Visualisation de données avec Pandas
La visualisation des données est une partie importante de l'analyse de données. Elle nous aide à mieux comprendre et interpréter les motifs, les tendances et les relations dans les données.
À travers des graphiques, des diagrammes et d'autres formes, la visualisation des données transforme des nombres complexes et des informations statistiques en images faciles à comprendre, ce qui facilite la prise de décision.
Pandas offre une intégration avecMatplotlibetSeabornainsi que d'autres bibliothèques de visualisation, ce qui rend la visualisation des données simple et efficace.
Dans Pandas, la fonctionnalité de visualisation de données est principalement mise en œuvre viaDataFrame.plot()etSeries.plot()méthodes. Ces méthodes sont en fait des surcouches autour de la bibliothèque Matplotlib, ce qui simplifie le processus de création de graphiques.
| Type de graphique | Description | Méthode |
|---|---|---|
| Graphique en courbes | Montre la tendance des données au fil du temps ou selon d'autres variables continues | df.plot(kind='line') |
| Diagramme à barres | Compare les données entre différentes catégories | df.plot(kind='bar') |
| Diagramme à barres horizontales | Compare les données entre différentes catégories, mais les barres sont disposées horizontalement | df.plot(kind='barh') |
| Histogramme | Affiche la distribution des données | df.plot(kind='hist') |
| Nuage de points | Montre la relation entre deux variables numériques | df.plot(kind='scatter', x='col1', y='col2') |
| Diagramme en boîte | Affiche la distribution des données, y compris la médiane, les quartiles, etc. | df.plot(kind='box') |
| Graphique de densité | Affiche la distribution de densité des données | df.plot(kind='kde') |
| Diagramme circulaire | Affiche la proportion des différentes parties dans l'ensemble | df.plot(kind='pie') |
| Diagramme en aires | Affiche les valeurs cumulées des données | df.plot(kind='area') |
Les fonctions et méthodes de base de la visualisation de données avec Pandas peuvent répondre à la plupart des besoins quotidiens de visualisation de données. Cependant, pour obtenir des visualisations plus complexes, vous pouvez combiner Matplotlib et Seaborn pour une personnalisation plus fine des graphiques.
I. Aperçu de la visualisation de données avec Pandas
Pandas fournit laplot()méthodes permettant de tracer facilement différents types de graphiques, notamment des graphiques linéaires, des diagrammes à barres, des histogrammes, des nuages de points, etc.plot()Les méthodes disposent de nombreux paramètres, permettant de personnaliser le style du graphique, les couleurs, les libellés, etc.
1. Basesplot()Méthodes
| Paramètre | Description |
|---|---|
kind |
Type de graphique, prend en charge'line', 'bar', 'barh', 'hist', 'box', 'kde', 'density', 'area', 'pie'et d'autres types |
x |
Définir la colonne de données pour l'axe des x |
y |
Définir la colonne de données pour l’axe Y |
title |
Titre du graphique |
xlabel |
Libellé de l’axe X |
ylabel |
Libellé de l’axe Y |
color |
Définir la couleur du graphique |
figsize |
Définir la taille du graphique (largeur, hauteur) |
legend |
Afficher ou non la légende |
2. Types de graphiques courants
| Type de graphique | Description | Utilisation courante |
|---|---|---|
| Graphique en courbes | Utilisé pour afficher les tendances des données au fil du temps | df.plot(kind='line') |
| Diagramme à barres | Utilisé pour afficher des données de comparaison entre catégories | df.plot(kind='bar') |
| Diagramme à barres horizontales | Semblable à un graphique à barres, mais les barres sont horizontales | df.plot(kind='barh') |
| Histogramme | Utilisé pour afficher la distribution des données (distribution des fréquences) | df.plot(kind='hist') |
| Nuage de points | Utilisé pour afficher la relation entre deux variables numériques | df.plot(kind='scatter', x='col1', y='col2') |
| Diagramme en boîte | Utilisé pour afficher la distribution des données, les valeurs aberrantes et les quartiles | df.plot(kind='box') |
| Graphique de densité | Utilisé pour afficher la distribution de densité des données | df.plot(kind='kde') |
| Diagramme circulaire | Utilisé pour afficher la proportion de chaque partie dans l'ensemble | df.plot(kind='pie') |
| Diagramme en aires | Utilisé pour afficher des valeurs cumulées (semblable à un graphique en courbes, mais avec une couleur de remplissage) | df.plot(kind='area') |
II. Exemples de visualisation de données
1. Graphique en courbes
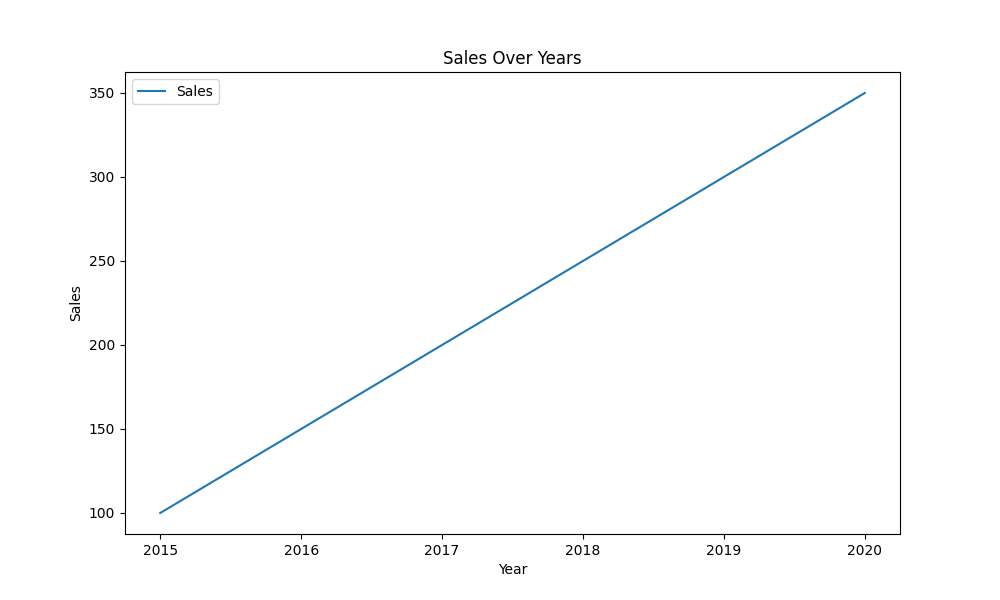
Les graphiques en courbes sont couramment utilisés pour montrer la tendance des données au fil du temps.
Exemple
import matplotlib.pyplot as plt
# Données d'exemple
data = {'Year': [2015, 2016, 2017, 2018, 2019, 2020],
'Sales': [100, 150, 200, 250, 300, 350]}
df = pd.DataFrame(data)
# Tracer un graphique en courbes
df.plot(kind='line', x='Year', y='Sales', title='Sales Over Years', xlabel='Year', ylabel='Sales', figsize=(10, 6))
plt.show()
Sortie :
2. Diagramme à barres
Les diagrammes à barres sont utilisés pour montrer des comparaisons entre différentes catégories, particulièrement adaptés aux données discrètes.
Exemple
import matplotlib.pyplot as plt
# Données d'exemple
data = {'Category': ['A', 'B', 'C', 'D'],
'Valeur': [10, 15, 7, 12]}
df = pd.DataFrame(data)
# Tracer un diagramme à barres
df.plot(kind='bar', x='Category', y='Value', title='Valeurs des catégories', xlabel='Category', ylabel='Value', figsize=(8, 5))
plt.show()
Sortie :

3. Diagramme de dispersion
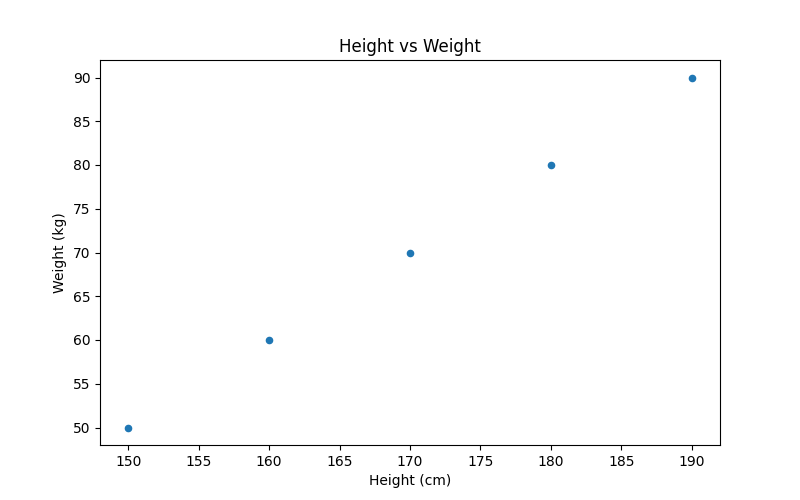
Les diagrammes de dispersion sont utilisés pour montrer la relation entre deux variables numériques.
Exemple
import matplotlib.pyplot as plt
# Données d'exemple
data = {'Height': [150, 160, 170, 180, 190],
'Weight': [50, 60, 70, 80, 90]}
df = pd.DataFrame(data)
# Tracer un diagramme de dispersion
df.plot(kind='scatter', x='Height', y='Weight', title='Taille vs Poids', xlabel='Taille (cm)', ylabel='Poids (kg)', figsize=(8, 5))
plt.show()
Sortie :
4. Histogramme
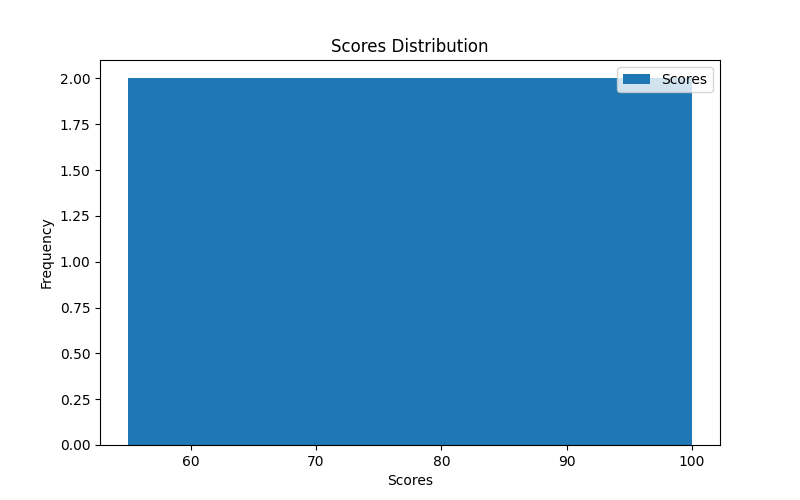
Les histogrammes sont utilisés pour afficher la distribution des données, en particulier pour décrire la distribution des fréquences des données.
Exemple
import matplotlib.pyplot as plt
# Données d'exemple
data = {'Scores': [55, 70, 85, 90, 60, 75, 80, 95, 100, 65]}
df = pd.DataFrame(data)
# Tracer l'histogramme
df.plot(kind='hist', y='Scores', bins=5, title='Distribution des scores', xlabel='Scores', figsize=(8, 5))
plt.show()
Sortie :
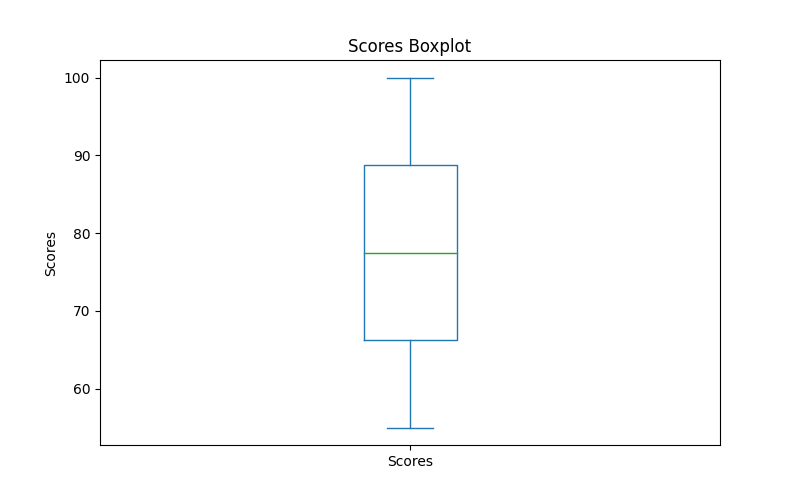
5. Boîte à moustaches
Les boîtes à moustaches sont utilisées pour afficher la distribution des données, y compris la médiane, les quartiles et les valeurs aberrantes.
Exemple
import matplotlib.pyplot as plt
# Données d'exemple
data = {'Scores': [55, 70, 85, 90, 60, 75, 80, 95, 100, 65]}
df = pd.DataFrame(data)
# Tracer la boîte à moustaches
df.plot(kind='box', title='Boîte à moustaches des scores', ylabel='Scores', figsize=(8, 5))
plt.show()
Sortie :
6. Diagramme circulaire
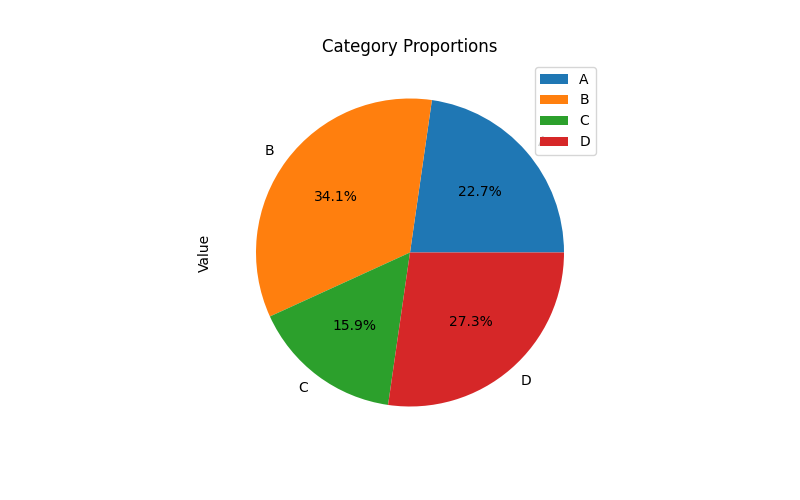
Les diagrammes circulaires servent à montrer la proportion de chaque partie par rapport au tout.
Exemple
import matplotlib.pyplot as plt
# Données d'exemple
data = {'Category': ['A', 'B', 'C', 'D'],
'Valeur': [10, 15, 7, 12]}
df = pd.DataFrame(data)
# Tracer un diagramme circulaire
df.plot(kind='pie', y='Value', labels=df['Category'], autopct='%1.1f%%', title='Proportions des catégories', figsize=(8, 5))
plt.show()
Sortie :
III. Visualisation Seaborn
Seaborn est une bibliothèque avancée de visualisation de données basée sur Matplotlib, offrant des graphiques plus beaux, plus faciles à utiliser et une variété plus riche de types de graphiques statistiques.
Dans Pandas, vous pouvez utiliser Seaborn directement en conjonction avec lui.
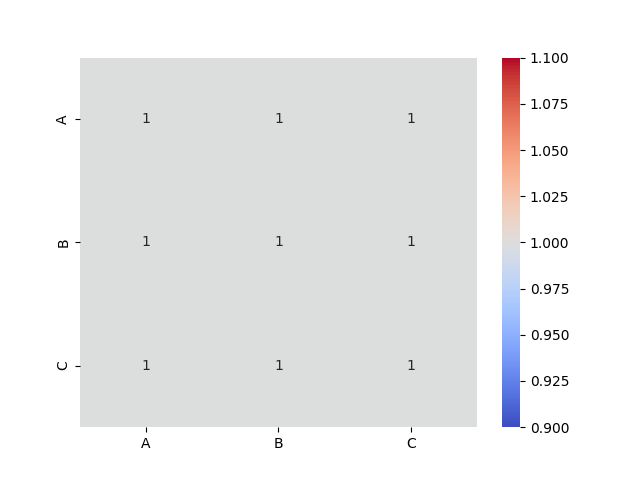
Carte thermique :
Exemple
import seaborn as sns
import matplotlib.pyplot as plt
# Données d'exemple
data = {'A': [1, 2, 3], 'B': [4, 5, 6], 'C': [7, 8, 9]}
df = pd.DataFrame(data)
# Tracer une carte thermique
sns.heatmap(df.corr(), annot=True, cmap='coolwarm')
plt.show()
Sortie :
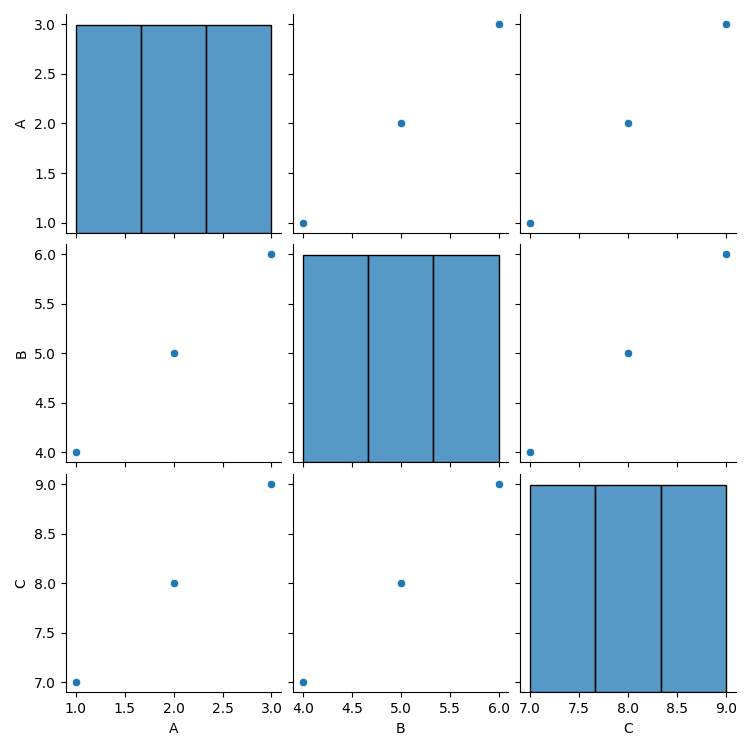
Matrice de nuages de points entre toutes les variables numériques du jeu de données:
Exemple
import seaborn as sns
import matplotlib.pyplot as plt
# Données d'exemple
data = {'A': [1, 2, 3], 'B': [4, 5, 6], 'C': [7, 8, 9]}
df = pd.DataFrame(data)
sns.pairplot(df)
plt.show()
Sortie :
IV. Personnalisation avancée de Matplotlib
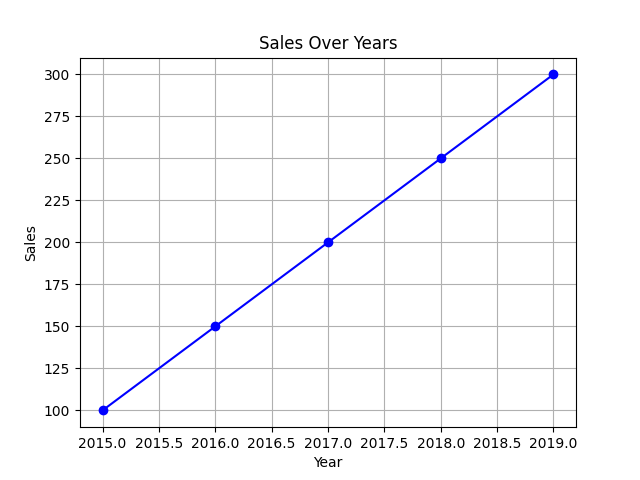
En plus d'utiliser les méthodes fournies par Pandas,plot()Matplotlib peut également fournir des fonctionnalités de personnalisation plus flexibles, telles que l'ajout de titres, d'étiquettes, la définition de styles de graphiques, l'ajustement des axes, etc.
Exemple
import seaborn as sns
import matplotlib.pyplot as plt
# Données d'exemple
data = {'Year': [2015, 2016, 2017, 2018, 2019],
'Sales': [100, 150, 200, 250, 300]}
df = pd.DataFrame(data)
# Tracer un graphique en courbes
plt.plot(df['Year'], df['Sales'], color='blue', marker='o')
# Personnalisation
plt.title('Ventes au fil des années')
plt.xlabel('Année')
plt.ylabel('Ventes')
plt.grid(True)
# Affichage
plt.show()
Sortie :