Introduction à Pandas
Pandas est une bibliothèque open source d'analyse et de traitement de données basée sur le langage de programmation Python.
Pandas fournit des structures de données et des outils d'analyse de données faciles à utiliser, particulièrement adaptés au traitement de données structurées telles que les données tabulaires (similaires aux feuilles de calcul Excel).
Pandas est l'un des outils couramment utilisés en science des données et en analyse. Il permet aux utilisateurs d'importer facilement des données à partir de diverses sources de données et d'effectuer des opérations et des analyses efficaces sur les données.
Pandas introduit principalement deux nouvelles structures de données :SeriesetDataFrame。
Series: Similaire à un tableau ou une liste unidimensionnels, il est composé d'un ensemble de données et d'étiquettes de données associées (indices). Une Series peut être considérée comme une colonne dans un DataFrame, ou elle peut exister indépendamment en tant que structure de données unidimensionnelle.
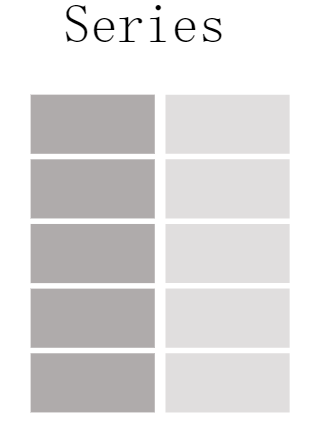
DataFrame: Similaire à une table bidimensionnelle, c'est la structure de données la plus importante dans Pandas. Un DataFrame peut être considéré comme une table composée de plusieurs Series disposées en colonnes. Il possède à la fois des indices de lignes et des indices de colonnes, ce qui facilite les opérations de sélection de lignes/colonnes, de filtrage, de fusion et autres.
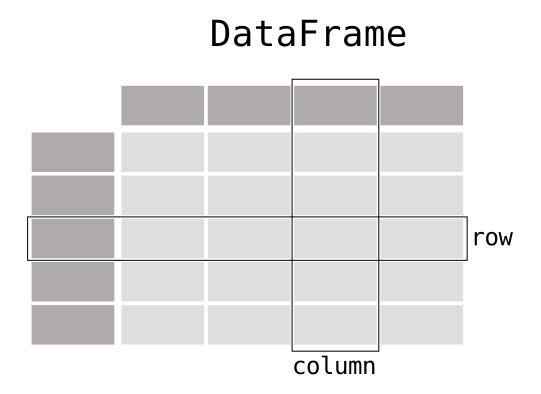
Un DataFrame peut être considéré comme une structure de données composée de plusieurs Series :
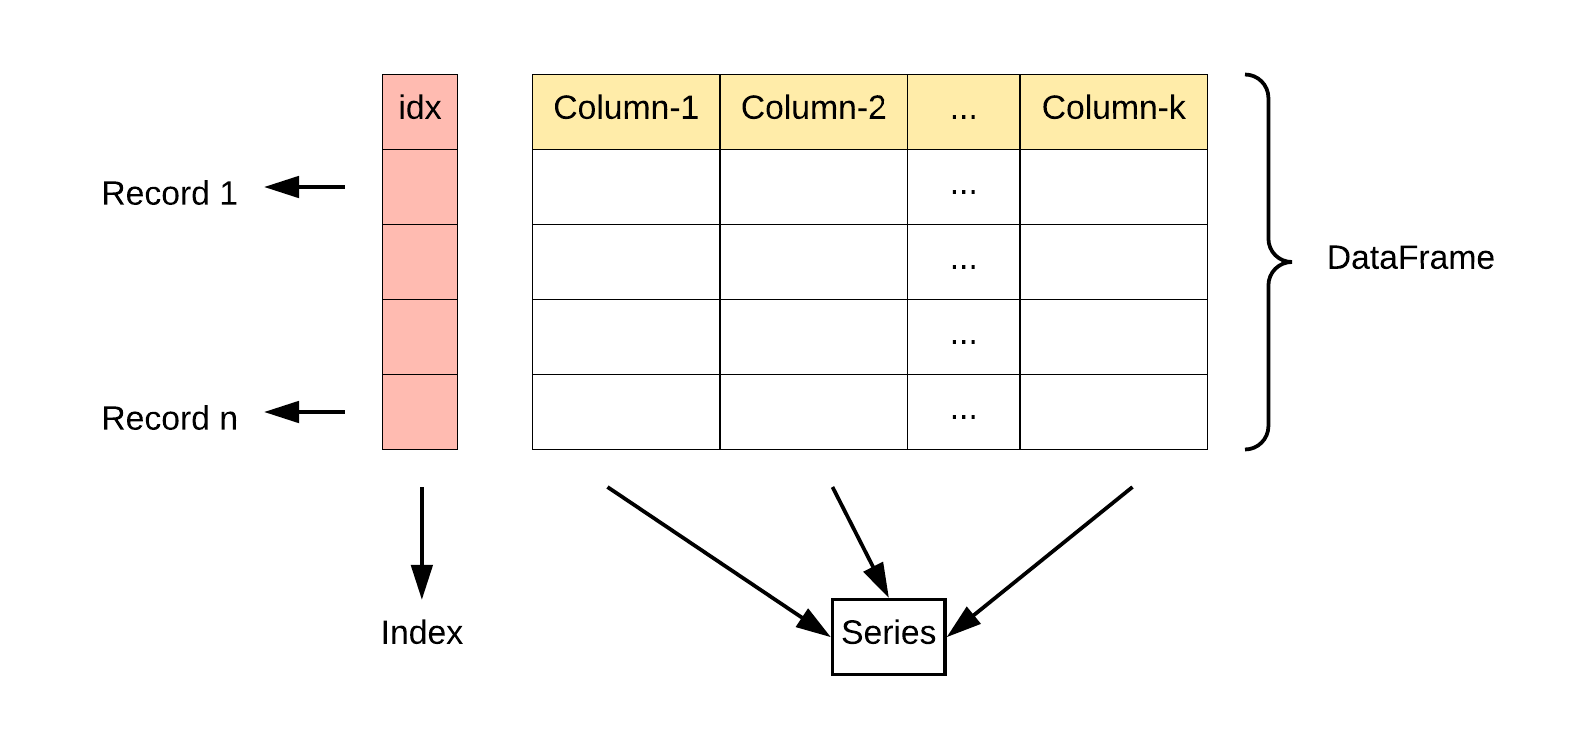
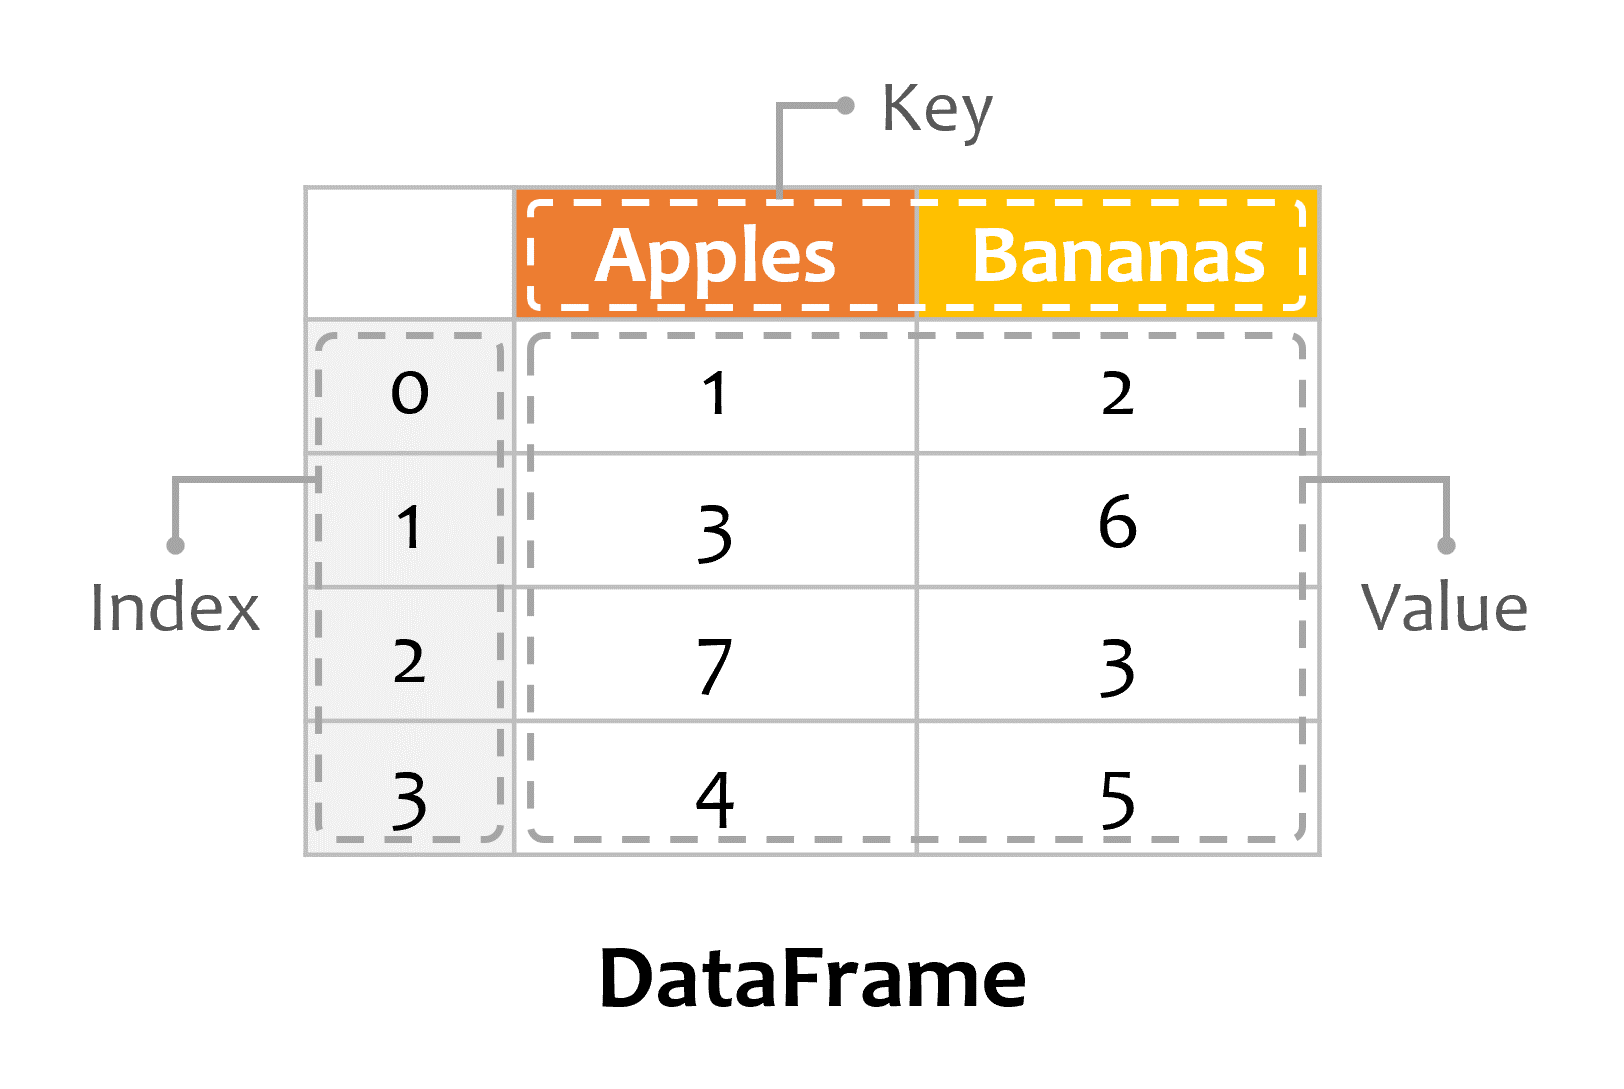
La figure ci-dessous montre deux objets Series additionnés ensemble pour obtenir un objet DataFrame :
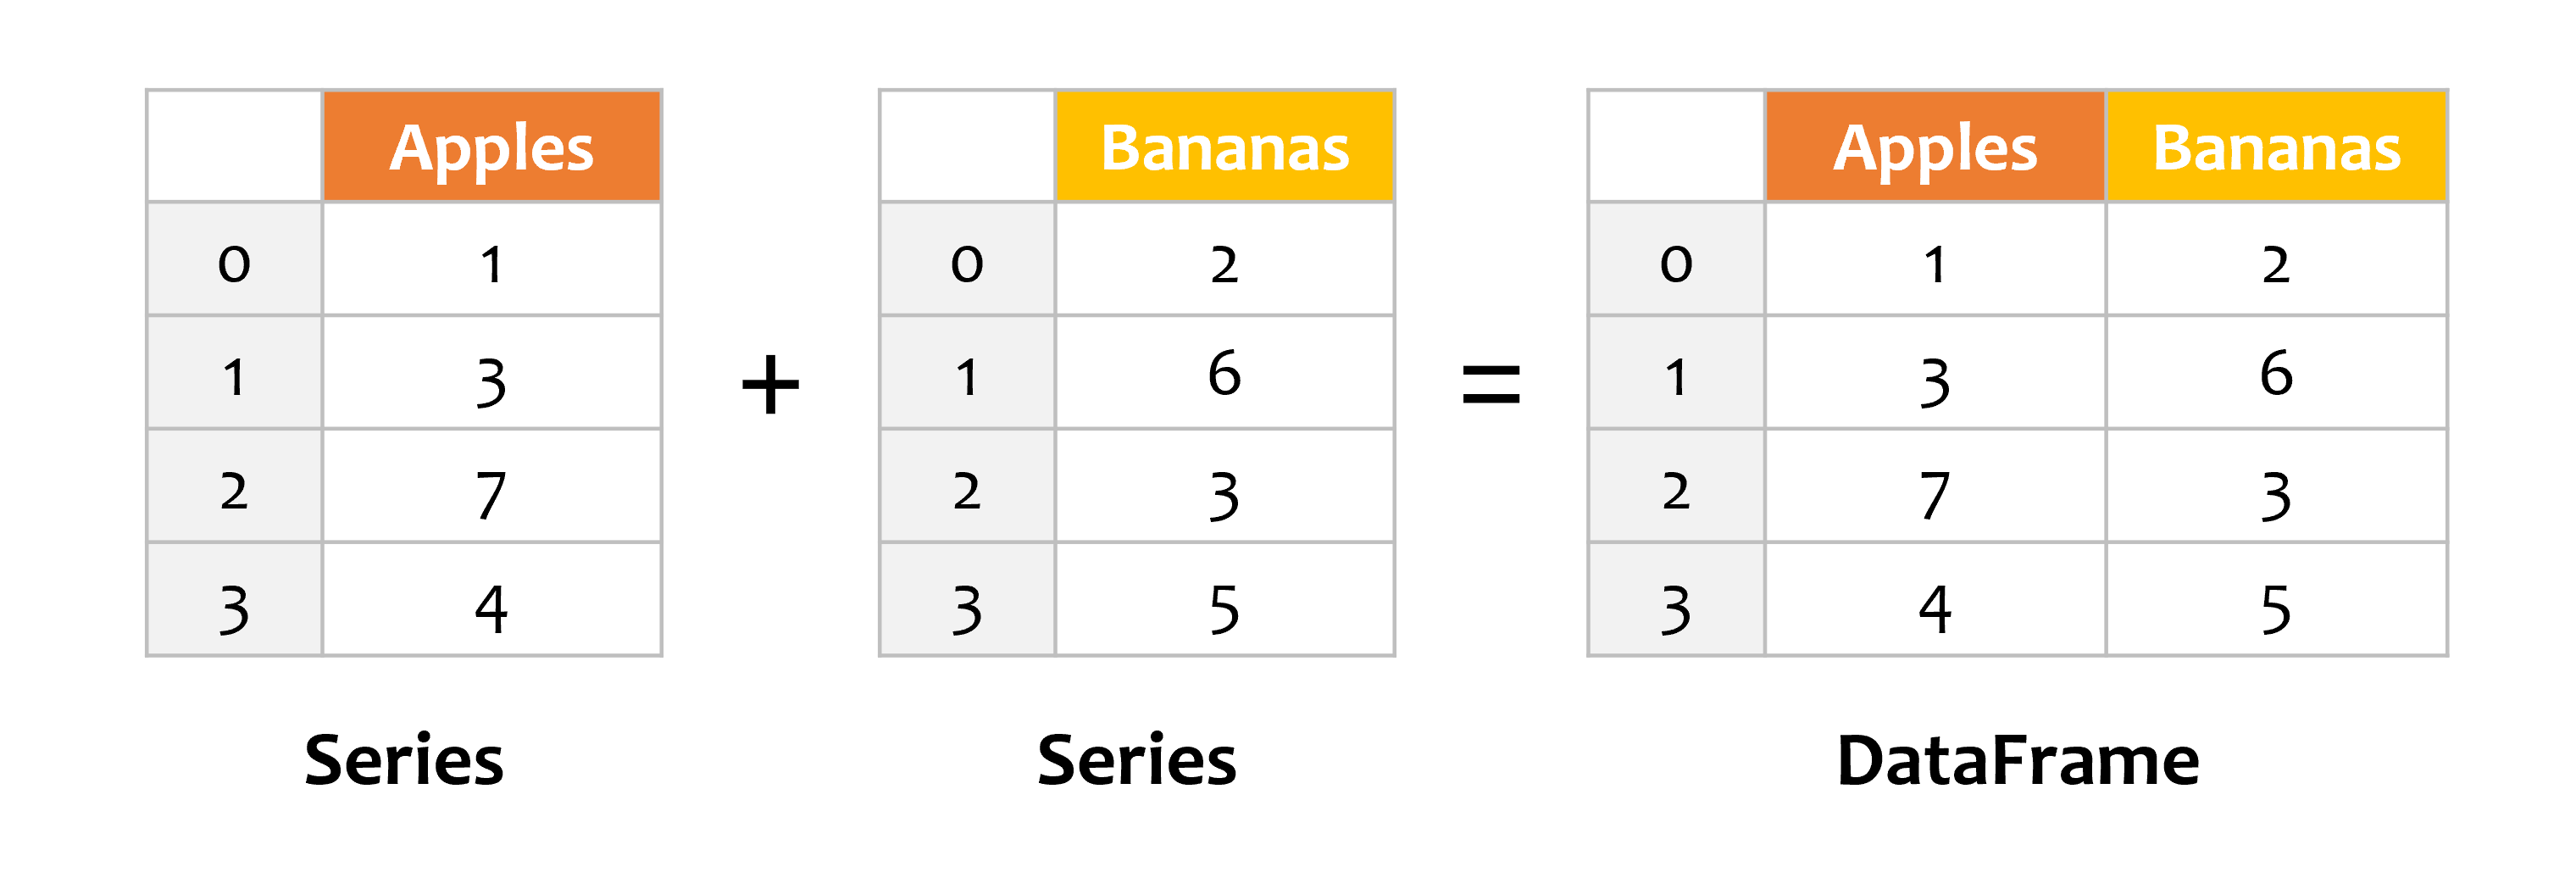
Un DataFrame est constitué d'Index, de Key et de Value :
Exemples
# Créer deux objets Series
series_apples = pd.Series([1, 3, 7, 4])
series_bananas = pd.Series([2, 6, 3, 5])
# Additionner les deux objets Series pour obtenir un DataFrame et spécifier les noms de colonnes
df = pd.DataFrame({ 'Apples': series_apples, 'Bananas': series_bananas })
# Afficher le DataFrame
print(df)
Le résultat de sortie est:
   Apples  Bananas
0       1        2
1       3        6
2       7        3
3       4        5
Fonctionnalités de Pandas
Structures de données efficaces:
- Series: Structure de données unidimensionnelle, similaire à une liste (List), mais avec des fonctionnalités plus puissantes et prend en charge l’indexation.
- DataFrame: Structure de données bidimensionnelle, similaire à une table ou à une table de données dans une base de données, où les lignes et les colonnes ont des étiquettes (indices).
Nettoyage et prétraitement des données:
- Pandas fournit de nombreuses fonctions pour gérer les valeurs manquantes, les données en double, la conversion de types de données, les opérations sur les chaînes, etc., aidant les utilisateurs à nettoyer et transformer facilement les données.
Manipulation et analyse des données:
- Prend en charge la sélection efficace des données, le filtrage, le découpage, l'extraction de données selon des conditions, la fusion, la concaténation de plusieurs ensembles de données, le regroupement des données, les statistiques récapitulatives et d'autres opérations.
- Il peut effectuer des transformations complexes des données, telles que les tableaux croisés dynamiques, la tabulation croisée, l'analyse de séries temporelles, etc.
Lecture et export des données:
- Prend en charge la lecture de données à partir de sources de données dans divers formats, tels que CSV, Excel, JSON, bases de données SQL, etc.
- Il peut également exporter les données traitées vers différents formats, tels que CSV, Excel, etc.
Visualisation de données:
- Grâce à l'intégration avec Matplotlib et d'autres outils de visualisation, Pandas peut rapidement générer des graphiques courants tels que des courbes, des diagrammes à barres, des nuages de points, etc.
Analyse de séries temporelles:
- Prend en charge de puissantes fonctions de traitement des séries temporelles, notamment l'analyse des dates, le rééchantillonnage, la conversion de fuseau horaire, etc.
Performance et optimisation:
- Pandas optimise le traitement de données à grande échelle et fournit des opérations vectorisées efficaces, évitant l'inefficacité de l'utilisation de boucles Python pour traiter les données.
- Il prend également en charge certaines techniques d'optimisation de la mémoire, telles que l'utilisation de
categorytype pour gérer les données dupliquées.
Applications de Pandas
Pandas est largement utilisé dans les domaines de la science des données et de l'analyse de données, et son principal avantage réside dans sa capacité à traiter et analyser des données structurées.
Voici quelques-uns des principaux domaines d'application de Pandas :
Secteur financier: Les institutions financières utilisent Pandas pour traiter et analyser les données boursières, les données financières, les données de trading, etc. La flexibilité et l'efficacité de Pandas permettent aux analystes financiers d'effectuer rapidement le nettoyage des données, l'analyse statistique, la modélisation et d'autres tâches.
Recherche scientifique: Le domaine de la recherche scientifique implique souvent de grandes quantités de données expérimentales, de données d'observation, etc. Pandas fournit des outils puissants pour traiter et analyser ces données, comme en astronomie, biologie, sciences de la Terre et dans d'autres domaines.
Analyse des données d'entreprise: Diverses entreprises et organisations doivent analyser des données commerciales pour appuyer la prise de décision et la planification stratégique. Pandas fournit des fonctionnalités pour traiter et analyser les données d'entreprise, notamment les données de ventes, les données clients, les données opérationnelles, etc.
Analyse des médias sociaux: Les données massives générées par les plateformes de médias sociaux doivent être analysées pour comprendre le comportement des utilisateurs, les tendances et les tendances de sentiment. Pandas peut aider les analystes à traiter et analyser les données des médias sociaux, à réaliser des analyses du comportement des utilisateurs, des analyses de sentiment, etc.
Santé: Le domaine de la santé doit traiter et analyser de grandes quantités de données médicales, notamment les données des patients, les données d'essais cliniques, les données d'imagerie médicale, etc. Pandas fournit des outils pour traiter et analyser ces données, soutenant la recherche médicale et la prise de décision clinique.
Recherche en éducation: Le domaine de l'éducation peut utiliser Pandas pour traiter les données de performance des étudiants, les données d'évaluation de l'enseignement, les données de cours, etc., afin de mener des recherches en éducation et d'améliorer la qualité de l'enseignement.
Marketing: Les professionnels du marketing peuvent utiliser Pandas pour analyser les données de marché, les données clients, les données publicitaires, etc., afin de formuler des stratégies marketing et d'optimiser l'efficacité des activités marketing.
Pandas est un outil puissant et flexible dans de nombreux domaines, offrant aux scientifiques des données, aux analystes et aux ingénieurs un moyen pratique de traiter et d'analyser les données.
Autres extensions