Archivos CSV de Pandas
CSV (Comma-Separated Values, valores separados por comas, a veces también llamados valores separados por caracteres, porque el carácter separador puede no ser una coma); sus archivos almacenan datos tabulares (números y texto) en forma de texto plano.
CSV es un formato de archivo universal y relativamente simple, ampliamente utilizado por usuarios, empresas y el ámbito científico.
Pandas puede manejar archivos CSV de manera muy conveniente; los métodos comunes son:
| Nombre del método | Descripción de la función | Parámetros comunes |
|---|---|---|
pd.read_csv() | Lee datos de un archivo CSV y los carga como DataFrame | filepath_or_buffer(ruta u objeto de archivo),sep(delimitador),header(encabezado),names(nombres de columnas personalizados),dtype(tipo de datos),index_col(columna de índice) |
DataFrame.to_csv() | Escribe el DataFrame en un archivo CSV | path_or_buffer(ruta de destino u objeto de archivo),sep(delimitador),index(si escribir el índice),columns(columnas especificadas),header(si escribir los nombres de las columnas),mode(modo de escritura) |
Este artículo utilizanba.csvcomo ejemplo, puedesdescargar nba.csvoabrir nba.csvpara verlo.
pd.read_csv() - Leer archivos CSV
read_csv() es el método principal para leer datos de un archivo CSV; carga los datos como un DataFrame.
import pandas as pd

# 读取 CSV 文件,并自定义列名和分隔符
df = pd.read_csv('data.csv', sep=';', header=0, names=['A', 'B', 'C'], dtype={'A': int, 'B': float})
print(df)
Parámetros comunes de read_csv:
| Parámetro | Descripción | Valor predeterminado |
|---|---|---|
filepath_or_buffer | Ruta del archivo CSV u objeto de archivo (admite URL, rutas de archivo, objetos de archivo, etc.) | Parámetro obligatorio |
sep | Define el delimitador de campos; por defecto es una coma (,), se puede cambiar a otros caracteres, como el tabulador (\t) | ',' |
header | Especifica el número de fila como encabezado de columna; por defecto es 0 (la primera fila), o se puede establecer comoNonesin encabezado | 0 |
names | Nombres de columnas personalizados; pasar una lista de nombres de columnas | None |
index_col | Número o nombre de la columna utilizada como índice de filas | None |
usecols | Lee las columnas especificadas; pueden ser nombres de columnas o índices de columnas | None |
dtype | Fuerza la conversión de las columnas al tipo de datos especificado | None |
skiprows | Omite el número especificado de filas al inicio del archivo, o pasa una lista de números de fila | None |
nrows | Lee las primeras N filas de datos | None |
na_values | Especifica qué valores deben tratarse como valores faltantes (NaN) | None |
skipfooter | Omite el número especificado de filas al final del archivo | 0 |
encoding | Formato de codificación del archivo (por ejemplo,utf-8,latin1etc.) | None |
Leer los datos del archivo nba.csv:
Ejemplo
df = pd.read_csv('nba.csv')
print(df.to_string())
to_string()Se utiliza para devolver datos de tipo DataFrame; si no se usa esta función, el resultado de salida son las primeras 5 filas y las últimas 5 filas, con la parte intermedia sustituida por...en su lugar.
Ejemplo
df = pd.read_csv('nba.csv')
print(df)
              Name            Team  Number Position   Age Height  Weight            College     Salary
0    Avery Bradley  Boston Celtics     0.0       PG  25.0    6-2   180.0              Texas  7730337.0
1      Jae Crowder  Boston Celtics    99.0       SF  25.0    6-6   235.0          Marquette  6796117.0
2     John Holland  Boston Celtics    30.0       SG  27.0    6-5   205.0  Boston University        NaN
3      R.J. Hunter  Boston Celtics    28.0       SG  22.0    6-5   185.0      Georgia State  1148640.0
4    Jonas Jerebko  Boston Celtics     8.0       PF  29.0   6-10   231.0                NaN  5000000.0
..             ...             ...     ...      ...   ...    ...     ...                ...        ...
453   Shelvin Mack       Utah Jazz     8.0       PG  26.0    6-3   203.0             Butler  2433333.0
454      Raul Neto       Utah Jazz    25.0       PG  24.0    6-1   179.0                NaN   900000.0
455   Tibor Pleiss       Utah Jazz    21.0        C  26.0    7-3   256.0                NaN  2900000.0
456    Jeff Withey       Utah Jazz    24.0        C  26.0    7-0   231.0             Kansas   947276.0
457            NaN             NaN     NaN      NaN   NaN    NaN     NaN                NaN        NaN
df.to_csv() - Escribir DataFrame en un archivo CSV
to_csv() es el método para escribir un DataFrame en un archivo CSV; admite configuraciones como delimitador personalizado, nombres de columnas, si incluir el índice, etc.
import pandas as pd

# 假设 df 是一个已有的 DataFrame
df.to_csv('output.csv', index=False, header=True, columns=['A', 'B'])
Parámetros comunes de to_csv:
| Parámetro | Descripción | Valor predeterminado |
|---|---|---|
path_or_buffer | Ruta del archivo CSV u objeto de archivo (admite rutas de archivo, objetos de archivo) | Parámetro obligatorio |
sep | Define el delimitador de campos; por defecto es una coma (,), se puede cambiar a otros caracteres, como el tabulador (\t) | ',' |
index | Si escribir el índice de filas; por defectoTrueindica que se escribe el índice | True |
columns | Especifica las columnas a escribir; puede ser una lista de nombres de columnas | None |
header | Si escribir los nombres de las columnas; por defectoTrueindica que se escriben los nombres de las columnas; al establecer comoFalseindica que no se escriben los nombres de las columnas | True |
mode | Modo de escritura del archivo; por defecto esw(modo escritura), se puede establecer comoa(modo añadir) | 'w' |
encoding | Formato de codificación del archivo, comoutf-8,latin1esperar | None |
line_terminator | Define el finalizador de línea; por defecto es\n | None |
quoting | Configura cómo manejar las comillas de los datos en el archivo (0-3, consulte la documentación para los modos específicos de comillas) | None |
quotechar | Establece el carácter utilizado para las comillas; por defecto son comillas dobles" | '"' |
date_format | Formato de fecha personalizado; si las columnas contienen datos de fecha, se puede usar este parámetro para especificar el formato de fecha | None |
doublequote | Si esTrue, al escribir, el texto que contiene comillas se envolverá entre comillas dobles | True |
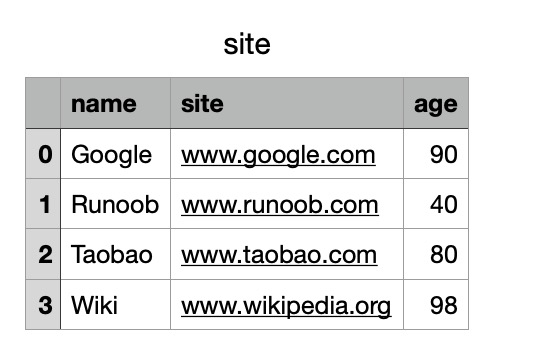
También podemos usar el métodoto_csv()para almacenar el DataFrame como un archivo CSV:
Ejemplo
# Tres campos: name, site, age
nme = ["Google", "Ejemplo", "Taobao", "Wiki"]
st = ["www.google.com", "www.example.com", "www.taobao.com", "www.wikipedia.org"]
ag = [90, 40, 80, 98]
# Diccionario
dict = {'name': nme, 'site': st, 'age': ag}
df = pd.DataFrame(dict)
# Guardar dataframe
df.to_csv('site.csv')
Después de ejecutarlo correctamente, abrimos el archivo site.csv y el resultado se muestra de la siguiente manera:
Procesamiento de datos
head()
head( n )El método se utiliza para leer las primeras n filas; si no se proporciona el parámetro n, devuelve 5 filas por defecto.
Ejemplo - Leer las primeras 5 filas
df = pd.read_csv('nba.csv')
print(df.head())
El resultado de salida es:
            Name            Team  Number Position   Age Height  Weight            College     Salary
0  Avery Bradley  Boston Celtics     0.0       PG  25.0    6-2   180.0              Texas  7730337.0
1    Jae Crowder  Boston Celtics    99.0       SF  25.0    6-6   235.0          Marquette  6796117.0
2   John Holland  Boston Celtics    30.0       SG  27.0    6-5   205.0  Boston University        NaN
3    R.J. Hunter  Boston Celtics    28.0       SG  22.0    6-5   185.0      Georgia State  1148640.0
4  Jonas Jerebko  Boston Celtics     8.0       PF  29.0   6-10   231.0                NaN  5000000.0
Ejemplo - Leer las primeras 10 filas
df = pd.read_csv('nba.csv')
print(df.head(10))
El resultado de salida es:
            Name            Team  Number Position   Age Height  Weight            College      Salary
0  Avery Bradley  Boston Celtics     0.0       PG  25.0    6-2   180.0              Texas   7730337.0
1    Jae Crowder  Boston Celtics    99.0       SF  25.0    6-6   235.0          Marquette   6796117.0
2   John Holland  Boston Celtics    30.0       SG  27.0    6-5   205.0  Boston University         NaN
3    R.J. Hunter  Boston Celtics    28.0       SG  22.0    6-5   185.0      Georgia State   1148640.0
4  Jonas Jerebko  Boston Celtics     8.0       PF  29.0   6-10   231.0                NaN   5000000.0
5   Amir Johnson  Boston Celtics    90.0       PF  29.0    6-9   240.0                NaN  12000000.0
6  Jordan Mickey  Boston Celtics    55.0       PF  21.0    6-8   235.0                LSU   1170960.0
7   Kelly Olynyk  Boston Celtics    41.0        C  25.0    7-0   238.0            Gonzaga   2165160.0
8   Terry Rozier  Boston Celtics    12.0       PG  22.0    6-2   190.0         Louisville   1824360.0
9   Marcus Smart  Boston Celtics    36.0       PG  22.0    6-4   220.0     Oklahoma State   3431040.0
tail()
tail( n )El método se utiliza para leer las últimas n filas; si no se proporciona el parámetro n, devuelve 5 filas por defecto; los valores de los campos en las filas vacías devuelvenNaN。
Ejemplo - Leer las últimas 5 filas
df = pd.read_csv('nba.csv')
print(df.tail())
El resultado de salida es:
             Name       Team  Number Position   Age Height  Weight College     Salary
453  Shelvin Mack  Utah Jazz     8.0       PG  26.0    6-3   203.0  Butler  2433333.0
454     Raul Neto  Utah Jazz    25.0       PG  24.0    6-1   179.0     NaN   900000.0
455  Tibor Pleiss  Utah Jazz    21.0        C  26.0    7-3   256.0     NaN  2900000.0
456   Jeff Withey  Utah Jazz    24.0        C  26.0    7-0   231.0  Kansas   947276.0
457           NaN        NaN     NaN      NaN   NaN    NaN     NaN     NaN        NaN
Ejemplo - Leer las últimas 10 filas
df = pd.read_csv('nba.csv')
print(df.tail(10))
El resultado de salida es:
               Name       Team  Number Position   Age Height  Weight   College      Salary
448  Gordon Hayward  Utah Jazz    20.0       SF  26.0    6-8   226.0    Butler  15409570.0
449     Rodney Hood  Utah Jazz     5.0       SG  23.0    6-8   206.0      Duke   1348440.0
450      Joe Ingles  Utah Jazz     2.0       SF  28.0    6-8   226.0       NaN   2050000.0
451   Chris Johnson  Utah Jazz    23.0       SF  26.0    6-6   206.0    Dayton    981348.0
452      Trey Lyles  Utah Jazz    41.0       PF  20.0   6-10   234.0  Kentucky   2239800.0
453    Shelvin Mack  Utah Jazz     8.0       PG  26.0    6-3   203.0    Butler   2433333.0
454       Raul Neto  Utah Jazz    25.0       PG  24.0    6-1   179.0       NaN    900000.0
455    Tibor Pleiss  Utah Jazz    21.0        C  26.0    7-3   256.0       NaN   2900000.0
456     Jeff Withey  Utah Jazz    24.0        C  26.0    7-0   231.0    Kansas    947276.0
457             NaN        NaN     NaN      NaN   NaN    NaN     NaN       NaN         NaN
info()
El método info() devuelve información básica sobre la tabla:
Ejemplo
df = pd.read_csv('nba.csv')
print(df.info())
El resultado de salida es:
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 458 entries, 0 to 457          # 行数,458 行,第一行编号为 0
Data columns (total 9 columns):            # 列数,9列
 #   Column    Non-Null Count  Dtype       # 各列的数据类型
---  ------    --------------  -----
 0   Name      457 non-null    object
 1   Team      457 non-null    object
 2   Number    457 non-null    float64
 3   Position  457 non-null    object
 4   Age       457 non-null    float64
 5   Height    457 non-null    object
 6   Weight    457 non-null    float64
 7   College   373 non-null    object         # non-null,意思为非空的数据
 8   Salary    446 non-null    float64
dtypes: float64(4), object(5)                 # 类型
non-null son datos no vacíos; podemos ver en la información anterior que hay un total de 458 filas, y el campo College tiene la mayor cantidad de valores vacíos.
Otras extensiones