Структуры данных Pandas — DataFrame
DataFrame — это еще одна ключевая структура данных в Pandas, похожая на двумерную таблицу или таблицу данных в базе данных.
DataFrame — это табличная структура данных, содержащая набор упорядоченных столбцов, каждый из которых может иметь различные типы значений (числовые, строковые, логические).
DataFrame имеет как индексы строк, так и индексы столбцов; его можно рассматривать как словарь, состоящий из Series (имеющих общий индекс).
DataFrame предоставляет различные функции для доступа к данным, фильтрации, разделения, объединения, изменения формы, агрегации и операций преобразования.
DataFrame — очень гибкая и мощная структура данных, широко используемая для таких задач, как анализ данных, очистка, преобразование и визуализация.
Особенности DataFrame:
Двумерная структура:
DataFrameЭто двумерная таблица, которую можно рассматривать как электронную таблицу Excel или таблицу SQL, со строками и столбцами. Её можно рассматривать как несколькоSeriesобъектов, объединённых в словарь.Типы данных столбцов:Разные столбцы могут содержать данные разных типов, таких как целые числа, числа с плавающей запятой, строки или объекты Python.
-
Index:
DataFrameМожет иметь индексы строк и индексы столбцов, подобно номерам строк и меткам столбцов в Excel. -
Изменяемый размер: Можно добавлять и удалять столбцы, подобно словарю в Python.
-
Автоматическое выравнивание: При выполнении арифметических операций или операций выравнивания данных,
DataFrameиндексы будут автоматически выровнены. -
Обработка пропущенных данных:
DataFrameМожет содержать пропущенные данные, Pandas используетNaN(Not a Number) для их представления. -
Операции с данными: Поддерживает такие операции, как срезы данных, индексация и разбиение на подмножества.
-
Поддержка временных рядов:
DataFrameИмеет специальную поддержку данных временных рядов, позволяя легко выполнять срезы, индексацию и манипуляции с данными, основанными на времени. -
Расширенная функциональность доступа к данным: С помощью
.loc、.ilocи.query()метода можно гибко получать доступ к данным и фильтровать их. -
Гибкая функциональность обработки данных: Включая объединение данных, изменение формы, сводные преобразования, группировку и агрегацию.
-
Визуализация данных: Хотя
DataFrameсама по себе она не является инструментом визуализации, её можно комбинировать с библиотеками визуализации, такими как Matplotlib или Seaborn, для выполнения визуализации данных. -
Эффективный ввод/вывод данных: Позволяет удобно читать и записывать данные, поддерживая множество форматов, таких как CSV, Excel, базы данных SQL и HDF5.
-
Описательная статистика: Предоставляет ряд методов для вычисления описательных статистик, таких как
.describe()、.mean()、.sum()и т. д. -
Гибкое выравнивание и интеграция данных: Можно легко комбинировать с другими
DataFrameилиSeriesобъектами для выполнения операций слияния, соединения или обновления. -
Функциональность преобразования: Позволяет преобразовывать значения в наборе данных, например, используя
.apply()метод для применения пользовательских функций. -
Скользящее окно и анализ временных рядов: Поддерживает статистику скользящего окна и анализ временных рядов для наборов данных.
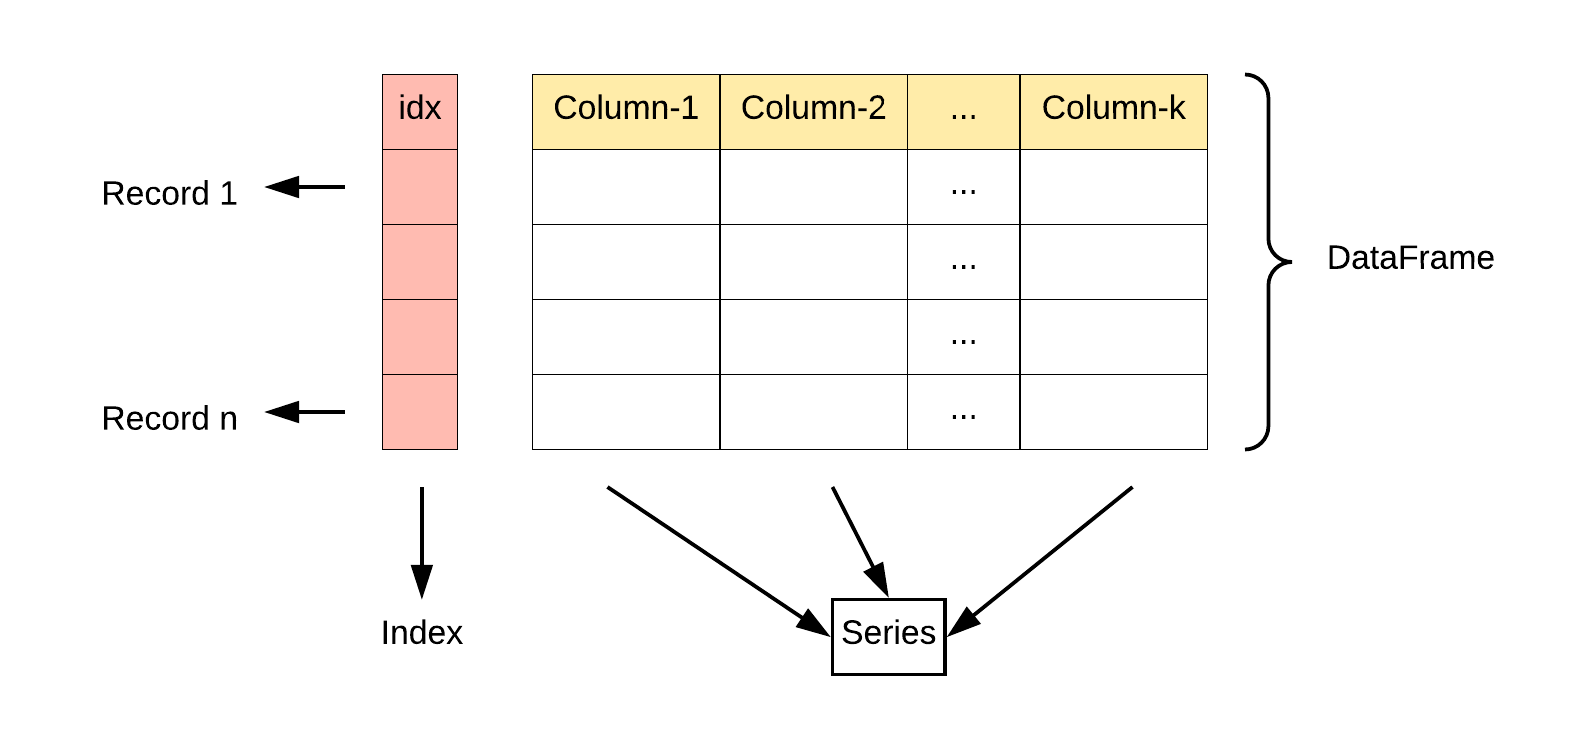

Конструктор DataFrame выглядит следующим образом:
pandas.DataFrame(data=None, index=None, columns=None, dtype=None, copy=False)
Описание параметра:
data: Часть данных DataFrame, которая может быть словарём, двумерным массивом, Series, DataFrame или другим объектом, который можно преобразовать в DataFrame. Если этот параметр не указан, создаётся пустой DataFrame.index: Индекс строк DataFrame, используемый для идентификации каждой строки данных. Он может быть списком, массивом, объектом индекса и т. д. Если этот параметр не указан, создаётся целочисленный индекс по умолчанию.columns: Индекс столбцов DataFrame, используемый для идентификации каждого столбца данных. Он может быть списком, массивом, объектом индекса и т. д. Если этот параметр не указан, создаётся целочисленный индекс по умолчанию.dtype: Задаёт тип данных DataFrame. Это может быть тип данных NumPy, напримерnp.int64、np.float64и т. д. Если этот параметр не указан, тип данных выводится автоматически на основе данных.copy: Копировать ли данные. По умолчанию False, то есть данные не копируются. Если установить True, входные данные копируются.
Pandas DataFrame — это двумерная структура массива, похожая на двумерный массив.
Пример — создание с использованием списка
data = [['Google', 10], ['Example', 12], ['Wiki', 13]]
# Создать DataFrame
df = pd.DataFrame(data, columns=['Site', 'Age'])
# Используйте метод astype, чтобы задать тип данных каждого столбца
df['Site'] = df['Site'].astype(str)
df['Age'] = df['Age'].astype(float)
print(df)
Вы также можете создать его с помощью словаря:
Пример — создание с помощью словаря
data = {'Site':['Google', 'Example', 'Wiki'], 'Age':[10, 12, 13]}
df = pd.DataFrame(data)
print (df)
Результат вывода следующий:

В следующем примере используются ndarrays для создания. Длины ndarrays должны быть одинаковыми. Если передается индекс, длина индекса должна быть равна длине массивов. Если индекс не передается, по умолчанию индексом будет range(n), где n — длина массивов.
Для ndarrays можно обратиться к:Объект ndarray в NumPy
Пример - Создание с использованием ndarrays
import pandas as pd
# Создание двумерного ndarray, содержащего сайт и возраст
ndarray_data = np.array([
['Google', 10],
['Example', 12],
['Wiki', 13]
])
# Использование конструктора DataFrame для создания DataFrame
df = pd.DataFrame(ndarray_data, columns=['Site', 'Age'])
# Вывод DataFrame
print(df)
Результат вывода следующий:
Из приведённого выше вывода видно, что тип данных DataFrame — это таблица, содержащая строки и столбцы:

Вы также можете использовать словарь (ключ/значение), где ключами словаря являются названия столбцов:
Пример — создание с помощью словаря
data = [{'a': 1, 'b': 2},{'a': 5, 'b': 10, 'c': 20}]
df = pd.DataFrame(data)
print (df)
Результат вывода:
   a   b     c
0  1   2   NaN
1  5  10  20.0
Часть без соответствующих данных — этоNaN。
Pandas может использовать атрибутlocдля возврата данных указанной строки. Если индекс не задан, индекс первой строки —0, индекс второй строки —1, и так далее:
Пример
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
# Загрузка данных в объект DataFrame
df = pd.DataFrame(data)
# Возврат первой строки
print(df.loc[0])
# Возврат второй строки
print(df.loc[1])
Результат вывода следующий:
calories    420
duration     50
Name: 0, dtype: int64
calories    380
duration     40
Name: 1, dtype: int64
Примечание:Возвращаемый результат на самом деле является данными Pandas Series.
Вы также можете вернуть несколько строк данных, используя формат[[ ... ]], где...— индексы каждой строки, разделённые запятыми:
Пример
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
# Загрузка данных в объект DataFrame
df = pd.DataFrame(data)
# Возврат первой и второй строк
print(df.loc[[0, 1]])
Результат вывода:
   calories  duration
0       420        50
1       380        40
Примечание:Возвращаемый результат на самом деле является данными Pandas DataFrame.
Мы можем указать значения индекса, как в следующем примере:
Пример
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
print(df)
Результат вывода:
      calories  duration
day1       420        50
day2       380        40
day3       390        45
Pandas может использоватьloc-атрибут для возврата строки, соответствующей указанному индексу:
Пример
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
# Указать индекс
print(df.loc["day2"])
Результат вывода:
calories    380
duration     40
Name: day2, dtype: int64
Методы DataFrame
Общие операции и методы DataFrame показаны в следующей таблице:
| Название метода | Описание функций |
|---|---|
head(n) | Возвращает первые n строк DataFrame (по умолчанию первые 5 строк) |
tail(n) | Возвращает последние n строк DataFrame (по умолчанию последние 5 строк) |
info() | Отображает краткую информацию о DataFrame, включая имена столбцов, типы данных, количество непустых значений и т. д. |
describe() | Возвращает статистическую информацию по числовым столбцам DataFrame, такую как среднее, стандартное отклонение, минимум и т. д. |
shape | Возвращает количество строк и столбцов DataFrame (строки, столбцы) |
columns | Возвращает все имена столбцов DataFrame |
index | Возвращает индекс строк DataFrame |
dtypes | Вернуть тип данных каждого столбца |
sort_values(by) | Сортировать по указанному столбцу |
sort_index() | Сортировать по индексу строк |
dropna() | Удалить строки или столбцы, содержащие пропущенные значения (NaN) |
fillna(value) | Заполнить пропущенные значения указанным значением |
isnull() | Проверить наличие пропущенных значений, возвращает булев DataFrame |
notnull() | Проверить наличие непропущенных значений, возвращает булев DataFrame |
loc[] | Выбрать данные по метке индекса |
iloc[] | Выбрать данные по позиционному индексу |
at[] | Доступ к одному элементу в DataFrame (болееloc[]эффективно) |
iat[] | Доступ к одному элементу в DataFrame (болееiloc[]эффективно) |
apply(func) | Применить функцию к DataFrame или Series |
applymap(func) | Применить функцию к каждому элементу DataFrame (только для DataFrame) |
groupby(by) | Операция группировки, используется для группировки по столбцу для вычисления сводной статистики |
pivot_table() | Создать сводную таблицу |
merge() | Объединить несколько DataFrame (аналогично операции SQL JOIN) |
concat() | Конкатенировать несколько DataFrame по строкам или столбцам |
to_csv() | Экспортировать DataFrame в CSV-файл |
to_excel() | Экспортировать DataFrame в файл Excel |
to_json() | Экспортировать DataFrame в формат JSON |
to_sql() | Экспортировать DataFrame в базу данных SQL |
query() | Выполнить запрос к DataFrame с использованием синтаксиса в стиле SQL |
duplicated() | Вернуть логический DataFrame, указывающий, является ли каждая строка дубликатом |
drop_duplicates() | Удалить дублирующиеся строки |
set_index() | Установить индекс DataFrame |
reset_index() | Сбросить индекс DataFrame |
transpose() | Транспонировать DataFrame (поменять местами строки и столбцы) |
Пример
# Создать DataFrame
data = {
'Name': ['Alice', 'Bob', 'Charlie', 'David'],
'Age': [25, 30, 35, 40],
'City': ['Нью-Йорк', 'Лос-Анджелес', 'Чикаго', 'Хьюстон']
}
df = pd.DataFrame(data)
# Просмотреть первые две строки данных
print(df.head(2))
# Просмотреть основную информацию о DataFrame
print(df.info())
# Получить описательную статистику
print(df.describe())
# Сортировать по возрасту
df_sorted = df.sort_values(by='Age', ascending=False)
print(df_sorted)
# Выбрать указанные столбцы
print(df[['Name', 'Age']])
# Выбрать строки по индексу
print(df.iloc[1:3]) # Выбрать строки со 2 по 3 (по позиции)
# Выбрать строки по метке
print(df.loc[1:2]) # Выбрать строки со 2 по 3 (по метке)
# Вычислить групповую статистику (группировка по городу, расчёт среднего возраста)
print(df.groupby('City')['Age'].mean())
# Обработка пропущенных значений (заполнить пропущенные значения)
df['Age'] = df['Age'].fillna(30)
# Экспорт в файл CSV
df.to_csv('output.csv', index=False)
Вывод:
# 查看前两行数据
     Name  Age         City
0   Alice   25     New York
1     Bob   30  Los Angeles

# 查看 DataFrame 的基本信息
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 4 entries, 0 to 3
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   Name    4 non-null      object
 1   Age     4 non-null      int64
 2   City    4 non-null      object
dtypes: int64(1), object(2)
memory usage: 148.0+ bytes

# 获取描述统计信息
             Age
count   4.000000
mean   32.500000
std     6.454972
min    25.000000
25%    27.500000
50%    32.500000
75%    37.500000
max    40.000000

# 按年龄排序
      Name  Age         City
3    David   40     Houston
2  Charlie   35      Chicago
1      Bob   30  Los Angeles
0    Alice   25     New York

# 按标签选择行
      Name  Age         City
1     Bob   30  Los Angeles
2  Charlie   35      Chicago

# 计算分组统计(按城市分组,计算平均年龄)
City
Chicago        35.0
Houston        40.0
Los Angeles    30.0
New York       25.0
Name: Age, dtype: float64
Дополнительные сведения о DataFrame
Создание DataFrame
Создание из словаря:Ключи словаря становятся именами столбцов, а значения — данными столбцов.
Пример
# Создать DataFrame из словаря
df = pd.DataFrame({'Column1': [1, 2, 3], 'Column2': [4, 5, 6]})
Создать из списка списков:Внешний список представляет строки, а внутренние списки — столбцы.
# Создать DataFrame из списка списковПример
columns=['Column1', 'Column2', 'Column3'])
Создать из массива NumPy:Укажите двумерный массив NumPy.
Пример
# Создать DataFrame из массива NumPy
df = pd.DataFrame(np.array([[1, 2, 3], [4, 5, 6], [7, 8, 9]]))
Создать DataFrame из Series:С помощьюpd.Series()создайте.
Пример
s1 = pd.Series(['Alice', 'Bob', 'Charlie'])
s2 = pd.Series([25, 30, 35])
s3 = pd.Series(['New York', 'Los Angeles', 'Chicago'])
df = pd.DataFrame({'Name': s1, 'Age': s2, 'City': s3})
Свойства и методы DataFrame
Объекты DataFrame имеют множество атрибутов и методов для манипулирования данными, индексации и обработки, таких как: shape, columns, index, head(), tail(), info(), describe(), mean(), sum() и т.д.
Пример
print(df.shape) # Форма
print(df.columns) # Имена столбцов
print(df.index) # Индекс
print(df.head()) # Первые несколько строк данных, по умолчанию первые 5 строк
print(df.tail()) # Последние несколько строк данных, по умолчанию последние 5 строк
print(df.info()) # Информация о данных
print(df.describe())# Описательная статистика
print(df.mean()) # Вычислить среднее
print(df.sum()) # Вычислить сумму
Доступ к элементам DataFrame
Доступ к столбцам:Используйте имена столбцов как атрибуты или через.loc[]、.iloc[]доступ, а также можно использовать индексацию по метке или позиции.
Пример
print(df['Column1'])
# Доступ по атрибуту
print(df.Name)
# Доступ через .loc[]
print(df.loc[:, 'Column1'])
# Доступ через .iloc[]
print(df.iloc[:, 0]) # Предположим, что 'Column1' — первый столбец
# Доступ к одному элементу
print(df['Name'][0])
Доступ к строкам:Используйте метки строк и.loc[]для доступа.
Пример
print(df.loc[0, 'Column1'])
Изменение DataFrame
Изменение данных столбца:Присваивайте значения столбцам напрямую.
df['Column1'] = [10, 11, 12]
Добавление нового столбца:Присвойте значения новому столбцу.
df['NewColumn'] = [100, 200, 300]
Добавление новой строки:Используйте методы loc, append или concat.
Пример
df.loc[3] = [13, 14, 15, 16]
# Добавление новой строки в конец с помощью append
new_row = {'Column1': 13, 'Column2': 14, 'NewColumn': 16}
df = df.append(new_row, ignore_index=True)
Примечание:append()Этот метод был помечен как устаревший в pandas версии 1.4.0 и будет удалён в будущих версиях. Официально рекомендуется использоватьconcat()как альтернативный метод для объединения данных.
Метод concat() используется для объединения двух или более DataFrame. Если вы хотите добавить строку в другой DataFrame, вы можете рассматривать новую строку как новый DataFrame и затем использовать concat():
Пример
new_row = pd.DataFrame([[4, 7]], columns=['A', 'B']) # Создать DataFrame, содержащий только новую строку
df = pd.concat([df, new_row], ignore_index=True) # Добавить новую строку в исходный DataFrame
print(df)
Удаление элементов DataFrame
Удаление столбцов:Используйте метод drop.
df_dropped = df.drop('Column1', axis=1)
Удаление строк:Также используйте метод drop.
df_dropped = df.drop(0) # 删除索引为 0 的行
Статистический анализ DataFrame
Описательная статистика:Используйте.describe()для просмотра статистической сводки по числовым столбцам.
df.describe()
Вычисление статистики:Используйте агрегатные функции, такие как.sum()、.mean()、.max()и т. д.
df['Column1'].sum()
df.mean()
Операции индексирования DataFrame
Сбросить индекс:Используйте.reset_index()。
df_reset = df.reset_index(drop=True)
Установить индекс:Используйте.set_index()。
df_set = df.set_index('Column1')
Булево индексирование DataFrame
Используйте булевы выражения: фильтруйте DataFrame на основе условий.
df[df['Column1'] > 2]
Типы данных DataFrame
Просмотр типов данных: используйте атрибутdtypes.
df.dtypes
Преобразование типов данных:Используйте методastype.
df['Column1'] = df['Column1'].astype('float64')
Объединение и разделение DataFrame
Слияние:Используйте методconcatилиmerge.
# 纵向合并
pd.concat([df1, df2], ignore_index=True)

# 横向合并
pd.merge(df1, df2, on='Column1')
Разделение:Используйтеpivot、meltили пользовательские функции.
# 长格式转宽格式
df_pivot = df.pivot(index='Column1', columns='Column2', values='Column3')

# 宽格式转长格式
df_melt = df.melt(id_vars='Column1', value_vars=['Column2', 'Column3'])
Индексация и срезы
DataFrame поддерживает операции индексации и среза по строкам и столбцам.
Пример
print(df[['Name', 'Age']]) # Извлечь несколько столбцов
print(df[1:3]) # Срез строк
print(df.loc[:, 'Name']) # Извлечь один столбец
print(df.loc[1:2, ['Name', 'Age']]) # Извлечь указанные строки и столбцы с помощью индексации по меткам
print(df.iloc[:, 1:]) # Извлечь указанные столбцы с помощью позиционной индексации
Примечания
DataFrameЭто гибкая структура данных, которая может содержать столбцы разных типов данных.- Имена столбцов и индексы строк могут быть строками, целыми числами и т. д.
DataFrameВыбор, фильтрация, изменение и анализ данных могут выполняться многими способами.- Через
DataFrameоперации, вы можете выполнять очистку данных, преобразование, анализ, визуализацию и многое другое.