Agent IA
Vous êtes peut-être habitué à ce type d'interaction : vous posez une question et l'IA donne une réponse.
-
Vous lui demandez d'écrire un article, et il écrit un article.
-
Vous lui demandez de traduire une phrase, et il traduit une phrase.
Dans ce mode, l'IA ressemble davantage à un consultant — elle vous donne des conseils, mais n'agit pas directement.
Mais que se passe-t-il si la tâche est légèrement plus complexe ? Par exemple : aidez-moi à vérifier la météo de demain à Pékin. Si la température dépasse 25 degrés, recommandez une chemise à manches courtes dans un budget de 300 yuan, puis rassemblez les résultats dans un e-mail et envoyez-le à mon chef.
Avec une IA conversationnelle ordinaire, vous devez la décomposer en plusieurs étapes :
-
Étape 1 : Vérifiez la météo de demain à Pékin.
-
Étape 2 : Si elle dépasse 25 degrés, recommandez une chemise à manches courtes dans la limite de 300 yuan.
-
Étape 3 : Écrire un e-mail à mon patron avec le contenu ...
Chaque étape vous oblige à avancer manuellement.
etAgent IAL'idée est : vous dites simplement « aidez-moi à faire ceci » une fois, et il s'occupera tout seul du reste.
Il déterminera automatiquement ce qui doit être fait, quels outils appeler, dans quel ordre les exécuter, et comment s'adapter lorsque des problèmes surviennent, jusqu'à ce que la tâche soit terminée.
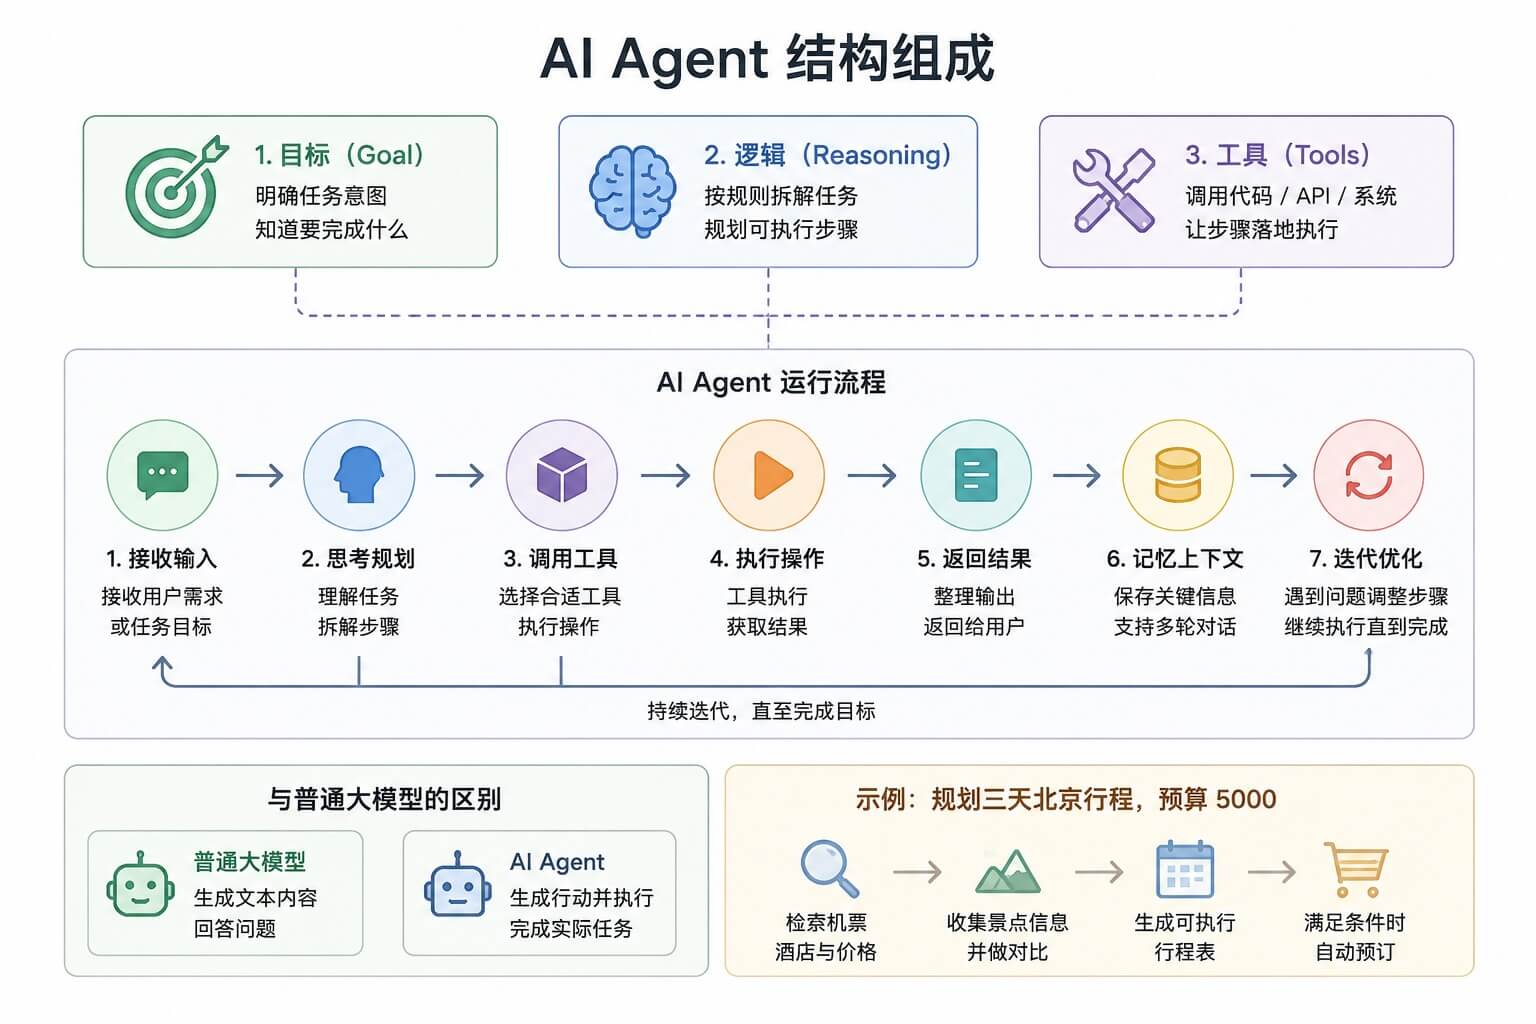
Compréhension simple : un LLM classique est un stratège qui vous donne des conseils ; un agent IA est un exécutant qui prend l'objectif et va accomplir les choses par lui-même.
Qu'est-ce qu'un agent IA ?
Un agent IA est un système autonome qui peut percevoir son environnement, prendre des décisions et entreprendre des actions.
Une définition plus académique est :Un Agent est une entité située dans un environnement ; il perçoit l'environnement au moyen de capteurs et agit sur l'environnement au moyen d'actionneurs afin d'atteindre un ensemble d'objectifs.。
Cette définition semble un peu abstraite, alors décomposons-la en langage simple.
Agent vs. LLM classique
Tout d'abord, jetez un œil à un tableau comparatif :
| Fonctionnalité | LLM classique | Agent IA |
|---|---|---|
| Mode d'interaction | Questions-réponses, pilotées par l'utilisateur | Exécution autonome, pilotée par objectif |
| Frontière des capacités | Uniquement les capacités intégrées du modèle | Peut étendre ses capacités grâce à des outils |
| Mémoire | Contexte de conversation (limité) | Mémoire à court terme + mémoire à long terme |
| Planification | Aucun (ou nécessite des indications de l'utilisateur) | Décomposition et planification autonomes des tâches |
| Boucle de rétroaction | Aucune (génération unique) | Boucle observer-réfléchir-agir |
Prenons un exemple concret : « Aide-moi à réserver un vol de Shanghai à Pékin demain, à un prix inférieur à 1,500 yuan. »
Un LLM classique pourrait répondre : « D'accord, je peux t'écrire un extrait de code pour interroger les prix des vols, ou te dire quel site web consulter. » Mais il ne va pas réellement rechercher des vols, encore moins t'en réserver un.
Un Agent qualifié, en revanche, fera ce qui suit :
-
1. Comprendre l'objectif : Réserver un vol de Shanghai à Pékin demain, pour moins de 1,500 yuan.
-
2. Décider d'une action : Je dois appeler une API de recherche de vols.
-
3. Exécuter l'action : Appeler l'API et obtenir la liste des vols.
-
4. Observer les résultats : 10 vols obtenus, dont 3 à moins de 1,500 yuan.
-
5. Réfléchir à nouveau : Lequel choisir ? Peut-être faut-il vérifier les horaires de départ et d'arrivée, ou demander les préférences de l'utilisateur.
-
6. Continuer d'agir : Peut-être appeler une autre API pour vérifier les taux de ponctualité, ou recommander directement des options à l'utilisateur.
-
7. Terminer la tâche : Aider l'utilisateur à réserver une place et générer un lien de commande.
Voyez-vous la différence ?Un LLM classique vous donne des réponses ; un Agent vous donne des résultats.。
Capacités principales d'un Agent
Un Agent complet possède généralement les trois capacités principales suivantes :
| Capacité | Description | Analogie |
|---|---|---|
| Perception | Obtenir des informations environnementales et des retours | Yeux, oreilles |
| Décision | Réfléchir à ce qu'il faut faire et comment le faire | Cerveau |
| Action | Exécuter des opérations spécifiques | Mains, pieds |
-
Perception, signifie que l'Agent peut voir ce qui se passe. Par exemple, un utilisateur envoie un message, une API renvoie un résultat, ou un nouveau fichier est ajouté au système de fichiers—ce sont toutes des entrées de perception.
-
Décision, signifie que l'Agent décide quoi faire ensuite en fonction des informations perçues. Doit-il répondre directement à l'utilisateur ? A-t-il besoin d'appeler un outil ? Doit-il décomposer une grande tâche en sous-tâches plus petites ? Ce sont toutes des décisions.
-
Action, signifie que l'Agent exécute réellement les décisions. Appeler une API de recherche, lire un fichier, envoyer un e-mail, exploiter une base de données—ce sont toutes des actions.
Architecture de base d'un Agent
Voyons maintenant le « puzzle en quatre pièces » standard de l'Agent : cerveau, outils, mémoire et planification.
Tout d'abord, examinons un diagramme d'architecture :

Cerveau : le LLM en tant que cœur du raisonnement
Le cerveau d'un Agent est généralement un grand modèle de langage, tel que GPT-4, Claude, Llama, etc.
Ce LLM est responsable de :
-
1. Comprendre l'intention de l'utilisateur : lorsque l'utilisateur dit « aide-moi à réserver un billet », que veut-il vraiment ?
-
2. Prendre des décisions : que dois-je faire ensuite ?
-
3. Générer les paramètres d'appel d'outil : quels paramètres sont nécessaires pour appeler une API de recherche de vols ?
-
4. Organiser la réponse finale : maintenant que suffisamment d'informations ont été collectées, comment donner à l'utilisateur un résumé clair ?
Le LLM est le cœur d'un Agent, mais pas tout — tout comme le cerveau humain est important, mais il vous faut quand même des mains et des pieds pour mener les choses à bien.
Outils : étendre les frontières des capacités de l'IA
Les LLM natifs ont deux limites évidentes :
-
1. Limite de connaissances : il ne sait pas ce qui s'est passé après la fin de l'entraînement.
-
2. Aucune capacité d'interaction : il ne peut pas lire directement des fichiers, interroger des bases de données ou appeler des API.
Les outils sont conçus pour résoudre ces problèmes.
Types d'outils courants :
| Type d'outil | Fonction | Exemple |
|---|---|---|
| Outils de recherche | Obtenir les dernières informations | Recherche Google、Recherche Bing |
| Outils de calcul | Effectuer des opérations mathématiques | Calculatrice, Wolfram Alpha |
| Opérations sur les fichiers | Lire/écrire des fichiers locaux | Lire des PDF, écrire des CSV |
| Appels API | Interagir avec des systèmes externes | Réserver des vols, envoyer des e-mails, vérifier la météo |
| Requêtes de base de données | Stocker et récupérer des données structurées | Requêtes SQL, récupération vectorielle |
| Exécution de code | Exécuter du code pour résoudre des problèmes | Python REPL, Jupyter |
Donner des outils à un agent, c'est comme équiper une personne d'un ordinateur — il passe instantanément du simple fait de pouvoir penser à celui de pouvoir agir.
Mémoire : court terme vs. long terme
Les LLMs sont naturellement amnésiques — chaque conversation repart de zéro, sauf si vous y intégrez le contexte.
Et un agent doit se souvenir de beaucoup de choses :
Mémoire à court terme : Que vient de dire l'utilisateur ? Quel outil ai-je appelé à l'étape précédente ? Quel résultat ai-je obtenu ?
-
Mémoire à long terme : Quelles sont les préférences de l'utilisateur ? Comment des tâches similaires ont-elles été traitées dans le passé ? Quelles leçons ont été tirées ?
Approches d'implémentation courantes pour les systèmes de mémoire :
| Type de mémoire | Contenu stocké | Méthode d'implémentation |
|---|---|---|
| Mémoire à court terme | Historique de conversation et étapes intermédiaires de la session en cours | Placé directement dans la fenêtre de contexte du LLM |
| Mémoire à long terme | Préférences de l'utilisateur, tâches historiques, documents de connaissances | Base de données vectorielle + recherche de similarité |
| Mémoire récapitulative | Résumés historiques compressés | Demander au LLM de générer des résumés périodiquement |
Un bon système de mémoire peut donner à un Agent l'impression qu'il se souvient de vous, plutôt que d'agir comme s'il vous rencontrait pour la première fois à chaque fois.
Planification : décomposition des tâches
Les tâches complexes ne seront pas accomplies en une seule étape ; un Agent doit pouvoir décomposer un grand objectif en étapes plus petites.
Par exemple : Aidez-moi à planifier une fête d'anniversaire pour 10 personnes.
L'Agent pourrait le planifier ainsi :
-
1. D'abord clarifier : Quel est le budget ? Quand est-ce ? Où est-ce ? Quelles sont les préférences de la personne fêtée ?
-
2. Ensuite : Rechercher des lieux à proximité.
-
3. Puis : Concevoir le menu.
-
4. Ensuite : Faites une liste de courses.
-
5. Enfin : Générez un planning.
Stratégies de planification courantes :
-
Chaîne de pensée : Réfléchissez étape par étape — ce qu'il faut faire d'abord, ce qu'il faut faire ensuite.
-
Arbre de pensée : Envisagez plusieurs chemins possibles en même temps et choisissez le chemin optimal.
-
Réflexion : Après avoir terminé une étape, revenez en arrière et vérifiez s'il y a des problèmes et si des ajustements sont nécessaires.
Utilisation d'outils / Appel de fonctions
L'appel d'outils est la capacité la plus fondamentale et la plus importante d'un Agent.
Commençons par expliquer ce que c'est.
Qu'est-ce que l'appel de fonction ?
En termes simples :L'appel de fonction, c'est lorsque le LLM produit un JSON structuré indiquant quelle fonction il souhaite appeler et quels paramètres transmettre.。
Ce n'est pas que le LLM exécute réellement la fonction — il vous dit simplement qu'il veut l'appeler, et c'est encore à vous de faire l'exécution.
L'ensemble du processus se déroule généralement comme ceci :
-
1. Vous dites au LLM : « Voici quelques fonctions que vous pouvez appeler. Le nom, les paramètres et l'objectif de chaque fonction sont... »
-
2. L'utilisateur envoie un message : « Aidez-moi à vérifier la météo de demain à Pékin. »
-
3. Le LLM répond : « Je veux appeler la fonction get_weather, avec les paramètres city='Beijing', date='tomorrow'. »
-
4. Vous appelez la fonction (en interrogeant réellement l'API météo) et obtenez le résultat.
-
5. Vous renvoyez le résultat au LLM : « L'appel de fonction précédent a renvoyé : température 25 degrés, ensoleillé. »
-
6. D'après ce résultat, le LLM donne à l'utilisateur une réponse en langage naturel : « Pékin sera ensoleillé demain, 25 degrés, très agréable. »
Vous voyez ? C'est le LLM qui réfléchit, et vous qui exécutez.
Définir le schéma JSON d'un outil
Pour que le LLM appelle des outils, vous devez d'abord lui indiquer quels outils sont disponibles.
Ce processus d'indication consiste à décrire les fonctions avec un schéma JSON.
Regardons un format standard de définition de fonction :
Exemple
tool_definition = {
"type": "function",
"function": {
"name": "get_weather", # Nom de la fonction
"description": "Interroger la météo pour une ville spécifiée à une date spécifiée", # Description du but de la fonction ; le LLM la consultera
"parameters": {
"type": "object",
"properties": {
"city": {
"type": "string",
"description": "Nom de la ville, par exemple 'Pékin', 'Shanghai', 'Shenzhen'",
},
"date": {
"type": "string",
"description": "Date, au format AAAA-MM-JJ, par exemple '2024-06-18'",
},
"unit": {
"type": "string",
"enum": ["celsius", "fahrenheit"],
"description": "Unité de température, Celsius ou Fahrenheit, par défaut Celsius",
},
},
"required": ["city", "date"], # Paramètres requis
},
},
}
# Un autre outil : Search
search_tool = {
"type": "function",
"function": {
"name": "web_search",
"description": "Rechercher sur Internet les dernières informations, adapté pour vérifier les actualités, les données en temps réel et les connaissances inconnues",
"parameters": {
"type": "object",
"properties": {
"query": {
"type": "string",
"description": "Mot-clé ou question de recherche",
},
"num_results": {
"type": "integer",
"description": "Nombre de résultats à renvoyer, par défaut 5",
"default": 5,
},
},
"required": ["query"],
},
},
}
# Autre outil : Calculatrice
calculator_tool = {
"type": "function",
"function": {
"name": "calculate",
"description": "Effectuer des calculs mathématiques, prenant en charge l'addition, la soustraction, la multiplication, la division, l'exponentiation, etc.",
"parameters": {
"type": "object",
"properties": {
"expression": {
"type": "string",
"description": "Expression mathématique, par ex. '25 * 4 + 10', 'sqrt(16)'",
},
},
"required": ["expression"],
},
},
}
print(f{len([tool_definition, search_tool, calculator_tool])} outils définis : get_weather, web_search, calculate)
# Sortie : 3 outils définis : get_weather, web_search, calculate
Points clés :
-
description est très importante — le LLM s'appuie sur cette description pour comprendre ce que fait l'outil et quand l'utiliser.
-
Les paramètres doivent aussi être décrits clairement — par exemple, si unit a une contrainte enum, le LLM sait qu'il ne peut choisir que parmi ces deux valeurs.
-
required marque les champs obligatoires — le LLM veillera à ce que ces paramètres aient toujours des valeurs.
Code pratique : ajouter des outils de recherche et de calcul à l'IA
Écrivons maintenant un exemple complet et exécutable.
Pour la démonstration, nous utilisons Python pour simuler le flux complet de Function Calling.
Exemple
# Une démo simplifiée d'appel d'outil d'Agent
# Aucune clé API réelle nécessaire, démonstration avec des données simulées
# ============================================
import json
import random
from typing import Dict, Any, List, Optional
class SimpleAgent:
"""Une simple classe de démonstration Agent"""
def __init__(self):
# Enregistrer les outils disponibles
self.tools = self._define_tools()
# Historique de la conversation (mémoire)
self.messages: List[Dict] = []
def _define_tools(self) -> List[Dict]:
"""Définir tous les outils disponibles"""
return [
{
"name": "web_search",
"description": "Rechercher sur Internet les dernières informations",
"parameters": {
"query": {"type": "string", "description": "Mot-clé de recherche"},
},
"required": ["query"],
},
{
"name": "calculate",
"description": "Effectuer des calculs mathématiques",
"parameters": {
"expression": {"type": "string", "description": "Expression mathématique"},
},
"required": ["expression"],
},
{
"name": "get_weather",
"description": "Interroger la météo",
"parameters": {
"city": {"type": "string", "description": "Nom de la ville"},
"date": {"type": "string", "description": "Date"},
},
"required": ["city", "date"],
},
]
def _call_tool(self, tool_name: str, parameters: Dict[str, Any]) -> str:
"""(Simulé) Appeler l'outil et renvoyer le résultat"""
print(f" [Appel d'outil] {tool_name}({parameters})")
if tool_name == "web_search":
query = parameters["query"]
# Résultat de recherche simulé
results = {
"example": Example (Rookie Tutorial) est un site d'apprentissage de la programmation qui propose un grand nombre de tutoriels et d'exemples de programmation.,
"Météo à Pékin le 18 juin 2024": "Pékin 2024-06-18 : Ensoleillé, 25°C, humidité 45%.",
"Population de Shanghai": "La population résidente de Shanghai en 2024 est d'environ 24.89 millions.",
}
return results.get(query, f"Résultats de recherche : aucune information exacte trouvée pour '{query}', il s'agit d'un résultat simulé.")
elif tool_name == "calculate":
expr = parameters["expression"]
try:
# Remarque : Ne pas utiliser eval en production ; ceci est juste pour la démonstration
result = eval(expr, {"__builtins__": None}, {
"sqrt": lambda x: x**0.5,
"pow": pow,
})
return f"Résultat du calcul : {expr} = {result}"
except Exception as e:
return f"Erreur de calcul : {e}"
elif tool_name == "get_weather":
city = parameters["city"]
date = parameters["date"]
# Données météorologiques simulées
weathers = ["Ensoleillé", "Nuageux", "Pluie légère", "Couvert"]
temp = random.randint(15, 35)
return f"{city} {date}:{random.choice(weathers)},{temp}°C"
else:
return f"Outil inconnu : {tool_name}"
def _decide_action(self, user_input: str) -> Dict[str, Any]:
"""
(Simulé) Processus de décision du LLM
Dans un projet réel, c'est ici que l'API LLM réelle serait appelée
"""
# Ici, des règles simples sont utilisées pour la simulation ; dans des scénarios réels, un LLM devrait être utilisé
if "Search" in user_input or "Look up" in user_input or "What is" in user_input:
# Extraire le terme de recherche (simulation simple)
query = user_input.replace("Search", "").replace("Rechercher", "").replace("Qu'est-ce que", "").strip()
if not query:
query = "exemple"
return {
"action": "call_tool",
"tool": "web_search",
"parameters": {"query": query},
}
elif "Calculate" in user_input or "equals" in user_input:
# Extraire l'expression (simulation simple)
return {
"action": "call_tool",
"tool": "calculate",
"parameters": {"expression": "25 * 4 + 10"}, # Exemple de valeurs fixes
}
elif "weather" in user_input:
return {
"action": "call_tool",
"tool": "get_weather",
"parameters": {"city": "Beijing", "date": "2024-06-18"},
}
else:
return {
"action": "respond",
"content": "D'accord, laissez-moi vous aider avec ceci." + user_input,
}
def run(self, user_input: str) -> str:
"""Exécuter l'Agent pour traiter l'entrée utilisateur"""
print(f"[Entrée utilisateur] {user_input}")
self.messages.append({"role": "user", "content": user_input})
# Étape 1 : Décider quoi faire
decision = self._decide_action(user_input)
if decision["action"] == "call_tool":
# Étape 2 : Appeler l'outil
tool_result = self._call_tool(decision["tool"], decision["parameters"])
self.messages.append({"role": "tool", "content": tool_result})
# Étape 3 : Générer la réponse finale en fonction du résultat de l'outil
# (Simple concaténation ici ; en réalité, le LLM devrait la générer)
final_response = f"D'après ma requête : {tool_result}\n\nJ'espère que cette information vous sera utile !"
self.messages.append({"role": "assistant", "content": final_response})
return final_response
else:
# Répondre directement
self.messages.append({"role": "assistant", "content": decision["content"]})
return decision["content"]
# ============================================
# Tester cet agent
# ============================================
agent = SimpleAgent()
print("=" * 60)
response1 = agent.run("Rechercher ce qu'est l'exemple")
print(f"[Réponse de l'agent]\n{response1}")
print("\n" + "=" * 60)
response2 = agent.run("Aide-moi à vérifier la météo à Pékin le 2024-06-18")
print(f"[Réponse de l'agent]\n{response2}")
print("\n" + "=" * 60)
response3 = agent.run("Calcule combien font 25 * 4 + 10")
print(f"[Réponse de l'agent]\n{response3}")
Bien que cet exemple soit simple, il démontre la boucle fermée complète de l'appel de fonction :
Comprendre → Décider → Appeler l'outil → Observer le résultat → Générer une réponse.
Dans un projet réel,_decide_actioncette étape serait remplacée par un véritable appel à un LLM, laissant le modèle décider quel outil utiliser et quels paramètres transmettre.
Boucle de planification ReAct
Une fois les capacités d'appel d'outils en place, la question suivante est : quand s'arrêter ?
Les tâches simples peuvent être réalisées en une seule étape, mais les tâches complexes nécessitent souvent plusieurs cycles d'itération.
C'est le problème que le framework ReAct vise à résoudre.
Pensée → Action → Observation
Le nom ReAct vient de la combinaison du raisonnement et de l'action.
Son idée centrale est simple : laisser l'Agent, comme un humain, penser une étape, agir une étape, observer, puis répéter cette boucle jusqu'à ce que la tâche soit terminée.
Regardons un organigramme :

Chaque cycle se compose de trois étapes :
| Étape | Anglais | Ce qu’il fait |
|---|---|---|
| Pensée | Pensée | Que dois-je faire maintenant ? Pourquoi ? |
| Action | Action | Appeler un outil pour effectuer une opération spécifique |
| Observation | Observation | Enregistrer le résultat de l'action |
Revenez ensuite à Pensée — en fonction des résultats observés, décidez quoi faire ensuite.
Cette boucle continue jusqu'à ce que l'Agent détermine que la tâche est terminée, auquel cas il quitte la boucle et fournit la réponse finale.
Utilisons un exemple concret pour voir comment ReAct fonctionne :
-
Question de l'utilisateur: En quelle année SpaceX a-t-elle été fondée ? Quel était le nom de sa première fusée à avoir réussi à atteindre l'orbite ?
-
Pensée 1: Je dois trouver l'année de fondation de SpaceX et le modèle de sa première fusée à avoir réussi un lancement orbital. Ces informations peuvent provenir de sources différentes, il est donc préférable d'effectuer une recherche avec des mots-clés couvrant les deux à la fois.
-
Action 1: Appeler web_search pour interroger "date de fondation de SpaceX première fusée orbitale".
-
Observation 1: Le résumé des résultats de recherche indique : "SpaceX (Space Exploration Technologies Corp.) a été fondée en 2002 par Elon Musk. Sa première fusée à entrer avec succès en orbite terrestre a été Falcon 1, qui a réussi lors de son quatrième vol d'essai le 28 septembre 2008." (L'information est complète et couvre les deux sous-questions.)
-
Pensée 2: Les résultats de recherche fournissent déjà à la fois l'année de fondation (2002) et la première fusée orbitale (Falcon 1). Il n'y a pas d'ambiguïté et l'information est crédible. Aucune recherche supplémentaire n'est nécessaire.
-
Réponse finale: SpaceX a été fondée en 2002, et sa première fusée à atteindre avec succès l'orbite a été Falcon 1, qui a atteint ce jalon le 28 septembre 2008.
-
Remarque: Vous voyez ? Chaque étape comporte clairement une "Pensée", une "Action" et une "Observation", et l'Agent juge par lui-même quand s'arrêter — ici, il n'a fallu qu'un seul tour d'action pour recueillir toutes les informations nécessaires, donc il est passé directement à la réponse finale sans boucles supplémentaires.
Conditions d'arrêt de la boucle
La boucle ReAct ne peut pas fonctionner indéfiniment ; elle a besoin d'une condition d'arrêt.
Conditions de terminaison courantes :
| Condition de terminaison | Description | Exemple |
|---|---|---|
| Tâche terminée | L'Agent détermine que suffisamment d'informations ont été collectées pour répondre à la question de l'utilisateur. | J'ai trouvé la réponse, je peux maintenant répondre. |
| Nombre maximal d'étapes atteint. | Pour éviter les boucles infinies, définissez un nombre maximal de tours (par exemple, 10 étapes). | Déjà itéré 10 fois, arrêt forcé. |
| Interruption utilisateur | L'utilisateur dit spontanément "stop" ou "assez". | Pas besoin de vérifier, je sais. |
| Échec certain. | L'agent juge que cette tâche ne peut pas être accomplie. | J'ai cherché plusieurs fois, mais je n'ai pas pu trouver les informations pertinentes. |
Lors de la conception d'un Agent, veillez à prévoir une soupape de sécurité « nombre maximal d'étapes » — sinon, il risque de tourner en rond et de ne jamais s'arrêter.
Conception du système de mémoire
Lorsqu'un agent travaille longtemps, il rencontre un problème : la fenêtre de contexte ne peut pas contenir tout l'historique de conversation.
À ce stade, un bon système de mémoire est nécessaire.
Historique de conversation : mémoire à court terme
La mémoire la plus simple consiste à sauvegarder complètement l'historique de conversation.
À chaque fois, tous les messages précédents sont injectés dans le LLM, afin qu'il puisse se souvenir de ce qui vient de se passer.
Mais cette approche présente un inconvénient évident : la fenêtre de contexte du LLM est limitée.
Par exemple, GPT-4, c'est 8K ou 32K, et Claude, 200K — même si c'est grand, ce n'est toujours pas infini.
Tout va bien quand la conversation est courte, mais dès qu'elle devient très longue, ou que chaque tour d'appels d'outils renvoie beaucoup de contenu, l'espace vient vite à manquer.
Base de données vectorielle : mémoire à long terme
Lorsqu'il y a trop de choses à mémoriser et que le contexte ne peut pas les contenir, une solution courante consiste à :stocker les mémoires dans une base de données vectorielle et « récupérer » celles qui sont pertinentes lorsque c'est nécessaire.。
Cette approche s'appelle RAG (Retrieval-Augmented Generation), et elle s'applique tout autant aux Agents.
Flux de travail :
-
Chaque fois qu'une mémoire est générée (ce que l'utilisateur a dit, le résultat renvoyé par l'outil, la réflexion de l'Agent), elle est convertie en un vecteur (Embedding).
-
2. Stocker ce vecteur dans la base de données vectorielle.
-
3. Lorsque l'Agent doit se rappeler, convertir également la question actuelle en un vecteur.
-
4. Rechercher dans la base de données vectorielle les quelques mémoires « les plus similaires ».
-
5. Ne placer que ces quelques mémoires pertinentes dans le contexte du LLM.
Ainsi, même s'il y a dix mille mémoires historiques, seules les plus pertinentes doivent être récupérées et utilisées.
Compression de mémoire par résumés
Un autre schéma d'optimisation de la mémoire :Ne stockez pas les textes complets des conversations ; à la place, un grand modèle génère périodiquement des résumés concis des sessions historiques, et seuls les résumés sont enregistrés de manière persistante.。
Dialogue long d'origine :
Utilisateur : Aide-moi à vérifier la météo.
-
Agent : Quelle ville vérifier ?
-
Utilisateur : Pékin.
-
Agent : Quel jour ?
-
Utilisateur : Demain.
-
……
Résumé compressé :
用户需要查询北京明日天气,Agent 先后确认城市与日期,用户明确查询时间为明天。
Cette approche peut réduire considérablement la surcharge de Token : une conversation complète qui occupait initialement 500 Tokens n'a besoin que d'un résumé de 50 Tokens pour conserver les informations essentielles.
Les projets de production utilisent généralement plusieurs solutions ensemble, en gérant la mémoire de conversation en couches :
- Dialogues les plus récents : entièrement conservés, directement envoyés dans le contexte du modèle ;
- Dialogues historiques éloignés : générer uniformément des résumés, en remplaçant le texte original par des résumés ;
- Informations clés à long terme : stockées dans une base de données vectorielle, récupérées à la demande.
Frameworks d'Agent courants
Après avoir compris les principes, vous pouvez écrire votre propre Agent, ou utiliser des frameworks existants.
Les plus populaires aujourd'hui sont :
Agents LangChain
LangChain est actuellement le framework de développement d'applications LLM le plus populaire, et il intègre un système d'Agent.
Concepts clés :
Agent : le cerveau, décide de ce qu'il faut faire.
Tools : liste d'outils.
Toolkits : suites d'outils (par exemple, regrouper plusieurs outils liés aux bases de données).
AgentExecutor : l'exécuteur, responsable de l'exécution de la boucle ReAct.
L'avantage de LangChain est son écosystème riche — de nombreuses intégrations d'outils prêtes à l'emploi, immédiatement utilisables.
L'inconvénient est qu'il paraît parfois un peu lourd, avec de nombreuses couches d'abstraction, ce qui rend le débogage difficile en cas de problème.
Agents LlamaIndex
LlamaIndex (anciennement appelé GPT Index) se concentre davantage sur la connexion des données — connecter vos données privées (documents, bases de données, APIs) au LLM.
Ses points forts en tant qu'Agent sont :
-
1. Interroger des données structurées et non structurées.
-
2. Effectuer le routage entre plusieurs sources de données.
-
3. Effectuer du question-réponse documentaire (RAG).
Si votre Agent doit travailler intensivement avec "vos données", LlamaIndex est un bon choix.
Principes d'AutoGPT
AutoGPT est un projet devenu populaire au début de 2023, et sa caractéristique est : l'autonomie totale.
Vous lui donnez un objectif ambitieux (par ex., "aidez-moi à créer un site web"), et il va de lui-même :
-
1. Générer une liste de tâches.
-
2. Exécuter les tâches.
-
3. S'auto-évaluer.
-
4. Ajuster le plan.
-
5. Continuer d'avancer.
AutoGPT a permis à de nombreuses personnes de découvrir pour la première fois la puissance des « Agents autonomes », mais il a aussi exposé de nombreux problèmes liés aux Agents :
Il continue souvent à avancer dans la mauvaise direction sans couper les pertes à temps.
Il est enclin à tomber dans des boucles infinies et à répéter les mêmes actions.
Coût élevé — une exécution peut dépenser des dizaines de dollars en frais d'API.
Mais AutoGPT est très instructif en tant que preuve de concept.
CrewAI multi-agents
Ce dont nous venons de parler concerne des Agents uniques, tandis que l'approche de CrewAI consiste à : laisser plusieurs Agents former une équipe et collaborer.
Par exemple, vous pouvez définir :
Agent Product Manager : responsable de la compréhension des besoins et de la rédaction des PRD.
Agent Ingénieur : responsable de l'écriture du code.
Agent Réviseur : responsable de la revue de code et de fournir des retours.
Ensuite, laissez-les collaborer comme une vraie équipe — discuter entre eux, attribuer des tâches et fournir des résultats.
Le multi-agent est une direction très prometteuse : un seul Agent peut faire des erreurs, mais plusieurs Agents peuvent se corriger mutuellement et se compléter.
Pratique : Construire un Agent automatisé de collecte d'informations
Maintenant, rassemblons les points de connaissance précédents et écrivons un Agent vraiment utilisable.
L'Agent que nous allons créer s'appelleexample-researcher— donnez-lui un sujet, et il recherchera, organisera et générera automatiquement un rapport de recherche.
Exemple
# Pratique : Agent automatique de collecte d'informations
# ============================================
import json
import time
from typing import Dict, Any, List
class ResearchAgent:
"""
Un Agent simple orienté recherche :
Étant donné un sujet, rechercher automatiquement des informations pertinentes et les organiser en un rapport
"""
def __init__(self, max_steps: int = 5):
self.max_steps = max_steps
self.memory: List[Dict] = [] # Mémoire
self.known_facts: List[str] = [] # Faits collectés
self.queries_used: List[str] = [] # Termes de recherche utilisés
def _search_web(self, query: str) -> str:
"""(Simulée) recherche web"""
print(f" Recherche : {query}")
time.sleep(0.5) # Délai simulé
# Base de connaissances simulée
knowledge_base = {
"Intelligence artificielle": "L'intelligence artificielle (IA) est une branche de l'informatique dédiée à la création de systèmes capables d'effectuer des tâches qui nécessitent généralement l'intelligence humaine.",
"Apprentissage automatique": "L'apprentissage automatique est un sous-ensemble de l'intelligence artificielle qui permet aux ordinateurs d'apprendre à partir de données sans être explicitement programmés.",
"Apprentissage profond": "L'apprentissage profond est un sous-ensemble de l'apprentissage automatique, basé sur des réseaux de neurones multicouches, particulièrement adapté au traitement de données non structurées telles que les images et le texte.",
"Grand modèle de langage": "Un grand modèle de langage (LLM) est un modèle d'IA basé sur l'architecture Transformer, entraîné sur d'énormes quantités de texte, capable de comprendre et de générer le langage humain.",
"Agent": "Un agent IA est un système qui peut percevoir son environnement de manière autonome, prendre des décisions et agir, généralement composé de quatre parties : LLM, outils, mémoire et planification.",
"Transformer": Transformer est une architecture de réseau de neurones proposée par Google en 2017, et constitue la base des LLM modernes, avec pour cœur le mécanisme d'attention.,
"example": Example (example) a été fondé en 2013 et est un site web axé sur les tutoriels de programmation, fournissant des ressources d'apprentissage pour plusieurs langages de programmation.,
}
# Trouver les connaissances les plus pertinentes
for key, value in knowledge_base.items():
if key in query:
return value
return fRésultats de recherche pour '{query}' : Ceci est un sujet très intéressant, impliquant plusieurs domaines techniques. (Résultat simulé)
def _think(self, step: int, user_topic: str) -> Dict[str, Any]:
"""
Réfléchir à ce qu'il faut faire ensuite
(Dans un projet réel, il faudrait appeler un LLM ici)
"""
# Règles heuristiques simples pour simuler le processus de réflexion
if step == 1:
# Étape 1 : Rechercher d'abord le sujet lui-même
return {
"thought": fJe dois d'abord comprendre la définition de base et le contexte de '{user_topic}'.,
"action": "search",
"query": user_topic,
}
elif step == 2:
# Étape 2 : Rechercher les technologies associées
return {
"thought": Maintenant que j'ai la définition de base, je dois rechercher les technologies et concepts associés.,
"action": "search",
"query": fTechnologies associées pour {user_topic},
}
elif step < self.max_steps:
# Étape intermédiaire : Continuer à approfondir
return {
"thought": Laissez-moi rechercher plus d'informations sous davantage de dimensions pour rendre le rapport plus riche.,
"action": "search",
"query": fScénarios d'application pour {user_topic},
}
else:
# Étape finale : Compiler le rapport
return {
"thought": J'ai collecté suffisamment d'informations, et je peux maintenant compiler le rapport final.,
"action": "finish",
}
def _observe(self, action_result: str):
"""Observer les résultats, enregistrer dans la mémoire"""
self.known_facts.append(action_result)
self.memory.append({
"role": "observation",
"content": action_result,
})
def _generate_report(self, topic: str) -> str:
"""Générer un rapport à partir des informations collectées"""
report = f"# {topic} Rapport de recherche\n\n"
report += f"> Ce rapport a été généré automatiquement par example-researcher\n\n"
report += "---\n\n"
report += "## Points clés\n\n"
for i, fact in enumerate(self.known_facts, 1):
report += f"{i}. {fact}\n\n"
report += "---\n\n"
report += "## Résumé\n\n"
report += f"Ce qui précède est l'information principale compilée sur '{topic}'."
report += "Si vous avez besoin de recherches plus approfondies, vous pouvez effectuer une recherche plus poussée sur des articles universitaires ou de la documentation technique pertinents.\n"
return report
def run(self, topic: str) -> str:
"""Exécuter l'agent de recherche"""
print(f" example-researcher a démarré !")
print(f" Sujet de recherche : {topic}")
print("-" * 50)
for step in range(1, self.max_steps + 1):
print(f"\nÉtape {step} / {self.max_steps} étapes)
# 1. Réflexion
decision = self._think(step, topic)
print(f" Réflexion : {decision['thought']}")
if decision["action"] == "finish":
print(" Collecte terminée, début de la compilation du rapport...")
break
# 2. Action
if decision["action"] == "search":
result = self._search_web(decision["query"])
print(f" Résultat : {result[:60]}...")
# 3. Observation
self._observe(result)
# Générer le rapport final
print("\n" + "-" * 50)
print(" Génération du rapport de recherche...")
final_report = self._generate_report(topic)
return final_report
# ============================================
# Essayez-le
# ============================================
agent = ResearchAgent(max_steps=4)
report = agent.run("Agent")
print("\n" + "=" * 50)
print(report)
print("=" * 50)
Bien que cet Agent simplifie les appels au LLM (simulés avec des règles), l'ensemble du flux de travail est véritablement utilisable.
Il vous suffit de_thinkremplacer la méthode par de véritables appels à l'API LLM, et_search_webremplacez-le par une véritable API de recherche, et il pourra vraiment vous aider à faire de la recherche.
Limites et modes de défaillance des agents
Les agents IA sont puissants, mais ils ne sont pas omnipotents.
Comprendre ses limites vous aide à l'utiliser dans les bons scénarios et à éviter les pièges.
Modes de défaillance courants
1. Sélection d'outil incorrecte
Lorsqu'un utilisateur pose une question sur la météo, l'agent fait appel à une recherche ; lorsqu'un utilisateur veut effectuer une recherche, l'agent fait appel à une calculatrice.
Ce type d'erreur est très courant, surtout lorsque les définitions d'outils ne sont pas assez claires.
2. Erreurs de passage de paramètres
Mauvais format de date, paramètres obligatoires manquants, types de paramètres incorrects — tout cela peut faire échouer les appels d'outils.
3. Boucle infinie
L'agent se retrouve bloqué dans une boucle infinie de « rechercher A → introuvable → rechercher A à nouveau → toujours introuvable → rechercher A encore une fois… »
4. Arrêt prématuré
Avant d'avoir collecté suffisamment d'informations, l'Agent décide que c'est « assez » et donne une réponse incomplète.
5. Hallucination
L'Agent peut fabriquer des outils qui n'existent pas, des paramètres qui n'existent pas, ou inventer de faux résultats de recherche.
6. Manque de bon sens
Parfois, l'Agent fait des choses qui semblent stupides aux humains — par exemple, lorsqu'un utilisateur dit « réserve-moi un vol pour demain », l'Agent cherche ce qu'est « demain », alors qu'il devrait en réalité utiliser la date d'aujourd'hui plus un jour.
Comment rendre les Agents plus fiables
Pour résoudre ces problèmes, l'industrie dispose de quelques stratégies d'atténuation couramment utilisées :
| Stratégie | Quel problème cela résout | Comment procéder |
|---|---|---|
| Humain dans la boucle | Empêcher l'Agent de s'engager sur la mauvaise voie | Faire confirmer les étapes clés par des humains, plutôt que d'être entièrement autonome |
| Définitions d'outils plus claires | Sélection incorrecte de l'outil | Rendez la description aussi détaillée que possible et fournissez des exemples |
| Nouvelle tentative + tolérance aux pannes | Échec d'appel d'outil | Réessayer automatiquement en cas d'échec, ou fournir au LLM un retour d'erreur clair |
| Imposer le format de sortie | Échec d'analyse des paramètres | Utilisez des contraintes JSON Schema, ou utilisez un Output Parser |
| Mécanisme de réflexion | Boucle infinie | Faire en sorte que l'Agent vérifie périodiquement : « Suis-je en train de répéter un travail inutile ? » |
Autres extensionsUne suggestion pratique : ne visez pas l'autonomie complète dès le départ. Commencez par un mode human-in-the-loop — l'agent propose quoi faire, et un humain confirme avant l'exécution. Une fois que vous avez confiance, déléguez progressivement plus d'autorité.