Основы больших языковых моделей (LLM)
Большая языковая модель (LLM) — это мозг AI-агента; её понимание является основой для создания интеллектуальных агентов.
Причина, по которой большая языковая модель может общаться с вами, писать статьи и программировать, по сути в том, что она на основе предоставленного вами текста (подсказки), слово за словом,угадываетвыдаёт наиболее разумное продолжение.
Проще говоря, большая языковая модель — это модель глубокого обучения, обученная на огромных текстовых данных, способная понимать и генерировать человеческий язык. Анализируя огромные объёмы текста в интернете, модель изучает статистические закономерности языка, и когда она получает входные данные, она генерирует наиболее разумное продолжение в соответствии с изученными закономерностями.

Мы можем представить большую языковую модель какчрезвычайно трудолюбивого студента с феноменальной памятью:
Этап обучения (тренировка): Она прочитала почти весь общедоступный текст в интернете — книги, статьи, веб-страницы, код и т. д. (объём данных может достигать триллионов слов). В этом процессе она не запоминает, а изучает чрезвычайно сложный набор языковых правил.
Этап применения (инференс): Когда вы задаёте ей вопрос или даёте инструкцию, она применяет изученные правила, чтобы слово за словом сгенерировать наиболее логичный и уместный по контексту ответ.
Её «масштабность» в основном проявляется в двух аспектах:
- Большой масштаб параметров: Модель содержит внутри десятки миллиардов или даже триллионы настраиваемых параметров, которые хранят изученные языковые знания.
- Большой объём обучающих данных: Объём текстовых данных, используемых для обучения, огромен и охватывает суть общедоступной информации в интернете.
На рисунке ниже показан процесс генерации текста LLM слово за словом — она предсказывает по одному слову за раз, затем включает это новое слово во входные данные, продолжает предсказывать следующее слово и повторяет этот цикл, пока не будет сгенерирован полный ответ:

Демонстрация анимации:
Каждый шаг делает только одно: на основе предшествующего текста предсказывает следующее слово.
Хотя LLM мощны, у них также есть явные ограничения:
| Способность | Описание | Ограничение |
|---|---|---|
| Отсечение знаний | Обучающие данные имеют дату отсечения | Не может знать новую информацию после обучения |
| Математические вычисления | Может выполнять простые вычисления | Сложные вычисления подвержены ошибкам |
| Информация в реальном времени | Требует помощи внешних инструментов | Не может самостоятельно получать данные в реальном времени |
| Достоверность фактов | Может генерировать неверную информацию | Требует проверки фактов |
| Обработка длинных текстов | Длина контекста имеет ограничения | В чрезвычайно длинных текстах может теряться информация |
| Логическая согласованность | Может быть противоречивой | Требует тщательного проектирования и проверки |
Важное напоминание:LLM не всеведущи; они по сути системы статистического сопоставления шаблонов. Только понимая их ограничения, можно лучше использовать их возможности.
Основной принцип работы: краткий анализ архитектуры Transformer
Выдающиеся возможности LLM неотделимы от их базовой ключевой технологии —архитектуры TransformerНет необходимости углубляться в сложные математические принципы, но можно понять её основные идеи.
Представьте, что вы хотите написать статью о Солнечной системе:
- Просмотр материаловСначала вы просмотрели бы множество соответствующих книг и веб-страниц.
- Определение ключевых моментовВы заметили бы, что такие слова, как Солнце, планеты, орбиты и гравитация, встречаются часто и взаимосвязаны.
- Организация языкаИсходя из тезиса, который вы хотите высказать (например, представить Марс), вы выборочно использовали бы ранее увиденную информацию о размере, цвете, расположении Марса и т. д. и организовывали бы её в связные предложения.
Принцип работы Transformer аналогичен; его основной процесс делится на три этапа:
- Обработка вводаВаши слова разбиваются на токены (слова или символы) и преобразуются в числа (векторы), понятные компьютерам.
- Понимание контекста (ядро):Механизм Self-Attentionначинает работать. Он позволяет модели при обработке каждого слова в предложении взвешивать важностьвсех остальных словв предложении. Этот процесспараллельнои чрезвычайно быстро.
- Генерация и итерация: Модель вычисляет распределение вероятностей на основе своего понимания всех слов и предсказывает наиболее вероятное следующее слово. Выбрав и выведя это слово, она использует его как новый вход и повторяет весь процесс, пока не будет сгенерирован полный ответ.
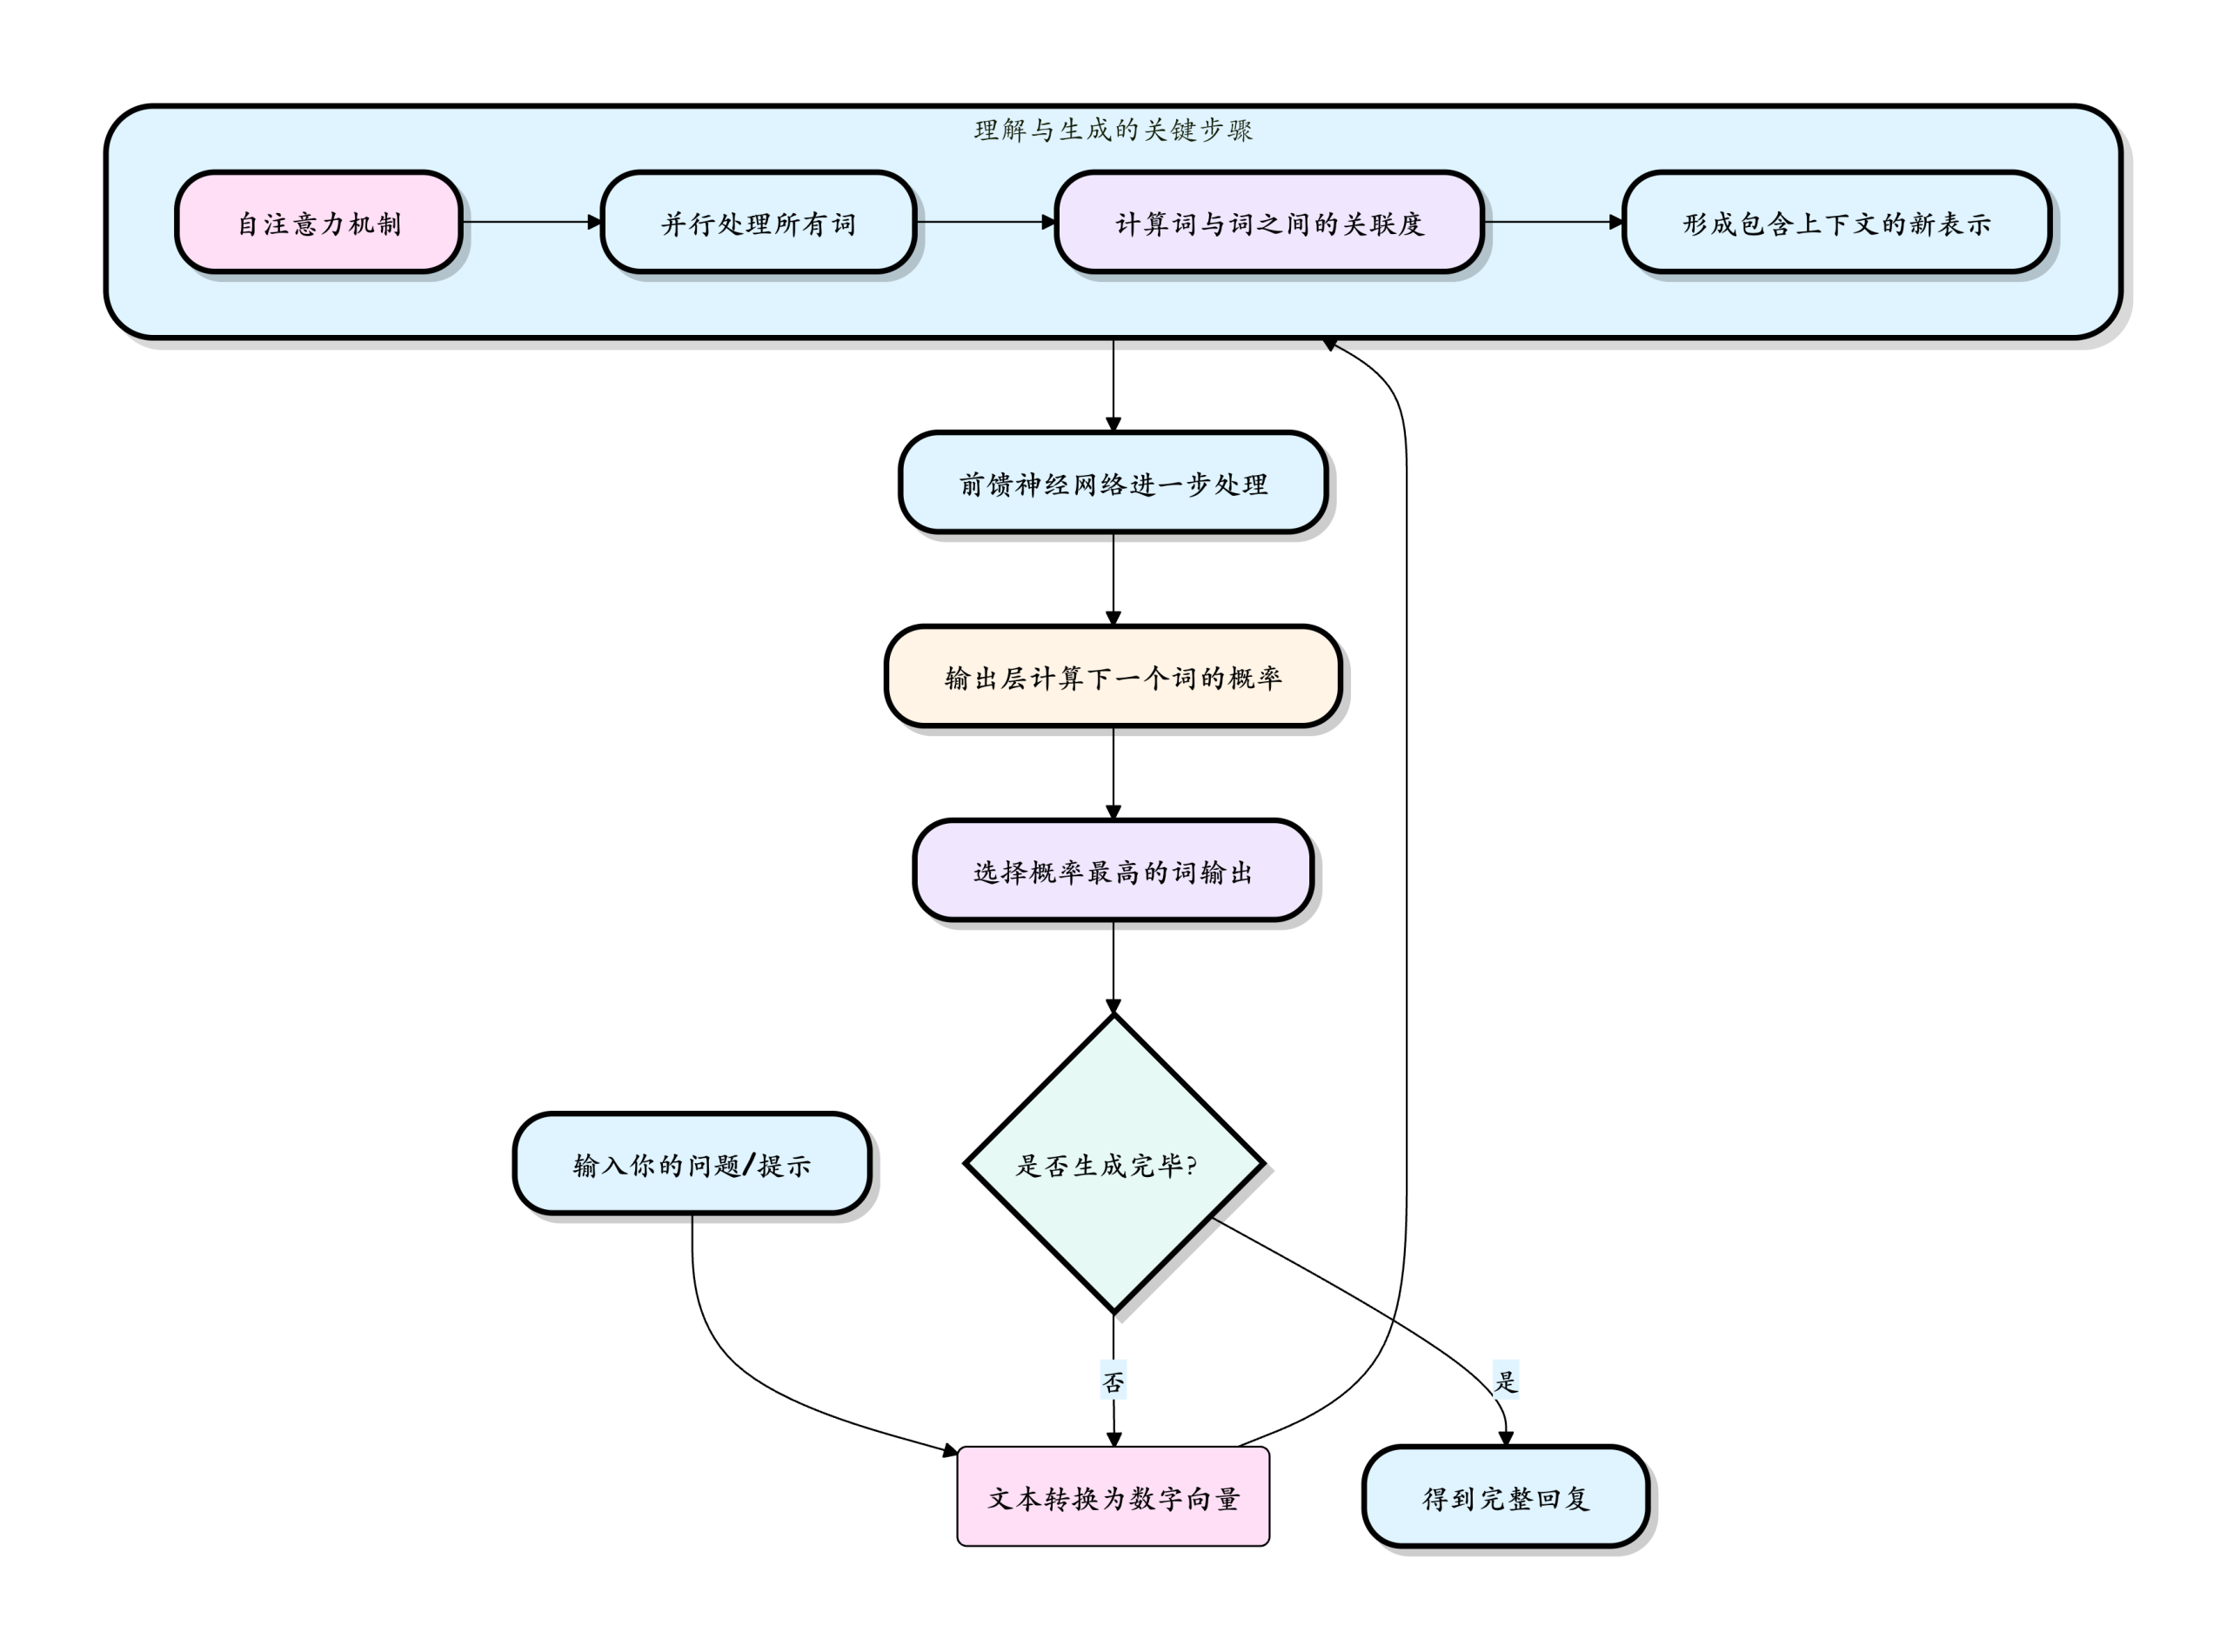
Self-attention — самая важная инновация Transformer. Взяв в качестве примера предложение "У телефона Apple очень большая батарея", когда модель обрабатываетitэто слово, механизм self-attention помогает модели определитьitиAppleиphoneсильно коррелируют. На рисунке ниже показано распределение весов внимания в этом процессе:
Именно эта способностьобрабатывать параллельноиглубоко понимать глобальный контекстпозволяет LLM на основе Transformer значительно превосходить предыдущие технологии (такие как RNN) в языковых задачах.
Как взаимодействовать с LLM: введение в промпт-инжиниринг
ПромптЭто входные данные, которые вы передаёте LLM. Они сообщают модели, чего вы хотите, как будто вы даёте инструкции ассистенту — чем яснее инструкции, тем лучше результат. Качество промпта напрямую определяет качество ответа.
Хороший промпт обычно состоит из следующих четырёх частей:
Основные принципы
Будьте ясны и конкретны: Избегайте расплывчатых выражений. Не говоритеНапиши что-нибудь о собаках, а вместо этого скажитеЖивым и ярким языком напиши краткое введение примерно на 100 слов об особенностях характера золотистых ретриверов для детей 6-8 лет.。
Укажите контекстСообщите модели вашу роль, опыт и цели. Например:Вы опытный наставник по программированию на Python. Объясните новичку, который только что изучил базовый синтаксис, что такое списковые включения, и приведите простой пример.
Укажите формат: Если вам нужен вывод в определённом формате, чётко укажите это, например:Пожалуйста, суммируйте следующие пункты в три маркированных пунктаилиПожалуйста, выведите в формате JSON。
Пошаговое мышление (Chain-of-Thought): Для сложных задач вы можете в промпте направлять модель рассуждать шаг за шагом, например:Пожалуйста, проанализируйте эту задачу шаг за шагом: сначала перечислите известные условия, затем выведите промежуточные шаги и в конце дайте вывод.Этот подход может значительно повысить точность сложных задач рассуждения.
Распространённые сценарии применения LLM
| Категория сценария | Конкретный пример | Описание |
|---|---|---|
| Создание и редактирование контента | Пишите письма, отчёты, блоги; продолжайте истории; шлифуйте текст; переводите тексты в разных стилях | Быстро генерируйте черновики, давайте вдохновение и несколько вариантов выражения |
| Поиск и обобщение информации | Быстро читать длинные документы и извлекать ключевые моменты; вопросы и ответы на основе баз знаний | Понимает вопросы лучше традиционного поиска, умеет суммировать и интегрировать информацию |
| Помощь в программировании | Объяснять код, генерировать фрагменты кода, отлаживать ошибки, рефакторить код, писать тестовые примеры | Работает как круглосуточный партнёр по программированию, значительно повышая эффективность разработки |
| Общение и обслуживание клиентов | Интеллектуальные чат-боты, персонализированные репетиторы, ролевые игры | Обеспечивает человекоподобный, контекстуально связный опыт взаимодействия |
| Логические рассуждения и анализ | Решать математические задачи, выполнять базовые логические рассуждения, анализировать тенденции данных, строить планы | Демонстрирует удивительные способности к рассуждению в ограниченных предметных областях |
Вызовы API и настройка параметров
Чтобы создать AI-агента, нужно научиться вызывать LLM через API.
В этой главе мы на примере OpenAI API познакомимся с базовыми способами вызова.
openai — это мощная библиотека Python для взаимодействия с рядом моделей и сервисов OpenAI. Подробнее см.:Python OpenAI。
Адрес открытого исходного кода:https://github.com/openai/openai-python
Базовые вызовы API
1. Установите необходимые библиотеки
pip install openai
Затем вам нужно зарегистрировать аккаунт на официальном сайте OpenAI и сгенерировать API Key на странице API keys.
Пример
from openai import OpenAI
client = OpenAI(
# Это значение по умолчанию, и его можно опустить
api_key=API-ключ, который вы запросили,
)
response = client.responses.create(
model="gpt-4o",
instructions="Ты — ассистент по программированию, который говорит как пират.",
input="Как проверить, является ли объект Python экземпляром класса?",
)
print(response.output_text)
Доступ к OpenAI внутри страны всё ещё немного затруднителен. Многие местные сервисы также поддерживают OpenAI, например DeepSeek и Qwen от Alibaba.
DeepSeek
DeepSeek API полностью совместим с форматом OpenAI API. Вам нужно лишь изменить несколько конфигураций, чтобы напрямую использовать OpenAI SDK или совместимые инструменты для доступа к DeepSeek API.
Основные параметры конфигурации:
| Параметр | Значение/Описание |
|---|---|
| base_url | Обязательно, фиксированное значение:https://api.deepseek.com(Можно также указатьhttps://api.deepseek.com/v1, только для совместимости с OpenAI; v1 не связан с версией модели) |
| api_key | Обязательно. Сначала вам нужно подать заявку на эксклюзивный API Key на официальном сайте DeepSeek (Адрес заявки:https://platform.deepseek.com/) |
| model | Обязательно,
|
Пример
from openai import OpenAI
# Инициализация клиента (основная конфигурация: замените на свой API Key)
client = OpenAI(
api_key=os.environ.get('DEEPSEEK_API_KEY'), # Рекомендуется настраивать через переменную окружения или жёстко задавать напрямую (не рекомендуется)
base_url="https://api.deepseek.com" # Фиксированный домен DeepSeek
)
# Вызов API чата
try:
response = client.chat.completions.create(
model="deepseek-v4-flash", # Укажите модель, варианты: deepseek-v4-flash / deepseek-v4-pro
messages=[
{"role": "system", "content": "Вы — полезный помощник"}, # Определение системной роли
{"role": "user", "content": "Привет"}, # Вопрос пользователя
],
stream=False # Нестриминговый вывод (возвращает полный результат сразу)
)
# Вывод содержимого ответа
print("Результат ответа:", response.choices[0].message.content)
except Exception as e:
print("Вызов не удался:", str(e))
Alibaba Bailian
Модель Tongyi Qianwen от Alibaba Cloud Bailian поддерживает интерфейс, совместимый с OpenAI. Вам нужно только изменить API Key, BASE_URL и имя модели, чтобы перенести существующий код OpenAI в сервис Alibaba Cloud Bailian.
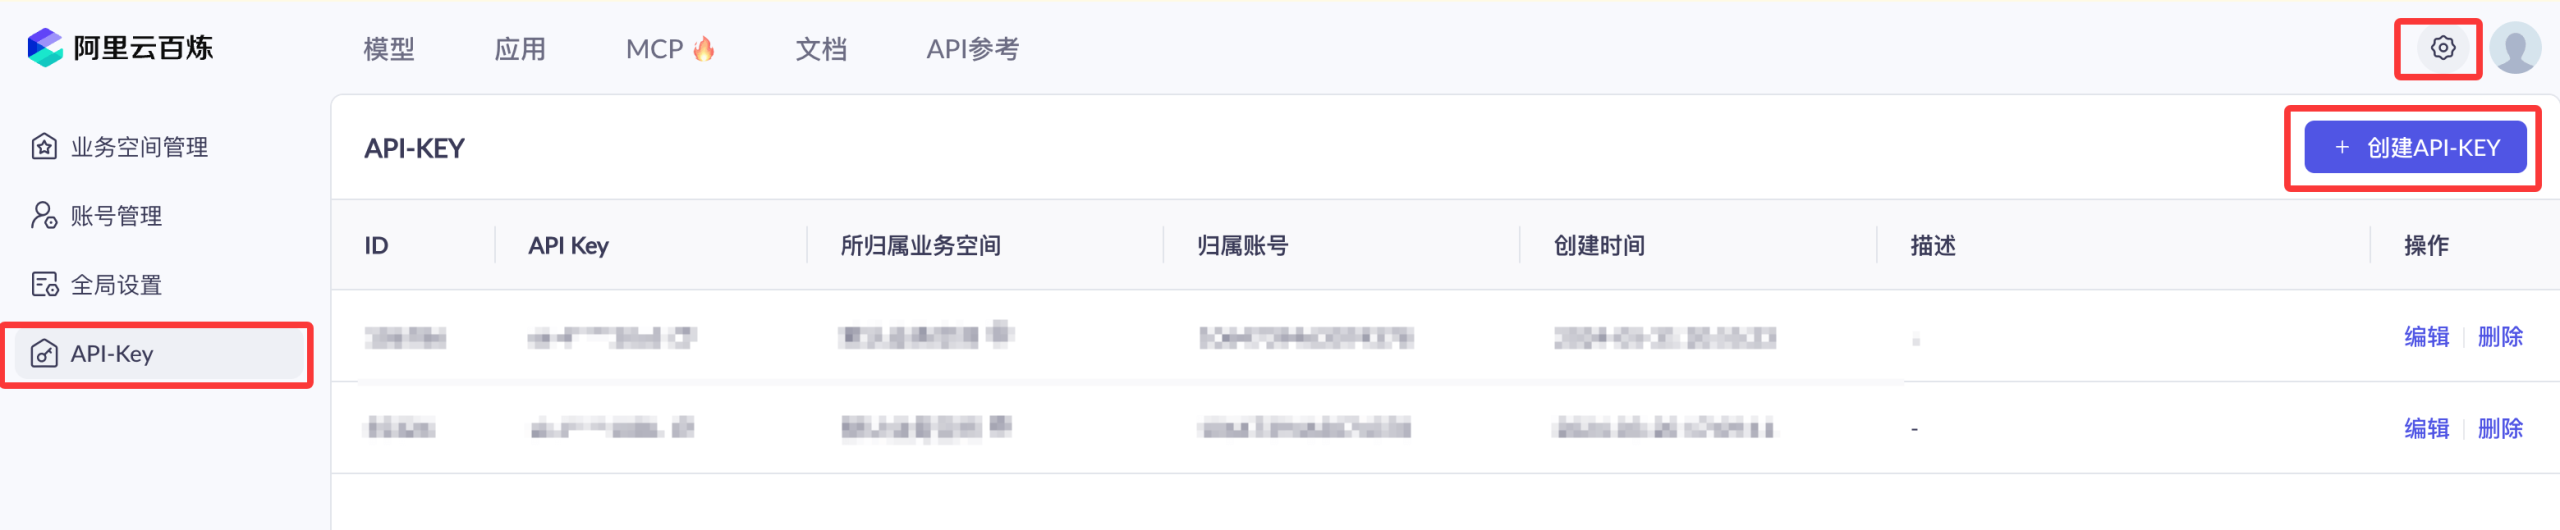
Нам нужно активировать сервис моделей Alibaba Cloud Bailian и получить API-KEY.
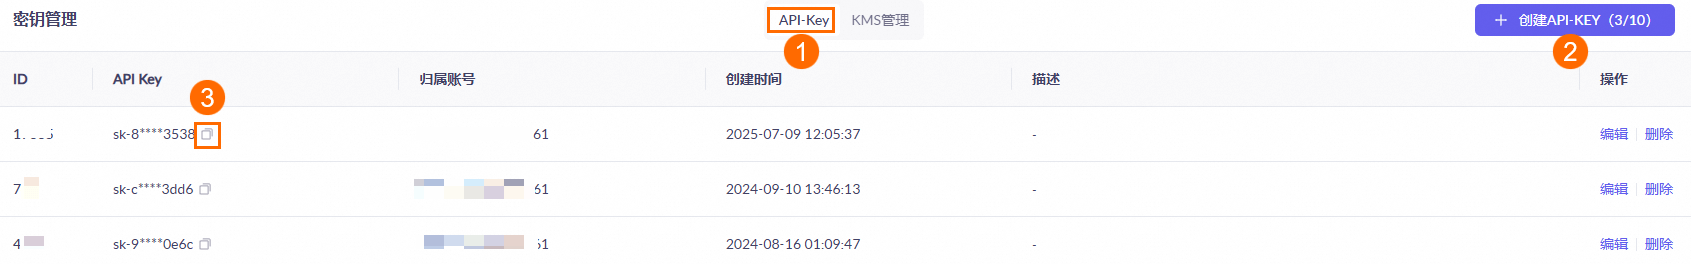
Сначала можно использовать основную учётную запись Alibaba Cloud для доступа к платформе сервисов моделей Bailian:https://bailian.console.aliyun.com/, затем нажмите «Войти» в правом верхнем углу. После входа нажмите на значок шестерёнки ⚙️ в правом верхнем углу, выберите API-ключ, затем скопируйте API-ключ. Если у вас его нет, вы также можете создать API-ключ:
Активация Alibaba Cloud Bailian не влечёт комиссий. Только вызовы моделей (после превышения бесплатной квоты), развёртывание моделей и тонкая настройка моделей повлекут соответствующие расходы.
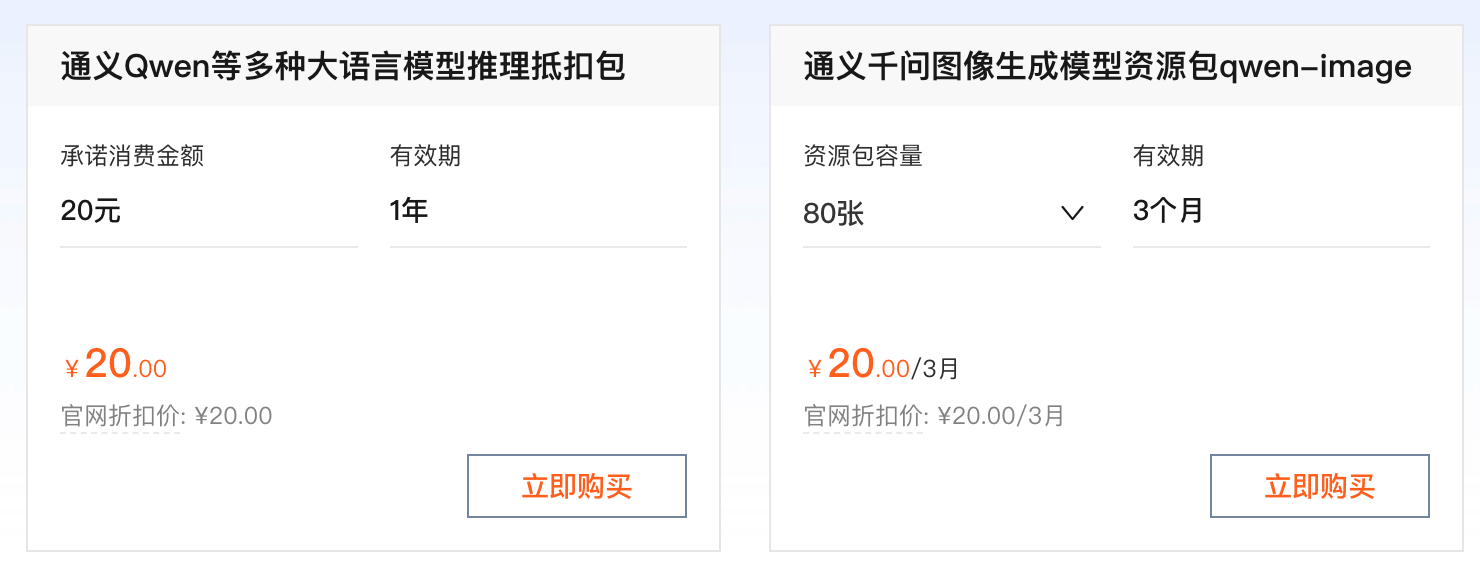
Теперь за использование API плата взимается по токенам. К счастью, это недорого. Можно сначала приобрести самый дешёвый пакет:Платформа сервисов больших моделей Alibaba Cloud Bailian。
Вы также можете напрямую использовать пакет Coding Plan от Bailian и Ark:https://www.example.com/claude-code/coding-plan.html。
Использование
Далее мы используем OpenAI SDK для доступа к модели Qwen на Bailian.
Пример вызова без потоковой передачи
Пример
import os
def get_response():
client = OpenAI(
api_key="sk-xxx", # Пожалуйста, используйте API-ключ Alibaba Cloud Bailian
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1", # Укажите base_url для DashScope SDK
)
completion = client.chat.completions.create(
model="qwen-plus", # Здесь qwen-plus используется в качестве примера; при необходимости вы можете изменить название модели. Список моделей: https://help.aliyun.com/zh/model-studio/getting-started/models
messages=[{'role': 'system', 'content': 'Вы — полезный помощник.'},
{'role': 'user', 'content': 'Кто вы?'}]
)
# Данные JSON
#print(completion.model_dump_json())
print(completion.choices[0].message.content)
if __name__ == '__main__':
get_response()
Выполнение кода даёт следующий результат:
I am Tongyi Qianwen, a large-scale language model independently developed by the Tongyi Lab under Alibaba Group. I can help you answer questions and create text, such as writing stories, official documents, emails, scripts, logical reasoning, programming, and more. I can also express opinions and play games. If you have any questions or need help, feel free to let me know at any time!
Пример потокового вызова
Пример
def get_response():
client = OpenAI(
api_key="sk-xxx",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
model="qwen-plus",
messages=[
{'role': 'system', 'content': 'Вы — полезный помощник.'},
{'role': 'user', 'content': 'Кто вы?'}
],
stream=True,
stream_options={"include_usage": True}
)
for chunk in completion:
# chunk может не содержать choices или delta
if hasattr(chunk, "choices") and len(chunk.choices) > 0:
choice = chunk.choices[0]
if hasattr(choice, "delta") and hasattr(choice.delta, "content"):
print(choice.delta.content, end='', flush=True)
if __name__ == '__main__':
get_response()
Выполнение кода даёт следующий результат:
I am Tongyi Qianwen, a large-scale language model independently developed by the Tongyi Lab under Alibaba Group. I can help you answer questions and create text, such as writing stories, official documents, emails, scripts, logical reasoning, programming, and more. I can also express opinions and play games. If you have any questions or need help, feel free to let me know at any time!
Основные большие языковые модели
Ниже приведён список официальных сайтов и адресов документации API для основных больших языковых моделей: