Учебник для начинающих по GraphRAG
GraphRAG — это структурированная иерархическая система генерации с расширенным поиском (RAG) с открытым исходным кодом от Microsoft Research. В отличие от традиционного RAG, который использует чисто текстовый векторный поиск, GraphRAG сначала применяет большую языковую модель для извлечения сущностей и связей из исходных документов, строит граф знаний, а затем выполняет поиск и ответы на вопросы на основе структуры графа.
Этот учебник рассчитан на начинающих без предварительных знаний и проведёт вас через полный рабочий процесс: от установочногодокумента → граф знаний → запросы и ответыИспользуемая модель —qwen-plus, а для Embedding используетсяtext-embedding-v4 от Alibaba Cloud Tongyi。

Что такое GraphRAG
Чтобы понять GraphRAG, сначала нужно понять, чем он лучше традиционного RAG.
Ограничения традиционного RAG
Рабочий процесс традиционного RAG (Baseline RAG) таков: разбить документы на небольшие фрагменты → сгенерировать векторы → когда поступает вопрос, использовать векторное сходство для извлечения наиболее релевантных фрагментов → передать их модели для генерации ответа.
Этот подход хорошо работает для вопросов типа «точный поиск», но плохо справляется в двух сценариях:
- Междокументное реляционное рассуждение: когда ответ требует связывания информации, разбросанной по разным документам, векторное сходство не может выразить это «отношение». Например: «Каково пересечение между генеральным директором компании A и основателем компании B?»
- Вопросы с глобальным обобщением: когда вопрос требует макроуровневого обобщения всего корпуса, несколько текстовых фрагментов не могут охватить всю картину. Например: «Каковы наиболее критичные точки риска в этом пакете финансовых отчётов?»
Как GraphRAG решает эти две проблемы
Основная идея GraphRAG заключается в следующем:вместо прямого извлечения текстовых фрагментов сначала строится граф знаний, а затем поиск выполняется на основе структуры графа.。
Весь процесс делится на два этапа:
| Этап | Что он делает | Что он выдаёт на выходе |
|---|---|---|
| Index | С помощью LLM выполняется чтение документов, извлечение сущностей (люди, места, организации и т. д.) и связей между ними, строится граф знаний; затем с помощью алгоритма Leiden выполняется иерархическая кластеризация графа и для каждого сообщества генерируется резюме. | Граф знаний + резюме сообществ + векторный индекс |
| Запрос | Когда пользователь задаёт вопрос, в зависимости от типа вопроса выбираются различные стратегии поиска, а данные графа, резюме сообществ и исходные текстовые фрагменты внедряются в контекст LLM для формирования ответа. | Структурированные ответы со ссылками на источники |
Этап индексации в GraphRAG требует большого количества вызовов API LLM: для каждого текстового сегмента выполняется извлечение сущностей и обобщение,расход токенов значительно выше, чем в традиционном RAG. При первом использовании рекомендуется сначала протестировать рабочий процесс на небольшом документе (в пределах нескольких тысяч символов) и переходить к обработке крупномасштабных корпусов только после подтверждения его корректной работы.
Сравнение четырёх режимов запросов
| Режим запроса | Стратегия извлечения | Подходящие типы вопросов | Потребление ресурсов |
|---|---|---|---|
| Глобальный поиск | Map-Reduce: обход всех сводок сообществ | Глобальные вопросы и вопросы обобщения, например: «Какова основная тема этих документов?» | Высокое (одновременные множественные вызовы LLM) |
| Локальный поиск | Начиная с релевантных сущностей, расширять соседей и связанные тексты | Вопросы о конкретных сущностях, например: «основная сеть связей человека» | Средняя |
| DRIFT Search | Локальный поиск + итеративное уточнение, управляемое информацией сообщества | Вопросы, связанные с сущностями, требующие широкого контекста и баланса между глубиной и широтой | Средне-высокая |
| Базовый поиск | Стандартное векторное сходство (как в традиционном RAG) | Простой точный поиск для сравнения | Низкая |
Требования к окружению
Перед началом убедитесь, что ваше окружение соответствует следующим требованиям.
| Зависимости | Требования к версиям | Описание |
|---|---|---|
| Python | 3.10 ~ 3.12 | Официальная область поддержки; 3.13 пока не поддерживается. |
| pip | Последняя версия | Рекомендуется сначалаpip install --upgrade pip |
| API-ключ Alibaba Cloud Bailian | — | На сайтеbailian.console.aliyun.com/подайте заявку |
| Место на диске | ≥ 2GB | Артефакты индекса (файлы Parquet, векторная база данных) займут значительный объем пространства. |
Установка
GraphRAG опубликован на PyPI. Рекомендуется устанавливать его в виртуальном окружении Python, чтобы не засорять системное окружение.
Создайте каталог проекта и инициализируйте виртуальное окружение
mkdir graphrag_demo
cd graphrag_demo
python -m venv .venv
Вы также можете использоватькоманду uv, чтобы указать версию Python:uv venv --python 3.12
Активируйте виртуальное окружение
macOS / Linux:
source .venv/bin/activate
Windows:
.venv\Scripts\activate
Установка GraphRAG
pip install graphrag
После завершения установки проверьте:
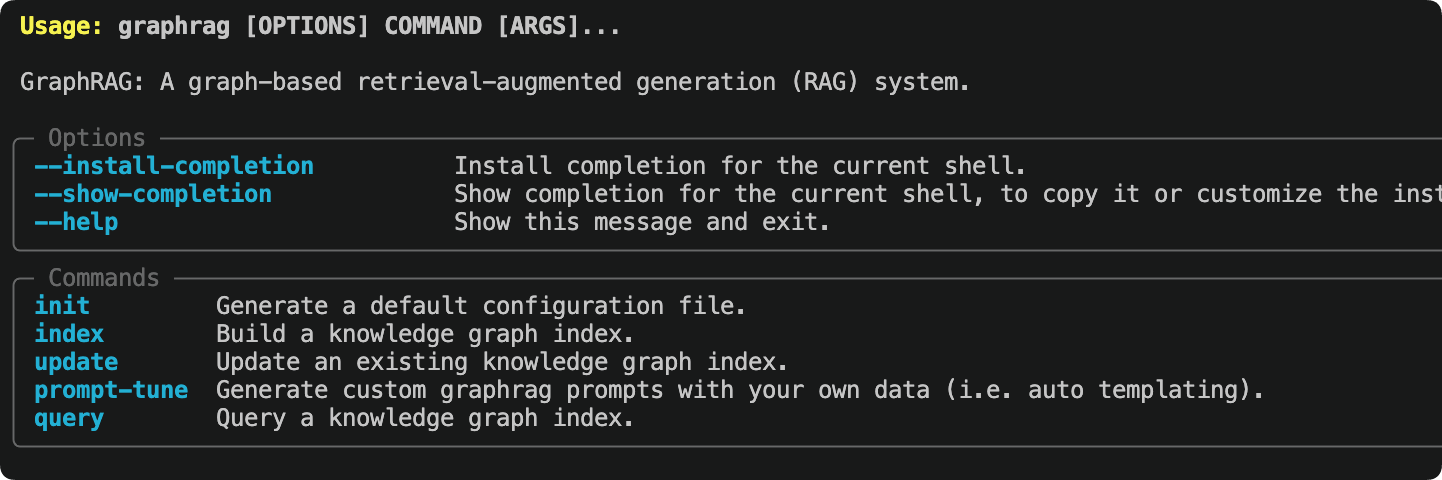
graphrag --help
Он выведет некоторую информациюgraphragкоманды. Вывод будет выглядеть примерно так:
GraphRAG автоматически установит зависимости, такие как LiteLLM, LanceDB, pandas и numpy. Первая установка может занять некоторое время (обычно 1-3 минуты). Пожалуйста, наберитесь терпения.
Инициализация рабочего пространства
Запуститеgraphrag initкоманду, GraphRAG создаст файлы конфигурации и структуру каталогов в текущем каталоге.
graphrag init
Он предложит нам настроить модели. Просто нажмите Enter, чтобы принять значения по умолчанию; мы сможем изменить их позже:
Specify the default chat model to use [gpt-4.1]:
Specify the default embedding model to use [text-embedding-3-large]:
Во время инициализации вам будет предложено ввести модель Chat по умолчанию и модель Embedding по умолчанию. Вы можете просто нажать Enter, чтобы пока пропустить; позже мы изменим их вручную.settings.yaml。
После завершения инициализации структура каталогов выглядит следующим образом:
graphrag_demo/
├── .env                  # 存放 API Key 环境变量
├── settings.yaml         # 核心配置文件
├── input/                # 存放待处理的文本文件
├── output/               # 索引产物输出目录(自动生成)
└── prompts/              # Prompt 模板目录(自动生成)
После каждого обновления минорной версии GraphRAG рекомендуется повторно запустить
graphrag init --forceчтобы обновить формат конфигурации; иначе могут возникнуть ошибки из-за изменений структуры конфигурации. Обратите внимание, что эта команда перезапишет существующиеsettings.yamlи промпты. Рекомендуется сначала сделать их резервные копии.
Подготовьте тестовые документы
GraphRAG поддерживает.txt、.csv、.jsonдокументы в формате ... . Все файлы для обработки следует поместить вinput/каталог.
Мы используем официально рекомендованный тестовый документ — «Рождественскую песнь» Чарльза Диккенса — скачанный напрямую с Project Gutenberg:
curl /static.jyshare.com/download/pg24022.txt?v=2 -o ./input/book.txt
Если нет доступа к сети, вы также можете самостоятельно создать китайский тестовый текст. Чем богаче содержание (включая множество персонажей, мест и связей между событиями), тем очевиднее будет эффект графа знаний GraphRAG:
Поместите файл в каталогinputс именем файлаdemo.txt:
SpaceX 太空探索技术公司成立于 2002 年,由埃隆·马斯克(Elon Musk)在美国加利福尼亚州霍桑市创办。
公司目标是大幅降低太空运输成本,最终实现人类移民火星。

马斯克早年联合创立了 PayPal,2002 年以 15 亿美元出售给 eBay,随后将个人资产投入 SpaceX.
联合创始人中,汤姆·穆勒(Tom Mueller)担任推进系统首席设计师,主导了 Merlin 和 Raptor 发动机的研发。
格温·肖特维尔(Gwynne Shotwell)于 2002 年加入,2008 年起担任总裁兼 COO,负责公司日常运营和商业拓展。

2008 年,猎鹰 1 号(Falcon 1)在经历三次失败后首次成功入轨,成为首个由私营公司研制的液体轨道火箭。
2010 年,猎鹰 9 号(Falcon 9)首飞成功,同年龙飞船(Dragon)完成首次商业发射与回收。
2012 年,龙飞船成为首个对接国际空间站的商业航天器。

2015 年 12 月,猎鹰 9 号一级火箭首次实现陆地垂直回收,开创了火箭重复使用的新纪元。
此后 SpaceX 累计完成超过 200 次火箭回收,单枚助推器最高复用次数达到 20 次以上。

2020 年,载人龙飞船(Crew Dragon)将 NASA 宇航员送入国际空间站,标志着商业载人航天时代的开始。
Starlink 星链项目自 2019 年启动,截至 2024 年已在轨部署超过 5000 颗卫星,覆盖全球超过 60 个国家和地区。

Starship 星舰是 SpaceX 正在研发的超重型运载系统,由超重助推器(Super Heavy)和星舰飞船组成,
设计目标为完全可重复使用,近地轨道运力超过 100 吨,是 NASA 阿尔忒弥斯登月计划的指定着陆器。

竞争对手方面,SpaceX 主要面临来自蓝色起源(Blue Origin)和联合发射联盟(ULA)的压力。
蓝色起源由亚马逊创始人杰夫·贝索斯创立,专注亚轨道旅游和重型火箭 New Glenn 的研发。
ULA 由洛克希德·马丁和波音合资成立,长期承担美国军方卫星发射任务。

Настройте qwen-plus и модель Embedding
Это самый важный шаг всего руководства; вам нужно изменить.envиsettings.yamlдва файла.
Шаг 1: Настройте ключ API
Open.envфайл и укажите свой API-ключ:
Пример
# API-ключ Alibaba Cloud Bailian
DASHSCOPE_API_KEY=sk-your-dashscope-api-key-here
Шаг 2: Измените settings.yaml
Opensettings.yaml, и замените всё содержимое следующей конфигурацией.
GraphRAG 2.x использует LiteLLM для единообразного вызова различных моделей,model_provider: openaiВместе сapi_baseвы можете перенаправлять запросы в любой OpenAI-совместимый интерфейс:
completion_models:
  default_completion_model:
    model_provider: openai
    model: qwen-plus                              # 中文抽取稳定,成本低于 qwen-plus
    auth_method: api_key
    api_key: ${DASHSCOPE_API_KEY}
    api_base: https://dashscope.aliyuncs.com/compatible-mode/v1
    call_args:
      temperature: 0                              # 提高结构化稳定性
      max_tokens: 4096
    retry:
      type: exponential_backoff
      max_retries: 5
      base_delay: 2

embedding_models:
  default_embedding_model:
    model_provider: openai
    model: text-embedding-v4                      # 通义向量模型
    auth_method: api_key
    api_key: ${DASHSCOPE_API_KEY}
    api_base: https://dashscope.aliyuncs.com/compatible-mode/v1
    retry:
      type: exponential_backoff
      max_retries: 5

input:
  type: text

input_storage:
  type: file
  base_dir: input

chunking:
  type: tokens
  size: 600                                       # 中文推荐 500~800
  overlap: 100
  encoding_model: o200k_base

output_storage:
  type: file
  base_dir: output

reporting:
  type: file
  base_dir: logs

cache:
  type: json
  storage:
    type: file
    base_dir: cache

vector_store:
  type: lancedb
  db_uri: output/lancedb

embed_text:
  embedding_model_id: default_embedding_model    # 注意不要带逗号
  batch_size: 10                                 # 百炼 embedding 单次最多10条
  batch_max_tokens: 6000
  concurrency: 1                                 # 避免并发触发限流

extract_graph:
  completion_model_id: default_completion_model
  entity_types: []                               # 自动识别实体
  max_gleanings: 3                               # 提高关系补抽成功率

summarize_descriptions:
  completion_model_id: default_completion_model
  max_length: 500

cluster_graph:
  max_cluster_size: 20                           # 降低社区数量

extract_claims:
  enabled: false

community_reports:
  completion_model_id: default_completion_model
  max_length: 1500
  max_input_length: 4000                         # 防止生成阶段过慢

snapshots:
  graphml: true                                  # 导出图结构
  embeddings: false

local_search:
  completion_model_id: default_completion_model
  embedding_model_id: default_embedding_model
  top_k_entities: 10

global_search:
  completion_model_id: default_completion_model
  map_max_length: 500
  reduce_max_length: 1500
О выводе JSON в Qwen:GraphRAG требует, чтобы модель стабильно возвращала формат JSON при извлечении сущностей. Qwen поддерживает режим JSON; установите
temperatureв 0 может дополнительно повысить стабильность вывода и снизить вероятность ошибок парсинга. Если ошибки парсинга JSON всё ещё возникают, можно попробоватьcall_argsдобавить вresponse_format: {type: json_object}。
Начать индексацию
После завершения настройки запустите команду индексации. GraphRAG автоматически прочитаетinput/все файлы в каталоге, вызовет qwen-plus для извлечения сущностей, распознавания отношений и генерации сводок и в итоге построит полный граф знаний.
graphrag index
Вы увидите вывод о ходе выполнения, похожий на следующий:
⠹ GraphRAG Indexer
├── Loading Input (text) - 1 files loaded
├── create_base_text_units
├── extract_graph
│   └── Entity Extraction: 100%|████████████| 12/12 [02:34<00:00]
├── summarize_descriptions
├── cluster_graph
├── community_reports
└── generate_text_embeddings
All workflows completed successfully.
После завершения индексации,output/в каталоге будет создана серия файлов Parquet:
| Файл | Содержание |
|---|---|
entities.parquet | Все извлечённые сущности (имя, тип, описание, вектор) |
relationships.parquet | Связи между сущностями (исходная сущность, целевая сущность, описание связи, вес) |
communities.parquet | Сообщества, сгенерированные кластеризацией Leiden (иерархическая структура) |
community_reports.parquet | Сводный отчёт по каждому сообществу (основные данные для Global Search) |
text_units.parquet | Исходные текстовые фрагменты (справочный источник для Local Search) |
lancedb/ | Векторная база данных, хранящая векторы для различных сущностей и текстовых фрагментов |
Ориентировочное время индексации:Для китайского документа объёмом в несколько тысяч символов (около 10–20 текстовых фрагментов) использование qwen-plus занимает примерно 3–10 минут; для больших наборов документов объёмом более 100 000 символов это может занять несколько часов. Рекомендуется сначала прогнать рабочий процесс на небольшом документе, а затем обрабатывать крупномасштабные данные.
Выполнение запросов
После завершения индексации вы можете выполнять запросы к графу знаний. GraphRAG предоставляет два метода: CLI и Python API.
Запросы через CLI
Глобальный поиск (подходит для вопросов макроуровня):
graphrag query "文档中涉及的主要组织和人物有哪些?它们之间有什么关系?"
Локальный поиск (подходит для вопросов о конкретных сущностях), добавьте--method local:
graphrag query "SpaceX 公司的主要业务和合作伙伴有哪些?" --method local
Поиск DRIFT (баланс глубины и широты):
graphrag query "埃隆·马斯克的职业背景和主要贡献是什么?" --method drift
Базовый векторный поиск (по сравнению с традиционным RAG):
graphrag query "Starship 星舰的设计目标和能力是什么?" --method basic
Запросы через Python API
Вызов запросов GraphRAG в коде, подходит для интеграции в приложения.
Пример
# Использование Python API GraphRAG для запросов
import asyncio
from graphrag.api import GraphRagConfig, search
async def run_query():
# Загрузить файл конфигурации (прочитать settings.yaml из текущего каталога)
config = GraphRagConfig.from_yaml("settings.yaml")
# ── Пример глобального поиска ──────────────────────────────
print("=" * 60)
print("[Глобальный поиск] Глобальный вопрос")
print("=" * 60)
global_result = await search(
config=config,
query="Какая сеть связей между крупными компаниями и людьми, упомянутыми в документах?",
method="global", # Использовать глобальный поиск
)
print(global_result.response)
print()
# ── Пример локального поиска ──────────────────────────────
print("=" * 60)
print("[Локальный поиск] Вопрос о конкретной сущности")
print("=" * 60)
local_result = await search(
config=config,
query="Какова предыстория команды основателей SpaceX и её основные продукты?",
method="local", # Использовать локальный поиск
)
print(local_result.response)
print()
# Просмотреть полученную информацию об источниках (необязательно)
if hasattr(local_result, "context_data"):
entities = local_result.context_data.get("entities", [])
print(f"Количество извлечённых релевантных сущностей: {len(entities)}")
if __name__ == "__main__":
asyncio.run(run_query())
python query_demo.py
============================================================
【Global Search】全局性问题
============================================================
根据文档内容,主要涉及以下公司和人物关系网络:

**公司层面:**
- SpaceX 公司:主要角色,覆盖商业发射、载人航天、卫星互联网三大方向
- NASA:重要合作伙伴,阿尔忒弥斯登月计划 Starship 着陆器供应商
- 蓝色起源 / 联合发射联盟:主要竞争对手

**人物层面:**
- 马斯克(创始人):PayPal 联合创始人,SpaceX CEO 兼首席工程师
- 汤姆·穆勒(联合创始人):推进系统首席设计师,Merlin 和 Raptor 发动机之父
- 格温·肖特维尔:总裁兼 COO,负责公司商业运营

**关键关系:**
SpaceX 与 NASA 于 2020 年建立战略合作关系,
三家公司(SpaceX、蓝色起源、ULA)在商业航天发射市场形成竞争格局...

============================================================
【Local Search】针对特定实体的问题
============================================================
SpaceX 公司成立于 2002 年,创始团队包括:
- 马斯克:PayPal 联合创始人,SpaceX CEO 兼首席工程师,航天领域超二十年经验
- 汤姆·穆勒:推进系统首席设计师,主导 Merlin 和 Raptor 发动机研发

主要产品:
1. 猎鹰 9 号:全球首个实现垂直回收的轨道级火箭,已完成 200 次以上回收
2. Starship 星舰:超重型运载系统,近地轨道运力超 100 吨,完全可重复使用

检索到相关实体数量:12
Автоматическая настройка промптов
GraphRAG официально настоятельно рекомендует запускать автоматическую настройку промптов перед обработкой ваших собственных данных.
При автоматической настройке LLM прочитает часть ваших документов, а затем сгенерирует промпты для извлечения сущностей, адаптированные под вашу предметную область, что обеспечит более качественное построение графа знаний.
graphrag prompt-tune --config settings.yaml --root . --language Chinese
После завершения настройки,prompts/файлы промптов в каталоге будут автоматически обновлены. Если ваши документы на китайском, добавьте--language Chineseпараметр, чтобы сгенерированный промпт также использовал китайский, повышая точность извлечения китайских сущностей.
Сама настройка промптов также расходует токены LLM (примерно эквивалентно быстрой индексации небольшого числа документов). Рекомендуется перенастраивать при каждом изменении набора данных, а не всегда использовать промпты по умолчанию.
Краткая справка по распространённым командам CLI
Ниже приведены наиболее часто используемые команды в повседневной работе с GraphRAG.
| Команда | Описание |
|---|---|
graphrag init | Инициализировать рабочее пространство и сгенерировать.env、settings.yaml、input/ |
graphrag init --force | Принудительная повторная инициализация (используйте после обновления версий); перезапишет существующую конфигурацию |
graphrag index | Параinput/Запустить полный конвейер индексации для документов в каталоге |
graphrag index --resume | Возобновить индексацию с места прерывания (вызовы LLM кэшируются, поэтому токены не расходуются повторно) |
graphrag index --update | Инкрементальная индексация; обрабатывает только недавно добавленные документы |
graphrag query "问题" | Запрос глобального поиска (режим по умолчанию) |
graphrag query "问题" --method local | Запрос локального поиска |
graphrag query "问题" --method drift | Запрос DRIFT Search |
graphrag query "问题" --method basic | Базовый поиск (векторное извлечение) |
graphrag prompt-tune | Автонастройка промпта (рекомендуется запускать перед обработкой новых наборов данных) |
Полный справочник по полям settings.yaml
Ниже мы приводимsettings.yamlподробное объяснение наиболее часто используемых элементов конфигурации, чтобы облегчить дальнейшую настройку.
Связанные с моделью
| Поле | Type | Описание |
|---|---|---|
model_provider | string | Провайдер модели; укажите при использовании интерфейса, совместимого с OpenAIopenai |
model | string | Название модели; для Qwen укажитеqwen-plus или qwen-max |
api_key | string | Ключ API; рекомендуется использовать${ENV_VAR}ссылки на переменные окружения |
api_base | string | Конечная точка API; для Qwen этоhttps://dashscope.aliyuncs.com/compatible-mode/v1 |
call_args.temperature | float | Температура генерации; рекомендуется устанавливать 0 во время индексации для повышения стабильности |
call_args.max_tokens | int | Максимальное количество токенов на генерацию |
retry.max_retries | int | Максимальное количество повторных попыток при сбое запроса |
Связанные с чанкингом
| Поле | Описание | Рекомендуемое значение |
|---|---|---|
chunking.size | Максимальное количество токенов на текстовый фрагмент | Английский: 1200~1500; Китайский: 600~1000 |
chunking.overlap | Количество перекрывающихся токенов между соседними фрагментами, чтобы сущности не обрезались на границах | 50~150 |
chunking.type | tokens(разбиение по токенам) илиsentence(разбиение по предложениям) | Обычно используйтеtokens |
Связанные с извлечением сущностей
| Поле | Описание | Рекомендация |
|---|---|---|
extract_graph.entity_types | Сообщите модели список типов сущностей, на извлечении которых нужно сосредоточиться | Настройте под свою предметную область, напримерperson, company, product, technology |
extract_graph.max_gleanings | Максимальное количество уточняющих вопросов на текстовый фрагмент (уточняющие вопросы могут повысить полноту, но потребляют больше токенов) | Установите 1, если нужно сбалансировать затраты, установите 2, если в приоритете качество |
ЧАВО
Что делать, если индексация прервется на середине?
GraphRAG кэширует результаты каждого вызова LLM. После сбоя просто запустите повторноgraphrag indexТекстовые фрагменты, которые уже были успешно обработаны, будут прочитаны из кэша и не будут повторно расходовать токены.
Если вы хотите перезапустить с определенного шага, используйте--resumeпараметр:
graphrag index --resume
Как обрабатывать ошибки парсинга JSON?
На этапе извлечения сущностей модель должна строго возвращать формат JSON. ЕслиJSONDecodeError, можно попробовать следующие методы:
- В
call_argsдобавьтеresponse_format: {type: json_object}(требуется, чтобы модель поддерживала этот параметр) - будет
temperatureУстановить в 0 - будет
max_gleaningsУстановить в 0 (уменьшить количество уточняющих вопросов, снизить вероятность ошибки) - Запустите
graphrag prompt-tuneПовторно оптимизировать промпт, чтобы модель лучше усвоила формат вывода
Как выбрать между глобальным поиском и локальным поиском?
| Тип вопроса | Рекомендуемый режим | Пример |
|---|---|---|
| Обобщение, глобальный | Глобальный поиск | "Какова основная тема этих документов?" "Полная картина всей сети взаимоотношений персонажей" |
| Для конкретных сущностей | Локальный поиск | "Карьерный опыт Маска?" "Основные технические характеристики ракеты Falcon 9" |
| Требует как глубины, так и широты | DRIFT Search | "Анализ взаимосвязи между определённым человеком и окружающей экосистемой" |
| Простой точный поиск | Базовый поиск | "В каком году была основана SpaceX?" |
Как контролировать высокое потребление токенов?
- будет
chunking.sizeУвеличить соответствующим образом (меньше текстовых фрагментов = меньше вызовов LLM) - будет
extract_graph.max_gleaningsУстановить в 0 или 1 - В
entity_typesоставлять только типы сущностей, наиболее релевантные бизнесу - Использовать более дешёвую модель во время индексации и при необходимости переключаться на более мощную модель во время запроса
GraphRAG предоставляет стратегию "асимметричной конфигурации моделей": в
completion_modelsОпределите несколько моделей в ..., используйте недорогие модели во время индексации и более мощные модели для критически важных запросов на этапе запроса, находя баланс между стоимостью и качеством.
Как обрабатывать документы на китайском языке?
При обработке документов на китайском языке необходимо обратить внимание на следующие моменты:
- Убедитесь
input.encoding: utf-8(UTF-8 уже по умолчанию) - Уменьшить
chunking.size(китайские иероглифы имеют высокую информационную плотность; достаточно 600~1000 токенов) - Запустите
graphrag prompt-tune --language ChineseСгенерировать китайский промпт entity_typesВы можете при необходимости добавить специфичные для китайского языка типы, напримерgovernment_agency(государственные органы),policy(политики)
Дополнительные материалы
| Тема | Описание | Ссылка |
|---|---|---|
| Официальная полная документация | Содержит подробные описания всех параметров конфигурации | microsoft.github.io/graphrag |
| Справочник по конфигурации | Полное описание полей settings.yaml | microsoft.github.io/graphrag/config/yaml/ |
| Руководство по выбору модели | Как интегрировать различные LLM (включая использование LiteLLM) | microsoft.github.io/graphrag/config/models/ |
| Подробное объяснение движка запросов | Принципы и настройка параметров четырех режимов запросов | microsoft.github.io/graphrag/query/overview/ |
| Руководство по настройке промптов | Полное описание автоматической и ручной настройки промптов | microsoft.github.io/graphrag/prompt_tuning/overview/ |
| Руководство по визуализации | Используйте официальные инструменты для визуализации графа знаний | microsoft.github.io/graphrag/visualization_guide/ |
| Статья GraphRAG | Оригинальная статья Microsoft Research, чтобы понять основополагающие принципы | arxiv.org/pdf/2404.16130 |