Bases des grands modèles de langage (LLM)
Le grand modèle de langage (LLM) est le cerveau d'un agent IA ; le comprendre est la base pour construire des agents intelligents.
La raison pour laquelle un grand modèle de langage peut converser avec vous, écrire des articles et programmer est essentiellement qu'il, à partir du texte (prompt) que vous fournissez, mot par mot,devineproduit la continuation la plus raisonnable.
En termes simples, un grand modèle de langage est un modèle d'apprentissage profond entraîné sur d'énormes données textuelles, capable de comprendre et de générer le langage humain. En analysant d'énormes textes sur Internet, le modèle apprend les régularités statistiques du langage, et lorsqu'il reçoit une entrée, il génère la continuation la plus raisonnable selon les régularités apprises.

Nous pouvons imaginer un grand modèle de langage comme un étudiantextrêmement travailleur doté d'une mémoire extraordinaire:
Phase d'apprentissage (entraînement): Il a lu presque tous les textes accessibles publiquement sur Internet—livres, articles, pages web, code, etc. (le volume de données peut atteindre des milliers de milliards de mots). Dans ce processus, il ne mémorise pas, mais apprend un ensemble extrêmement complexe de règles linguistiques.
Phase d'application (inférence): Lorsque vous lui posez une question ou lui donnez une instruction, il applique les règles apprises pour générer, mot par mot, la réponse la plus logique et la plus adaptée au contexte.
Sa « grandeur » se reflète principalement dans deux aspects :
- Grande échelle de paramètres: Le modèle contient en interne des dizaines de milliards, voire des milliers de milliards de paramètres ajustables, qui enregistrent les connaissances linguistiques apprises.
- Grand volume de données d'entraînement: Le volume de données textuelles utilisé pour l'entraînement est énorme, couvrant l'essentiel des informations internet accessibles publiquement.
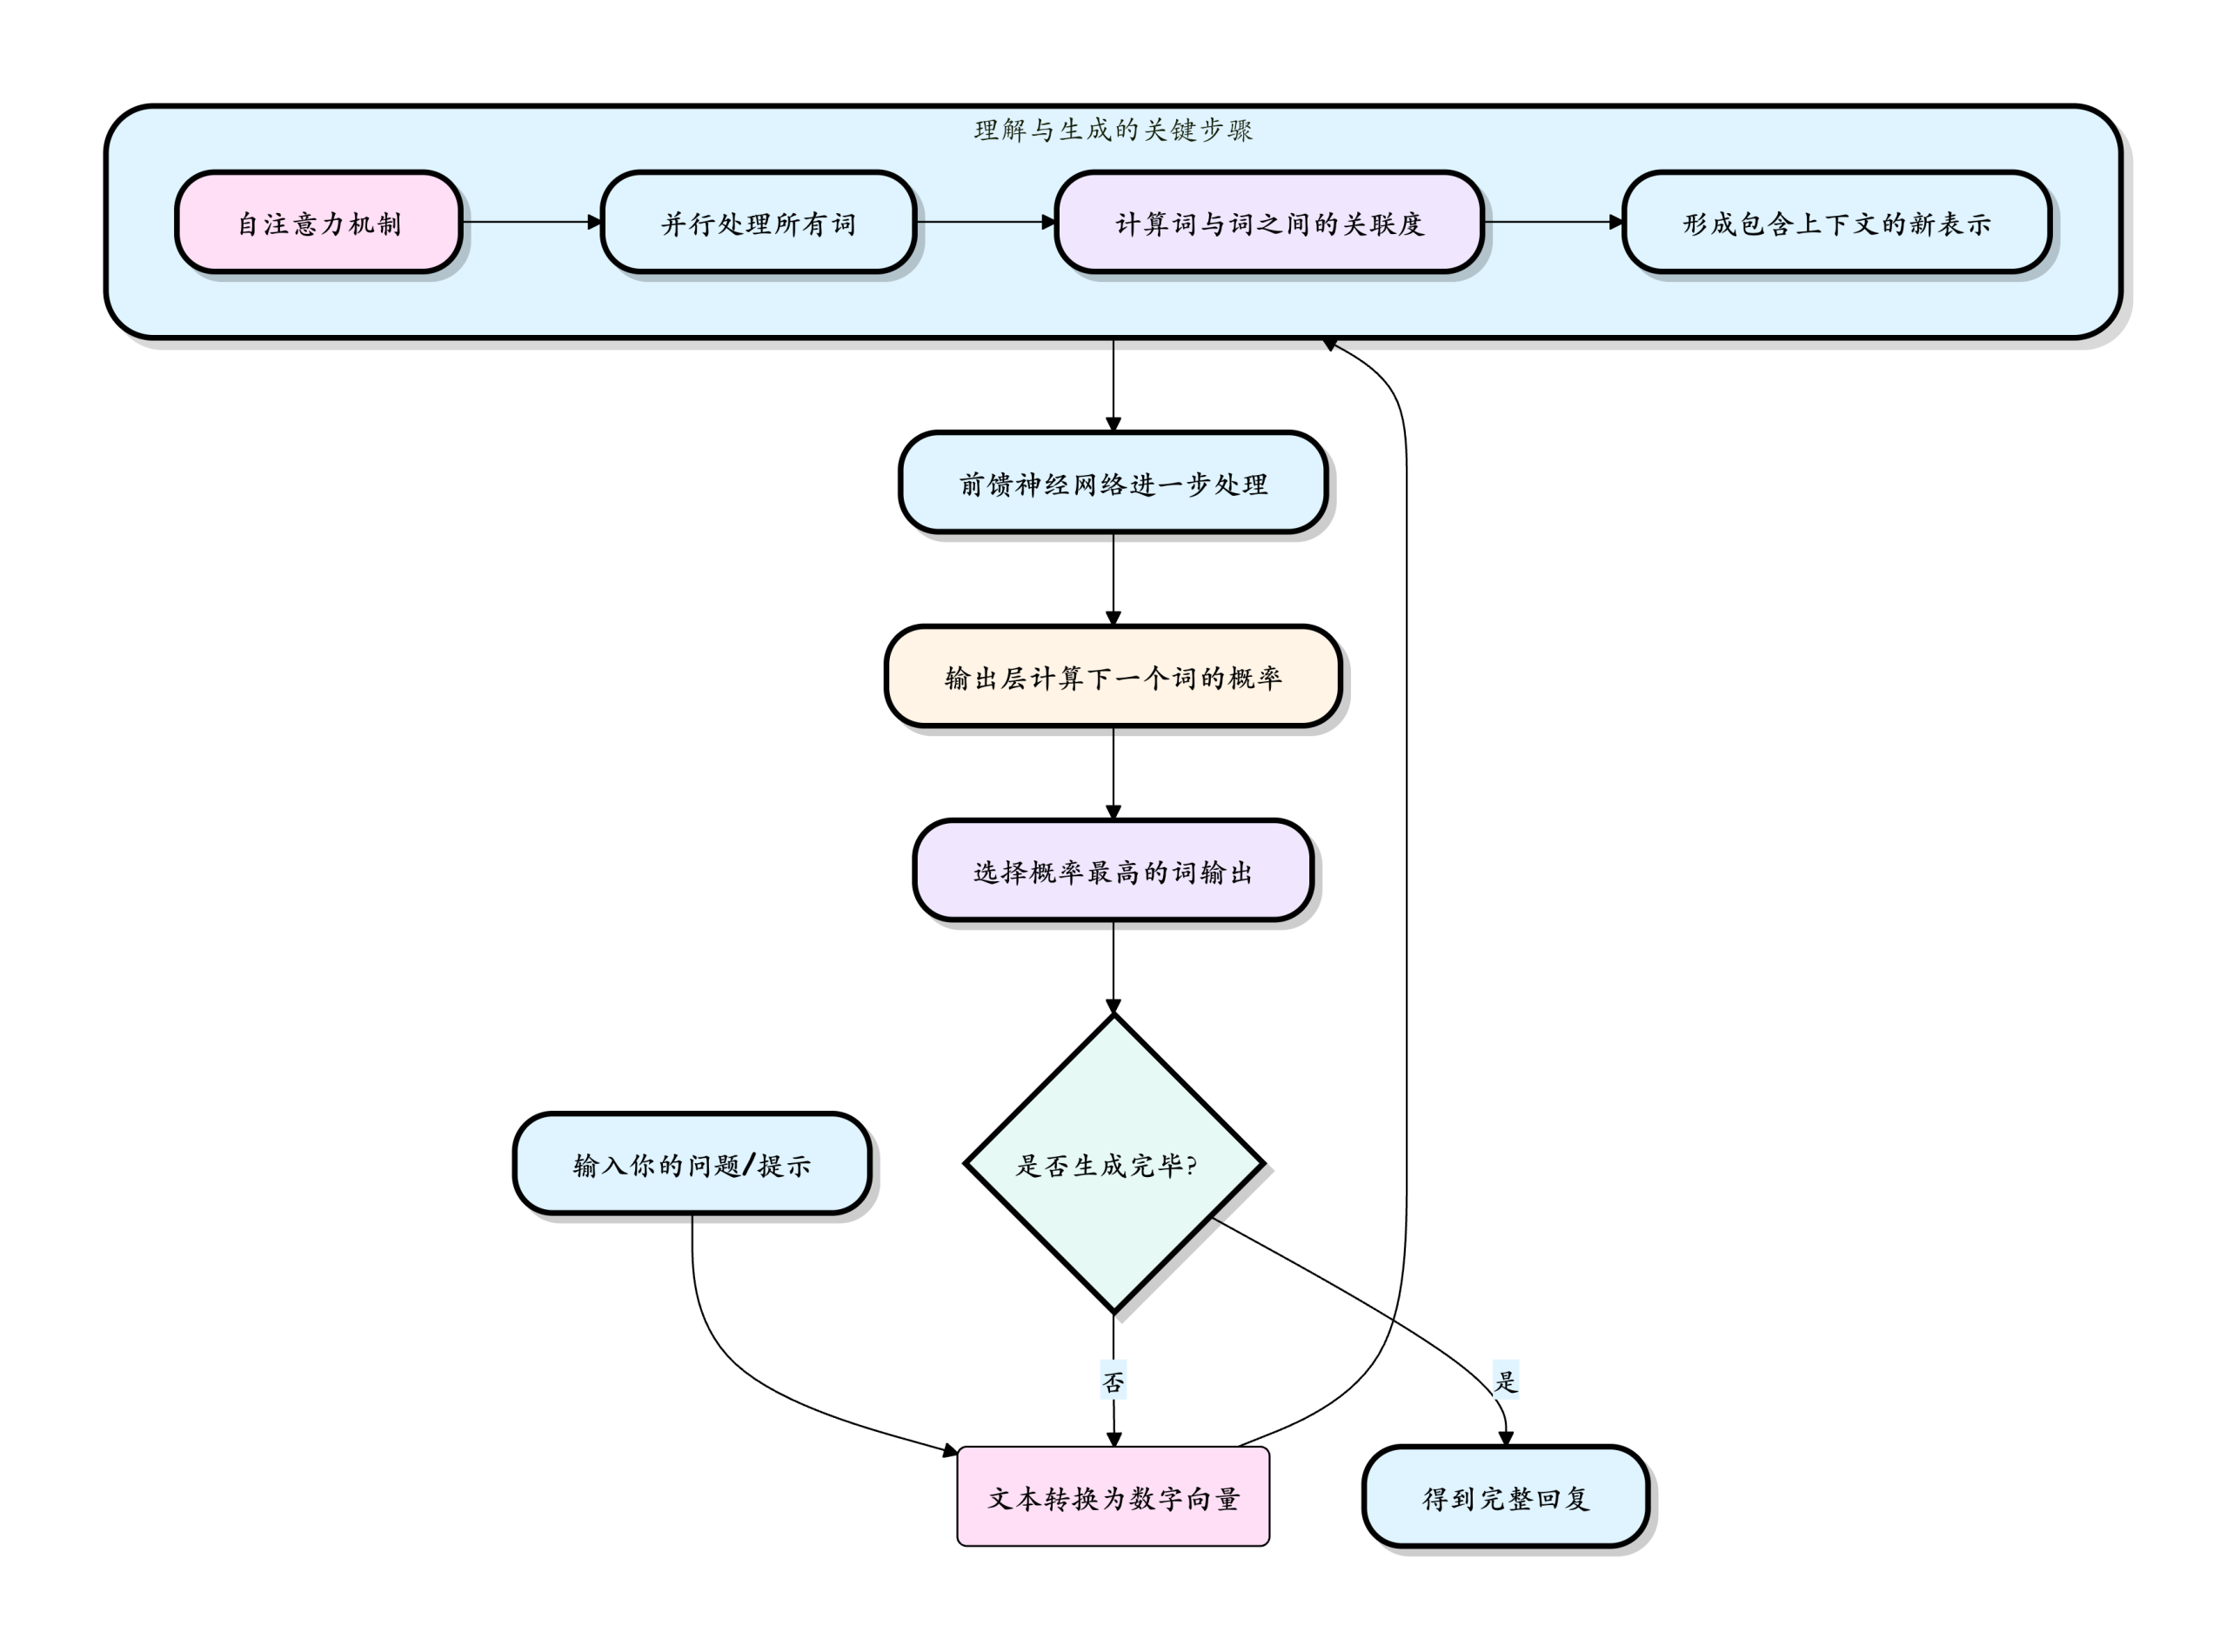
La figure ci-dessous montre le processus par lequel un LLM génère du texte mot par mot—il prédit un mot à la fois, puis intègre ce nouveau mot dans l'entrée, continue à prédire le mot suivant et répète ce cycle jusqu'à ce qu'une réponse complète soit générée :

Démonstration animée :
Chaque étape ne fait qu'une seule chose : en se basant sur le texte précédent, prédire le mot suivant.
Bien que les LLM soient puissants, ils ont aussi des limites claires :
| Capacité | Description | Limite |
|---|---|---|
| Coupure des connaissances | Les données d'entraînement ont une date limite | Ne peut pas connaître de nouvelles informations après l'entraînement |
| Calculs mathématiques | Peut effectuer des calculs simples | Les calculs complexes sont sujets aux erreurs |
| Informations en temps réel | Nécessite des outils externes pour l'assistance | Ne peut pas accéder seul aux données en temps réel |
| Exactitude factuelle | Peut générer des informations incorrectes | Nécessite une vérification des faits |
| Traitement de textes longs | La longueur du contexte a des limites | Les textes extrêmement longs peuvent perdre des informations |
| Cohérence logique | Peut être contradictoire | Nécessite une conception et une validation minutieuses |
Rappel important :Les LLM ne sont pas omniscients ; ce sont essentiellement des systèmes de reconnaissance de motifs statistiques. Ce n’est qu’en comprenant leurs limites que nous pouvons mieux exploiter leurs capacités.
Principe de fonctionnement essentiel : une brève analyse de l’architecture Transformer
Les capacités remarquables des LLM sont indissociables de leur technologie fondamentale sous-jacente —l’architecture TransformerIl n’est pas nécessaire d’approfondir des principes mathématiques complexes, mais vous pouvez comprendre ses idées essentielles.
Imaginez que vous voulez écrire un article sur le système solaire :
- Parcourir les documentsVous commenceriez par consulter de nombreux livres et pages web pertinents.
- Identifier les points clésVous remarqueriez que des mots comme Soleil, planètes, orbites et gravité apparaissent fréquemment et sont liés entre eux.
- Organiser le langageEn fonction du point que vous voulez développer (par exemple, présenter Mars), vous utiliseriez de manière sélective les informations déjà vues sur la taille, la couleur, la position, etc. de Mars, et les organiseriez en phrases cohérentes.
La façon dont Transformer fonctionne est similaire ; son processus central se divise en trois étapes :
- Traitement des entréesVos mots sont découpés en tokens (mots ou caractères) et convertis en nombres (vecteurs) que les ordinateurs peuvent comprendre.
- Compréhension du contexte (cœur):Le mécanisme d’auto-attentioncommence à fonctionner. Il permet au modèle, lorsqu’il traite chaque mot d’une phrase, de pondérer l’importance detous les autres motsdans la phrase. Ce processus estparallèleet extrêmement rapide.
- Génération et itération: Le modèle calcule une distribution de probabilité en fonction de sa compréhension de tous les mots, et prédit le mot suivant le plus probable. Après avoir sélectionné et produit ce mot, il l’utilise comme nouvelle entrée et répète tout le processus jusqu’à ce qu’une réponse complète soit générée.
L’auto-attention est l’innovation la plus cruciale du Transformer. Prenons comme exemple la phrase « le téléphone d’Apple a une très grande batterie », lorsque le modèle traitecemot, le mécanisme d’auto-attention aide le modèle à détermineriletAppleettéléphonesont fortement corrélés. La figure ci-dessous montre la distribution des poids d'attention dans ce processus :
C'est précisément cette capacité àtraiter en parallèleet àcomprendre en profondeur le contexte globalqui permet aux LLM basés sur Transformer de surpasser de loin les technologies précédentes (comme les RNN) sur les tâches linguistiques.
Comment interagir avec les LLM : Introduction à l'ingénierie des prompts
PromptC'est l'entrée que vous donnez au LLM. Il indique au modèle ce que vous voulez, comme lorsque vous donnez des instructions à un assistant : plus les instructions sont claires, meilleurs sont les résultats. La qualité du prompt détermine directement la qualité de la réponse.
Un bon prompt se compose généralement des quatre parties suivantes :
Principes de base
Soyez clair et précis: évitez les expressions vagues. Ne dites pasÉcrivez quelque chose sur les chiens, mais dites plutôtDans un langage vif et vivant, rédigez une courte introduction d'environ 100 mots sur les traits de personnalité des golden retrievers pour des enfants de 6 à 8 ans.。
Fournissez le contexteIndiquez au modèle votre identité, votre parcours et vos objectifs. Par exemple :Vous êtes un mentor expérimenté en programmation Python. Veuillez expliquer ce que sont les listes en compréhension à un débutant qui vient d'apprendre la syntaxe de base, et fournir un exemple simple.
Précisez le format: si vous avez besoin d'une sortie dans un format spécifique, indiquez-le clairement, par exemple :Veuillez résumer les points suivants en trois pucesouVeuillez produire une sortie au format JSON。
Raisonnement étape par étape (Chain-of-Thought): pour les problèmes complexes, vous pouvez guider le modèle pour qu'il raisonne étape par étape dans le prompt, par exemple :Veuillez analyser ce problème étape par étape : listez d'abord les conditions connues, puis déduisez les étapes intermédiaires, et enfin donnez la conclusion.Cette approche peut considérablement améliorer la précision des tâches de raisonnement complexes.
Scénarios d'application courants des LLM
| Catégorie de scénario | Exemple concret | Description |
|---|---|---|
| Création et édition de contenu | Rédiger des e-mails, des rapports, des blogs ; continuer des histoires ; peaufiner un texte ; traduire des textes dans différents styles | Générer rapidement des brouillons, fournir de l'inspiration et plusieurs modes d'expression |
| Récupération et résumé d'informations | Lire rapidement de longs documents et en extraire les points clés ; questions-réponses basées sur des bases de connaissances | Comprend mieux les questions que la recherche traditionnelle, peut résumer et intégrer |
| Assistance à la programmation | Expliquer du code, générer des extraits de code, déboguer des erreurs, refactoriser du code, écrire des cas de test | Agit comme un partenaire de programmation 24h/24 et 7j/7, améliorant considérablement l'efficacité du développement |
| Conversation et service client | Chatbots intelligents, tuteurs personnalisés, jeu de rôle | Fournit des expériences interactives anthropomorphes et contextuellement cohérentes |
| Raisonnement logique et analyse | Résoudre des problèmes mathématiques, effectuer un raisonnement logique de base, analyser des tendances de données, établir des plans | Démontre des capacités de raisonnement surprenantes dans des domaines limités |
Appels API et paramétrage
Pour construire un agent IA, vous devez apprendre à appeler des LLMs via API.
Dans ce chapitre, nous utilisons l'API OpenAI comme exemple pour présenter les méthodes d'appel de base.
openai est une puissante bibliothèque Python pour interagir avec une gamme de modèles et services OpenAI. Pour plus de détails, voir :Python OpenAI。
Adresse open source :https://github.com/openai/openai-python
Appels API de base
1. Installer les bibliothèques requises
pip install openai
Ensuite, vous devez créer un compte sur le site officiel d'OpenAI et générer une clé API sur la page des clés API.
Exemple
from openai import OpenAI
client = OpenAI(
# Ceci est la valeur par défaut et peut être omis
api_key=La clé API que vous avez demandée,
)
response = client.responses.create(
model="gpt-4o",
instructions="Vous êtes un assistant de codage qui parle comme un pirate.",
input="Comment vérifier si un objet Python est une instance d'une classe ?",
)
print(response.output_text)
Accéder à OpenAI au niveau national reste encore un peu compliqué. De nombreux services nationaux prennent également en charge OpenAI, comme DeepSeek et Qwen d'Alibaba.
DeepSeek
L'API DeepSeek est entièrement compatible avec le format de l'API OpenAI. Il vous suffit de modifier quelques configurations pour utiliser directement le SDK OpenAI ou des outils compatibles afin d'accéder à l'API DeepSeek.
Paramètres de configuration principaux :
| Paramètre | Valeur/Description |
|---|---|
| base_url | Requis, valeur fixe :https://api.deepseek.com(Vous pouvez également renseignerhttps://api.deepseek.com/v1, uniquement pour la compatibilité OpenAI ; v1 n'est pas lié à la version du modèle) |
| api_key | Requis. Vous devez d'abord demander une clé API exclusive sur le site officiel de DeepSeek (adresse de demande :https://platform.deepseek.com/) |
| model | Requis,
|
Exemple
from openai import OpenAI
# Initialiser le client (configuration principale : remplacez par votre clé API)
client = OpenAI(
api_key=os.environ.get('DEEPSEEK_API_KEY'), # Il est recommandé de configurer via une variable d'environnement, ou de coder en dur directement (non recommandé)
base_url="https://api.deepseek.com" # Domaine fixe de DeepSeek
)
# Appeler l'API de chat
try:
response = client.chat.completions.create(
model="deepseek-v4-flash", # Spécifiez le modèle, options : deepseek-v4-flash / deepseek-v4-pro
messages=[
{"role": "system", "content": "Vous êtes un assistant utile"}, # Définition du rôle système
{"role": "user", "content": "Hello"}, # Question de l'utilisateur
],
stream=False # Sortie non-streaming (renvoie le résultat complet en une seule fois)
)
# Afficher le contenu de la réponse
print("Résultat de la réponse :", response.choices[0].message.content)
except Exception as e:
print("Échec de l'appel :", str(e))
Alibaba Bailian
Le modèle Tongyi Qianwen d'Alibaba Cloud Bailian prend en charge l'interface compatible OpenAI. Il vous suffit d'ajuster l'API Key, BASE_URL et le nom du modèle pour migrer votre code OpenAI existant vers le service Alibaba Cloud Bailian.
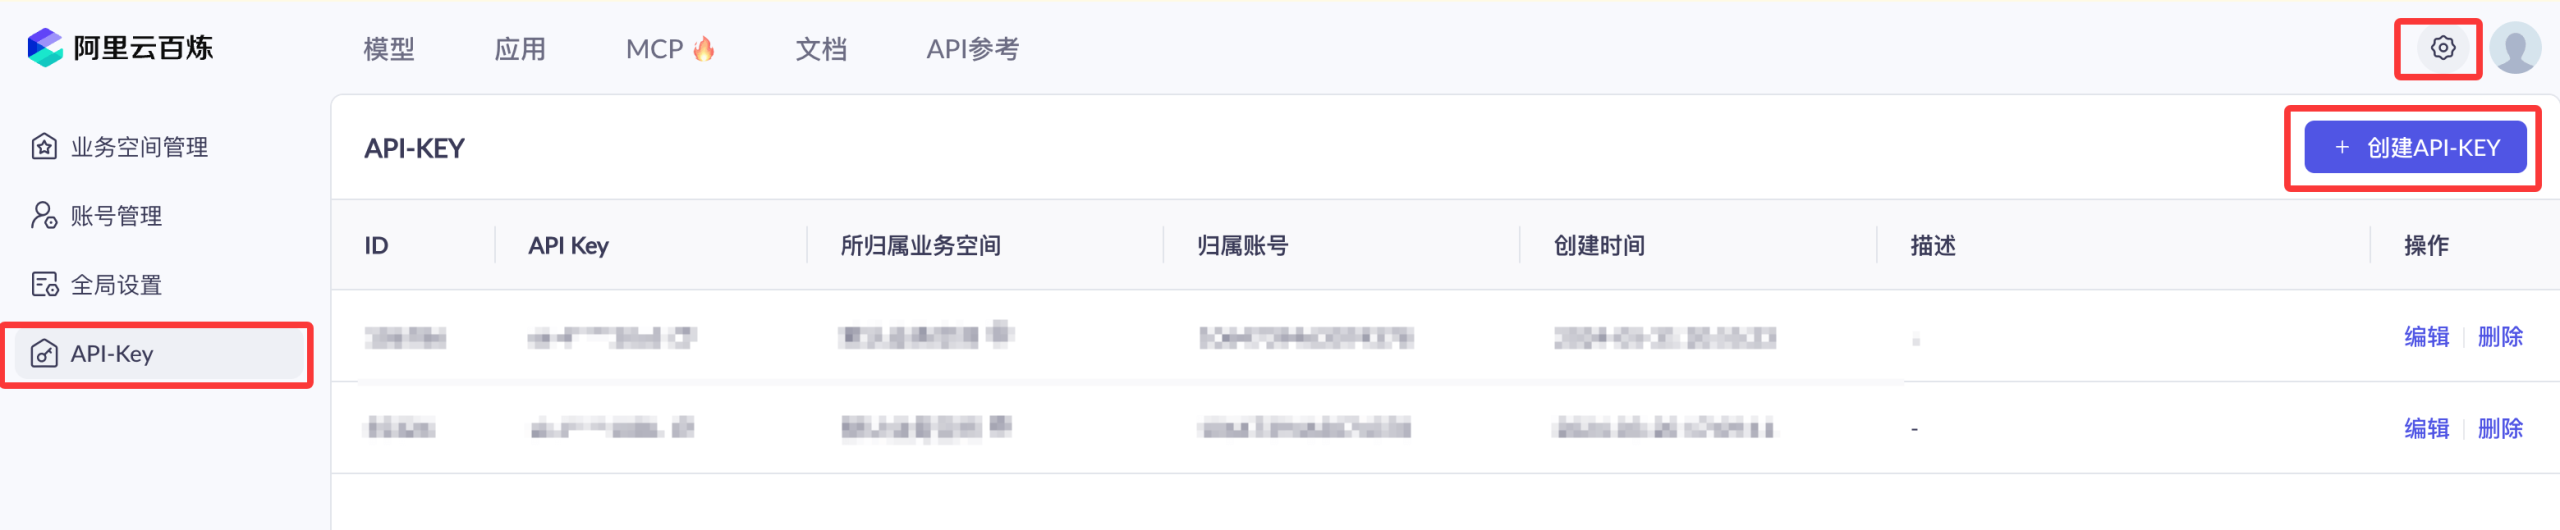
Nous devons activer le service de modèle Alibaba Cloud Bailian et obtenir une API-KEY.
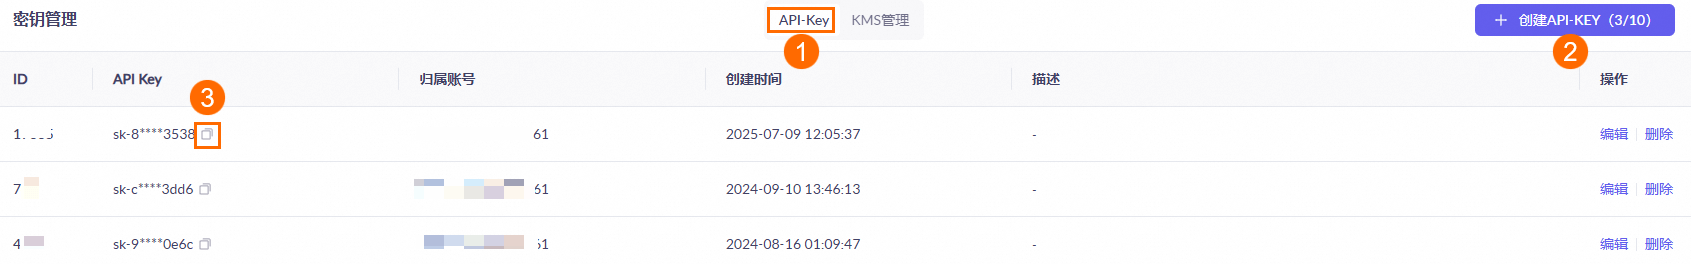
Nous pouvons d'abord utiliser le compte principal Alibaba Cloud pour accéder à la plateforme de service de modèle Bailian :https://bailian.console.aliyun.com/, puis cliquez sur Connexion dans le coin supérieur droit. Après vous être connecté, cliquez sur l'icône d'engrenage ⚙️ dans le coin supérieur droit, sélectionnez Clé API, puis copiez la clé API. Si vous n'en avez pas, vous pouvez également créer une clé API :
L'activation d'Alibaba Cloud Bailian n'entraîne pas de frais. Seuls les appels aux modèles (après dépassement du quota gratuit), le déploiement de modèles et le fine-tuning de modèles entraîneront des frais correspondants.
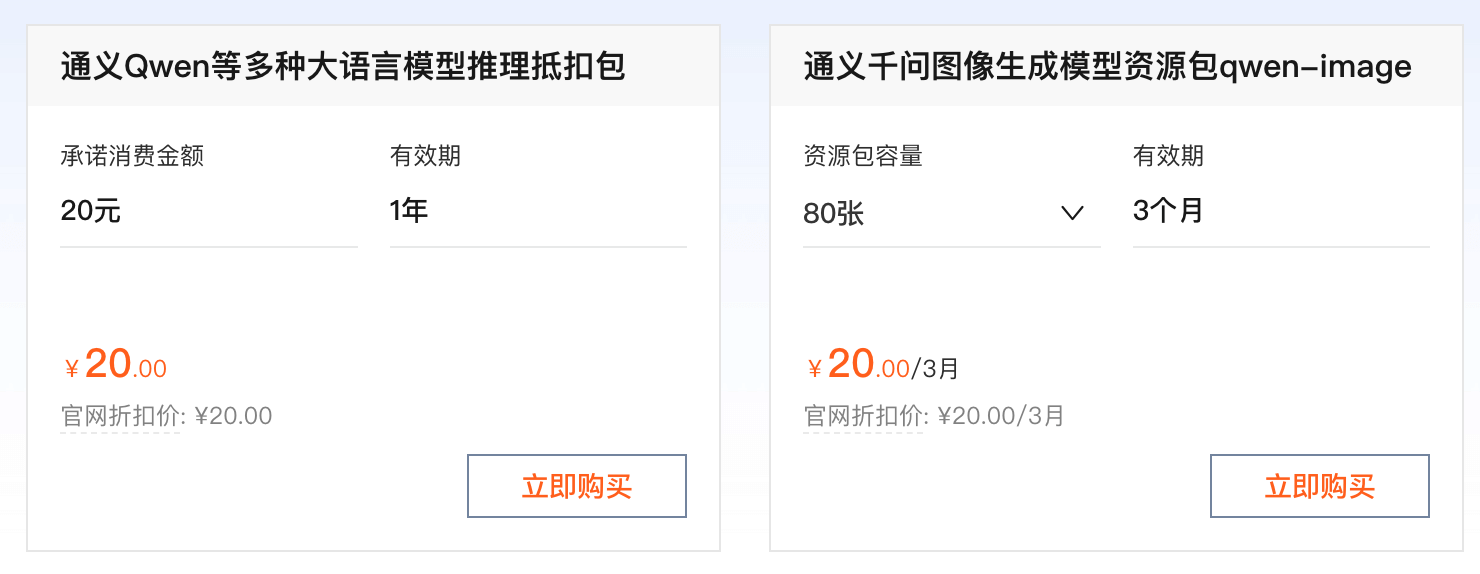
Maintenant, pour utiliser l'API, vous êtes facturé au token. Heureusement, ce n'est pas cher. Nous pouvons d'abord acheter le forfait le moins cher :Plateforme de service de grands modèles Alibaba Cloud Bailian。
Vous pouvez également utiliser directement le forfait Coding Plan de Bailian et Ark :https://www.example.com/claude-code/coding-plan.html。
Utilisation
Ensuite, nous utilisons le SDK OpenAI pour accéder au modèle Qwen sur Bailian.
Exemple d'appel non-streaming
Exemple
import os
def get_response():
client = OpenAI(
api_key="sk-xxx", # Veuillez utiliser la clé API Alibaba Cloud Bailian
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1", # Remplissez le base_url du SDK DashScope
)
completion = client.chat.completions.create(
model="qwen-plus", # Ici, qwen-plus est utilisé comme exemple ; vous pouvez modifier le nom du modèle selon vos besoins. Liste des modèles : https://help.aliyun.com/zh/model-studio/getting-started/models
messages=[{'role': 'system', 'content': 'Vous êtes un assistant serviable.'},
{'role': 'user', 'content': 'Qui êtes-vous ?'}]
)
# Données JSON
#print(completion.model_dump_json())
print(completion.choices[0].message.content)
if __name__ == '__main__':
get_response()
L'exécution du code produit le résultat suivant :
I am Tongyi Qianwen, a large-scale language model independently developed by the Tongyi Lab under Alibaba Group. I can help you answer questions and create text, such as writing stories, official documents, emails, scripts, logical reasoning, programming, and more. I can also express opinions and play games. If you have any questions or need help, feel free to let me know at any time!
Exemple d'appel en streaming
Exemple
def get_response():
client = OpenAI(
api_key="sk-xxx",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
model="qwen-plus",
messages=[
{'role': 'system', 'content': 'Vous êtes un assistant serviable.'},
{'role': 'user', 'content': 'Qui êtes-vous ?'}
],
stream=True,
stream_options={"include_usage": True}
)
for chunk in completion:
# Le chunk peut ne pas contenir choices ou delta
if hasattr(chunk, "choices") and len(chunk.choices) > 0:
choice = chunk.choices[0]
if hasattr(choice, "delta") and hasattr(choice.delta, "content"):
print(choice.delta.content, end='', flush=True)
if __name__ == '__main__':
get_response()
L'exécution du code produit le résultat suivant :
I am Tongyi Qianwen, a large-scale language model independently developed by the Tongyi Lab under Alibaba Group. I can help you answer questions and create text, such as writing stories, official documents, emails, scripts, logical reasoning, programming, and more. I can also express opinions and play games. If you have any questions or need help, feel free to let me know at any time!
Grands modèles de langage courants
Voici une compilation des sites officiels et des adresses de documentation API des grands modèles de langage courants :