CrewAI crée des agents intelligents.
CrewAI est un framework open source pour la collaboration multi-agents, spécialement conçu pour orchestrer et coordonner plusieurs agents IA afin qu'ils travaillent ensemble.
CrewAI peut décomposer une tâche complexe en plusieurs rôles, chacun responsable d'une partie, et l'accomplir grâce à une collaboration par processus.
Compréhension comparative :
- Agent unique: Un grand modèle, du début à la fin.
- CrewAIChef de produit + Ingénieur + Analyste + Éditeur, chacun faisant son propre travail.
CrewAI est un outil pour coordonner, gérer et encadrer des Agents IA, construit sur LangChain et Pydantic, afin de faciliter les équipes d'Agents jouant des rôles, autonomes et collaboratives.
- Crew: Un composé de plusieurs
AgentL'équipe projet s'est formée. - Agent (Membre): : Les individus de l'équipe, chacun a un
role(Rôle) clair,goal(Objectif) etbackstory(histoire de fond). - Task: Le travail spécifique qui doit être accompli par l'équipe. Une
CrewContient plusieurs tâches ordonnées ou parallèlesTask, et les assigner aux agents appropriésAgent。 - Process: Définit le flux de travail de l'équipe, par exemple, si les tâches sont exécutées séquentiellement ou en parallèle.
En termes simples, crewAI fournit une manière structurée de définir qui (Agent) fait quoi (Task) selon quel processus (Process), pour finalement atteindre les objectifs de l'équipe.
Le diagramme de flux ci-dessous montre clairement comment les composants principaux du framework crewAI collaborent :

Le processus commence par la définition d'agents avec des rôles et des objectifs spécifiques, puis par la création de tâches spécifiques pour eux.
Ensuite, ces agents et leurs tâches sont organisés en un crew, et un processus de collaboration est sélectionné pour le crew, tel qu'une exécution séquentielle ou parallèle. Enfin, le crew exécute toutes les tâches selon le processus défini et produit le résultat final.
Configuration et installation de l'environnement
Avant de commencer à construire, nous devons préparer l'environnement de développement.
Prérequis
Versions de Python requises :
- Obligatoire: Python ≥ 3.10 et < 3.14
- Vous pouvez saisir dans le terminal
python --versionpour vérifier. Si la plage de versions n'est pas respectée, de nombreux problèmes surviendront plus tard, et il n'est pas recommandé de passer outre.
CrewAI utiliseUVpour la gestion des dépendances et des paquets, avec un seul objectif :
Pour rendre les projets multi-agents plus stables et éviter qu'ils ne soient mis à mal par des problèmes d'environnement.
Référence du tutoriel d'introduction à UV :UV - outil de gestion des paquets et des environnements Python。
Clé API :
crewAI lui-même ne fournit pas de modèles d'IA ; il doit se connecter à de grands modèles de langage tels que GPT d'OpenAI, Claude d'Anthropic, et d'autres.
Installer crewAI
Ouvrez votre terminal ou votre outil en ligne de commande et utilisez la commande pip pour installer le paquet crewAI.
# 正常安装
pip install crewai
# 其他依赖
pip install langchain
pip install openai


# 如果安装慢,可以使用国内镜像安装
pip install crewai -i https://mirrors.aliyun.com/pypi/simple/
pip install langchain -i https://mirrors.aliyun.com/pypi/simple/
pip install openai -i https://mirrors.aliyun.com/pypi/simple/
Si vous souhaitez utiliser certains des outils avancés intégrés de crewAI (comme la recherche web), vous pouvez installer des dépendances supplémentaires :
# 正常安装
pip install 'crewai[tools]'

# 如果安装慢,可以使用国内镜像安装
pip install 'crewai[tools]' -i https://mirrors.aliyun.com/pypi/simple/
En Chine, nous pouvons utiliser le grand modèle DeepSeek pour les tests. Si vous n'en avez pas encore, vous devez d'abord vous rendre surhttps://platform.deepseek.com/api_keysCréer une clé API.
Référence de la documentation de l'API DeepSeek :https://api-docs.deepseek.com/zh-cn/。
Après l'installation, créez un nouveau fichier Python, par exemplemy_first_crew.py, et importez les bibliothèques nécessaires.
Pour les modèles tiers (y compris DeepSeek), le LLM de crewAI doit passer par LiteLLM au niveau inférieur. Avant utilisation, nous devons installer :
pip install -U litellm
Instance
from crewai.llm import LLM
# =====================================================
# Configuration LLM (format standard DeepSeek | LiteLLM)
# =====================================================
llm = LLM(
model="deepseek/deepseek-v4-flash", # Clé : doit inclure le fournisseur deepseek, puis écrire le nom du modèle deepseek-v4-flash ou deepseek-v4-pro
api_key="sk-xxxxx", # Définir la clé API
api_base="https://api.deepseek.com/v1",
temperature=0.7,
)
# =====================================================
# Agents
# =====================================================
researcher = Agent(
role="Chercheur technique",
goal="Rechercher les documents techniques les plus récents, exacts et vérifiables, et fournir une preuve par le code.",
backstory="Expert dans l'analyse systématique des problèmes techniques, en mettant l'accent sur les faits et la reproductibilité.",
llm=llm,
verbose=True,
allow_delegation=False,
)
writer = Agent(
role="Rédacteur de blog technique",
goal="Organiser les résultats de recherche sous forme d'articles techniques adaptés aux débutants.",
backstory="Expert pour décomposer des concepts complexes en étapes claires et fournir des exemples complets.",
llm=llm,
verbose=True,
allow_delegation=True,
)
# =====================================================
# Tâches
# =====================================================
research_task = Task(
description=(
"Recherche approfondie : utilisez Python pour le nettoyage automatisé des données."\n"
"Les principaux axes de travail incluent : pandas, numpy, les valeurs manquantes, les valeurs dupliquées et les problèmes de format incohérent."\n"
"Doit fournir des exemples de code complets et exécutables."
),
agent=researcher,
expected_output=(
"Un rapport de recherche comprenant la classification des problèmes, le code de solution et le processus complet de nettoyage."
),
)
write_task = Tâche(
description=(
"À partir du rapport de recherche, rédigez un blog technique de niveau débutant."\n"
"Titre : \"Guide du débutant pour le nettoyage de données en Python : dites adieu aux données sales avec pandas\"."
),
agent=writer,
contexte=[research_task],
expected_output="Un blog technique Markdown d'au moins 800 mots.",
)
# =====================================================
# Équipage
# =====================================================
crew = Crew(
agents=[researcher, writer],
tasks=[research_task, write_task],
process=Process.sequential,
verbose=True,
)
# =====================================================
# Exécuter
# =====================================================
if __name__ == "__main__":
result = crew.kickoff()
output = result.raw
with open("python_data_cleaning_blog.md", "w", encoding="utf-8") as f:
f.write(output)
Ensuite, la tâche commencera à s'exécuter et affichera les informations pertinentes :

Une fois terminé, le contenu de sortie sera écrit dans le fichier python_data_cleaning_blog.md.
Ce qui suit est une explication des attributs associés dans le code.
Attributs clés du LLM (couche de modèle)
| Attribut | Valeur d'exemple | Objectif | Conséquence d'une erreur |
|---|---|---|---|
model |
deepseek/deepseek-v4-flash |
Syntaxe canonique LiteLLM:Service Provider/Model Name |
Manquantdeepseek/Lèvera directement une erreurLLM Provider NOT provided |
api_key |
sk-xxxxx |
Authentification du modèle | Si vide ou incorrect, directement 401 / Échec du LLM |
api_base |
https://api.deepseek.com/v1 |
Adresse de l'API DeepSeek | Dépend de l'adresse du modèle spécifique |
temperature |
0.7 |
Contrôle le caractère aléatoire de la sortie | Une valeur trop élevée rend le contenu diffus ; une valeur trop faible rend le texte rigide |
Attributs clés de l'agent (agent intelligent)
| Attribut | Objectif | Essence |
|---|---|---|
role |
Étiquette d'identité de l'agent | Écrit dans le prompt système |
goal |
Objectif principal de l'agent actuel | Détermine l'orientation de la réponse |
backstory |
Contraintes comportementales et style | Stabilise la qualité de la sortie |
llm |
Quel modèle utiliser | Doit être lié explicitement |
verbose |
Afficher le processus d'exécution | N'affecte que les journaux |
allow_delegation |
Si la délégation de tâches est autorisée | Extrêmement facile de tomber dans des pièges |
chercheur
| Attribut | Valeur | Intention de conception |
|---|---|---|
allow_delegation |
False |
Empêcher la décomposition infinie des tâches |
goal |
Trouver des ressources + fournir du code | Le résultat est de la 'matière première' |
rédacteur (rédaction)
| Attribut | Valeur | Risque |
|---|---|---|
allow_delegation |
True |
Peut déclencher à nouveau une délégation vers la recherche |
context |
[research_task] |
Dispose déjà d'une entrée, en fait pas besoin de déléguer à nouveau |
Conclusion
Dans un pipeline séquentiel, l'Agent d'écrituredoit désactiver la délégation, sinon il est facile d'échouer lors d'une re-délégation.
Attributs clés de Task
Champs communs de Task :
| Attribut | Objectif | Point clé |
|---|---|---|
description |
Texte réel de la tâche envoyé au LLM | Plus c'est spécifique, plus c'est stable |
agent |
Qui exécute | Doit être unique |
expected_output |
Contraintes de résultat | Non requis, mais fortement recommandé |
context |
Tâches amont dépendantes | Cœur de l'exécution séquentielle |
research_task:
| Attribut | Description |
|---|---|
agent=researcher |
Lier le chercheur |
Aucunecontext |
Tâche de première étape |
| Sortie | Contenu de recherche structuré |
write_task:
| Attribut | Description |
|---|---|
context=[research_task] |
Forcer la lecture des résultats de recherche |
agent=writer |
Organiser et exprimer uniquement |
| Sortie | Texte Markdown final |
Attributs clés de Crew (Actuator)
| Attribut | Valeur d'exemple | Objectif | Conséquences d'erreur |
|---|---|---|---|
agents |
[researcher, writer] |
Tous les Agents disponibles | Si l'un est manquant, une erreur est levée directement. |
tasks |
[research_task, write_task] |
File d'exécution | Ordre par liste |
process |
Process.sequential |
Stratégie d'exécution | L'exécution parallèle rompra les dépendances |
verbose |
True |
Commutateur de journalisation | Doit être de type bool |
kickoff() et structure de sortie
| Expression | Type | Objectif |
|---|---|---|
crew.kickoff() |
CrewOutput |
Conteneur de résultat d'exécution |
result.raw |
str |
Sortie texte finale |
result.tasks_output |
list/dict | Sortie de chaque tâche |
result.token_usage |
dict | Statistiques |
commande crewai
Nous pouvons utiliser la commandecrewaipour générer la structure complète du projet :
crewai create crew <项目名>
Par exemple, nous créons un projet example-agent-test et exécutons la commande suivante :
crewai create crew example-agent-test
Ensuite, le contenu suivant apparaît. Vous pouvez d'abord sélectionner le fournisseur de grand modèle :
Creating folder example_agent_test...
Cache expired or not found. Fetching provider data from the web...
Downloading  [####################################]  1102019/56339
Select a provider to set up:
1. openai
2. anthropic
3. gemini
4. nvidia_nim
5. groq
6. huggingface
7. ollama
8. watson
9. bedrock
10. azure
11. cerebras
12. sambanova
13. other
q. Quit
Dans ce chapitre, nous allons choisir DeepSeek. Entrez d'abord 13 pour sélectionner autre, puis vous pouvez faire défiler avec la souris pour voir que DeepSeek est à 23. Entrez simplement le nombre 23 :
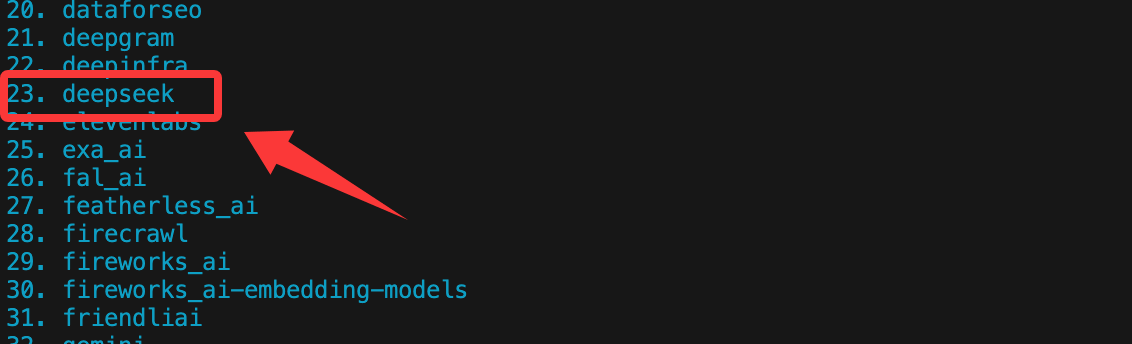
Si vous avez des clés API pour d'autres modèles, sélectionnez simplement en fonction du numéro.
Une fois terminé, vous pouvez voir le répertoire généré comme suit :
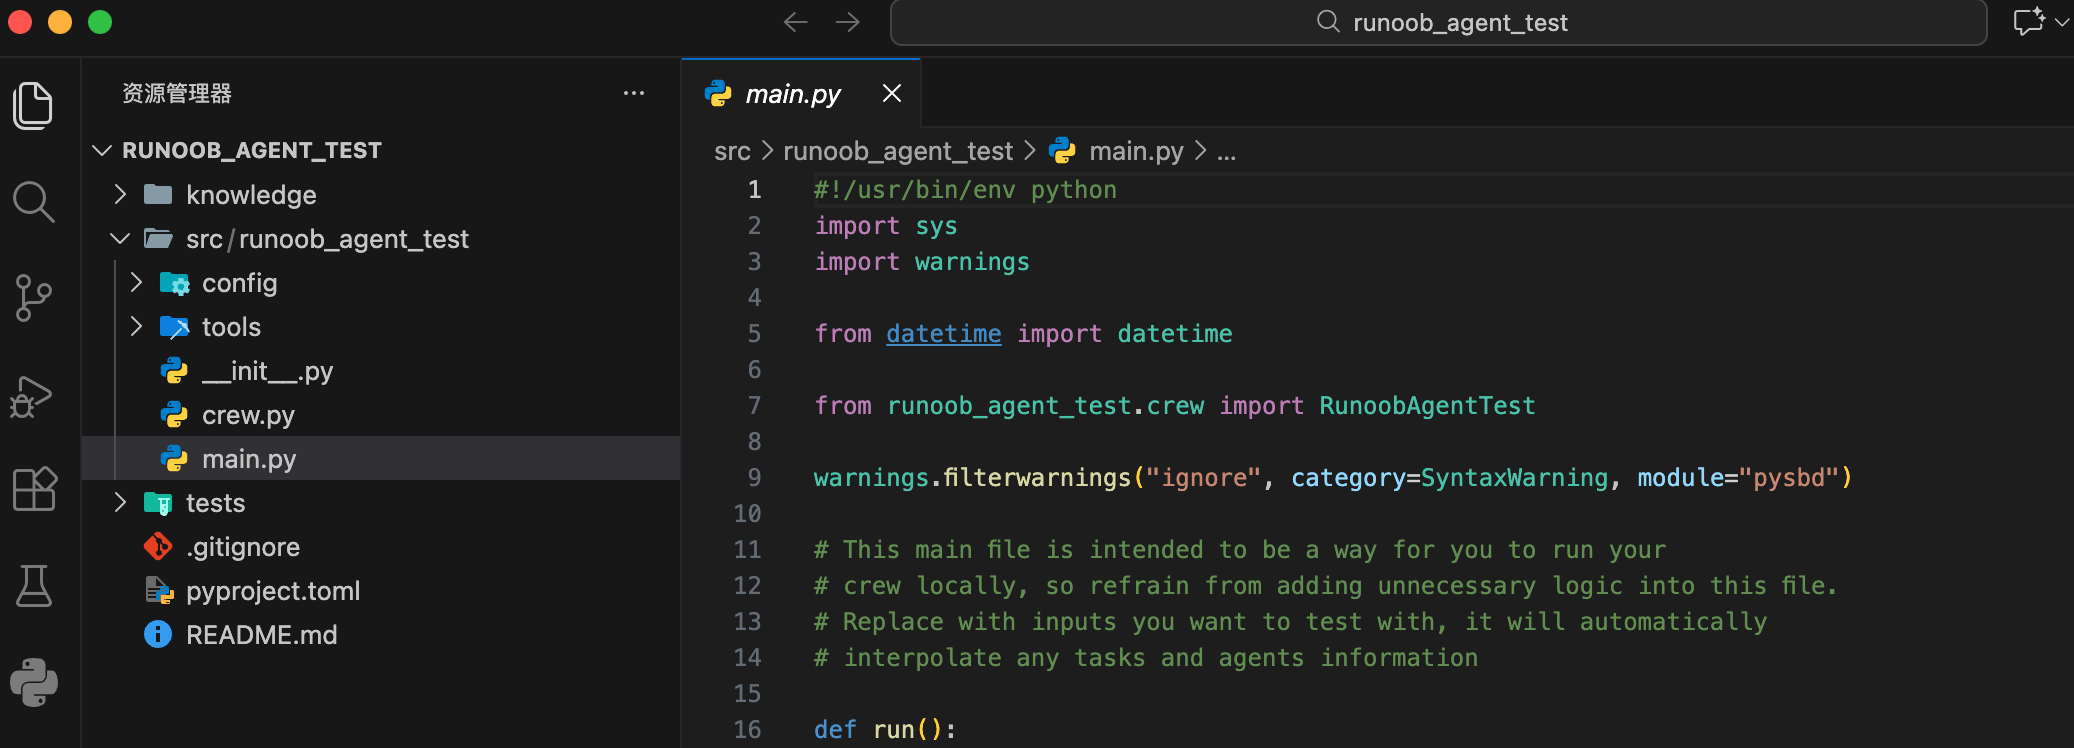
Description de la structure du projet :
my_project/
├── .env                # 环境变量(API Key)
├── pyproject.toml      # 项目依赖声明
├── README.md
└── src/
    └── my_project/
        ├── main.py     # 程序入口
        ├── crew.py     # Crew 与 Agent 的核心逻辑
        ├── tools/      # 自定义工具
        └── config/
            ├── agents.yaml  # Agent 定义
            └── tasks.yaml   # Task 定义
Exécutez votre Crew.
Accédez au répertoire racine du projet :
cd my_project
Verrouillez et installez les dépendances :
crewai install
Exécutez :
crewai run
Ou directement :
python src/my_project/main.py
Configurer la clé API
Pour des raisons de sécurité, il n'est pas recommandé d'écrire la clé API directement dans le code ; nous pouvons la définir comme variable d'environnement.
Définir dans le code (pour test uniquement):
import os
os.environ["OPENAI_API_KEY"] = "你的-openai-api-key-here"
Méthode recommandée : utilisez.envfichier
Dans le répertoire racine du projet, créez un fichier nommé.envfichier.
Écrivez ce qui suit dans le fichier :OPENAI_API_KEY=你的-openai-api-key-here
Dans le code Python, utilisezpython-dotenvle paquet à charger.
Commande d'installation :
pip install python-dotenv
Ensuite, chargez-le dans le code :
from dotenv import load_dotenv
load_dotenv() # 这会自动加载 .env 文件中的变量
# 现在 os.environ["OPENAI_API_KEY"] 就已经有了值
Composants principaux : explication détaillée et pratique
Maintenant, créons notre équipe d'IA étape par étape, comme pour construire une entreprise. Nous allons simuler une équipe de création de blog technique.
Étape 1 : Définir l'agent
Agentest membre de votre équipe. Lors de sa création, vous devez définir plusieurs attributs clés :
| Paramètre | Description | Exemple |
|---|---|---|
| rôle | Le rôle ou le poste de l'agent. | Senior Technical Writer |
| objectif | L'objectif ultime de l'agent. | Create accessible, practical technical tutorials |
| backstory | L'histoire du rôle, utilisée pour façonner son comportement et son ton. | 你是一位拥有10年全栈开发经验的开发者,热爱分享,擅长将复杂概念简单化。 |
| llm | Spécifiez le grand modèle de langage utilisé par l'agent. | ChatOpenAI(model="gpt-4", temperature=0.7) |
| verbose | Défini àTrueLorsqu'il est défini, il affiche le processus de réflexion détaillé de l'agent. |
True(très utile lors du débogage) |
| allow_delegation | Indique s'il faut autoriser cet agent à déléguer des tâches à d'autres agents. | True |
Créons deux agents : unchercheuret unrédacteur。
Exemple
llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0.7)
# Créer l'agent chercheur
researcher = Agent(
role='Chercheur technique',
goal='Trouver les informations techniques les plus récentes, les plus précises et les plus pertinentes pour le sujet assigné.',
backstory='Vous êtes un analyste technique concentré et rigoureux, expert dans l'extraction des points clés à partir d'énormes quantités d'informations et dans la vérification de la fiabilité des sources.',
llm=llm, # Utiliser le modèle défini ci-dessus
verbose=True, # Afficher des journaux détaillés
allow_delegation=False # Le chercheur n'a pas besoin de déléguer des tâches
)
# Créer l'agent rédacteur
writer = Agent(
role='Rédacteur de blog technique',
goal='Rédiger un article de blog technique bien structuré, vivant et intéressant, avec des exemples de code complets, à partir des éléments fournis par le chercheur.',
backstory='Vous êtes un blogueur technique très populaire avec un style d'écriture convivial et une logique rigoureuse, particulièrement doué pour expliquer des concepts complexes à l'aide d'analogies et d'exemples.',
llm=llm,
verbose=True,
allow_delegation=True # Si le rédacteur le juge nécessaire, il peut déléguer des tâches (par exemple, revenir en arrière et demander au chercheur de compléter des éléments).
)
Étape 2 : Créer une tâche
Taskest un élément de travail spécifique qui doit être attribué àAgentpour l'accomplir. Les attributs clés comprennent :
| Parameters | Description | Exemple |
|---|---|---|
| description | Une description claire de la tâche. | 研究 "Python异步编程asyncio" 在 2023 年后的核心应用场景和最佳实践。 |
| agent | Responsable de l'exécution de cette tâcheAgentobjet. |
researcher |
| expected_output | Une description détaillée des livrables de la tâche. | 一份结构化的研究报告,包含概述、3-4个核心应用场景、2-3个代码片段示例以及总结。 |
Nous créons une tâche pour chacun : le chercheur et le rédacteur.
exemple
research_task = Task(
description=(
"Mener une recherche approfondie sur le sujet 'Automated Data Cleaning with Python'.\n"
"Concentrez-vous sur l'utilisation la plus récente des bibliothèques pandas et numpy (après 2023), les problèmes courants de données sales (tels que les valeurs manquantes, les valeurs en double, les formats incohérents) et les flux de nettoyage efficaces.\n"
"Veuillez fournir des extraits de code spécifiques pour illustrer chaque étape.
),
agent=researcher, # Attribuer cette tâche au chercheur
expected_output=(
"Un rapport de recherche complet au format suivant :\n"
"1. Aperçu du sujet\n"
"2. Classification des problèmes de données courants (au moins 3 catégories)\n"
"3. Solutions pandas/numpy pour chaque type de problème (avec des extraits de code)\n"
"4. Un exemple complet de flux de nettoyage de bout en bout\n"
"5. Résumé et recommandations"
)
)
# Créer une tâche de rédaction
write_task = Tâche(
description=(
"En utilisant le rapport de recherche fourni par le chercheur, rédigez un article de blog technique pour débutants."\n"
"Le titre de l'article est : 'Nettoyage de données avec Python pour débutants : dites adieu aux données sales avec pandas'."\n"
"Exigences de l'article : un langage facile à comprendre, une logique progressive, inclure tous les extraits de code clés fournis par le chercheur et ajouter des commentaires détaillés."\n"
"Enfin, fournissez un exemple complet et exécutable qui démontre l'ensemble du processus de nettoyage d'un jeu de données simulé."
),
agent=writer, # Assigner cette tâche au rédacteur
expected_output=(
"Un article de blog au format Markdown d'au moins 800 mots."\n"
"Inclure une introduction, un corps principal (avec des sous-sections), des blocs de code et un résumé."\n"
"Un script Python complet contenant des données simulées et le code de nettoyage doit être joint à la fin de l'article."
),
# Le paramètre context est très important ! Il spécifie les dépendances de cette tâche, c'est-à-dire que research_task doit être terminé en premier.
contexte=[research_task]
)
Remarque write_taskdans lecontext=[research_task], ce qui établit des dépendances entre les tâches, ce qui signifie que le rédacteur doit attendre que le chercheur termine la tâche avant de commencer son travail.
Étape 3 : Constituer l'équipe et mettre en place les processus (Crew & Process)
Maintenant, mettez lesAgentetTaskassembler dansCrew, et définissez leur travailProcess。
Instance
blog_crew = Crew(
agents=[researcher, writer], # Quels membres composent l'équipe
tasks=[research_task, write_task], # Quelles tâches l'équipe a-t-elle
process=Process.sequential, # Type de processus : exécution séquentielle. Le chercheur termine, puis l'écrivain travaille.
verbose=2 # Définir la verbosité des logs lors de l'exécution de l'équipe (0=silencieux, 1=basique, 2=verbeux)
)
crewAI prend principalement en charge deux processus :
Process.sequential: Les tâches sont exécutées dans l'ordre selon la liste. Convient aux opérations de pipeline avec des dépendances strictes.Process.hierarchical: Combiné à un Agent Manager (Manager), qui coordonne et attribue les tâches. Convient aux scénarios de collaboration plus complexes et dynamiques.
Étape 4 : Exécutez la tâche et obtenez les résultats.
Tout est prêt, lancez votre équipe d'IA !
Exemple
result = blog_crew.kickoff()
# Afficher le résultat final
print("###################### Final Results ######################")
print(result)
Exécutez votre script Python (python my_first_crew.py). Comme nous avons définiverbose=Trueetverbose=2, vous verrez le processus de réflexion de chaque Agent et les journaux d'exécution des tâches dans le terminal, et enfin l'article de blog généré.
Techniques avancées : Équiper les agents avec des outils
crewAI permetAgentd’appeler des outils externesTool, comme rechercher sur le web, interroger des bases de données, effectuer des calculs, etc.
L’exemple suivant équipe le chercheur d’outils derecherche webet decalcul:
Exemple
# Initialiser les outils
# Remarque : SerperDevTool nécessite une clé API distincte. Veuillez vous inscrire sur https://serper.dev/ pour l’obtenir.
search_tool = SerperDevTool(serper_api_key="your-serper-api-key")
calc_tool = CalculatorTool()
# Créer un chercheur équipé d’outils
advanced_researcher = Agent(
role='Chercheur technique senior',
goal='Rechercher les dernières tendances technologiques et effectuer une analyse quantitative',
backstory='Vous n'êtes pas seulement doué pour trouver des informations, mais aussi capable d'effectuer des calculs simples et des comparaisons sur des données.',
tools=[search_tool, calc_tool], # Attribuer la liste d'outils à l'agent
llm=llm,
verbose=True
)
Créer une tâche à l'aide d'outils.
analysis_task = Task(
description=(
Rechercher et comparer les chiffres de croissance des étoiles de 'FastAPI' et 'Django' sur GitHub au cours de l'année écoulée.\n"
Calculer les taux de croissance des deux, et analyser les raisons possibles.
),
agent=advanced_researcher,
expected_output=Un bref rapport contenant des données spécifiques, le processus de calcul et l'analyse des causes.
)