Tutoriel GraphRAG pour débutants
GraphRAG est un système de génération augmentée par récupération (RAG) structuré et hiérarchique, publié en open source par Microsoft Research. Contrairement au RAG traditionnel, qui utilise une récupération vectorielle de texte pur, GraphRAG utilise d'abord un grand modèle de langage pour extraire les entités et les relations des documents bruts, construit un graphe de connaissances, puis effectue la récupération et la réponse aux questions en se basant sur la structure du graphe.
Ce tutoriel est conçu pour les débutants sans connaissances préalables, vous guidant à travers le flux de travail complet depuis l'installationdocument → graphe de connaissances → requête Q&RLe modèle utilisé estqwen-plus, et l'Embedding utilise letext-embedding-v4 d'Alibaba Cloud Tongyi。

Qu'est-ce que GraphRAG
Pour comprendre GraphRAG, vous devez d'abord comprendre en quoi il est meilleur que le RAG traditionnel.
Limites du RAG traditionnel
Le flux de travail du RAG traditionnel (Baseline RAG) est le suivant : diviser les documents en petits morceaux → générer des vecteurs → lorsqu'une question est posée, utiliser la similarité vectorielle pour récupérer les morceaux les plus pertinents → les fournir au modèle pour générer une réponse.
Cette approche fonctionne bien pour les questions de type "récupération exacte", mais donne de mauvais résultats dans deux scénarios :
- Raisonnement relationnel inter-documents: Lorsque la réponse nécessite de relier des informations dispersées dans différents documents, la similarité vectorielle ne peut pas exprimer cette "relation". Par exemple, "Quel est le point commun entre le PDG de la société A et le fondateur de la société B ?"
- Questions de synthèse globale: Lorsque la question nécessite un résumé au niveau macro de l’ensemble du corpus, quelques segments de texte ne peuvent pas donner une vue d’ensemble. Par exemple, « Quels sont les points de risque les plus critiques dans ce lot de rapports financiers ? »
Comment GraphRAG résout ces deux problèmes
L’idée centrale de GraphRAG est la suivante :Au lieu de récupérer directement des segments de texte, il construit d’abord un graphe de connaissances, puis effectue la récupération en fonction de la structure du graphe.。
L’ensemble du processus est divisé en deux étapes :
| Étape | Ce qu’il fait | Ce qu’il produit |
|---|---|---|
| Index | Utiliser le LLM pour lire les documents, extraire les entités (personnes, lieux, organisations, etc.) et les relations, puis construire un graphe de connaissances ; ensuite, utiliser l’algorithme Leiden pour effectuer un clustering hiérarchique sur le graphe et générer un résumé pour chaque communauté. | Graphe de connaissances + résumés de communautés + index vectoriel |
| Requête | Lorsqu’un utilisateur pose une question, différentes stratégies de récupération sont sélectionnées en fonction du type de question, et les données du graphe, les résumés de communautés ainsi que les segments de texte originaux sont tous injectés dans le contexte du LLM pour générer une réponse. | Réponses structurées avec références aux sources |
La phase d’indexation de GraphRAG nécessite d’appeler un grand nombre d’API LLM, d’effectuer l’extraction d’entités et la génération de résumés sur chaque segment de texte,La consommation de tokens est bien plus élevée que celle du RAG traditionnel. Il est recommandé, pour une première utilisation, de tester d’abord le flux de travail avec un petit document (de quelques milliers de caractères), puis de ne traiter des corpus à grande échelle qu’après avoir confirmé qu’il fonctionne correctement.
Comparaison de quatre modes de requête
| Mode de requête | Stratégie de récupération | Types de questions appropriés | Consommation de ressources |
|---|---|---|---|
| Recherche globale | Map-Reduce : parcourir tous les résumés de communauté | Questions globales et de synthèse, telles que « Quel est le thème central de ces documents ? » | Élevée (appels LLM multiples simultanés) |
| Recherche locale | En partant des entités pertinentes, étendre les voisins et les textes associés | Questions sur des entités spécifiques, telles que « le principal réseau de relations d'une personne » | Moyenne |
| Recherche DRIFT | Recherche locale + suivi itératif guidé par les informations de la communauté | Questions liées aux entités nécessitant un contexte large, équilibrant profondeur et étendue | Moyenne-élevée |
| Recherche de base | Similarité vectorielle standard (identique au RAG traditionnel) | Récupération exacte simple à des fins de comparaison | Faible |
Exigences d'environnement
Avant de commencer, assurez-vous que votre environnement répond aux exigences suivantes.
| Dépendances | Exigences de version | Description |
|---|---|---|
| Python | 3.10 ~ 3.12 | Périmètre de support officiel ; 3.13 n'est pas pris en charge pour le moment. |
| pip | Dernière version | Recommandé en premierpip install --upgrade pip |
| Clé API Alibaba Cloud Bailian | — | Rendez-vous surbailian.console.aliyun.com/pour faire une demande |
| Espace disque | ≥ 2GB | Les artefacts d'index (fichiers Parquet, base de données vectorielle) occuperont un espace important. |
Installation
GraphRAG est publié sur PyPI. Il est recommandé de l'installer dans un environnement virtuel Python afin d'éviter de polluer l'environnement système.
Créer un répertoire de projet et initialiser un environnement virtuel
mkdir graphrag_demo
cd graphrag_demo
python -m venv .venv
Vous pouvez également utiliserla commande uvpour spécifier une version de Python :uv venv --python 3.12
Activer l'environnement virtuel
macOS / Linux :
source .venv/bin/activate
Windows:
.venv\Scripts\activate
Installer GraphRAG
pip install graphrag
Une fois l'installation terminée, vérifiez :
graphrag --help
Il affichera des informations sur la commandegraphrag. La sortie ressemblera à :
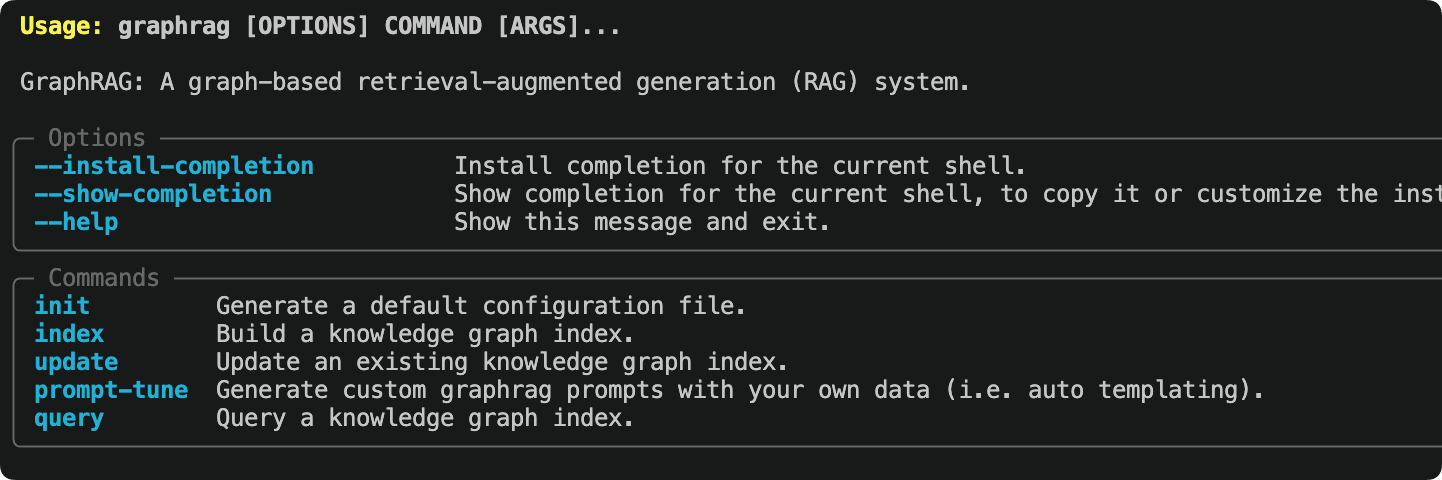
GraphRAG installera automatiquement des dépendances telles que LiteLLM, LanceDB, pandas et numpy. La première installation peut prendre un certain temps (généralement 1-3 minutes). Veuillez patienter.
Initialiser l'espace de travail
Exécutezgraphrag initla commande, GraphRAG générera les fichiers de configuration et la structure de répertoires dans le répertoire courant.
graphrag init
Il nous invitera à définir les modèles. Appuyez simplement sur Entrée pour accepter les valeurs par défaut ; nous pourrons les modifier plus tard :
Specify the default chat model to use [gpt-4.1]:
Specify the default embedding model to use [text-embedding-3-large]:
Pendant l'initialisation, il vous sera demandé de saisir le modèle Chat et le modèle Embedding par défaut. Vous pouvez simplement appuyer sur Entrée pour ignorer pour l'instant ; nous les modifierons manuellement plus tard.settings.yaml。
Une fois l'initialisation terminée, la structure des répertoires est la suivante :
graphrag_demo/
├── .env                  # 存放 API Key 环境变量
├── settings.yaml         # 核心配置文件
├── input/                # 存放待处理的文本文件
├── output/               # 索引产物输出目录(自动生成)
└── prompts/              # Prompt 模板目录(自动生成)
Après chaque mise à niveau de version mineure de GraphRAG, il est recommandé de réexécuter
graphrag init --forcepour actualiser le format de configuration ; sinon, des erreurs peuvent survenir en raison de modifications de la structure de configuration. Notez que cette commande écrasera l'existantsettings.yamlet les prompts. Il est recommandé de les sauvegarder au préalable.
Préparer les documents de test
GraphRAG prend en charge.txt、.csv、.jsonles documents au format ... . Tous les fichiers à traiter doivent être placés dans leinput/répertoire.
Nous utilisons le document de test officiellement recommandé — « A Christmas Carol » de Charles Dickens — téléchargé directement depuis Project Gutenberg :
curl /static.jyshare.com/download/pg24022.txt?v=2 -o ./input/book.txt
S'il n'y a pas d'accès réseau, vous pouvez également créer vous-même un texte de test en chinois. Plus le contenu est riche (incluant de nombreux personnages, lieux et relations entre événements), plus l'effet du graphe de connaissances de GraphRAG sera évident :
Placez le fichier dans leinputrépertoire, avec le nom de fichierdemo.txt:
SpaceX 太空探索技术公司成立于 2002 年,由埃隆·马斯克(Elon Musk)在美国加利福尼亚州霍桑市创办。
公司目标是大幅降低太空运输成本,最终实现人类移民火星。

马斯克早年联合创立了 PayPal,2002 年以 15 亿美元出售给 eBay,随后将个人资产投入 SpaceX.
联合创始人中,汤姆·穆勒(Tom Mueller)担任推进系统首席设计师,主导了 Merlin 和 Raptor 发动机的研发。
格温·肖特维尔(Gwynne Shotwell)于 2002 年加入,2008 年起担任总裁兼 COO,负责公司日常运营和商业拓展。

2008 年,猎鹰 1 号(Falcon 1)在经历三次失败后首次成功入轨,成为首个由私营公司研制的液体轨道火箭。
2010 年,猎鹰 9 号(Falcon 9)首飞成功,同年龙飞船(Dragon)完成首次商业发射与回收。
2012 年,龙飞船成为首个对接国际空间站的商业航天器。

2015 年 12 月,猎鹰 9 号一级火箭首次实现陆地垂直回收,开创了火箭重复使用的新纪元。
此后 SpaceX 累计完成超过 200 次火箭回收,单枚助推器最高复用次数达到 20 次以上。

2020 年,载人龙飞船(Crew Dragon)将 NASA 宇航员送入国际空间站,标志着商业载人航天时代的开始。
Starlink 星链项目自 2019 年启动,截至 2024 年已在轨部署超过 5000 颗卫星,覆盖全球超过 60 个国家和地区。

Starship 星舰是 SpaceX 正在研发的超重型运载系统,由超重助推器(Super Heavy)和星舰飞船组成,
设计目标为完全可重复使用,近地轨道运力超过 100 吨,是 NASA 阿尔忒弥斯登月计划的指定着陆器。

竞争对手方面,SpaceX 主要面临来自蓝色起源(Blue Origin)和联合发射联盟(ULA)的压力。
蓝色起源由亚马逊创始人杰夫·贝索斯创立,专注亚轨道旅游和重型火箭 New Glenn 的研发。
ULA 由洛克希德·马丁和波音合资成立,长期承担美国军方卫星发射任务。

Configurer qwen-plus et le modèle d'embedding
C'est l'étape la plus critique de l'ensemble du tutoriel ; vous devez modifier.envetsettings.yamldeux fichiers.
Étape 1 : Configurer la clé API
Open.envfichier, puis renseignez votre clé API :
Exemple
# Clé API Alibaba Cloud Bailian
DASHSCOPE_API_KEY=sk-your-dashscope-api-key-here
Étape 2 : Modifier settings.yaml
Opensettings.yaml, puis remplacez tout le contenu par la configuration suivante.
GraphRAG 2.x utilise LiteLLM pour appeler de manière uniforme divers modèles,model_provider: openaiAvecapi_basevous pouvez transmettre les requêtes vers n'importe quelle interface compatible avec OpenAI :
completion_models:
  default_completion_model:
    model_provider: openai
    model: qwen-plus                              # 中文抽取稳定,成本低于 qwen-plus
    auth_method: api_key
    api_key: ${DASHSCOPE_API_KEY}
    api_base: https://dashscope.aliyuncs.com/compatible-mode/v1
    call_args:
      temperature: 0                              # 提高结构化稳定性
      max_tokens: 4096
    retry:
      type: exponential_backoff
      max_retries: 5
      base_delay: 2

embedding_models:
  default_embedding_model:
    model_provider: openai
    model: text-embedding-v4                      # 通义向量模型
    auth_method: api_key
    api_key: ${DASHSCOPE_API_KEY}
    api_base: https://dashscope.aliyuncs.com/compatible-mode/v1
    retry:
      type: exponential_backoff
      max_retries: 5

input:
  type: text

input_storage:
  type: file
  base_dir: input

chunking:
  type: tokens
  size: 600                                       # 中文推荐 500~800
  overlap: 100
  encoding_model: o200k_base

output_storage:
  type: file
  base_dir: output

reporting:
  type: file
  base_dir: logs

cache:
  type: json
  storage:
    type: file
    base_dir: cache

vector_store:
  type: lancedb
  db_uri: output/lancedb

embed_text:
  embedding_model_id: default_embedding_model    # 注意不要带逗号
  batch_size: 10                                 # 百炼 embedding 单次最多10条
  batch_max_tokens: 6000
  concurrency: 1                                 # 避免并发触发限流

extract_graph:
  completion_model_id: default_completion_model
  entity_types: []                               # 自动识别实体
  max_gleanings: 3                               # 提高关系补抽成功率

summarize_descriptions:
  completion_model_id: default_completion_model
  max_length: 500

cluster_graph:
  max_cluster_size: 20                           # 降低社区数量

extract_claims:
  enabled: false

community_reports:
  completion_model_id: default_completion_model
  max_length: 1500
  max_input_length: 4000                         # 防止生成阶段过慢

snapshots:
  graphml: true                                  # 导出图结构
  embeddings: false

local_search:
  completion_model_id: default_completion_model
  embedding_model_id: default_embedding_model
  top_k_entities: 10

global_search:
  completion_model_id: default_completion_model
  map_max_length: 500
  reduce_max_length: 1500
À propos de la sortie JSON de Qwen :GraphRAG exige que le modèle renvoie de manière stable le format JSON lors de l'extraction d'entités. Qwen prend en charge le mode JSON ; définir
temperatureà 0 peut encore améliorer la stabilité de sortie et réduire la probabilité d'échecs d'analyse. Si des erreurs d'analyse JSON se produisent encore, vous pouvez essayercall_argsd'ajouter àresponse_format: {type: json_object}。
Lancer l'indexation
Une fois la configuration terminée, exécutez la commande d'indexation. GraphRAG lira automatiquementinput/tous les fichiers du répertoire, appellera qwen-plus pour l'extraction d'entités, la reconnaissance de relations et la génération de résumés, puis construira finalement un graphe de connaissances complet.
graphrag index
Vous verrez une sortie de progression semblable à ce qui suit :
⠹ GraphRAG Indexer
├── Loading Input (text) - 1 files loaded
├── create_base_text_units
├── extract_graph
│   └── Entity Extraction: 100%|████████████| 12/12 [02:34<00:00]
├── summarize_descriptions
├── cluster_graph
├── community_reports
└── generate_text_embeddings
All workflows completed successfully.
Une fois l'indexation terminée,output/une série de fichiers Parquet sera générée dans le répertoire :
| Fichier | Contenu |
|---|---|
entities.parquet | Toutes les entités extraites (nom, type, description, vecteur) |
relationships.parquet | Relations entre les entités (entité source, entité cible, description de la relation, poids) |
communities.parquet | Communautés générées par le clustering Leiden (structure hiérarchique) |
community_reports.parquet | Rapport de synthèse pour chaque communauté (données essentielles pour Global Search) |
text_units.parquet | Segments de texte originaux (source de référence pour Local Search) |
lancedb/ | Base de données vectorielle, stockant les vecteurs de diverses entités et segments de texte |
Référence de temps d'indexation :Pour un document chinois de quelques milliers de caractères (environ 10–20 segments de texte), l'utilisation de qwen-plus prend environ 3–10 minutes ; pour de grands ensembles de documents dépassant 100,000 caractères, cela peut prendre plusieurs heures. Il est recommandé de d'abord dérouler le flux de travail avec un petit document, puis de traiter des données à grande échelle.
Exécuter des requêtes
Une fois l'indexation terminée, vous pouvez interroger le graphe de connaissances. GraphRAG propose deux méthodes : CLI et l'API Python.
Requêtes CLI
Recherche globale (adaptée aux questions de niveau macro) :
graphrag query "文档中涉及的主要组织和人物有哪些?它们之间有什么关系?"
Recherche locale (adaptée aux questions sur des entités spécifiques), ajoutez--method local:
graphrag query "SpaceX 公司的主要业务和合作伙伴有哪些?" --method local
Recherche DRIFT (équilibre entre profondeur et étendue) :
graphrag query "埃隆·马斯克的职业背景和主要贡献是什么?" --method drift
Recherche vectorielle de base (comparée au RAG traditionnel) :
graphrag query "Starship 星舰的设计目标和能力是什么?" --method basic
Requêtes via l'API Python
Appelez des requêtes GraphRAG dans le code, adapté à l'intégration dans des applications.
Exemple
# Utilisez l'API Python GraphRAG pour les requêtes
import asyncio
from graphrag.api import GraphRagConfig, search
async def run_query():
# Charger le fichier de configuration (lire settings.yaml depuis le répertoire courant)
config = GraphRagConfig.from_yaml("settings.yaml")
# ── Exemple de recherche globale ──────────────────────────────
print("=" * 60)
print("[Recherche globale] Question globale")
print("=" * 60)
global_result = await search(
config=config,
query="Quel est le réseau de relations des principales entreprises et personnes mentionnées dans les documents ?",
method="global", # Utiliser la recherche globale
)
print(global_result.response)
print()
# ── Exemple de recherche locale ──────────────────────────────
print("=" * 60)
print("[Recherche locale] Question sur une entité spécifique")
print("=" * 60)
local_result = await search(
config=config,
query="Quel est le parcours de l'équipe fondatrice de SpaceX et ses principaux produits ?",
method="local", # Utiliser la recherche locale
)
print(local_result.response)
print()
# Afficher les informations de source récupérées (facultatif)
if hasattr(local_result, "context_data"):
entities = local_result.context_data.get("entities", [])
print(f"Nombre d'entités pertinentes récupérées : {len(entities)}")
if __name__ == "__main__":
asyncio.run(run_query())
python query_demo.py
============================================================
【Global Search】全局性问题
============================================================
根据文档内容,主要涉及以下公司和人物关系网络:

**公司层面:**
- SpaceX 公司:主要角色,覆盖商业发射、载人航天、卫星互联网三大方向
- NASA:重要合作伙伴,阿尔忒弥斯登月计划 Starship 着陆器供应商
- 蓝色起源 / 联合发射联盟:主要竞争对手

**人物层面:**
- 马斯克(创始人):PayPal 联合创始人,SpaceX CEO 兼首席工程师
- 汤姆·穆勒(联合创始人):推进系统首席设计师,Merlin 和 Raptor 发动机之父
- 格温·肖特维尔:总裁兼 COO,负责公司商业运营

**关键关系:**
SpaceX 与 NASA 于 2020 年建立战略合作关系,
三家公司(SpaceX、蓝色起源、ULA)在商业航天发射市场形成竞争格局...

============================================================
【Local Search】针对特定实体的问题
============================================================
SpaceX 公司成立于 2002 年,创始团队包括:
- 马斯克:PayPal 联合创始人,SpaceX CEO 兼首席工程师,航天领域超二十年经验
- 汤姆·穆勒:推进系统首席设计师,主导 Merlin 和 Raptor 发动机研发

主要产品:
1. 猎鹰 9 号:全球首个实现垂直回收的轨道级火箭,已完成 200 次以上回收
2. Starship 星舰:超重型运载系统,近地轨道运力超 100 吨,完全可重复使用

检索到相关实体数量:12
Réglage automatique des prompts
GraphRAG recommande officiellement et vivement d'exécuter le réglage automatique des prompts avant de traiter vos propres données.
Le réglage automatique amènera le LLM à lire une partie de vos documents, puis à générer des prompts d'extraction d'entités personnalisés pour votre domaine de données, ce qui aboutira à une construction de graphe de connaissances de meilleure qualité.
graphrag prompt-tune --config settings.yaml --root . --language Chinese
Une fois le réglage terminé,prompts/les fichiers Prompt du répertoire seront automatiquement mis à jour. Si vos documents sont en chinois, ajoutez le--language Chineseparamètre afin que le Prompt généré utilise aussi le chinois, ce qui améliore la précision d'extraction des entités en chinois.
Le réglage des prompts consomme lui aussi des tokens LLM (environ l'équivalent d'un indexage rapide d'un petit nombre de documents). Il est recommandé de relancer le réglage chaque fois que vous modifiez votre jeu de données, plutôt que d'utiliser toujours les prompts par défaut.
Référence rapide pour les commandes CLI courantes
Voici les commandes les plus couramment utilisées dans l'utilisation quotidienne de GraphRAG.
| Commande | Description |
|---|---|
graphrag init | Initialiser l'espace de travail et générer.env、settings.yaml、input/ |
graphrag init --force | Forcer la réinitialisation (à utiliser après une mise à niveau de version) ; écrasera la configuration existante |
graphrag index | Pairinput/Exécuter le pipeline d'indexation complet sur les documents du répertoire |
graphrag index --resume | Reprendre l'indexation là où elle a été interrompue (les appels LLM sont mis en cache, donc les tokens ne sont pas consommés de manière répétée) |
graphrag index --update | Indexation incrémentielle ; ne traite que les documents nouvellement ajoutés |
graphrag query "问题" | Requête Global Search (mode par défaut) |
graphrag query "问题" --method local | Requête Local Search |
graphrag query "问题" --method drift | Requête DRIFT Search |
graphrag query "问题" --method basic | Basic Search (récupération vectorielle) |
graphrag prompt-tune | Auto-tune Prompt (recommandé à exécuter avant de traiter de nouveaux jeux de données) |
Référence complète des champs de settings.yaml
Ci-dessous, nous fournissonssettings.yamlune explication détaillée des éléments de configuration les plus couramment utilisés pour faciliter les ajustements ultérieurs.
Relatif au modèle
| Champ | Type | Description |
|---|---|---|
model_provider | string | Fournisseur de modèle ; à renseigner lors de l'utilisation d'une interface compatible OpenAIopenai |
model | string | Nom du modèle ; pour Qwen, à renseignerqwen-plus ou qwen-max |
api_key | string | Clé API ; recommandé d'utiliser${ENV_VAR}références de variables d'environnement |
api_base | string | Point de terminaison d'API ; pour Qwen, il s'agit dehttps://dashscope.aliyuncs.com/compatible-mode/v1 |
call_args.temperature | float | Température de génération ; recommandé de la définir sur 0 lors de l'indexation pour améliorer la stabilité |
call_args.max_tokens | int | Nombre maximal de tokens par génération |
retry.max_retries | int | Nombre maximal de tentatives en cas d'échec d'une requête |
Lié au chunking
| Champ | Description | Valeur recommandée |
|---|---|---|
chunking.size | Nombre maximal de tokens par segment de texte | Anglais : 1200~1500 ; Chinois : 600~1000 |
chunking.overlap | Nombre de tokens en chevauchement entre segments adjacents pour éviter que les entités soient tronquées aux limites | 50~150 |
chunking.type | tokens(découpage par token) ousentence(découpage par phrase) | Utiliser généralementtokens |
Lié à l'extraction d'entités
| Champ | Description | Recommandation |
|---|---|---|
extract_graph.entity_types | Indiquez au modèle la liste des types d'entités sur lesquels concentrer l'extraction | Personnalisez selon votre domaine métier, par exempleperson, company, product, technology |
extract_graph.max_gleanings | Nombre maximal de questions de suivi par segment de texte (les questions de suivi peuvent améliorer le rappel mais consomment plus de tokens) | Définissez à 1 pour équilibrer le coût, à 2 pour privilégier la qualité |
FAQ
Que faire si l'indexation échoue à mi-parcours ?
GraphRAG met en cache les résultats de chaque appel LLM. Après un échec, relancez simplementgraphrag indexLes segments de texte déjà traités avec succès seront lus depuis le cache et ne consommeront pas de tokens de manière répétée.
Si vous souhaitez redémarrer à partir d'une étape spécifique, utilisez--resumele paramètre :
graphrag index --resume
Comment gérer les erreurs d'analyse JSON ?
La phase d'extraction d'entités exige que le modèle renvoie strictement au format JSON. SiJSONDecodeError, vous pouvez essayer les méthodes suivantes :
- Dans
call_argsajoutezresponse_format: {type: json_object}(nécessite que le modèle prenne en charge ce paramètre) - va
temperatureDéfinir sur 0 - va
max_gleaningsDéfinir sur 0 (réduire les questions de suivi, diminuer la probabilité d'erreur) - Exécutez
graphrag prompt-tuneRéoptimiser le prompt pour que le modèle soit plus familier avec le format de sortie
Comment choisir entre la recherche globale et la recherche locale ?
| Type de question | Mode recommandé | Exemple |
|---|---|---|
| Synthèse, globale | Recherche globale | « Quel est le thème central de ces documents ? » « La vue d'ensemble de tout le réseau de relations entre personnages » |
| Pour des entités spécifiques | Recherche locale | « L'expérience professionnelle de Musk ? » « Principales caractéristiques techniques de la fusée Falcon 9 » |
| Nécessite à la fois de la profondeur et de l'étendue | Recherche DRIFT | "Analyse de la relation entre une certaine personne et l'écosystème environnant" |
| Recherche simple et précise | Recherche de base | "En quelle année SpaceX a-t-elle été fondée ?" |
Comment contrôler une consommation élevée de tokens ?
- va
chunking.sizeAugmenter de manière appropriée (moins de segments de texte = moins d'appels LLM) - va
extract_graph.max_gleaningsDéfinir sur 0 ou 1 - Dans
entity_typesconserver uniquement les types d'entités les plus pertinents pour l'activité - Utiliser un modèle moins cher pendant l'indexation, et basculer vers un modèle plus puissant pendant la requête si nécessaire
GraphRAG fournit une stratégie de "configuration de modèle asymétrique" : dans
completion_modelsDéfinir plusieurs modèles dans ..., utiliser des modèles à faible coût pendant l'indexation, et utiliser des modèles plus performants pour les requêtes critiques pendant la phase de requête, en trouvant un équilibre entre coût et qualité.
Comment gérer les documents chinois ?
Lors du traitement de documents chinois, les points suivants nécessitent une attention particulière :
- Assurez-vous
input.encoding: utf-8(UTF-8 déjà par défaut) - Diminuer
chunking.size(Les caractères chinois ont une densité d'information élevée ; 600~1000 tokens suffisent) - Exécutez
graphrag prompt-tune --language ChineseGénérer un prompt chinois entity_typesVous pouvez ajouter de manière appropriée des types spécifiques au chinois, tels quegovernment_agency(agences gouvernementales),policy(politiques)
Pour aller plus loin
| Sujet | Description | Lien |
|---|---|---|
| Documentation officielle complète | Contient des descriptions détaillées de tous les éléments de configuration | microsoft.github.io/graphrag |
| Référence de configuration | Description complète des champs de settings.yaml | microsoft.github.io/graphrag/config/yaml/ |
| Guide de sélection des modèles | Comment intégrer divers LLMs (y compris l'utilisation de LiteLLM) | microsoft.github.io/graphrag/config/models/ |
| Explication détaillée du moteur de requête | Principes et réglage des paramètres des quatre modes de requête | microsoft.github.io/graphrag/query/overview/ |
| Guide de réglage des prompts | Description complète du réglage automatique et manuel des prompts | microsoft.github.io/graphrag/prompt_tuning/overview/ |
| Guide de visualisation | Utilisez les outils officiels pour visualiser le graphe de connaissances | microsoft.github.io/graphrag/visualization_guide/ |
| Article GraphRAG | Article original de Microsoft Research, pour comprendre les principes sous-jacents | arxiv.org/pdf/2404.16130 |