Tutoriel de prise en main de Dify
Dify (Do It For You) est actuellement la plateforme open source de développement d'applications LLM la plus populaire, conçue spécialement pour créer des applications d'IA génératives alimentées par de grands modèles de langage (LLM).
Dify intègre l'orchestration des flux de travail d'IA, les bases de connaissances RAG, les frameworks d'agents, la gestion des modèles et l'observabilité dans une seule plateforme visuelle, ce qui vous permet de passer rapidement du prototype à la production sans construire une infrastructure LLM à partir de zéro.
Dify simplifie la création d'applications d'IA en intégrant des pipelines RAG, des flux de travail d'IA, des outils d'observabilité et la gestion des modèles.
Si LangChain estune usine de composants pour applications d'IA(flexible mais nécessite beaucoup de code écrit à la main), alors Dify estun IDE visuel pour applications d'IA—tous les composants sont là, il suffit de glisser, connecter et exécuter.

Comparaison avec d'autres outils
Voici une comparaison de Dify avec LangChain et n8n selon les principaux critères.
| Dimension | Dify | LangChain | n8n |
|---|---|---|---|
| Utilisateurs principaux | Développeur + Chef de produit | développeur | Opérations/Automatisation |
| Prérequis de programmation | Low-code / No-code | Écriture de Python/JS requise | low-code |
| RAG intégré | Entièrement intégré | Assemblage manuel requis | Limité |
| Framework d'agents | Intégré | Intégré | Limité |
| Observabilité | Intégré | Composant tiers requis | Limité |
| Auto-hébergé | Entièrement pris en charge | Pris en charge | Pris en charge |
| Licence | Apache 2.0 | MIT | Fair-code |
Le studio d'orchestration visuelle intuitif de Dify en fait un choix idéal pour les startups et les entreprises qui doivent rapidement créer des applications d'IA fonctionnelles.
LangChain est plus adapté aux applications complexes de niveau entreprise qui nécessitent des intégrations personnalisées et une implication approfondie des développeurs.
Qui utilise Dify ?
De la biomédecine à l'industrie automobile, Dify fournit des solutions fiables pour un large éventail d'entreprises.
Volvo Cars utilise Dify pour la validation rapide d'idées dans la navigation stratégique à la pointe de l'IA.
Les utilisateurs saluent vivement Dify pour avoir démocratisé le développement d'agents IA en combinant de puissantes capacités d'IA/ML dans une plateforme no-code.
Concepts fondamentaux
Avant de commencer, comprenons les concepts de base de Dify :
| Concept | Description |
|---|---|
| Application | L'unité de déploiement de base dans Dify. Chaque application correspond à une fonction IA indépendante, avec son propre prompt système, sa base de connaissances associée, sa configuration d'outils et sa clé API. |
| Base de connaissances | Une base de connaissances est votre propre collection de données qui peut être intégrée dans des applications d'IA. Elle fournit aux LLM vos données propriétaires comme source de vérité supplémentaire lors des réponses, garantissant des réponses plus précises, plus pertinentes et moins sujettes aux hallucinations. |
| RAG (Génération augmentée par récupération) | Lorsqu'un utilisateur pose une question, le système récupère d'abord les informations les plus pertinentes dans la base de connaissances (Récupération), puis combine les résultats récupérés avec la question d'origine de l'utilisateur et les envoie au LLM (Augmentation), et le LLM génère une réponse plus précise en fonction de ce contexte (Génération). |
| Workflow | Créez et testez de puissants flux de travail d'IA sur un canevas visuel, en définissant une logique de traitement d'IA en plusieurs étapes par glisser-déposer de nœuds et connexion de lignes. |
| Agent | Les agents peuvent être définis sur la base de LLM Function Calling ou ReAct, avec des outils prédéfinis ou personnalisés qui leur sont ajoutés. Dify fournit plus de 50 outils intégrés pour les agents d'IA, tels que Google Search, DALL E, Stable Diffusion et WolframAlpha. |
| Nœud | L'unité de base d'un flux de travail ; chaque nœud effectue une opération spécifique : raisonnement LLM, récupération de connaissances, exécution de code, requêtes HTTP, branchement conditionnel, etc. |
Installation et démarrage
Quatre méthodes d'installation, du démarrage instantané au déploiement en cluster à haute disponibilité.
Méthode 1 : Dify Cloud (le plus rapide, prise en main en 0 seconde)
Visitezcloud.dify.ai, créez un compte et commencez à l'utiliser immédiatement.
Le forfait Sandbox gratuit inclut 200 messages par mois et 5 applications, sans configuration d'environnement requise.
Convient aux essais rapides, aux projets personnels et au prototypage.

Méthode 2 : Auto-hébergement avec Docker Compose (recommandé pour la production)
Convient aux utilisateurs ayant un profil technique, offrant un contrôle total sur les données et l'environnement de déploiement.
Configuration système requise
| Ressource | Configuration minimale requise | Configuration recommandée |
|---|---|---|
| CPU | 2 cœurs | 4 cœurs |
| Mémoire | 4 GB | 8 GB |
| Disque | 20 GB | 50 GB+ |
| Docker | Moteur 20.10+ | Dernière version |
| Docker Compose | v2.2+ | Dernière version |
Étapes d'installation
Étape 1 : Cloner le dépôt
Clonez le dépôt Dify sur votre machine locale :
git clone https://github.com/langgenius/dify.git
cd dify
Étape 2 : Accédez au répertoire docker et copiez la configuration d'environnement
cd docker
# 从模板复制环境配置文件
cp .env.example .env
Étape 3 (Important) : Configurez SECRET_KEY
Depuis la v1.14.1, les déploiements Docker ne reposent plus sur une clé secrète par défaut publique. Lorsque SECRET_KEY est vide, l'API génère et conserve automatiquement une clé d'exécution. Il est recommandé de la définir explicitement dans le fichier .env.
# 生成一个安全的随机密钥
openssl rand -base64 42
Modifiez le fichier .env, recherchez SECRET_KEY et définissez sa valeur sur la chaîne aléatoire générée ci-dessus :
SECRET_KEY=your-very-long-random-secret-key-here
Étape 4 : Démarrez le service
# 启动所有 Dify 服务(首次会拉取镜像,约需 3-10 分钟)
docker compose up -d
Étape 5 : Accédez et initialisez
Ouvrez http://localhost/install dans votre navigateur et terminez l'enregistrement du compte administrateur.
Étape 6 : Vérifiez l'état du service
# 查看所有容器状态,全部为 healthy 即表示运行正常
docker compose ps
Si tous les conteneurs (api, worker, web, db, redis, weaviate, nginx, etc.) sont en état healthy, les services fonctionnent normalement.
Arrêter et redémarrer
# 停止所有服务(数据保留在 Docker volumes 中)
docker compose down

# 重新启动所有服务
docker compose up -d
Mettre à niveau vers une nouvelle version
# 进入 docker 目录
cd dify/docker

# 拉取最新代码
git pull origin main

# 拉取新镜像
docker compose pull

# 重新启动
docker compose up -d
Les données sont persistées dans des volumes Docker, et les mises à jour n'affecteront pas les applications et bases de connaissances existantes, ni l'historique des conversations. Il est recommandé de sauvegarder la base de données PostgreSQL avant les mises à niveau de version majeure.
Méthode 3 : Déploiement en un clic sur AWS Marketplace
Pour les startups et les petites entreprises opérant sur AWS, Dify Premium sur AWS Marketplace permet un déploiement en un clic dans votre propre VPC AWS, et prend en charge un logo et une image de marque personnalisés.
Méthode 4 : Déploiement Kubernetes (haute disponibilité)
Pour les scénarios nécessitant une configuration de haute disponibilité, la communauté fournit des Helm Charts et des fichiers YAML pour déployer Dify dans un cluster Kubernetes.
# 添加 Dify Helm 仓库
helm repo add dify https://langgenius.github.io/dify-helm

# 使用自定义 values.yaml 安装
helm install dify dify/dify -f values.yaml
Configurer les fournisseurs de modèles
Après l'installation, la première étape consiste à connecter votre modèle d'IA.
Chemin d'accès
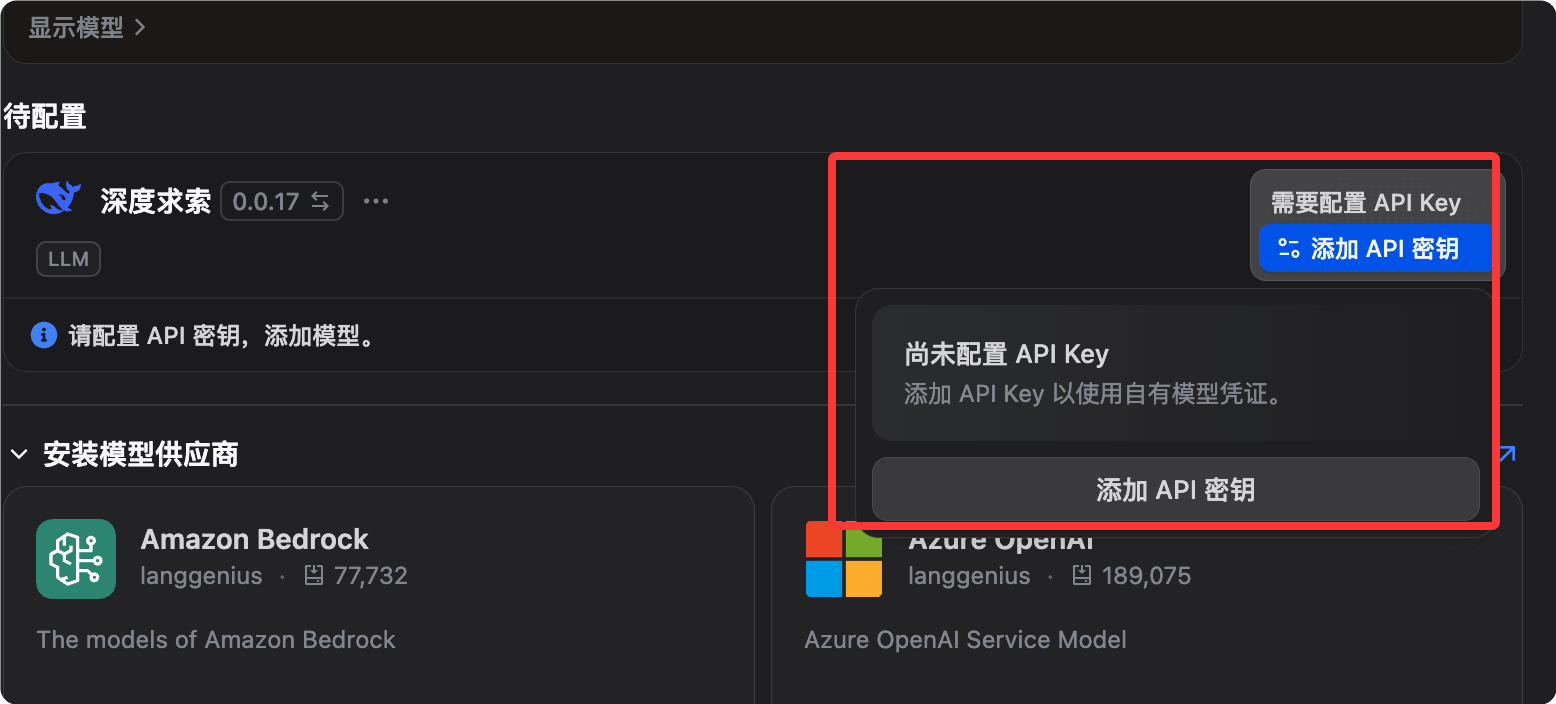
Après vous être connecté à Dify, cliquez sur l'avatar dans le coin supérieur droit, accédez à Paramètres, puis sélectionnez Fournisseur de modèles.

Par exemple, nous pouvons installer le fournisseur de modèles DeepSeek, puis configurer la clé API :
Configuration des fournisseurs courants
Anthropic (série Claude) :
Provider: Anthropic
API Key: sk-ant-xxxxxxxx(从 console.anthropic.com 获取)
推荐模型:claude-sonnet-4-6(综合性能最佳)
OpenAI:
Provider: OpenAI
API Key: sk-xxxxxxxx(从 platform.openai.com 获取)
推荐模型:gpt-4o(性价比高)
Google (série Gemini):
Provider: Google
API Key: xxxxxxxx(从 aistudio.google.com 获取)
推荐模型:gemini-2.0-flash(速度快,适合大量请求)
OpenRouter (une clé pour accéder à 300+ modèles):
Provider: OpenRouter
API Key: sk-or-xxxxxxxx(从 openrouter.ai 获取)
Base URL: https://openrouter.ai/api/v1
Modèle local (Ollama):
Provider: Ollama
Base URL: http://host.docker.internal:11434  # Docker 内访问宿主机
(先在宿主机运行:ollama pull llama3.3)
Configurer le modèle d'embedding (requis pour la base de connaissances)
La vectorisation de la base de connaissances nécessite un modèle d'embedding. Voici les options recommandées:
| Modèle | Fonctionnalités | Scénarios applicables |
|---|---|---|
| OpenAI text-embedding-3-small | Économique et efficace | Scénarios généraux |
| Zhipu AI embedding-3 | Excellent support du chinois | Contenu principalement en chinois |
| nomic-embed-text local (Ollama) | Entièrement hors ligne | Exigences élevées en matière de sécurité des données |
Vérifier la disponibilité du modèle
Revenez dans Paramètres, trouvez le fournisseur configuré, cliquez sur le bouton Test à côté du nom du modèle. Une coche verte indique que la configuration a réussi.
Explication détaillée des cinq types d'applications
Sur la page d'accueil de Dify, cliquez sur Créer une application. Vous verrez cinq types, chacun correspondant à différents scénarios d'utilisation.
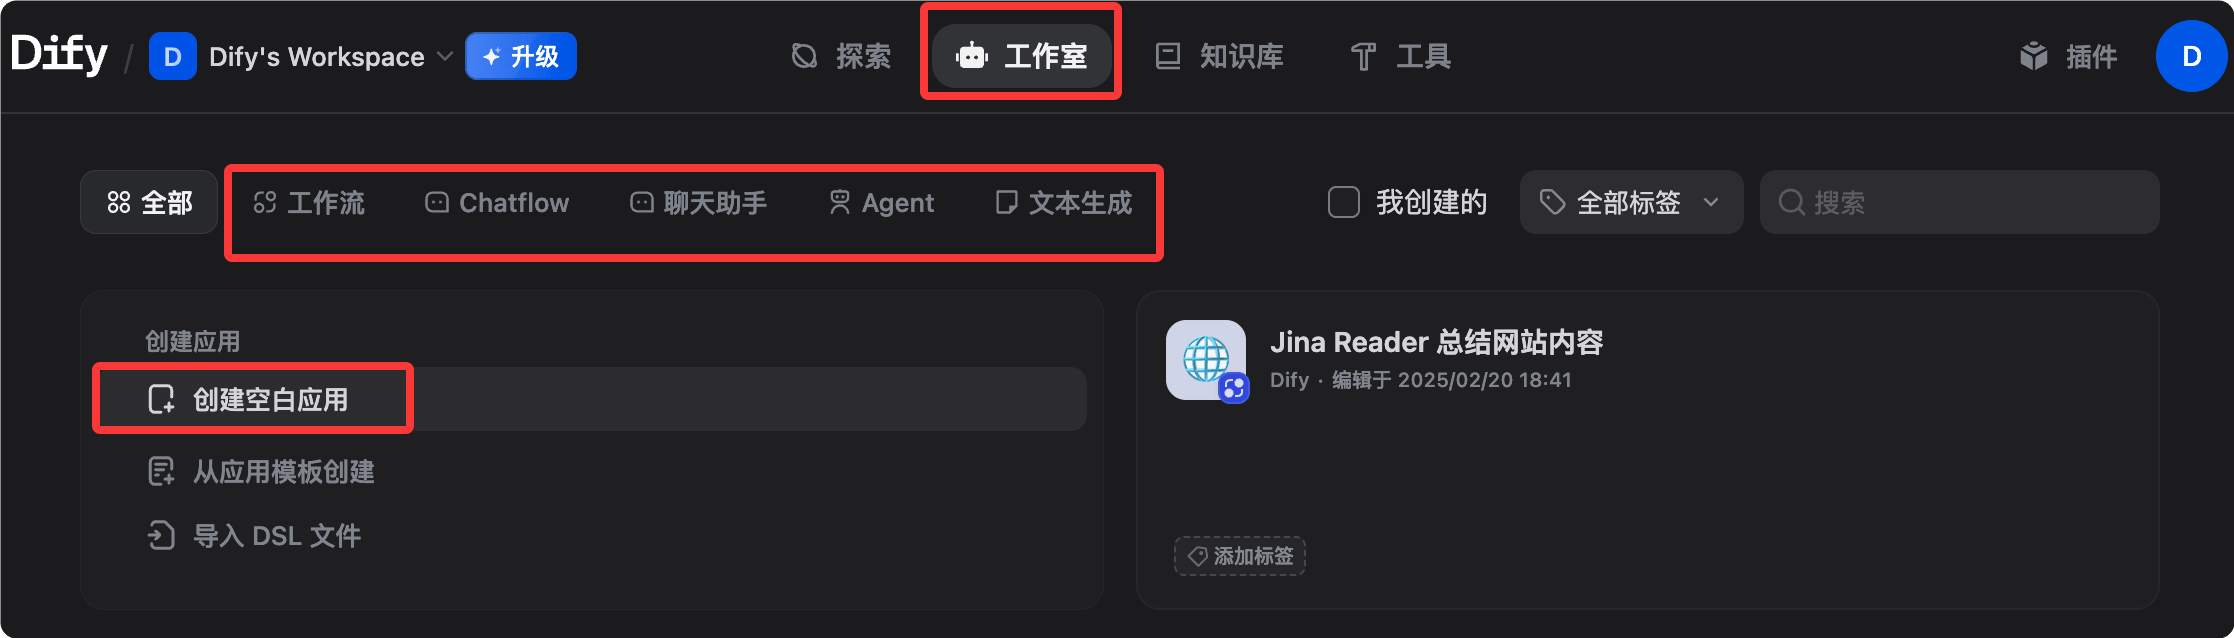
Cliquez pour créer une application vierge, et vous pouvez voir cinq types d'applications :

1. Chatbot (Assistant conversationnel)
Une application standard de conversation multi-tours avec mémoire de session persistante.
| Attribut | Description |
|---|---|
| Scénarios adaptés | Bots de service client, assistants personnels, FAQ et questions-réponses |
| Fonctionnalités principales | Mémoire de conversation intégrée (stratégie de mémoire configurable), base de connaissances associable (activer RAG), prise en charge de la sortie en streaming, publication en un clic en tant que code d'intégration web. |
2. Générateur de texte
Une seule entrée pour une seule sortie, aucun historique de conversation conservé.
| Attribut | Description |
|---|---|
| Scénarios adaptés | Réécriture d'articles, génération de résumés, rédaction SEO, rédaction d'e-mails |
| Fonctionnalités principales | Structure claire (formulaire de saisie + texte de sortie), adaptée au traitement par lots, prend en charge les espaces réservés de variables (par ex., {{product_name}}) |
3. Agent
Une IA capable d'appeler proactivement des outils, de planifier et d'exécuter de manière autonome des tâches à plusieurs étapes.
| Attribut | Description |
|---|---|
| Scénarios adaptés | Requête et analyse de données, recherche et synthèse, exécution de code |
| Fonctionnalités principales | Prend en charge deux modes de raisonnement : Function Calling et ReAct ; plus de 50 outils intégrés (recherche, génération d'images, interpréteur de code, etc.) ; prend en charge les outils API personnalisés ; le processus d'appel des outils est visible par les utilisateurs |
4. Chatflow (flux de conversation)
Ajoute des capacités de conversation multi-tours au-dessus de Workflow, en combinant l'orchestration des processus et le contexte conversationnel.
| Attribut | Description |
|---|---|
| Scénarios adaptés | Processus de service client complexes, chatbots nécessitant une prise de décision en plusieurs étapes |
| Fonctionnalités principales | À la fois les capacités d'orchestration de nœuds de Workflow et la mémoire de conversation multi-tours, permettant de déclencher des processus automatisés au sein de la conversation |
5. Workflow
Un flux de traitement multi-étapes purement automatisé, sans interface conversationnelle, déclenché via API ou exécuté manuellement.
| Attribut | Description |
|---|---|
| Scénarios adaptés | Traitement de données par lots, tâches automatisées planifiées, pipelines de traitement IA en arrière-plan |
| Fonctionnalités principales | Construisez et testez des workflows IA sur un canevas visuel ; prend en charge les branches parallèles, les boucles et la logique conditionnelle ; prend en charge le Human-in-the-Loop (nœud Human Input) ; les résultats de sortie peuvent être intégrés à d'autres systèmes |
Guide de sélection
Décidez rapidement quel type d'application utiliser en fonction de vos besoins :
需要多轮对话?
├─ 是 → 需要复杂流程逻辑?
│        ├─ 是 → Chatflow
│        └─ 否 → Chatbot ou  Agent(需要工具调用时选 Agent)
└─ 否 → 单次输入输出?
          ├─ 是 → Text Generator
          └─ 需要多步骤自动化 → Workflow
Base de connaissances (RAG) : Laissez l'IA répondre avec vos données privées
La base de connaissances est l'une des fonctionnalités les plus puissantes de Dify et le cœur de la plupart des applications d'entreprise.
Créer une base de connaissances
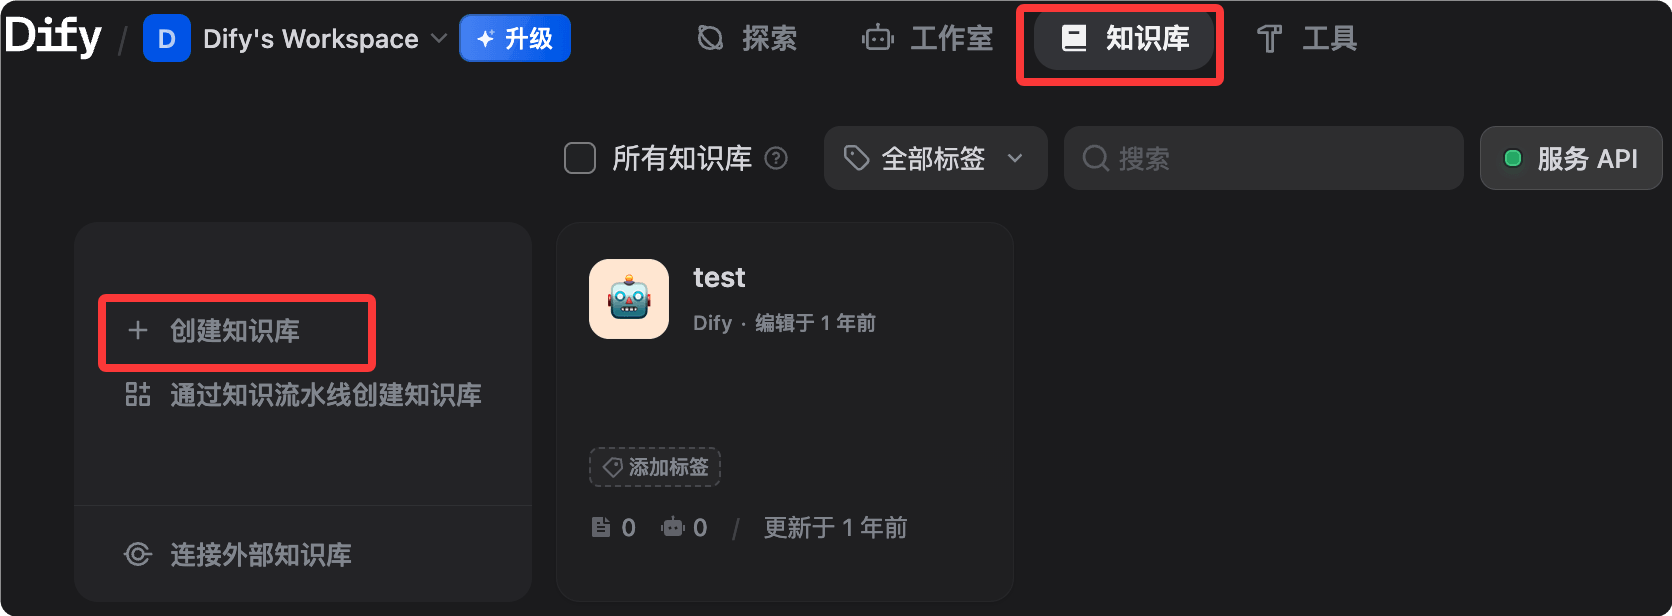
- Dans la barre de navigation, sélectionnez Knowledge (base de connaissances), puis cliquez sur Create Knowledge (créer une base de connaissances).
- Nommez la base de connaissances, par exemple « Manuel produit » ou « Documents de politique interne »
- Choisissez une méthode de création
Méthode 1 : Téléverser des fichiers (la plus courante)
Dify accepte les fichiers aux formats PDF, Word (.docx), Markdown (.md), texte brut (.txt), CSV et HTML.
Le Markdown ou le texte brut est recommandé, car ce sont les formats les plus fiables à analyser.
Les PDF avec des mises en page complexes ou des versions numérisées peuvent nécessiter un prétraitement ; il est recommandé d'utiliser des outils OCR pour extraire le texte avant de les téléverser.
Méthode 2 : Knowledge Pipeline (niveau entreprise)
Knowledge Pipeline est un système d'orchestration visuel basé sur des nœuds, spécialement conçu pour l'ingestion et le traitement de documents.
Il répond à trois problèmes majeurs du RAG traditionnel : des sources de données dispersées, une perte d'informations lors de l'analyse (les graphiques et les formules étant écartés), et un traitement en boîte noire (rendant difficile le diagnostic des causes de défaillance).
Méthode 3 : API de base de connaissances externe
Synchronisez des bases de connaissances externes existantes via API sans avoir besoin de migration de données.
Stratégie de segmentation des documents
Après le téléversement, Dify effectue automatiquement la segmentation du texte. Les paramètres clés sont expliqués ci-dessous :
| Paramètre | Description | valeur recommandée |
|---|---|---|
| Taille de segment | Nombre de tokens par segment | 500-1000 (chinois) |
| Chevauchement de segment | Nombre de tokens en chevauchement entre segments adjacents | 50-100 |
| Délimiteurs | Découper par (paragraphe/phrase) | Paragraphe |
Pour le contenu en chinois, il est recommandé de définir la taille de segment à environ 500 tokens. Une taille trop grande rend la récupération moins précise ; une taille trop courte fait perdre le contexte.
Modes d'indexation
| Mode | Description | coût |
|---|---|---|
| Haute qualité (par défaut) | L'utilisation d'un modèle Embedding pour générer des vecteurs donne les meilleurs résultats | Consomme l'API Embedding |
| Mode économique | Index inversé (correspondance par mots-clés), aucun Embedding requis | Gratuit |
Configuration de la récupération
Accédez à la base de connaissances, sélectionnez Paramètres, puis configurez les paramètres de récupération :
| Méthode de récupération | Description | Scénarios applicables |
|---|---|---|
| Récupération vectorielle | Correspondance par similarité sémantique | Requêtes relatives au sens |
| Récupération de texte intégral | Correspondance de mots-clés. | Requête de terme exact |
| Récupération hybride (recommandée) | Combiner les deux et utiliser un modèle de reranking pour améliorer la précision | Scénarios généraux |
Il est recommandé de définir le seuil de similarité à 0.5-0.7.
Si le seuil de similarité est trop élevé, aucun résultat ne sera renvoyé ; s'il est trop bas, du contenu non pertinent sera renvoyé. Il est recommandé de commencer les tests à 0.6 et d'affiner en fonction des résultats.
Tester les résultats de récupération
Dans la base de connaissances, cliquez sur Test de récupération, saisissez une question de test et affichez directement les Chunks renvoyés pour vérifier la qualité de la récupération sans réellement démarrer une conversation.
Associer la base de connaissances à une application
Sur la page de modification de l'application, sélectionnez Contexte, cliquez sur Ajouter, choisissez la base de connaissances créée, puis enregistrez.
Une fois liée, chaque conversation dans l'application effectuera d'abord une recherche dans la base de connaissances avant de répondre.
Workflow : orchestrer visuellement des tâches à plusieurs étapes
Définissez une logique de traitement IA à plusieurs étapes en faisant glisser des nœuds et en les connectant.
Accéder à l'éditeur de Workflow
Sélectionnez Workflow lors de la création d'une application, ou cliquez sur Modifier dans une application Workflow existante pour accéder au canevas.

Principaux types de nœuds
Voici les nœuds les plus couramment utilisés dans l'éditeur de Workflow et leurs fonctions :
| Nœud | Fonction | Cas d'utilisation typique |
|---|---|---|
| Début | Entrée du processus, définit les variables d'entrée | Reçoit les entrées de l'utilisateur ou les paramètres externes |
| LLM | Appeler le modèle de langage | Génération de texte, analyse, traduction |
| Récupération de connaissances | Récupérer depuis la base de connaissances | Scénarios RAG |
| IF/ELSE | Branche conditionnelle | Achemine différents chemins de traitement en fonction du contenu |
| Code | Exécuter du code Python ou JS | Transformation de données, traitement de format, calculs |
| Requête HTTP | Appeler une API externe | Interroger la base de données, envoyer des notifications |
| Modèle | Rendu de modèle de variable | Combiner les sorties de plusieurs nœuds |
| Assignateur de variables | Définir/Mettre à jour des variables | Transmettre des données entre les nœuds |
| Itération | Parcourir les listes | Traiter par lots plusieurs éléments de données |
| Agent | Nœud d'agent intégré | Donne à une étape du flux de travail une capacité de raisonnement autonome |
| Saisie humaine | Met en pause et attend une revue humaine | Point de décision clé pour la collaboration homme-machine |
| Fin | Sortie du processus, définit la sortie | Renvoie le résultat final |

Passage de variables entre les nœuds
La sortie de chaque nœud peut être référencée par les nœuds suivants à l'aide de la syntaxe {{node_name.output_variable_name}}.
Voici un exemple de passage de variables dans un flux de travail RAG de questions-réponses typique :
Start 节点输出 user_query
  ↓
Knowledge Retrieval 节点:
  输入:{{Start.user_query}}
  输出:result(检索结果)
  ↓
LLM 节点:
  System Prompt:你是一个客服助理,根据以下资料回答问题
  User:用户问题:{{Start.user_query}}
        参考资料:{{Knowledge Retrieval.result}}
  ↓
End 节点:
  返回:{{LLM.text}}
Nœud de saisie humaine (HITL)
Le nœud Human Input est une mise à jour majeure qui permet aux workflows de suspendre l'exécution à des points de décision clés.
Ce nœud génère une interface UI pour la revue humaine et la modification de variables (par ex., éditer des brouillons ou corriger des données), puis détermine le chemin suivant en fonction de boutons personnalisés (tels que « Approuver », « Rejeter » ou « Escalader »).
Cela résout le dilemme binaire des workflows précédents — « soit entièrement automatisé, soit entièrement manuel » — permettant aux scénarios à haut risque (revue de contrat, conseil médical, décisions financières) de bénéficier également de l'IA automatisée.
Débogage du workflow
Cliquez sur Run (Run) dans le coin supérieur droit du canevas, saisissez les paramètres de test et observez l'entrée/sortie et la latence de chaque nœud.
Des indicateurs verts (succès) ou rouges (échec) apparaissent à côté des nœuds ; cliquez pour afficher les journaux d'exécution détaillés.
Scénario pratique 1 : Bot de questions-réponses sur les connaissances internes de l'entreprise
Utilisez Dify pour construire un chatbot capable de répondre avec précision aux questions sur des documents internes, avec des citations de sources dans les réponses.
Contexte métier
L'entreprise possède un grand nombre de documents internes (politiques RH, manuels produits, Wiki technique). Les employés doivent souvent trouver des informations, mais les documents sont dispersés et difficiles à rechercher.
Étape 1 : Préparer la base de connaissances
- Organisez les documents : exportez les politiques RH (PDF), les manuels produits (Word) et le Wiki technique (Markdown) pour utilisation.
- Sous Connaissances, sélectionnez Créer une connaissance et nommez-la « Company Internal Knowledge Base ».
- Téléversez des fichiers et sélectionnez le mode d'indexation de haute qualité.
- Attendez que la vectorisation soit terminée (indiquée par la barre de progression).
Conseils d'optimisation de la qualité des documents : supprimez les informations non pertinentes, les en-têtes/pieds de page et les caractères spéciaux. Utilisez des titres clairs et des paragraphes courts. Si un document couvre plusieurs sujets différents, envisagez de le diviser en fichiers séparés.
Étape 2 : Créer une application Chatbot
- Cliquez sur Créer une application, sélectionnez Chatbot, et nommez-la « Internal Assistant ».
- Choisissez un modèle (Claude Sonnet 4.6 ou GPT-4o recommandé).
- Rédigez le prompt système.

You are an internal company knowledge assistant, specifically helping employees find information in internal documents.

Code of conduct:
- Only answer based on the provided knowledge base content; do not fabricate information
- Cite the source document name when answering
- If the relevant information is not found in the knowledge base, directly say "I did not find the relevant information in the documents" and suggest contacting the corresponding department
- Use concise, professional language
- Do not discuss topics other than company confidential matters
- Dans Contexte, cliquez sur Ajouter et sélectionnez « Company Internal Knowledge Base ».
- Configurez les paramètres de récupération : récupération hybride, seuil de similarité 0.6, renvoyer le Top 5 des segments.
Étape 3 : Tests et ajustements
Testez avec de vraies questions. Voici des cas de test recommandés :
测试问题示例:
"年假怎么申请?" → 应该从 HR 政策文档返回正确步骤
"产品 A 的定价是多少?" → 应该从产品手册返回准确价格
"如何配置 VPN?" → 应该从技术 Wiki 返回步骤
"CEO 是谁?" → 如果文档中没有,应该诚实说不知道
Opérations de réglage courantes
| Problème | Solution |
|---|---|
| Réponses inexactes | Abaissez le seuil de similarité (p. ex., 0.5) et augmentez le nombre de segments retournés. |
| Réponses non pertinentes | Augmentez le seuil (p. ex., 0.7) et vérifiez si le découpage des documents est raisonnable. |
| Réponses incomplètes | Augmentez la taille des segments afin que chaque segment contienne des paragraphes plus complets. |
Étape 4 : Publier et intégrer
Publier en tant qu'application web : Sur la page de l'application, sélectionnez Aperçu, cliquez sur Intégré, copiez le code d'intégration, puis collez-le dans un Wiki interne ou une page intranet.
Publier en tant qu'API : Sur la page de l'application, sélectionnez Référence API, copiez la clé API, et appelez l'exemple :
# 调用聊天 API,向知识问答机器人发送问题
curl -X POST 'https://api.dify.ai/v1/chat-messages' \
  -H 'Authorization: Bearer app-xxxxxxxx' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {},
    "query": "年假怎么申请?",
    "response_mode": "blocking",
    "user": "employee-001"
  }'
Scénario pratique 2 : Pipeline automatisé de génération de contenu
Utilisez Workflow pour générer du contenu marketing pour différents canaux en parallèle.
Contexte métier
L'équipe marketing doit convertir par lots des journaux de mise à jour produit (langage technique) en contenu pour différents canaux : publications sur le compte public WeChat, blogs techniques et scripts de vidéos courtes.
Conception du Workflow
Start(输入:更新日志文本)
  ↓ 并行分支
  ├─→ LLM-1:生成微信推文(轻松活泼,500字,含表情符号)
  ├─→ LLM-2:生成技术博客(专业详细,1500字,含代码示例)
  └─→ LLM-3:生成短视频脚本(口语化,300字,分镜头格式)
  ↓ 合并
End(输出:三份内容)
Étapes de construction concrètes
Étape 1 : Créez une application Workflow et nommez-la « Content Generation Pipeline ».
Étape 2 : Configurez le nœud Start et ajoutez des variables d'entrée :
| Nom de la variable | Type | Description |
|---|---|---|
| update_content | Type Texte | Journal de mise à jour du produit original |
| product_name | Type Texte | Nom du produit |
| version | Type Texte | Numéro de version |
Étape 3 : Ajouter trois nœuds LLM (en parallèle).
Connectez les trois nœuds LLM au nœud Start, et Dify les exécutera automatiquement en parallèle.
Exemple de prompt pour LLM-1 (publication WeChat) :
你是一位擅长社交媒体写作的内容创作者。

请将以下 {{product_name}} v{{version}} 的更新日志改写成微信公众号推文:
- 字数:400-600字
- 语气:轻松活泼,贴近用户
- 结构:开头吸引眼球,中间介绍亮点,结尾引导互动
- 适当使用 emoji
- 不要使用技术术语,用用户能理解的语言

更新日志原文:
{{Start.update_content}}
LLM-2 (blog technique) et LLM-3 (script de vidéo courte) sont configurés de la même manière ; ajustez simplement le prompt et le modèle.
Étape 4 : Ajouter un nœud End et configurer les variables de sortie :
wechat_post:引用 {{LLM-1.text}}
tech_blog:引用 {{LLM-2.text}}
video_script:引用 {{LLM-3.text}}
Étape 5 : Intégrer aux outils internes via l'API.
Exemple
def generate_content(update_content: str, product_name: str, version: str):
"""Appeler l'API Dify Workflow pour générer par lots du contenu multi-version"""
# URL de l'API : Remplacez api.dify.ai par le domaine de votre instance Dify
url = "https://api.dify.ai/v1/workflows/run"
# En-têtes de requête : Remplacez par la clé API de votre application
headers = {
"Authorization": "Bearer app-xxxxxxxx", # Requis : clé API de l'application
"Content-Type": "application/json"
}
# Corps de la requête : Passez les trois variables d'entrée définies dans le nœud Start
payload = {
"inputs": {
"update_content": update_content, # Journal de mise à jour d'origine
"product_name": product_name, # Nom du produit
"version": version # Numéro de version
},
"response_mode": "blocking", # Mode bloquant, attendre le résultat complet
"user": "content-team" # Identifiant utilisateur, utilisé pour le suivi des logs
}
response = requests.post(url, headers=headers, json=payload)
# Extraire le champ outputs de la réponse, contenant les résultats de génération des trois nœuds LLM
return response.json()["data"]["outputs"]
Scénario pratique 3 : Agent de support client (avec un humain dans la boucle)
Construisez un système intelligent de traitement des tickets de service client : l'IA traite automatiquement les problèmes standard, et les problèmes complexes sont acheminés vers des agents humains avec une pré-analyse.
Contexte métier
Une plateforme de commerce électronique reçoit en moyenne 500+ tickets de service client par jour ; la plupart sont des questions standard (demandes logistiques, politiques de retour), mais environ 20% nécessitent un traitement manuel (réclamations complexes, remboursements importants).
Conception du Workflow
Start(接收用户工单:问题类型 + 内容 + 订单号)
  ↓
LLM-分类:判断问题类型(standard / complex)
  ↓
IF/ELSE:问题类型是否为 standard?
  ├─ standard →
  │    Knowledge Retrieval(从客服知识库检索)
  │      ↓
  │    LLM-回复:生成标准回答
  │      ↓
  │    End(直接回复用户)
  │
  └─ complex →
       LLM-预分析:生成问题摘要和建议处理方案
         ↓
       Human Input(人工审核,可编辑 AI 建议,选择"批准"/"修改"/"升级")
         ↓
       End(发送经过人工确认的回复)
Configuration des nœuds clés
Nœud LLM de classification (produit du JSON structuré) :
Exemple
"system": "Vous êtes un expert en classification de tickets de service client. Veuillez analyser le ticket suivant et produire le résultat de classification au format JSON.",
"output_schema": {
"category": "standard ou complexe",
"reason": "Raison de la classification (une phrase)",
"priority": "faible / moyenne / élevée"
},
"criteria": {
"standard": Demande logistique, politique de retour, remboursement normal (<500 yuan), problèmes de compte,
"complex": Remboursement important (>500 yuan), réclamations, litiges, problèmes de qualité produit
}
}
Configuration du nœud Human Input :
| Élément de configuration | Description |
|---|---|
| Contenu affiché | Résultats de la pré-analyse IA + brouillon de réponse suggéré |
| Champs modifiables. | Contenu de la réponse, priorité |
| Boutons personnalisés. | Approuver (répondre selon la suggestion de l’IA), Approuver avec modifications (répondre après une édition manuelle), Escalader (transférer vers une équipe de traitement spécialisée) |
Résultats attendus
| Type de ticket | Méthode de traitement | Amélioration de l’efficacité |
|---|---|---|
| Questions standard (environ 80%) | Traitement entièrement automatisé par l’IA | Temps de réponse réduit de 4 heures à 30 secondes |
| Questions complexes (environ 20%) | L’IA assiste les humains en fournissant des analyses et des brouillons | Temps de traitement manuel réduit de 60% |
| global | - | Efficacité de traitement des tickets améliorée d'environ 3x |
Publication externe : API, intégration Web et serveur MCP
La publication d'applications Dify vers des systèmes externes prend en charge trois méthodes : appels API, intégration web et serveurs MCP.
Publier en tant qu'API
Chaque application Dify dispose automatiquement d'une API REST. Accédez à la page de l'application et sélectionnez API Access pour l'obtenir.
Exemple d'appel API d'application de chat :
# 调用聊天 API(流式返回模式)
curl -X POST 'https://api.dify.ai/v1/chat-messages' \
  -H 'Authorization: Bearer {API_KEY}' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {},
    "query": "你好",
    "response_mode": "streaming",
    "conversation_id": "",
    "user": "user-001"
  }'
Exemple d'appel API d'application Workflow :
# 调用 Workflow API(阻塞模式)
curl -X POST 'https://api.dify.ai/v1/workflows/run' \
  -H 'Authorization: Bearer {API_KEY}' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {"your_variable": "your_value"},
    "response_mode": "blocking",
    "user": "user-001"
  }'
Le format de la clé API commence par app-. Assurez-vous de la transmettre dans l'en-tête de requête sous la forme Authorization: Bearer, et non comme paramètre de requête. Chaque clé API correspond à une seule application spécifique, et les clés des différentes applications ne sont pas interchangeables.
Intégration dans une page web
Sur la page de l'application, sélectionnez Overview, cliquez sur Embedded, et trois méthodes d'intégration sont proposées :
Méthode 1 : intégration par iframe
Exemple
<iframe
src="https://udify.app/chatbot/xxxxxxxx"
style="width: 100%; height: 100%; min-height: 700px"
frameborder="0"
allow="microphone">
</iframe>
Méthode 2 : Bouton bulle (flottant dans le coin inférieur droit de la page web)
Exemple
<script>
window.difyChatbotConfig = { token: 'xxxxxxxx' }
</script>
<script
src="https://udify.app/embed.min.js"
id="xxxxxxxx"
defer>
</script>
Méthode 3 : Page web plein écran, consultée indépendamment, partagez directement le lien : https://udify.app/chat/xxxxxxxx.
Publier en tant que serveur MCP
Dify prend en charge la publication de workflows ou d'agents construits en tant que serveurs MCP standards, avec prise en charge des modes de pré-autorisation et sans authentification.
Cela signifie que l'application de questions-réponses sur base de connaissances que vous créez dans Dify peut directement devenir un nœud d'outil pour les outils de programmation IA tels que Claude Code, Cursor, omp, etc., intégré de manière transparente au flux de travail de développement.
Chemin d'opération : Dans l'application, sélectionnez Publier et cliquez sur MCP Server.
Observabilité : surveillance et optimisation en continu
Surveillez et optimisez en continu les performances des applications d'IA grâce aux journaux, aux annotations, aux statistiques et à l'intégration de plateformes externes.
Consulter les journaux de l'application
Dans la page de l'application, sélectionnez Logs pour afficher l'entrée/sortie complète de chaque conversation, l'utilisation des tokens (entrée et sortie comptées séparément), le temps de réponse, le modèle et les informations sur les paramètres.
Annoter les conversations
Dans les journaux, cliquez sur une conversation spécifique, puis cliquez sur le bouton J'aime ou Je n'aime pas à côté de la réponse pour ajouter une réponse idéale en tant qu'annotation.
Les utilisations des données d'annotation incluent : la création d'ensembles de données de fine-tuning à partir d'annotations, l'identification des lacunes de couverture dans la base de connaissances et la découverte des types d'erreurs fréquentes.
Statistiques des données de l'application
Dans la page de l'application, sélectionnez Vue d'ensemble et cliquez sur Analyses pour afficher :
| Élément statistique | Description |
|---|---|
| Tendance du nombre de conversations | Variations du volume de conversations quotidiennes/hebdomadaires/mensuelles |
| Consommation moyenne de tokens | Utilisation moyenne de tokens par conversation |
| Note de satisfaction des utilisateurs | Statistiques de répartition des J'aime/Je n'aime pas |
| Nombre d'utilisateurs actifs | Nombre d'utilisateurs uniques utilisant l'application |
Intégrer des plateformes d'observabilité externes
Dify prend en charge des plateformes d'observabilité telles que Opik, Langfuse et Arize Phoenix.
En prenant Langfuse comme exemple : dans Paramètres, sélectionnez Surveillance, choisissez Langfuse, saisissez la clé publique et la clé secrète, puis enregistrez. Ensuite, la chaîne d'appels de toutes les applications sera automatiquement synchronisée avec Langfuse, où vous pourrez consulter le traçage complet des spans et les détails des coûts en tokens.
Boucle d'optimisation continue
Il est recommandé d'établir le processus d'optimisation continue suivant :
部署上线
  ↓
收集对话日志(1-2 周)
  ↓
分析差评对话:哪些问题回答得不好?
  ↓
改进知识库(补充文档、调整分块)或优化 Prompt
  ↓
A/B 测试:对比改进前后的效果
  ↓
再次部署
Tarification et forfaits.
Comprenez les structures de coûts de Dify Cloud et de l'auto-hébergement, et choisissez l'option qui vous convient le mieux.
Forfait Dify Cloud
| Forfait | Frais mensuels | Description |
|---|---|---|
| Bac à sable | Gratuit | 200 messages/mois, 5 applications, adapté aux scénarios d'essai |
| Professionnel | $59/mois | 5,000 messages/mois, 50 applications, prend en charge la collaboration d'équipe |
| Équipe | $159/mois | 10,000 messages/mois, applications illimitées, support prioritaire |
| Entreprise | Personnalisé | Utilisation illimitée, option de déploiement privé, garantie SLA |
Coûts d'auto-hébergement.
L'édition Communautaire auto-hébergée est entièrement gratuite, sans restrictions d'utilisation.
Vous ne payez que l'hébergement du serveur (un VPS coûte environ $5-50/mois) et les frais d'appels API pour les modèles d'IA.
Estimation des coûts (auto-hébergé, 10,000 conversations/mois):
| Composant | Coût estimé |
|---|---|
| VPS (4 cœurs, 8 GB) | 20-40 $/mois |
| Claude Sonnet 4.6 (environ 1K tokens par conversation) | ~30 $/mois |
| Embedding(text-embedding-3-small) | ~2 $/mois |
| Total | ~52-72 $/mois |
Comparé à Dify Cloud Professional (59 $/mois, plus les frais d'API du modèle), l'auto-hébergement est généralement plus économique pour une utilisation intensive.
Conseils pour réduire les coûts
| Astuce | Description |
|---|---|
| Indexer les bases de connaissances en mode économique | Si la recherche par mots-clés existante suffit, pas besoin de vectoriser |
| Choisir le modèle approprié | Utilisez GPT-4o-mini ou Gemini Flash pour les questions-réponses simples, et des modèles phares pour les tâches complexes |
| Définir une limite de tokens | Définissez max_tokens dans le nœud LLM pour éviter les appels uniques excessivement longs |
| Activer la mise en cache | Les questions similaires réutilisent automatiquement la réponse précédente (Prompt Cache) |
Problèmes courants et dépannage
Couvre les méthodes de dépannage pour quatre grandes catégories de problèmes courants : le démarrage, la récupération dans la base de connaissances, les appels API et les workflows.
Problème de démarrage
Problème : services en mauvaise santé après docker compose up -d
Exemple
docker compose logs api
# Afficher les journaux du conteneur worker
docker compose logs worker
# Vérifier si la mémoire est suffisante (au moins 4 GB requis)
free -h
# Vérifier si le port est occupé (80 ou 443)
sudo lsof -i :80
Problème : l'accès à http://localhost affiche 502 Bad Gateway
Exemple
docker compose ps
Après avoir confirmé que api, web et worker sont tous opérationnels, accédez à nouveau.
Problèmes de récupération de la base de connaissances
Question : Le contenu pertinent est introuvable dans la base de connaissances.
Étapes de dépannage :
- Dans la base de connaissances, cliquez sur Test de récupération, testez des questions spécifiques et confirmez si elles peuvent être récupérées.
- Si rien n'est récupéré : abaissez le seuil de similarité (de 0.6 à 0.3) et testez s'il y a des résultats.
- S'il n'y a toujours aucun résultat : confirmez que la configuration du modèle Embedding est correcte et si l'index de la base de connaissances a été complété.
- S'il y a des résultats mais que le contenu est incorrect : vérifiez la stratégie de découpage des documents et envisagez de diviser manuellement les fichiers volumineux.
Problème : RAG renvoie du contenu non pertinent.
Vérifiez le contenu du Chunk récupéré. Si le Chunk n'est pas pertinent, réduisez la taille du chunk et augmentez le seuil de score. Si aucun Chunk n'est renvoyé, le seuil est peut-être défini trop haut ; abaissez-le temporairement à 0.3 et testez à nouveau. Confirmez également que la base de connaissances a été liée dans le panneau d'orchestration de l'application.
Problèmes d'appels API
Problème : l'API renvoie 401 Unauthorized
Vérifiez le format de la clé API — les clés API d'application Dify commencent par app-. Assurez-vous qu'elle est transmise dans l'en-tête de requête sous la forme Authorization: Bearer, et non comme paramètre de requête. Vérifiez également que cette clé API appartient à la bonne application — les clés sont au niveau de l'application, et les clés de différentes applications ne sont pas interchangeables.
Question : réponse en streaming tronquée à mi-chemin.
Il s'agit généralement d'un problème de délai d'attente. Vérifiez les paramètres de délai d'attente du proxy inverse — Nginx utilise par défaut 60 secondes, ce qui peut ne pas suffire pour des workflows complexes.
# nginx.conf 中增加超时配置,确保长时间运行的工作流不被中断
proxy_read_timeout 300s;
proxy_connect_timeout 300s;
proxy_send_timeout 300s;
Problèmes de workflow.
Problème : un nœud du workflow a signalé une erreur.
Étapes de dépannage :
- Ouvrez le panneau de débogage pour consulter l'entrée/sortie du nœud qui a signalé l'erreur.
- Cliquez sur le marqueur rouge à côté du nœud pour afficher les informations détaillées sur l'erreur.
- Cause fréquente : chemin de référence de variable incorrect (vérifiez l'orthographe de {{node name.variable name}})
Ressources
Parcours d'apprentissage recommandés et ressources associées pour vous aider à passer du niveau débutant à la maîtrise.
Parcours d'apprentissage recommandé
注册 Dify Cloud,用 Sandbox 体验
    ↓
配置自己的模型提供商(Anthropic ou  OpenAI)
    ↓
创建第一个知识库,上传 5-10 个文档,测试检索效果
    ↓
创建 Chatbot 应用,关联知识库,完成场景实战一
    ↓
学习 Workflow,完成场景实战二(内容生成流水线)
    ↓
探索 Human Input 节点,完成场景实战三(客服 Agent)
    ↓
用 Docker Compose 搭建本地/服务器自托管版本
    ↓
通过 API 将 Dify 应用集成到现有系统
    ↓
探索 MCP Server 发布,接入 AI 编程工具生态
Ressources officielles
| ressources | Lien | explication |
|---|---|---|
| Site officiel | dify.ai | Informations produit et entrée d'inscription |
| Document | docs.dify.ai | Documentation complète d'utilisation du produit |
| GitHub | github.com/langgenius/dify | Open source Apache 2.0, vous pouvez consulter le code source et soumettre des Issues |
| Communauté Discord | discord.gg/FngNHpbcY7 | Communiquez avec les membres de la communauté et l’équipe officielle |
| Place de marché des modèles | Modèles intégrés à l’application | Utilisez directement les modèles de workflow partagés par la communauté |
| Blog Dify | dify.ai/blog | Mises à jour des fonctionnalités et cas d’utilisation |
| FAQ de la base de connaissances | docs.dify.ai/faq | Réponses officielles aux questions fréquentes |