Problemas derivados de algoritmos de ordenación
Cuando dominamos algoritmos de ordenación básicos como la ordenación de burbuja y la ordenación rápida, descubrimos que ordenar no es simplemente ordenar los datos.
En la programación real y en las entrevistas, muchos problemas son variantes o problemas derivados de los algoritmos de ordenación.
Comprender estos problemas derivados nos ayuda a dominar más profundamente la esencia de los algoritmos de ordenación y a mejorar nuestra capacidad para resolver problemas complejos.
Este artículo explorará varios problemas derivados clásicos de algoritmos de ordenación, analizando sus ideas centrales, soluciones y aplicaciones prácticas, para ayudarte a desarrollar un pensamiento algorítmico más sistemático.
¿Qué son los problemas derivados de algoritmos de ordenación?
Los problemas derivados de algoritmos de ordenación se refieren a aquellosque no requieren ordenar directamente,pero cuya idea central, flujo de algoritmo o estructura de datos para resolver el problema estánaltamente relacionadoscon los algoritmos de ordenación clásicos.
Este tipo de problemas suele tener las siguientes características:
- Objetivo diferente: el propósito final no es generar una secuencia ordenada
- Ideas comunes: utiliza ideas centrales de la ordenación como comparación, intercambio y divide y vencerás
- Complejidad relacionada: la complejidad temporal suele estar en el mismo orden que la de los algoritmos de ordenación
- Amplia aplicación: se encuentra frecuentemente en el desarrollo real
A continuación, profundizaremos mediante varios problemas concretos.
Clásico problema derivado 1: problema Top K
Definición del problema
Encontrar entre n elementoslos K elementos más grandes (o más pequeños).。
Escenarios de aplicación práctica:
- Sitios de comercio electrónico: encontrar los 10 productos más vendidos
- Redes sociales: encontrar los 100 usuarios con más seguidores
- Análisis de datos: encontrar las 5 páginas con más visitas
Comparación de soluciones
| Método | Complejidad temporal | Complejidad espacial | Escenario aplicable |
|---|---|---|---|
| Ordenar directamente y tomar los primeros K | O(n log n) | O(1) o O(n) | Cuando K está cerca de n |
| Ordenación de burbuja K veces | O(n × K) | O(1) | K es muy pequeño (K < 10) |
| Montículo mínimo/montículo máximo | O(n log K) | O(K) | El más utilizado, K es mucho menor que n |
| Algoritmo de selección rápida | O(n) promedio, O(n²) en el peor caso | O(1) | No necesita estar completamente ordenado, solo necesita Top K |
Método 1: selección rápida basada en la idea de ordenación rápida
El algoritmo de selección rápida es una variante de la ordenación rápida. No necesita ordenar completamente todo el array, solo necesita encontrar la posición del K-ésimo elemento más grande.
Ejemplo
"""
Encontrar el k-ésimo elemento más pequeño usando el algoritmo de selección rápida
nums: array de entrada
k: el k-ésimo elemento más pequeño a buscar (basado en 1)
Retorna: el valor del k-ésimo elemento más pequeño
"""
def partition(left, right, pivot_idx):
"""Función de partición: divide el array en dos partes, menor y mayor que el pivote."""
pivot = nums[pivot_idx]
# Mover el pivote al final
nums[pivot_idx], nums[right] = nums[right], nums[pivot_idx]
store_idx = left
for i in range(left, right):
if nums[i] < pivot:
nums[store_idx], nums[i] = nums[i], nums[store_idx]
store_idx += 1
# Mover el pivote a la posición correcta
nums[right], nums[store_idx] = nums[store_idx], nums[right]
return store_idx
def select(left, right, k_smallest):
"""Función principal de selección"""
if left == right:
return nums[left]
# Seleccionar pivote aleatorio
pivot_idx = left + (right - left) // 2
# Particionar y obtener la posición final del pivote
pivot_idx = partition(left, right, pivot_idx)
# El pivote es exactamente el k-ésimo elemento más pequeño
if k_smallest == pivot_idx:
return nums[k_smallest]
# El k-ésimo elemento más pequeño está en la mitad izquierda
elif k_smallest < pivot_idx:
return select(left, pivot_idx - 1, k_smallest)
# El k-ésimo elemento más pequeño está en la mitad derecha
else:
return select(pivot_idx + 1, right, k_smallest)
# k-1 porque internamente se usa índice basado en 0
return select(0, len(nums) - 1, k - 1)
def find_top_k(nums, k, largest=True):
"""
Encontrar los k elementos más grandes
nums: array de entrada
k: número de elementos a encontrar
largest: True para encontrar los k más grandes, False para encontrar los k más pequeños
Retorna: lista de los k elementos más grandes
"""
n = len(nums)
if k >= n:
return sorted(nums, reverse=largest)
if largest:
# Encontrar los k más grandes = encontrar el (n-k+1)-ésimo más pequeño
kth_value = quick_select(nums, n - k + 1)
# Recopilar todos los elementos mayores o iguales a kth_value
result = [x for x in nums if x > kth_value]
# Si no hay suficientes, agregar elementos iguales
while len(result) < k:
result.append(kth_value)
return result
else:
# Encontrar los k más pequeños = encontrar el k-ésimo más pequeño
kth_value = quick_select(nums, k)
result = [x for x in nums if x < kth_value]
while len(result) < k:
result.append(kth_value)
return result
# Datos de prueba
test_data = [3, 2, 1, 5, 6, 4, 9, 8, 7, 0]
print("Datos originales:", test_data)
print("Los 3 elementos más grandes:", find_top_k(test_data.copy(), 3, largest=True))
print("Los 3 elementos más pequeños:", find_top_k(test_data.copy(), 3, largest=False))
Método 2: solución basada en ordenación por montículos
El montículo es una estructura de datos clásica para resolver el problema Top K, especialmente adecuada para escenarios de flujo de datos.
Ejemplo
def find_top_k_with_heap(nums, k, largest=True):
"""
Encontrar los k elementos más grandes usando un montículo
nums: array de entrada
k: número de elementos a encontrar
largest: True para encontrar los k más grandes, False para encontrar los k más pequeños
Retorna: lista de los k elementos más grandes
"""
if largest:
# Encontrar los k más grandes: usar un montículo mínimo
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, num)
elif num > heap[0]: # El elemento actual es mayor que la cima del montículo
heapq.heapreplace(heap, num)
return sorted(heap, reverse=True)
else:
# Encontrar los k más pequeños: usar un montículo máximo (implementado con negativos)
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, -num) # Almacenar negativos
elif num < -heap[0]: # El elemento actual es menor que la cima del montículo
heapq.heapreplace(heap, -num)
return sorted([-x for x in heap])
# Probar el método del montículo
print("\n"Usando el método del montículo:")
print("Los 3 elementos más grandes:", find_top_k_with_heap(test_data, 3, largest=True))
print("Los 3 elementos más pequeños:", find_top_k_with_heap(test_data, 3, largest=False))
Clásico problema derivado 2: conteo de pares invertidos
Definición del problema
En un array, si un elemento anterior es mayor que un elemento posterior, estos dos elementos forman unpar invertido. Calcula el número total de pares invertidos en el array.
Escenarios de aplicación práctica:
- Medir el grado de orden de los datos
- Análisis de preferencias de usuarios en sistemas de recomendación
- Detección de conflictos de modificaciones en sistemas de control de versiones
Solución: algoritmo basado en ordenación por mezcla
El proceso de ordenación por mezcla puede contar naturalmente el número de pares invertidos; esta es una aplicación típica de la idea de divide y vencerás.
Ejemplo
"""
Calcular el número de pares invertidos en un array
Usando el método basado en ordenación por mezcla
"""
def merge_sort_count(left, right):
"""Ordenación por mezcla y conteo de pares invertidos"""
if left >= right:
return 0, [nums[left]] if left == right else []
mid = (left + right) // 2
# Contar recursivamente los pares invertidos en las dos mitades
left_count, left_arr = merge_sort_count(left, mid)
right_count, right_arr = merge_sort_count(mid + 1, right)
# Contar los pares invertidos que cruzan el punto medio
cross_count = 0
merged = []
i = j = 0
while i < len(left_arr) and j < len(right_arr):
if left_arr[i] <= right_arr[j]:
merged.append(left_arr[i])
i += 1
else:
# left_arr[i] > right_arr[j], forman un par invertido
merged.append(right_arr[j])
cross_count += len(left_arr) - i # Clave: todos los elementos restantes de la izquierda forman pares invertidos con right_arr[j]
j += 1
# Agregar los elementos restantes
merged.extend(left_arr[i:])
merged.extend(right_arr[j:])
total_count = left_count + right_count + cross_count
return total_count, merged
if not nums:
return 0
count, _ = merge_sort_count(0, len(nums) - 1)
return count
# Probar el conteo de pares invertidos
test_cases = [
([1, 2, 3, 4, 5], 0), # Completamente ordenado, pares invertidos = 0
([5, 4, 3, 2, 1], 10), # Completamente invertido, pares invertidos = C(5,2)=10
([2, 4, 1, 3, 5], 3), # Ejemplo
([7, 5, 6, 4], 5), # Ejemplo complejo
]
print("\n"Prueba de conteo de pares invertidos:")
for nums, expected in test_cases:
result = count_inversions(nums.copy())
print(f"Array {nums}: valor calculado={result}, valor esperado={expected}, {'correcto' if result == expected else 'incorrecto'}")
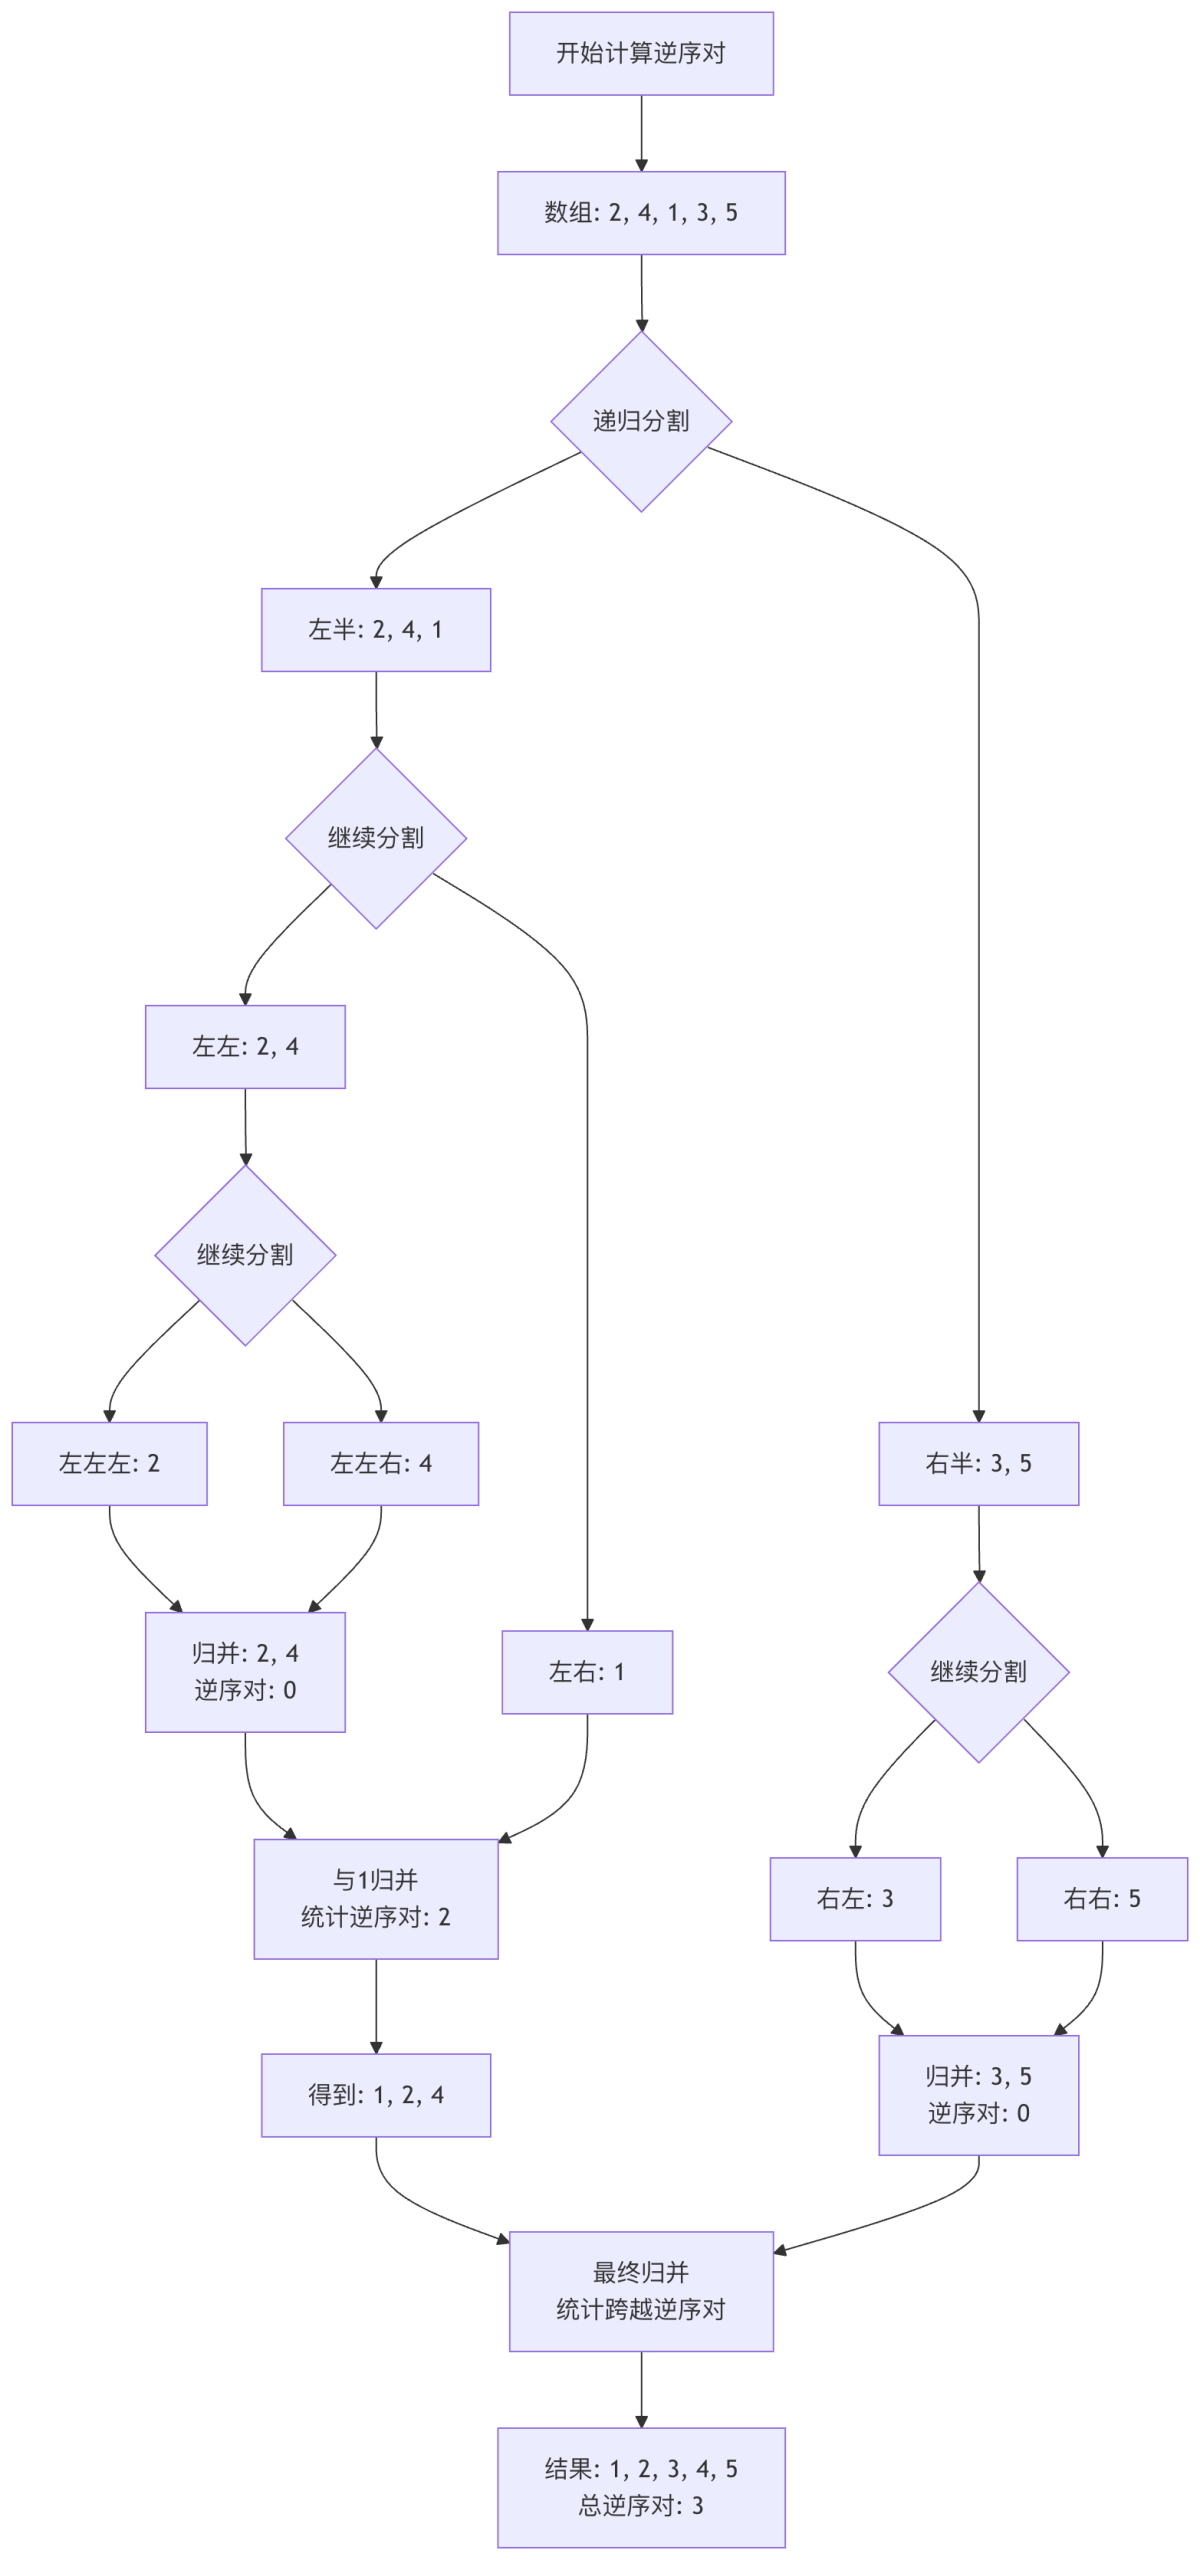
La siguiente figura muestra cómo contar pares invertidos durante la ordenación por mezcla. El punto clave es:Cuando un elemento de la mitad derecha es menor que un elemento de la mitad izquierda, todos los elementos restantes de la mitad izquierda forman pares invertidos con ese elemento de la mitad derecha.。
Clásico problema derivado 3: elemento K-ésimo más grande/más pequeño
Este problema es un caso especial del problema Top K, pero tiene soluciones más variadas.
Comparación de múltiples soluciones
| Método | Complejidad temporal | Complejidad espacial | Característica |
|---|---|---|---|
| Ordenar y tomar directamente | O(n log n) | O(1) o O(n) | La más simple e intuitiva |
| Selección rápida | O(n) promedio | O(1) | Mejor complejidad promedio |
| Método del montículo | O(n log k) | O(k) | Adecuado para flujos de datos |
| Ordenación por conteo | O(n + m) | O(m) | Adecuado para casos con un rango de datos pequeño |
Ejemplo de implementación completa
Ejemplo
"""Encontrar el k-ésimo elemento más pequeño (basado en 1)"""
# Método 1: Ordenamiento directo
def method_sort():
return sorted(nums)[k-1]
# Método 2: Selección rápida (ya implementado arriba)
def method_quick_select():
return quick_select(nums.copy(), k)
# Método 3: Método de montículo (heap)
def method_heap():
# Usar un montículo máximo para encontrar el k-ésimo más pequeño
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, -num) # El montículo máximo se implementa con números negativos
elif num < -heap[0]:
heapq.heapreplace(heap, -num)
return -heap[0]
# Método 4: Ordenamiento por conteo (adecuado para rangos de datos pequeños)
def method_counting():
if not nums:
return None
# Encontrar el rango de datos
min_val, max_val = min(nums), max(nums)
range_size = max_val - min_val + 1
# Contar
count = [0] * range_size
for num in nums:
count[num - min_val] += 1
# Encontrar el k-ésimo más pequeño
accumulated = 0
for i in range(range_size):
accumulated += count[i]
if accumulated >= k:
return i + min_val
return None
# Verificar que todos los métodos dan el mismo resultado
result1 = method_sort()
result2 = method_quick_select()
result3 = method_heap()
result4 = method_counting()
print(f"\nPrueba de búsqueda del {k}-ésimo elemento más pequeño (array: {nums}):")
print(f"Método de ordenamiento: {result1}")
print(f"Selección rápida: {result2}")
print(f"Método de montículo: {result3}")
print(f"Método de conteo: {result4}")
# Verificar consistencia
assert result1 == result2 == result3 == result4, "¡Los resultados de los diferentes métodos no coinciden!"
return result1
# Datos de prueba
test_nums = [3, 2, 3, 1, 2, 4, 5, 5, 6]
for k in [1, 3, 5, 7]:
find_kth_smallest(test_nums.copy(), k)
Clásico problema derivado 4: fusión de intervalos
Definición del problema
Dado un conjunto de intervalos, fusiona todos los intervalos superpuestos.
Escenarios de aplicación práctica:
- Fusión de intervalos de tiempo en aplicaciones de calendario
- Programación de tareas en la gestión de proyectos
- Fusión de rangos de direcciones IP de red
Solución: ordenación + escaneo lineal
Ejemplo
"""
Fusionar intervalos superpuestos
intervals: lista de listas, cada sublista representa un intervalo [start, end]
Retorna: lista de intervalos fusionados
"""
if not intervals:
return []
# Paso clave 1: Ordenar por el inicio del intervalo
intervals.sort(key=lambda x: x[0])
merged = []
# Paso clave 2: Escaneo lineal para fusionar
current_start, current_end = intervals[0]
for interval in intervals[1:]:
start, end = interval
if start <= current_end: # Hay superposición
# Fusionar intervalos: tomar el punto final más grande
current_end = max(current_end, end)
else: # Sin superposición
# Guardar el intervalo actual
merged.append([current_start, current_end])
# Comenzar un nuevo intervalo
current_start, current_end = start, end
# Agregar el último intervalo
merged.append([current_start, current_end])
return merged
# Probar fusión de intervalos
test_intervals = [
[[1, 3], [2, 6], [8, 10], [15, 18]],
[[1, 4], [4, 5]],
[[1, 4], [0, 4]],
[[1, 4], [2, 3]], # Inclusión completa
[[1, 4], [0, 2], [3, 5]], # Casos complejos
]
print("\nPrueba de fusión de intervalos:")
for i, intervals in enumerate(test_intervals, 1):
result = merge_intervals(intervals.copy())
print(f"Caso de prueba {i}:")
print(f" Entrada: {intervals}")
print(f" Salida: {result}")
print()
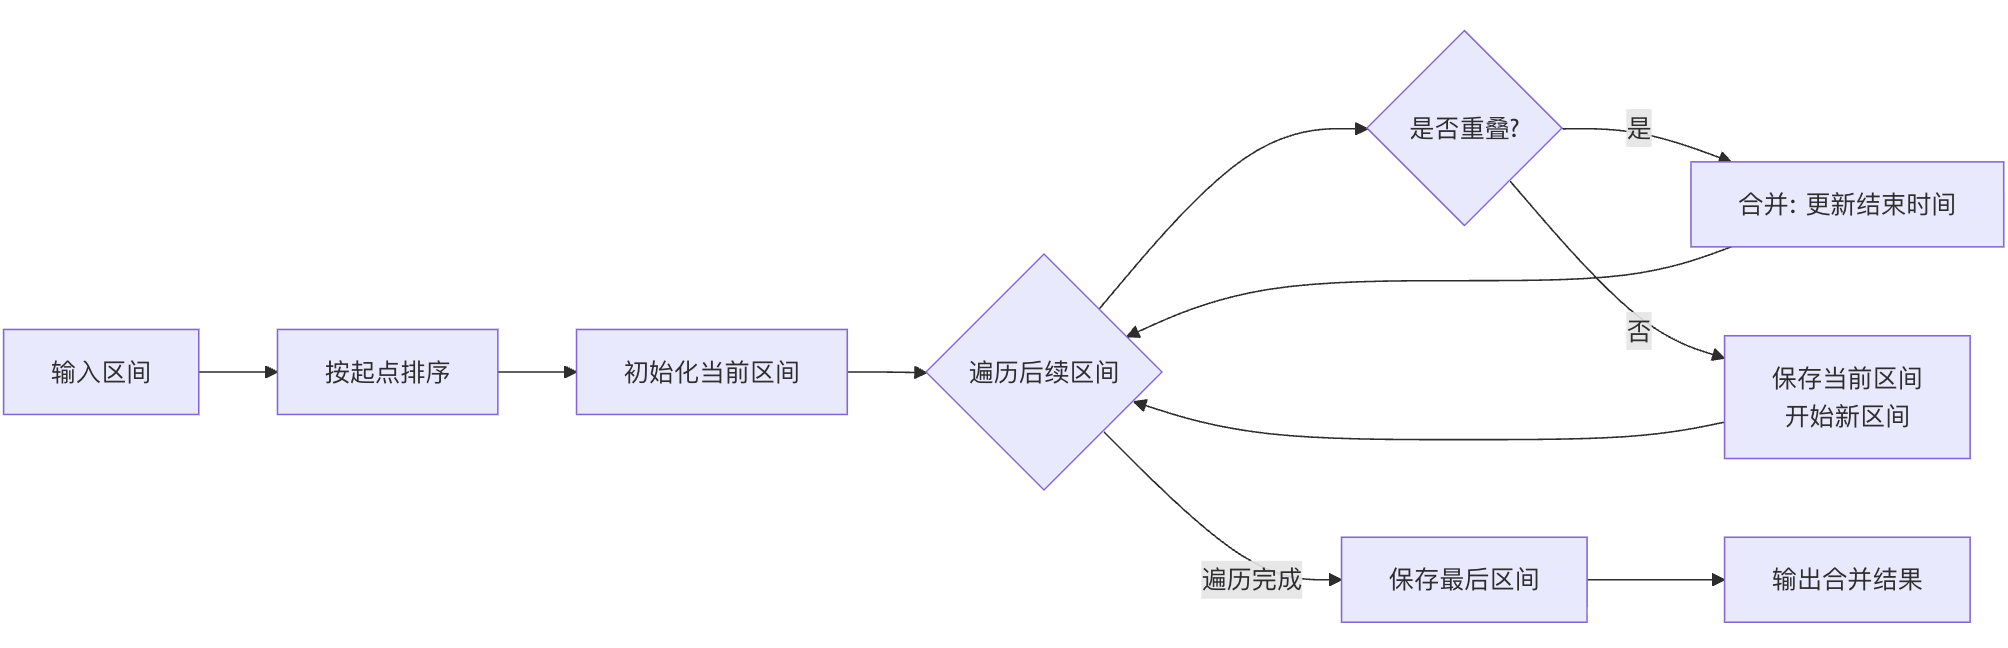
Análisis del proceso del algoritmo
Ejercicios prácticos
Ahora, consolidemos lo aprendido con algunos ejercicios:
Ejercicio 1: clasificación de colores (problema de la bandera holandesa)
Dado un array de n elementos que contienen rojo, blanco y azul, ordénalos en su lugar de modo que los elementos del mismo color queden adyacentes y en el orden rojo, blanco, azul.
Ejemplo
"""
Ordenar el array de colores en su lugar
0: rojo, 1: blanco, 2: azul
Usar el método de tres punteros (similar a la idea de partición del ordenamiento rápido)
"""
# Inicializar tres punteros
left = 0 # Límite derecho de la zona roja
current = 0 # Elemento actual a revisar
right = len(nums) - 1 # Límite izquierdo de la zona azul
while current <= right:
if nums[current] == 0: # Rojo
nums[left], nums[current] = nums[current], nums[left]
left += 1
current += 1
elif nums[current] == 1: # Blanco
current += 1
else: # Azul
nums[current], nums[right] = nums[right], nums[current]
right -= 1
# Nota: aquí no se incrementa current, porque el elemento intercambiado aún no se ha revisado
return nums
# Prueba
colors = [2, 0, 2, 1, 1, 0]
print("Antes de ordenar los colores:", colors)
print("Después de ordenar los colores:", sort_colors(colors.copy()))
Ejercicio 2: el K-ésimo elemento más grande en un array
Encuentra el k-ésimo elemento más grande en un array no ordenado.
Ejemplo
"""
Encontrar el k-ésimo elemento más grande
Usar el algoritmo de selección rápida
"""
# El k-ésimo más grande = el (n-k+1)-ésimo más pequeño
k_smallest = len(nums) - k + 1
def quick_select(arr, left, right, k_small):
if left == right:
return arr[left]
# Elegir pivote
pivot_idx = (left + right) // 2
pivot = arr[pivot_idx]
# Particionar
arr[pivot_idx], arr[right] = arr[right], arr[pivot_idx]
store_idx = left
for i in range(left, right):
if arr[i] < pivot:
arr[store_idx], arr[i] = arr[i], arr[store_idx]
store_idx += 1
arr[right], arr[store_idx] = arr[store_idx], arr[right]
# Selección recursiva
if k_small == store_idx:
return arr[store_idx]
elif k_small < store_idx:
return quick_select(arr, left, store_idx - 1, k_small)
else:
return quick_select(arr, store_idx + 1, right, k_small)
return quick_select(nums.copy(), 0, len(nums) - 1, k_smallest - 1)
# Prueba
test_array = [3, 2, 1, 5, 6, 4]
k = 2
print(f"\nEl {k}-ésimo elemento más grande en el array {test_array} es: {find_kth_largest(test_array, k)}")