ソートアルゴリズム派生問題
バブルソートやクイックソートなどの基本ソートアルゴリズムを習得すると、ソートは単にデータを順番に並べるだけではないことに気づくでしょう。
実際のプログラミングや面接では、多くの問題がソートアルゴリズムの変形または派生問題です。
これらの派生問題を理解することで、ソートアルゴリズムの本質をより深く把握し、複雑な問題を解決する能力を高めることができます。
本記事では、いくつかの代表的なソートアルゴリズム派生問題について考察し、その中核となる考え方、解決策、実際の応用を分析することで、より体系的なアルゴリズム思考を身につける助けとなります。
ソートアルゴリズム派生問題とは何か?
ソートアルゴリズム派生問題とは、直接ソートを要求しないが、問題解決の中核となる考え方、アルゴリズムの流れ、またはデータ構造が古典的なソートアルゴリズムと高度に関連している問題のことです。
この種の問題には通常、以下の特徴があります。
- 目標が異なる:最終目標は順序付きシーケンスを出力することではない
- 考え方が共通する:ソートにおける比較、交換、分割統治などの中核的な考え方を使用する
- 計算量が関連する:時間計算量は多くの場合、ソートアルゴリズムと同じオーダーになる
- 応用が広い:実際の開発で頻繁に遭遇する
以下、いくつかの具体的な問題を通して深く理解していきましょう。
代表的な派生問題 その1:Top K 問題
問題定義
n 個の要素の中から最大(または最小)の K 個の要素を見つける。
実際の応用シーン:
- ECサイト:売上上位10個の商品を見つける
- SNS:フォロワー数上位100人のユーザーを見つける
- データ分析:アクセス数上位5ページを見つける
解決策の比較
| 方法 | 時間計算量 | 空間計算量 | 適用シーン |
|---|---|---|---|
| 直接ソートして先頭K個を取得 | O(n log n) | O(1) または O(n) | K が n に近い場合 |
| バブルソートをK回行う | O(n × K) | O(1) | K が非常に小さい場合 (K < 10) |
| 最小ヒープ/最大ヒープ | O(n log K) | O(K) | 最も一般的、K が n よりはるかに小さい |
| クイックセレクトアルゴリズム | 平均 O(n)、最悪 O(n²) | O(1) | 完全に整列する必要はなく、Top K だけでよい |
方法1:クイックソートの考え方に基づくクイックセレクト
クイックセレクトアルゴリズムはクイックソートの変種であり、配列全体を完全にソートする必要はなく、K番目に大きい要素の位置を見つけるだけでよい。
例
"""
クイックセレクトアルゴリズムを使ってk番目に小さい要素を見つける
nums: 入力配列
k: 探すk番目に小さい要素 (1-based)
戻り値: k番目に小さい要素の値
"""
def partition(left, right, pivot_idx):
"""パーティション関数。配列を基準値未満と基準値より大きい部分の2つに分割する"""
pivot = nums[pivot_idx]
# 基準を末尾に移動する
nums[pivot_idx], nums[right] = nums[right], nums[pivot_idx]
store_idx = left
for i in range(left, right):
if nums[i] < pivot:
nums[store_idx], nums[i] = nums[i], nums[store_idx]
store_idx += 1
# 基準を正しい位置に移動する
nums[right], nums[store_idx] = nums[store_idx], nums[right]
return store_idx
def select(left, right, k_smallest):
"""選択メイン関数"""
if left == right:
return nums[left]
# 基準をランダムに選択する
pivot_idx = left + (right - left) // 2
# パーティション分割し、基準の最終位置を取得する
pivot_idx = partition(left, right, pivot_idx)
# 基準がちょうどk番目に小さい要素である
if k_smallest == pivot_idx:
return nums[k_smallest]
# k番目に小さい要素は左半分にある
elif k_smallest < pivot_idx:
return select(left, pivot_idx - 1, k_smallest)
# k番目に小さい要素は右半分にある
else:
return select(pivot_idx + 1, right, k_smallest)
# k-1 は内部で0-basedインデックスを使用するため
return select(0, len(nums) - 1, k - 1)
def find_top_k(nums, k, largest=True):
"""
最大のk個の要素を見つける
nums: 入力配列
k: 見つける要素の個数
largest: Trueなら最大のk個、Falseなら最小のk個を探す
戻り値: 最大のk個の要素のリスト
"""
n = len(nums)
if k >= n:
return sorted(nums, reverse=largest)
if largest:
# 最大のk個を見つける = 第(n-k+1)小さい要素を見つける
kth_value = quick_select(nums, n - k + 1)
# kth_value 以上の要素をすべて収集する
result = [x for x in nums if x > kth_value]
# 数が足りない場合は、等しい要素を追加する
while len(result) < k:
result.append(kth_value)
return result
else:
# 最小のk個を見つける = 第k小さい要素を見つける
kth_value = quick_select(nums, k)
result = [x for x in nums if x < kth_value]
while len(result) < k:
result.append(kth_value)
return result
# テストデータ
test_data = [3, 2, 1, 5, 6, 4, 9, 8, 7, 0]
print("元データ:", test_data)
print("最大の3つの要素:", find_top_k(test_data.copy(), 3, largest=True))
print("最小の3つの要素:", find_top_k(test_data.copy(), 3, largest=False))
方法2:ヒープソートに基づく解決策
ヒープはTop K問題を解決する古典的なデータ構造であり、データストリームのシナリオに特に適しています。
例
def find_top_k_with_heap(nums, k, largest=True):
"""
ヒープを使って最大のk個の要素を見つける
nums: 入力配列
k: 見つける要素の個数
largest: Trueなら最大のk個、Falseなら最小のk個を探す
戻り値: 最大のk個の要素のリスト
"""
if largest:
# 最大のk個を見つける:最小ヒープを使用する
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, num)
elif num > heap[0]: # 現在の要素がヒープの先頭より大きい
heapq.heapreplace(heap, num)
return sorted(heap, reverse=True)
else:
# 最小のk個を見つける:最大ヒープを使用する(負数を取ることで実現)
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, -num) # 負数を格納する
elif num < -heap[0]: # 現在の要素がヒープの先頭より小さい
heapq.heapreplace(heap, -num)
return sorted([-x for x in heap])
# ヒープメソッドをテストする
print("\nヒープメソッドを使用:")
print("最大の3つの要素:", find_top_k_with_heap(test_data, 3, largest=True))
print("最小の3つの要素:", find_top_k_with_heap(test_data, 3, largest=False))
代表的な派生問題 その2:転倒数のカウント
問題定義
配列内で、前の要素が後ろの要素より大きい場合、この2つの要素は転倒ペアを構成します。配列内の転倒ペアの総数を計算します。
実際の応用シーン:
- データの整列度を測る
- レコメンドシステムにおけるユーザー嗜好の分析
- バージョン管理システムにおける変更衝突の検出
解決策:マージソートに基づくアルゴリズム
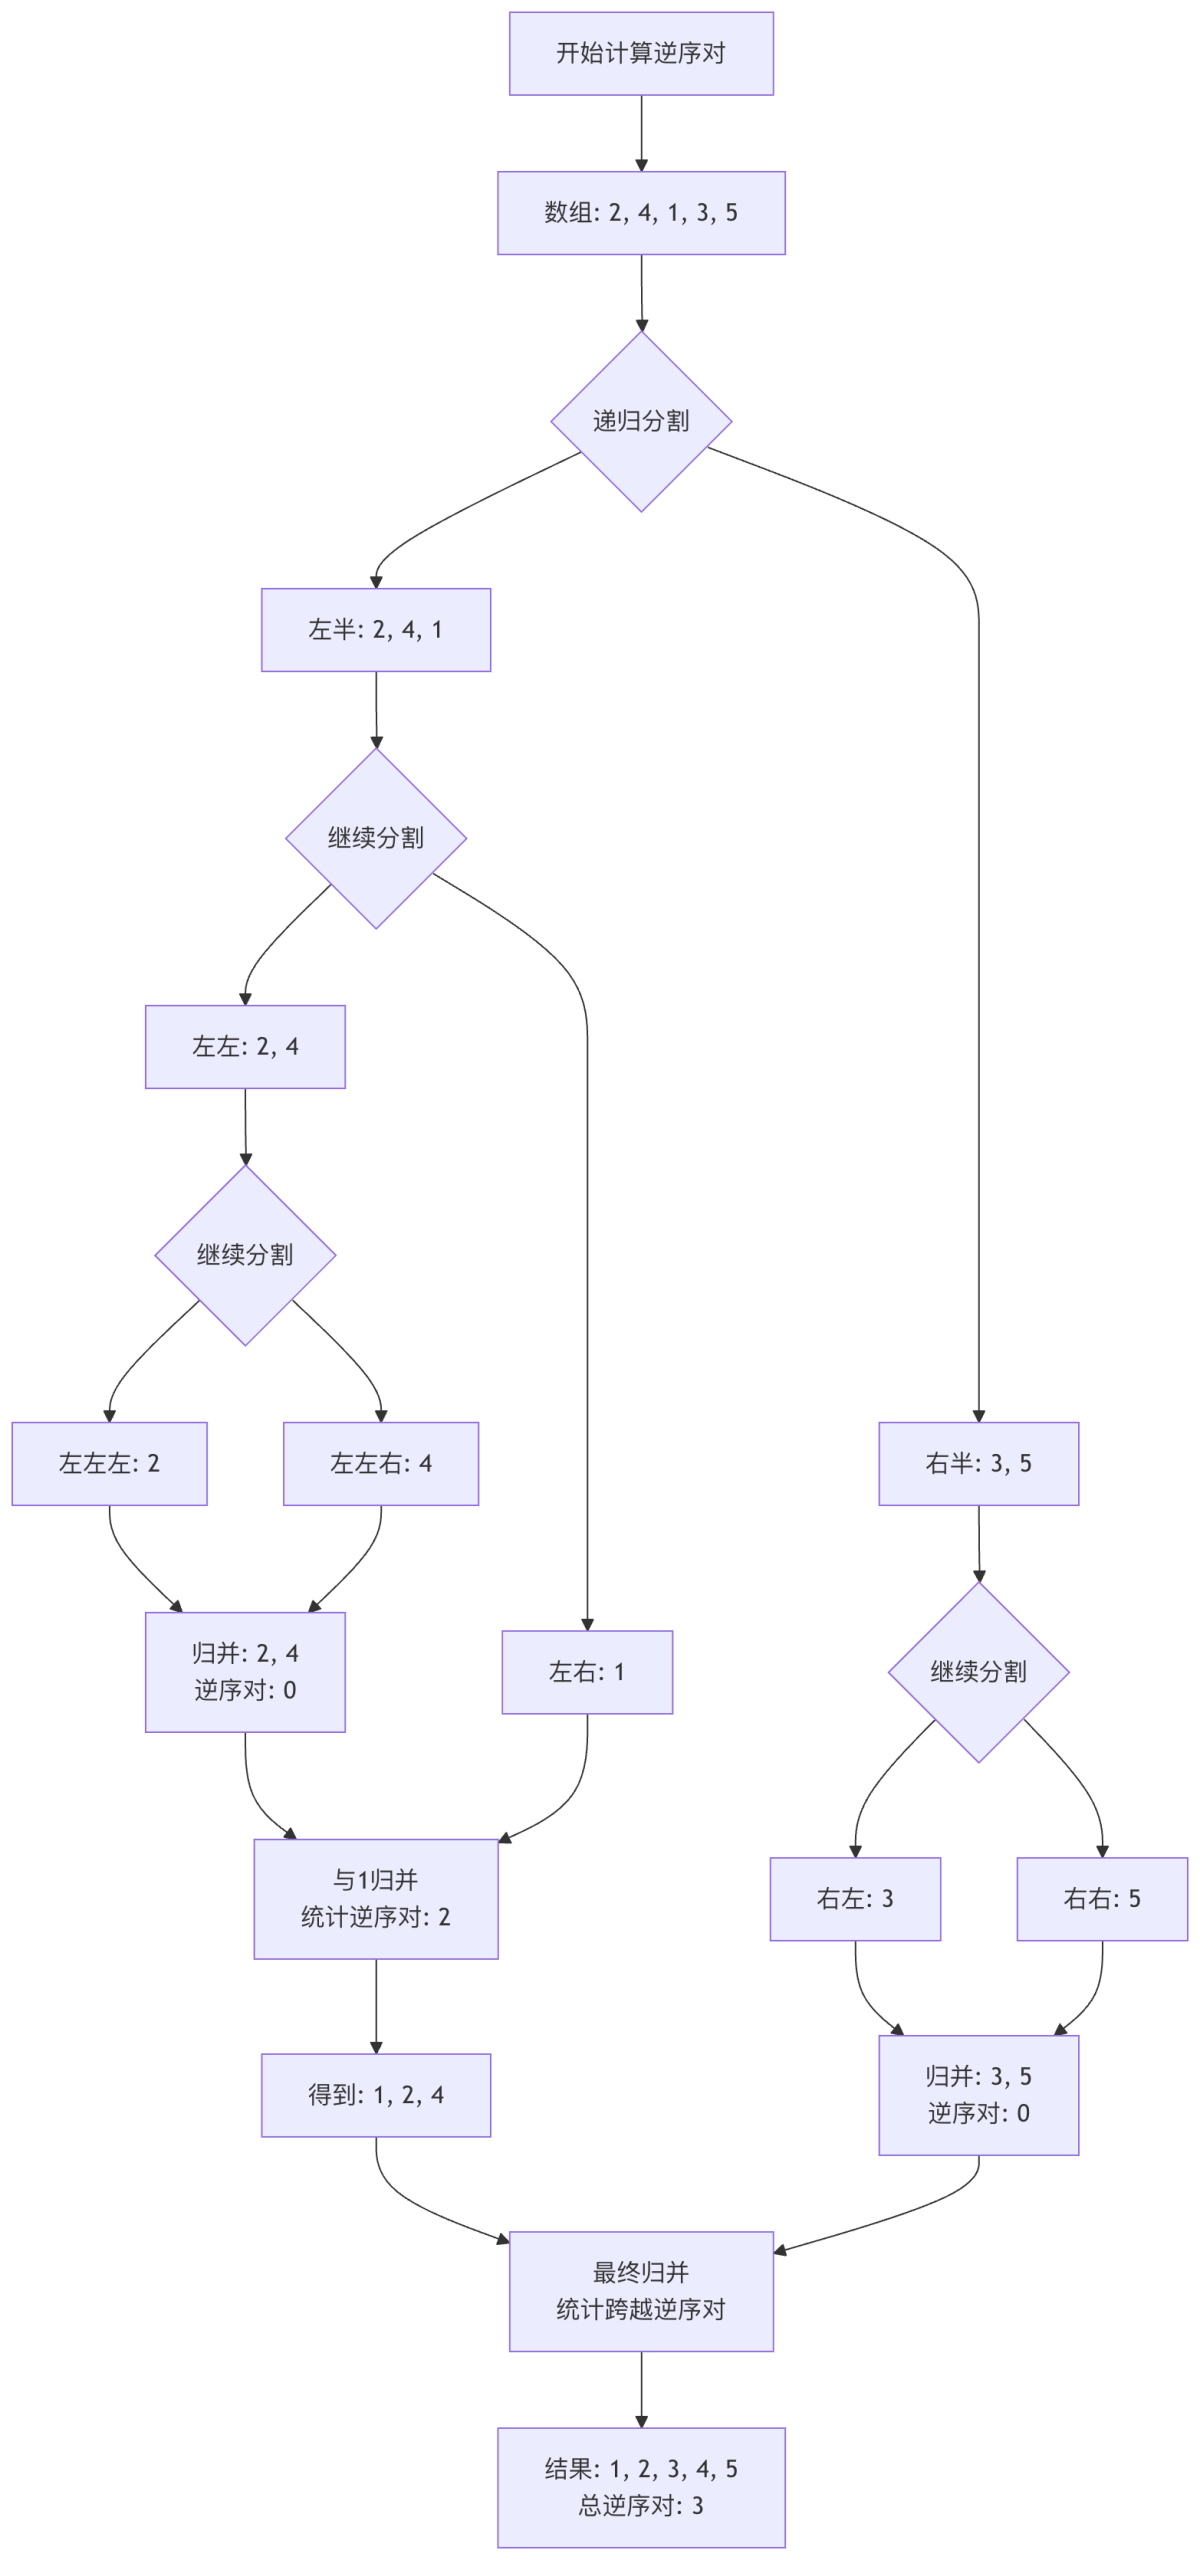
マージソートの過程で自然に転倒ペア数を数えることができ、これは分割統治の考え方の典型的な応用です。
例
"""
配列内の転倒数を計算する
マージソートに基づく方法を使用する
"""
def merge_sort_count(left, right):
"""マージソートを行い、転倒ペアを数える"""
if left >= right:
return 0, [nums[left]] if left == right else []
mid = (left + right) // 2
# 再帰的に左右の部分の転倒ペアを数える
left_count, left_arr = merge_sort_count(left, mid)
right_count, right_arr = merge_sort_count(mid + 1, right)
# 中点をまたぐ転倒ペアを数える
cross_count = 0
merged = []
i = j = 0
while i < len(left_arr) and j < len(right_arr):
if left_arr[i] <= right_arr[j]:
merged.append(left_arr[i])
i += 1
else:
# left_arr[i] > right_arr[j] の場合、転倒ペアを構成する
merged.append(right_arr[j])
cross_count += len(left_arr) - i # 重要:左側の残りの要素はすべて right_arr[j] と転倒ペアを構成する
j += 1
# 残りの要素を追加する
merged.extend(left_arr[i:])
merged.extend(right_arr[j:])
total_count = left_count + right_count + cross_count
return total_count, merged
if not nums:
return 0
count, _ = merge_sort_count(0, len(nums) - 1)
return count
# 転倒ペア数え上げのテスト
test_cases = [
([1, 2, 3, 4, 5], 0), # 完全に整列している場合、転倒ペアは0
([5, 4, 3, 2, 1], 10), # 完全に逆順の場合、転倒ペアはC(5,2)=10
([2, 4, 1, 3, 5], 3), # 例
([7, 5, 6, 4], 5), # 複雑な例
]
print("\n転倒数カウントテスト:")
for nums, expected in test_cases:
result = count_inversions(nums.copy())
print(f"配列 {nums}: 計算値={result}, 期待値={expected}, {'正しい' if result == expected else '誤り'}")
下図は、マージソートの過程でどのように転倒ペアを数えるかを示しています。重要なポイントは次のとおりです:右半分の要素が左半分のある要素より小さい場合、左半分の残りのすべての要素がその右半分の要素と転倒ペアを構成します。
代表的な派生問題 その3:K番目に大きい/小さい要素
この問題はTop K問題の特殊なケースですが、解法はより多様です。
複数の解法の比較
| 方法 | 時間計算量 | 空間計算量 | 特徴 |
|---|---|---|---|
| ソート後に直接取得 | O(n log n) | O(1) または O(n) | 最も簡単で直感的 |
| クイックセレクト | O(n) 平均 | O(1) | 最良の平均計算量 |
| ヒープ法 | O(n log k) | O(k) | データストリームに適している |
| 計数ソート | O(n + m) | O(m) | データ範囲が小さい場合に適している |
完全な実装例
例
"""第k番目に小さい要素を見つける(1始まり)"""
# 方法1: 直接ソート
def method_sort():
return sorted(nums)[k-1]
# 方法2: クイックセレクト(上で実装済み)
def method_quick_select():
return quick_select(nums.copy(), k)
# 方法3: ヒープ法
def method_heap():
# 最大ヒープを使用して第k小を求める
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, -num) # 最大ヒープは負数を使って実現
elif num < -heap[0]:
heapq.heapreplace(heap, -num)
return -heap[0]
# 方法4: 計数ソート(データ範囲が小さい場合に適する)
def method_counting():
if not nums:
return None
# データ範囲を求める
min_val, max_val = min(nums), max(nums)
range_size = max_val - min_val + 1
# カウント
count = [0] * range_size
for num in nums:
count[num - min_val] += 1
# 第k小を見つける
accumulated = 0
for i in range(range_size):
accumulated += count[i]
if accumulated >= k:
return i + min_val
return None
# すべてのメソッドの結果が一致することを確認
result1 = method_sort()
result2 = method_quick_select()
result3 = method_heap()
result4 = method_counting()
print(f"\n第{k}小要素検索テスト(配列: {nums}):")
print(f"ソート法: {result1}")
print(f"クイックセレクト: {result2}")
print(f"ヒープ法: {result3}")
print(f"計数法: {result4}")
# 一貫性の確認
assert result1 == result2 == result3 == result4, "異なるメソッドの結果が一致しません!"
return result1
# テストデータ
test_nums = [3, 2, 3, 1, 2, 4, 5, 5, 6]
for k in [1, 3, 5, 7]:
find_kth_smallest(test_nums.copy(), k)
代表的な派生問題 その4:区間のマージ
問題定義
一組の区間が与えられたとき、重複するすべての区間をマージします。
実際の応用シーン:
- カレンダーアプリでの時間帯のマージ
- プロジェクト管理でのタスクの時間調整
- ネットワークIPアドレス帯のマージ
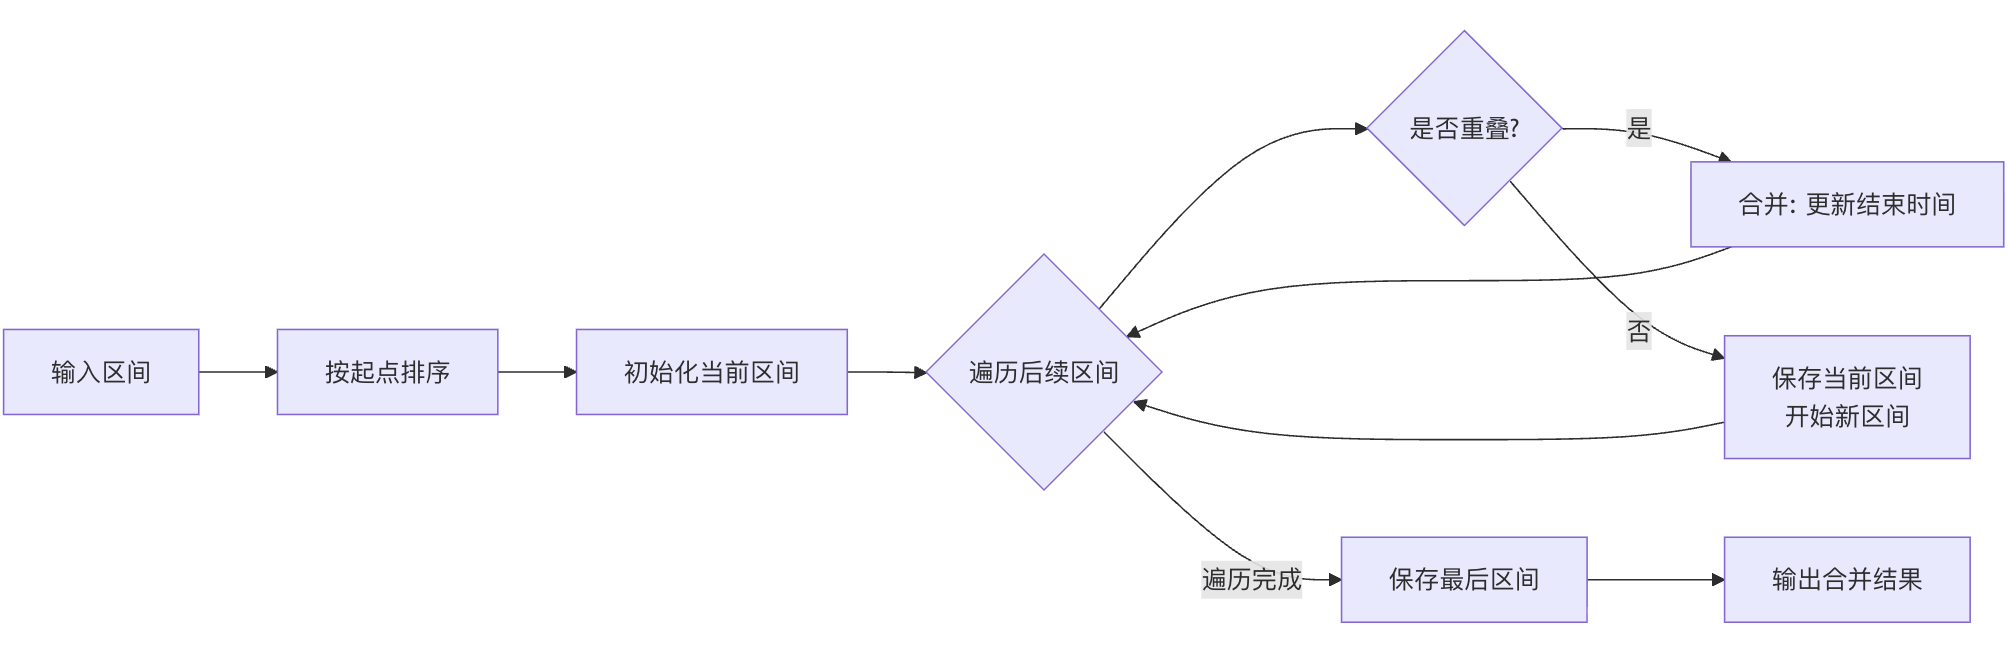
解決策:ソート+線形スキャン
例
"""
重複する区間をマージ
intervals: リストのリスト。各サブリストは区間 [start, end] を表す
戻り値: マージ後の区間リスト
"""
if not intervals:
return []
# 重要なステップ1: 区間の開始点でソート
intervals.sort(key=lambda x: x[0])
merged = []
# 重要なステップ2: 線形スキャンでマージ
current_start, current_end = intervals[0]
for interval in intervals[1:]:
start, end = interval
if start <= current_end: # 重複あり
# 区間をマージ:最大の終了点を取る
current_end = max(current_end, end)
else: # 重複なし
# 現在の区間を保存
merged.append([current_start, current_end])
# 新しい区間を開始
current_start, current_end = start, end
# 最後の区間を追加
merged.append([current_start, current_end])
return merged
# 区間マージのテスト
test_intervals = [
[[1, 3], [2, 6], [8, 10], [15, 18]],
[[1, 4], [4, 5]],
[[1, 4], [0, 4]],
[[1, 4], [2, 3]], # 完全に含む
[[1, 4], [0, 2], [3, 5]], # 複雑なケース
]
print("\n区間マージテスト:")
for i, intervals in enumerate(test_intervals, 1):
result = merge_intervals(intervals.copy())
print(f"テストケース {i}:")
print(f" 入力: {intervals}")
print(f" 出力: {result}")
print()
アルゴリズムのプロセス解析
実践演習
さて、いくつかの演習を通して学んだ知識を定着させましょう:
演習1:色の分類(オランダ国旗問題)
赤、白、青の全部で n 個の要素を含む配列が与えられ、同じ色の要素が隣接し、赤、白、青の順に並ぶように、それらをインプレースでソートします。
例
"""
色の配列をインプレースでソート
0: 赤, 1: 白, 2: 青
三つのポインタ法を使用(クイックソートの分割思想に類似)
"""
# 三つのポインタを初期化
left = 0 # 赤領域の右端
current = 0 # 現在チェック中の要素
right = len(nums) - 1 # 青領域の左端
while current <= right:
if nums[current] == 0: # 赤
nums[left], nums[current] = nums[current], nums[left]
left += 1
current += 1
elif nums[current] == 1: # 白
current += 1
else: # 青
nums[current], nums[right] = nums[right], nums[current]
right -= 1
# 注意:ここではcurrentを増やさない。交換されてきた要素はまだチェックしていないため
return nums
# テスト
colors = [2, 0, 2, 1, 1, 0]
print("色ソート前:", colors)
print("色ソート後:", sort_colors(colors.copy()))
演習2:配列内のK番目に大きい要素
ソートされていない配列の中で k 番目に大きい要素を見つけます。
例
"""
第k大の要素を見つける
クイックセレクトアルゴリズムを使用
"""
# 第k大 = 第(n-k+1)小
k_smallest = len(nums) - k + 1
def quick_select(arr, left, right, k_small):
if left == right:
return arr[left]
# 基準を選択
pivot_idx = (left + right) // 2
pivot = arr[pivot_idx]
# 分割
arr[pivot_idx], arr[right] = arr[right], arr[pivot_idx]
store_idx = left
for i in range(left, right):
if arr[i] < pivot:
arr[store_idx], arr[i] = arr[i], arr[store_idx]
store_idx += 1
arr[right], arr[store_idx] = arr[store_idx], arr[right]
# 再帰的に選択
if k_small == store_idx:
return arr[store_idx]
elif k_small < store_idx:
return quick_select(arr, left, store_idx - 1, k_small)
else:
return quick_select(arr, store_idx + 1, right, k_small)
return quick_select(nums.copy(), 0, len(nums) - 1, k_smallest - 1)
# テスト
test_array = [3, 2, 1, 5, 6, 4]
k = 2
print(f"\n配列 {test_array} の中で第 {k} 大きい要素は: {find_kth_largest(test_array, k)}")