Algoritmos avanzados de grafos
En los tutoriales básicos anteriores, ya hemos aprendido los conceptos fundamentales de los grafos, sus métodos de representación y algoritmos básicos como la búsqueda en anchura (BFS) y la búsqueda en profundidad (DFS). Estos algoritmos nos ayudan a resolver problemas como si dos puntos están conectados o cómo recorrer un grafo.
Sin embargo, muchos problemas complejos del mundo real, como la recomendación de amigos en redes sociales, la planificación de la ruta más corta en la navegación con mapas, la optimización de rutas en la distribución logística, e incluso la clasificación de páginas web en Internet, requieren algoritmos más potentes y eficientes. Estos son losalgoritmos avanzados de grafosque se encargan de resolver estos desafíos.
Algoritmos avanzados de grafosSon como herramientas especializadas diseñadas para resolver problemas complejos específicos:
- Flujo en redes: resuelve problemas de asignación de flujo, como en transporte y logística.
- Emparejamiento en grafos bipartitos: resuelve problemas de emparejamiento, como asignación de tareas o emparejamiento de parejas.
- Componentes fuertemente conexos: analiza la estructura de conectividad de un grafo.
- Ordenamiento topológico: resuelve problemas de dependencias.
Casos de la vida real:
- Flujo en redes: como la optimización del flujo en el sistema de tráfico urbano.
- Emparejamiento en grafos bipartitos: como un sistema de emparejamiento de parejas.
- Componentes fuertemente conexos: como el análisis de círculos de amigos en redes sociales.
- Ordenamiento topológico: como el ordenamiento de tareas con dependencias.
| Tipo de problema | Algoritmos comunes | Algoritmos avanzados de grafos |
|---|---|---|
| Optimización de flujo | Difícil de modelar y resolver | Los algoritmos de flujo en redes lo resuelven específicamente |
| Problemas de emparejamiento | La búsqueda por fuerza bruta es ineficiente | El emparejamiento en grafos bipartitos lo resuelve eficientemente |
| Análisis de conectividad | El BFS/DFS básico proporciona información limitada | Los componentes fuertemente conexos ofrecen un análisis profundo |
| Ordenamiento de dependencias | Difícil de manejar dependencias complejas | El ordenamiento topológico lo resuelve perfectamente |
El problema del camino más corto y el algoritmo de Dijkstra
Imagina que estás usando una aplicación de mapas para planificar la ruta de tu casa a la oficina. En el mapa hay innumerables rutas, y cada una tiene un tiempo de viaje (peso) diferente. Tu objetivo es encontrarla ruta con el menor tiempo total de viaje, este es el clásicoproblema del camino más corto de una sola fuente.。
Idea central del algoritmo
El algoritmo de Dijkstraes un algoritmo voraz que resuelve elproblema del camino más corto de una sola fuente en grafos con pesos no negativos. Su idea central es como la de un explorador cauteloso:
- Mantiene un conjunto de "distancias más cortas conocidas".
- Cada vez, selecciona de la "región desconocida" un nodoque actualmente esté a la distancia más corta desde el punto de partida, y confirma su distancia más corta.
- Luego, usa este nodo recién confirmado para actualizar las "distancias más cortas estimadas" de todos sus vecinos.
- Repite este proceso hasta que se hayan confirmado las distancias más cortas de todos los nodos.
Explicación detallada de los pasos del algoritmo
Visualicemos el proceso de ejecución del algoritmo de Dijkstra mediante un diagrama de flujo:
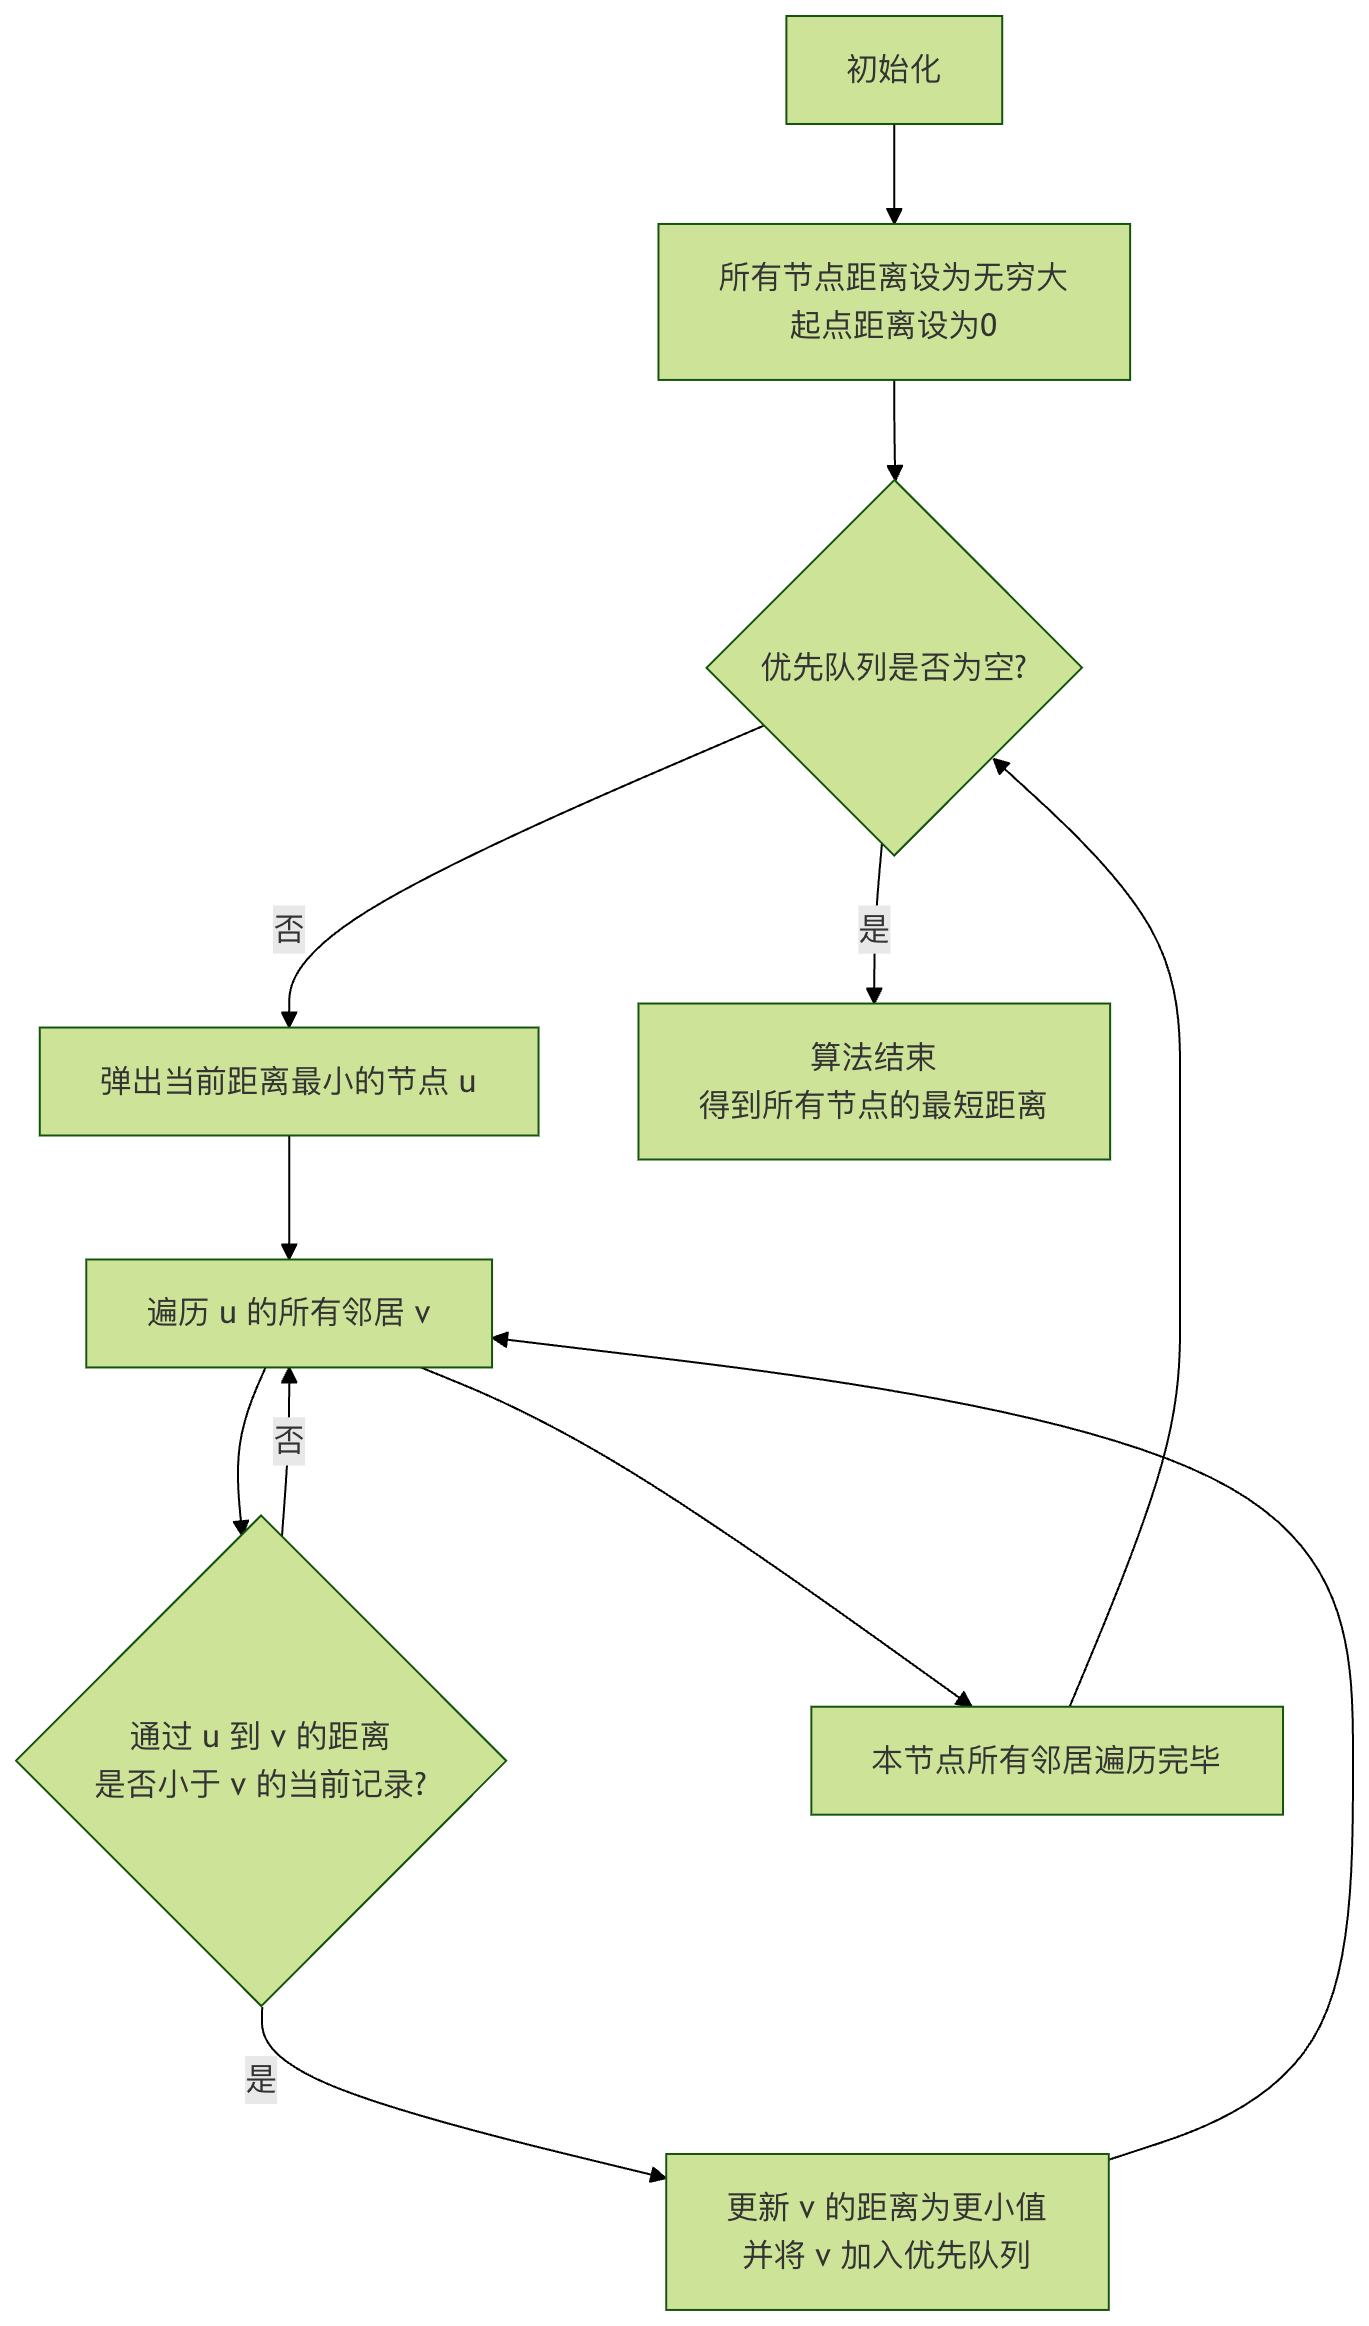
Explicación del diagrama de flujo: el algoritmo comienza con la inicialización, y continuamente extrae de la cola de prioridad el nodo no procesado más cercano al punto de partida, usándolo para relajar (actualizar) las estimaciones de distancia de sus nodos vecinos, hasta que la cola se vacía; en ese momento, todos los caminos más cortos han sido determinados.
Implementación de código y ejemplos
A continuación, implementaremos el algoritmo de Dijkstra en Python. Usaremos el móduloheapqcola de prioridad (montículo mínimo) para obtener eficientemente el nodo con la distancia mínima actual.
Ejemplo
def dijkstra(graph, start):
"""
Calcula la distancia más corta desde el nodo inicial start a todos los demás nodos del grafo usando el algoritmo de Dijkstra.
Parámetros:
graph: lista de adyacencia representada como diccionario. Formato: {nodo: [(vecino1, peso1), (vecino2, peso2), ...]}
start: nodo inicial.
Retorna:
Un diccionario que contiene las distancias más cortas de todos los nodos al nodo inicial.
"""
# Inicialización: la distancia más corta de todos los nodos se establece en infinito
shortest_distances = {node: float('inf') for node in graph}
shortest_distances[start] = 0 # La distancia del inicio a sí mismo es 0
# Usar una cola de prioridad (montículo mínimo), con elementos (distancia actual, nodo)
priority_queue = [(0, start)]
while priority_queue:
current_distance, current_node = heapq.heappop(priority_queue)
# Si la distancia extraída actual es mayor que la distancia registrada, son datos antiguos, omitir
if current_distance > shortest_distances[current_node]:
continue
# Recorrer todos los vecinos del nodo actual
for neighbor, weight in graph[current_node]:
distance = current_distance + weight
# Si se encuentra un camino más corto, actualizar
if distance < shortest_distances[neighbor]:
shortest_distances[neighbor] = distance
heapq.heappush(priority_queue, (distance, neighbor))
return shortest_distances
# --- Ejemplo de prueba ---
# Definir un grafo dirigido con pesos (nodo: [(vecino, peso), ...])
test_graph = {
'A': [('B', 4), ('C', 2)],
'B': [('C', 1), ('D', 5)],
'C': [('B', 1), ('D', 8), ('E', 10)],
'D': [('E', 2)],
'E': []
}
start_node = 'A'
distances = dijkstra(test_graph, start_node)
print(f"Distancias más cortas desde el nodo {start_node} a cada nodo:")
for node, dist in distances.items():
print(f" Al nodo {node}: {dist}")
Explicación del código:
shortest_distancesEl diccionario se usa para registrar, desde el inicio hasta cada nodo, la distancia más cortafinalmente confirmada, con un valor inicial de infinito.priority_queuees un montículo mínimo que siempre nos permite extraer rápidamente el nodo "actualmente estimado como más cercano al inicio".- En el bucle principal,
heapq.heappopse extrae el nodo en la cima del montículo (el nodo actualmente más cercano). if current_distance > ... : continuees una optimización clave para manejar las múltiples versiones antiguas del mismo nodo (con valores de distancia) que puedan existir en el montículo.- Al recorrer los vecinos, se calcula
distance = current_distance + weight, que es la "nueva distancia al vecino a través del nodo actual". - Si la nueva distancia es más corta, se actualiza
shortest_distancesunióny se inserta el vecino con su nueva distancia en el montículo, para su procesamiento posterior.
Al ejecutar el código anterior, obtendrás la siguiente salida::
从节点 A 出发到各节点的最短距离:
  到节点 A: 0
  到节点 B: 3  # 路径: A -> C -> B
  到节点 C: 2  # 路径: A -> C
  到节点 D: 8  # 路径: A -> C -> B -> D
  到节点 E: 10 # 路径: A -> C -> B -> D -> E
Árbol de expansión mínima y algoritmo de Prim
Ahora considera otro problema: debes tender una red de fibra óptica para una nueva zona residencial, conectando todas las casas. Para ahorrar costos, deseas que la longitud total de fibra óptica utilizada sea la mínima posible. Se conoce el costo (peso) de tender fibra óptica entre cada par de casas. ¿Cómo eliges qué líneas tender?
Este problema requiere encontrar unsubgrafo que conecte todos los nodos, y que además sea un árbol (sin ciclos), y que la suma de los pesos de todas sus aristas seamínima. Este árbol se llamaárbol de expansión mínima (MST, por sus siglas en inglés).。
Idea del algoritmo de Prim
El algoritmo de Primes un algoritmo voraz para encontrar el árbol de expansión mínima. Su proceso se parece mucho a "hacer crecer un árbol":
- Comienza con cualquier nodo e inicializa el árbol para que contenga únicamente ese nodo.
- Entre todaslas aristas que conectan un nodo interno del árbol con un nodo externo, elige una arista depeso mínimo.
- Añade esta arista y el nodoexternoque conecta al árbol.
- Repite los pasos 2 y 3 hasta que todos los nodos estén incluidos en el árbol.
Implementación de código y ejemplos
La implementación del algoritmo de Prim es muy similar a la de Dijkstra, con la diferencia en la definición de la distancia.
En el algoritmo de Prim, mantenemos el costo mínimo de conexión de cada nodo alárbol de expansión actual.
Ejemplo
def prim_mst(graph):
"""
Calcula el peso total del árbol de expansión mínima (MST) de un grafo usando el algoritmo de Prim.
Parámetros:
graph: lista de adyacencia representada como diccionario. Formato: {nodo: [(vecino1, peso1), (vecino2, peso2), ...]}
Se asume que el grafo es conexo.
Retorna:
El peso total del árbol de expansión mínima.
"""
start_node = list(graph.keys())[0] # Comenzar desde cualquier nodo; aquí se toma el primero
visited = set([start_node]) # Conjunto de nodos ya agregados al MST
# Cola de prioridad que almacena (peso de la arista, nodo vecino)
# Inicialización: agregar todas las aristas del nodo inicial a la cola
edges = [(weight, start_node, neighbor) for neighbor, weight in graph[start_node]]
heapq.heapify(edges)
total_weight = 0
while edges:
weight, from_node, to_node = heapq.heappop(edges)
if to_node not in visited:
visited.add(to_node) # Agregar el nuevo nodo al MST
total_weight += weight # Acumular el peso total del MST
print(fAñadir arista: {from_node} - {to_node}, peso: {weight}) # Imprime la arista seleccionada
# Añade a la cola todas las aristas que conectan el nuevo nodo con nodos externos
for neighbor, w in graph[to_node]:
if neighbor not in visited:
heapq.heappush(edges, (w, to_node, neighbor))
return total_weight
# --- Ejemplo de prueba ---
# Define un grafo no dirigido con pesos (cada arista aparece dos veces en la lista de adyacencia)
test_graph_undirected = {
'A': [('B', 4), ('C', 2)],
'B': [('A', 4), ('C', 1), ('D', 5)],
'C': [('A', 2), ('B', 1), ('D', 8), ('E', 10)],
'D': [('B', 5), ('C', 8), ('E', 2)],
'E': [('C', 10), ('D', 2)]
}
print(Proceso de construcción del árbol de expansión mínima:)
mst_weight = prim_mst(test_graph_undirected)
print(f"\nEl peso total del árbol de expansión mínima es: {mst_weight})
Explicación del código:
visitedEl conjunto registra los nodos que ya pertenecen al MST.edgeses un montículo mínimo que almacena todaslas aristas que cruzan el interior y el exterior del MST(es decir, un extremo está envisitedel MST y el otro no).- En el bucle principal, siempre se toma del montículo la arista de menor peso.
(weight, from_node, to_node)。 - Si el nodo que conecta esta arista
to_nodeaún no ha sido visitado, entonces es una arista válida del MST. Se añade al resultado y se actualiza convisitedytotal_weight。 - el nuevo nodo.
to_nodeTodas las aristas del nuevo nodo hacia nodos externos se añaden al montículo para la siguiente ronda.
Al ejecutar el código anterior, verás el proceso de construcción del MST:
构建最小生成树的过程:
添加边: A - C, 权重: 2
添加边: C - B, 权重: 1
添加边: A - B, 权重: 4  # 注意:这条边连接B和A,但B已在树中,所以会被下一行的if语句跳过,不会添加。
添加边: B - D, 权重: 5
添加边: D - E, 权重: 2

最小生成树的总权重为: 10
(Nota: en la salida real, la arista A - B, debido a queto_nodeB ya está envisitedel conjunto, no se ejecutaprintla sentencia. El comentario anterior es solo para explicarlo.)Las aristas del MST final son A-C, C-B, B-D, D-E, con un peso total de 2+1+5+2=10.
Ordenamiento topológico: manejo de tareas con dependencias
Cuando necesitas organizar una serie de tareas, y algunas deben comenzar después de que otras hayan terminado (por ejemplo, ponerse los calcetines debe hacerse antes de ponerse los zapatos), ¿cómo determinarías un orden de ejecución razonable? Estas dependencias entre tareas se pueden representar con ungrafo acíclico dirigido (DAG)para representarlas, y el proceso de encontrar un orden de ejecución lineal factible es elordenamiento topológico。
Algoritmo de Kahn (basado en grado de entrada)
El algoritmo de Kahnes uno de los algoritmos más intuitivos para el ordenamiento topológico, y se basa en el grado de entrada (el número de aristas que apuntan al nodo).
- Encuentra todos los nodos con grado de entrada 0, que son tareas que se pueden ejecutar de inmediato (sin dependencias previas).
- Coloca estos nodos en una cola y "elimínalos" del grafo (escríbelos en el resultado ordenado).
- Después de "eliminar" un nodo, actualiza el grado de entrada de todos sus vecinos (resta 1). Si el grado de entrada de algún vecino se convierte en 0, agrégalo a la cola.
- Repite los pasos 2 y 3 hasta que la cola esté vacía.
- Si el número de nodos emitidos es igual al número total de nodos del grafo, la ordenación es exitosa; de lo contrario, significa que hay un ciclo en el grafo y no se puede realizar el ordenamiento topológico.
Implementación de código y ejemplos
Ejemplo
def topological_sort_kahn(graph):
"""
Realiza el ordenamiento topológico usando el algoritmo de Kahn.
Parámetros:
graph: lista de adyacencia representada por un diccionario. Formato: {nodo: [vecino1, vecino2, ...]}
Retorna:
Si existe un ordenamiento topológico, devuelve una lista (el orden); de lo contrario, devuelve None (hay un ciclo).
"""
# 1. Calcula el grado de entrada de todos los nodos
in_degree = {node: 0 for node in graph}
for node in graph:
for neighbor in graph[node]:
in_degree[neighbor] = in_degree.get(neighbor, 0) + 1
# 2. Inicializa la cola, poniendo en la cola todos los nodos con grado de entrada 0
queue = deque([node for node in in_degree if in_degree[node] == 0])
topo_order = []
# 3. Procesa la cola
while queue:
current_node = queue.popleft()
topo_order.append(current_node)
# "Elimina" el nodo actual, actualiza el grado de entrada de sus vecinos
for neighbor in graph.get(current_node, []):
in_degree[neighbor] -= 1
if in_degree[neighbor] == 0:
queue.append(neighbor)
# 4. Comprueba si todos los nodos han sido ordenados
if len(topo_order) == len(graph):
return topo_order
else:
return None # Hay un ciclo en el grafo
# --- Ejemplo de prueba ---
# Define un grafo dirigido de dependencias de cursos
# Por ejemplo: para tomar el curso de algoritmos (Algo) primero se necesita el curso de estructuras de datos (DS)
course_graph = {
'Programación': ['Estructuras de datos', 'Algoritmos'],
'Estructuras de datos': ['Algoritmos', 'Bases de datos'],
'Algoritmos': ['Aprendizaje automático'],
'Bases de datos': ['Diseño de sistemas'],
'Matemáticas': ['Aprendizaje automático'],
'Aprendizaje automático': [],
'Diseño de sistemas': []
}
print(Grafo de dependencias de cursos:)
for course, deps in course_graph.items():
print(f" {course} -> {deps}")
result = topological_sort_kahn(course_graph)
if result:
print(f"\nUn orden factible para estudiar los cursos (ordenamiento topológico) es:)
print(" -> ".join(result))
else:
print("\n¡La planificación de cursos tiene dependencias cíclicas, no se puede ordenar!)
Explicación línea por línea del código:
in_degreeUn diccionario registra el grado de entrada de cada nodo. Al recorrer la lista de adyacencia se puede calcular cuántas aristas apuntan a cada nodo.- Inicializa la cola
queuey agrega todos los nodos que "no tienen tareas previas" (grado de entrada 0). - En el bucle principal, se saca un nodo de la cola y se añade a la lista de resultados
topo_order, lo que equivale a completar esa tarea. - Recorre todos los sucesores (vecinos) de la tarea y resta 1 a su grado de entrada. Si llega a 0, significa que todas las tareas previas de esa tarea se han completado, y se puede agregar a la cola para su ejecución.
- Finalmente, verifica la longitud del resultado ordenado. Si es igual al número de nodos del grafo, es un éxito; de lo contrario, significa que algunos nodos siempre tienen dependencias previas (grado de entrada distinto de 0), es decir, hay un ciclo en el grafo.
Al ejecutar el código anterior, obtendrás un orden de estudio factible:
Diagrama de dependencias de cursos:
  Programación -> ['Estructuras de Datos', 'Algoritmos']
  Estructuras de Datos -> ['Algoritmos', 'Bases de Datos']
  Algoritmos -> ['Aprendizaje Automático']
  Bases de Datos -> ['Diseño de Sistemas']
  Matemáticas -> ['Aprendizaje Automático']
  Aprendizaje Automático -> []
  Diseño de Sistemas -> []

Un orden factible para estudiar los cursos (ordenamiento topológico) es:
Programación -> Matemáticas -> Estructuras de Datos -> Algoritmos -> Bases de Datos -> Aprendizaje Automático -> Diseño de Sistemas
Nota: el resultado del ordenamiento topológico puede no ser único. Por ejemplo, tanto Matemáticas como Programación son nodos iniciales con grado de entrada 0; cualquiera puede ir primero o después.
Comparación de algoritmos y escenarios de aplicación
Para ayudarte a comprender mejor y elegir entre estos algoritmos, la siguiente tabla resume sus características clave:
| Algoritmo | Uso principal | Tipo de grafo aplicable | Idea central | Complejidad temporal (con cola de prioridad) | Casos de uso típicos |
|---|---|---|---|---|---|
| Dijkstra | Camino más corto de una sola fuente | con pesos no negativosgrafos dirigidos/no dirigidos | Codicioso: cada vez expande el nodo más cercano al punto de inicio | O((V+E) log V) | Navegación por mapas, enrutamiento de red |
| Prim | Árbol de expansión mínima (MST) | Grafo no dirigido y conexo con pesos | Codicioso: cada vez incorpora el nodo más cercano al árbol de expansión actual | O((V+E) log V) | Cableado de redes, diseño de placas de circuito, análisis de agrupamiento |
| Kahn (ordenamiento topológico) | Planificación de tareas | Grafo acíclico dirigido (DAG) | Basado en el grado de entrada, elimina repetidamente los nodos sin dependencias previas | O(V+E) | Planificación de cursos, dependencias de sistemas de compilación, orden de compilación |
Práctica de ejercicios
Solo mirar no es suficiente; ¡hay que practicar para dominarlo! Intenta completar los siguientes ejercicios:
Ejercicio 1: Corregir el algoritmo de Dijkstra
El siguiente código pretende implementar el algoritmo de Dijkstra, pero tiene algunos errores. Encuéntralos y corrígelos.
Ejemplo
def wrong_dijkstra(graph, start):
dist = {node: float('inf') for node in graph}
dist[start] = 0
pq = [(0, start)]
while pq:
cur_dist, cur_node = pq.pop(0) # Aquí puede haber un problema
for neighbor, weight in graph[cur_node]:
if cur_dist + weight < dist[neighbor]:
dist[neighbor] = cur_dist + weight
# Aquí puede faltar algo
return dist
Ejercicio 2: Implementar el algoritmo de Kruskal
El algoritmo de Prim es un método para hallar el MST; otro método clásico esel algoritmo de Kruskal. Su idea es:
- Ordena todas las aristas del grafo de menor a mayor peso.
- Considera cada arista en orden; si los dos nodos que conecta esta aristano están en el mismo componente conexo(es decir, si añadirla no forma un ciclo), entonces agrégala al MST.
- Repite el paso 2 hasta que el MST tenga V-1 aristas (V es el número de nodos).
Tu tarea: intenta implementar el algoritmo de Kruskal utilizando la estructura de datos "unión-búsqueda (Disjoint Set Union, DSU)" para determinar de manera eficiente si dos nodos están conectados.
Ejercicio 3: Desafío con datos reales
Supón que tienes unfriendships.jsonarchivo que registra los usuarios (representados por ID) y sus relaciones de amistad en una red social. Cada relación tiene un peso de "cercanía".
[
  {"user_id": 1, "friend_id": 2, "closeness": 5},
  {"user_id": 1, "friend_id": 3, "closeness": 2},
  {"user_id": 2, "friend_id": 3, "closeness": 1},
  {"user_id": 2, "friend_id": 4, "closeness": 6},
  {"user_id": 3, "friend_id": 4, "closeness": 3},
  {"user_id": 4, "friend_id": 5, "closeness": 4}
]
Problema: si el peso de "cercanía" se puede interpretar como distancia (cuanto menor es el valor, más cercana es la relación), calcula desde el usuario1hasta todos los demás usuarios la "ruta más cercana" (es decir, la ruta con la suma de pesos mínima). ¿Qué algoritmo deberías usar? Escribe código para resolverlo.