Ordenamiento rápido aleatorizado
El ordenamiento rápido es uno de los algoritmos de ordenamiento más clásicos en ciencias de la computación, conocido por su complejidad temporal de O(n log n) en el caso promedio. Sin embargo, cuando los datos de entrada ya están ordenados o casi ordenados, el ordenamiento rápido tradicional degrada a una complejidad temporal de O(n²). El ordenamiento rápido aleatorizado resuelve este problema de manera ingeniosa al introducir aleatoriedad.
Antes de profundizar en el ordenamiento rápido aleatorizado, repasemos la idea central del ordenamiento rápido tradicional.
Cómo funciona el ordenamiento rápido
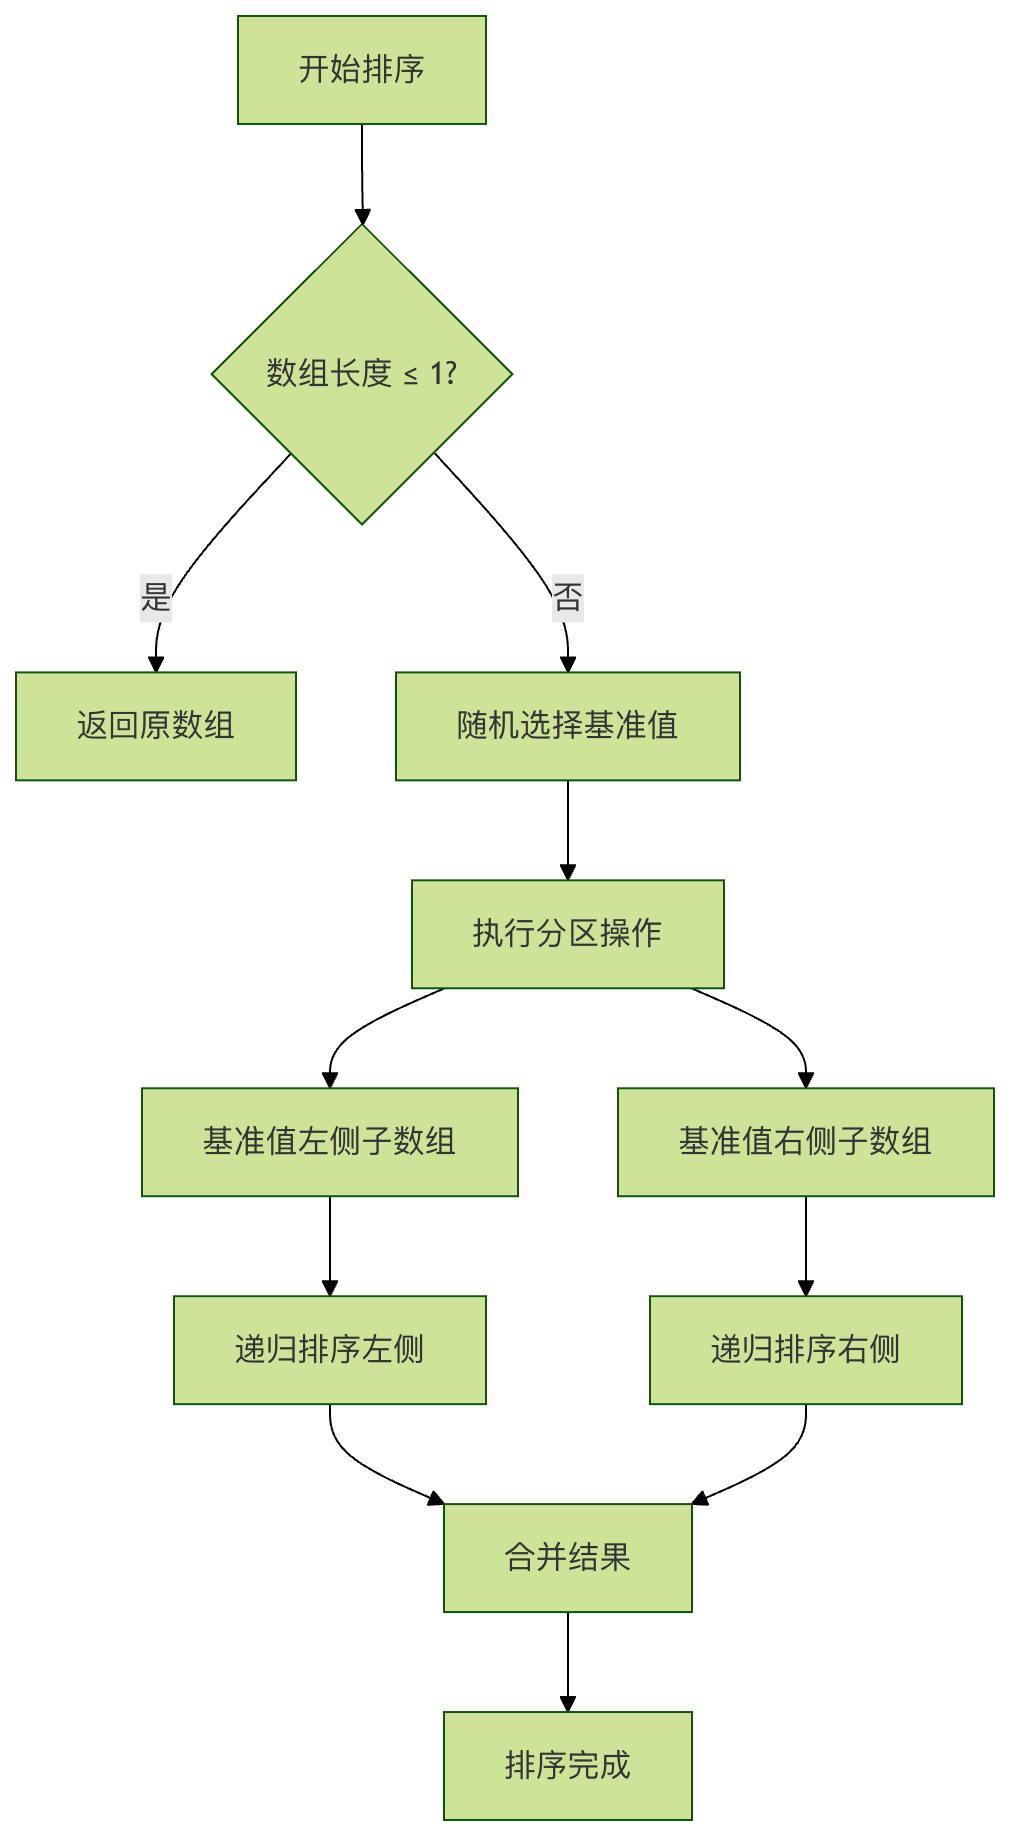
El ordenamiento rápido utilizala estrategia de dividir y conquistar, y sus pasos básicos son los siguientes:
- Seleccionar el valor pivote: elegir un elemento del array como valor pivote
- Operación de partición: reorganizar el array de modo que todos los elementos menores que el pivote se coloquen antes del pivote, y todos los elementos mayores que el pivote se coloquen después del pivote.
- Ordenamiento recursivo: aplicar recursivamente el mismo proceso a los subarrays a ambos lados del pivote.
Problemas del ordenamiento rápido tradicional
El rendimiento del ordenamiento rápido tradicional depende en gran medida de la elección del valor pivote. Cuando el pivote elegido cada vez puede dividir aproximadamente el array en dos partes iguales, el algoritmo es más eficiente. Pero en los siguientes casos, el rendimiento disminuye notablemente:
- Array ya ordenado: si el array ya está ordenado, elegir siempre el último elemento como pivote provoca una partición extremadamente desequilibrada.
- Array en orden inverso: similar al array ya ordenado, pero en dirección opuesta.
- Elementos repetidos: una gran cantidad de elementos repetidos también puede provocar un desequilibrio en la partición.
En estos peores casos, la complejidad temporal del ordenamiento rápido se degrada a O(n²), comparable a algoritmos simples como el ordenamiento de burbuja.
El ordenamiento rápido aleatorizado evita la aparición de los peores casos al introducir aleatoriedad, asegurando que el algoritmo mantenga un buen rendimiento promedio bajo diversas entradas.
La mejora central del ordenamiento rápido aleatorizado es muy simple:Elegir el valor pivote de forma aleatoria, en lugar de elegir fijamente el primero, el último o el elemento del medio. Esta aleatoriedad hace que la probabilidad del peor caso sea extremadamente baja, garantizando así una complejidad temporal esperada de O(n log n).
Idea básica del ordenamiento rápido aleatorizado:Mediante una pasada de ordenamiento, los datos a ordenar se dividen en dos partes independientes, donde todos los datos de una parte son menores que todos los datos de la otra. Luego se aplica el ordenamiento rápido a cada una de estas dos partes por separado; todo el proceso de ordenamiento puede realizarse de forma recursiva, logrando así que todos los datos queden en una secuencia ordenada.
Ventajas del algoritmo
| Característica | Ordenamiento rápido tradicional | Ordenamiento rápido aleatorizado |
|---|---|---|
| Complejidad temporal en el peor caso | O(n²) | O(n²) (pero con probabilidad extremadamente baja) |
| Complejidad temporal en el caso promedio | O(n log n) | O(n log n) |
| Condición para que ocurra el peor caso | Entradas específicas (como arrays ya ordenados) | La selección aleatoria siempre elige exactamente el valor extremo |
| Complejidad espacial | O(log n) (pila de recursión) | O(log n) (pila de recursión) |
| Estabilidad | Inestable | Inestable |
Aunque teóricamente la complejidad temporal en el peor caso del ordenamiento rápido aleatorizado sigue siendo O(n²), en la práctica la probabilidad de que ocurra este peor caso es extremadamente baja. Para un array con n elementos, la probabilidad de que la elección aleatoria del pivote conduzca al peor caso es aproximadamente 1/n!, lo que es prácticamente imposible en la práctica.
Ilustración del proceso
En un array se elige un punto base, por ejemplo el 4 en la primera posición, y luego se mueve el 4 a su posición correcta, de modo que en el subarray anterior los datos sean menores que 4 y en el subarray posterior los datos sean mayores que 4. Después se continúa recursivamente hasta completar todo el ordenamiento.
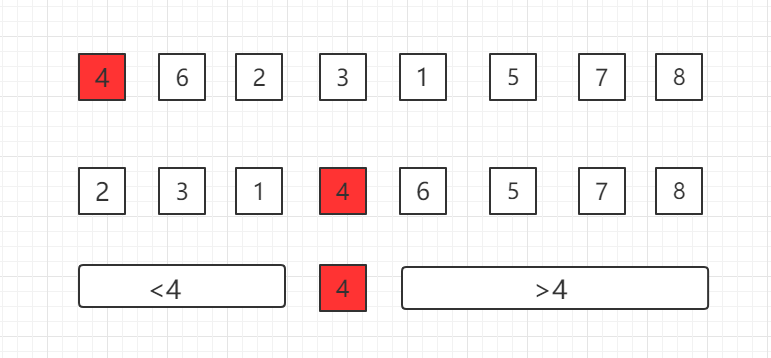
Cómo mover el dato del punto base seleccionado a su posición correcta es el núcleo del ordenamiento rápido; lo llamamos Partición (Partition).
El proceso se muestra a continuación, dondeies la posición del elemento actualmente comparado durante el recorrido:
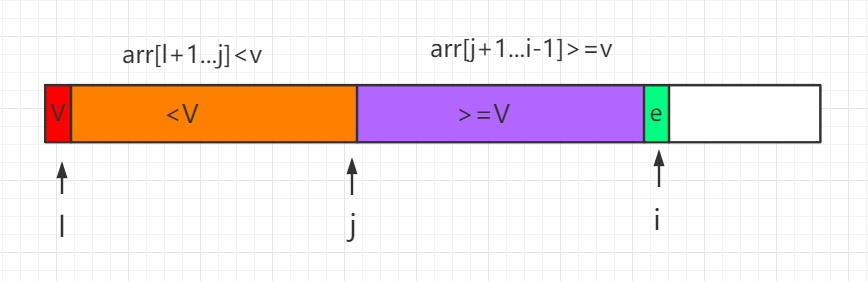
Este proceso de partición se expresa en código como:
Ejemplo
private static int partition(Comparable[] arr, int l, int r){
Comparable v = arr[l];
int j = l;
for( int i = l + 1 ; i <= r ; i ++ )
if( arr[i].compareTo(v) < 0 ){
j ++;
// Intercambio de posiciones de elementos del array
swap(arr, j, i);
}
swap(arr, l, j);
return j;
}
...
Si se aplica el ordenamiento rápido a un array casi ordenado, el tamaño de los subarrays después de cada partición es extremadamente desequilibrado, y es fácil que degrade aO(n^2)un algoritmo de complejidad temporal O(n²). Necesitamos optimizar el código anterior eligiendo aleatoriamente un punto base como referencia; esto se llama algoritmo de ordenamiento rápido aleatorizado. Solo necesitamos añadir la siguiente línea antes del código anterior para intercambiar aleatoriamente un dato del array con el dato del punto base.
swap( arr, l , (int)(Math.random()*(r-l+1))+l );
Código de ejemplo en Java
Descarga del paquete de código fuente:Download
Código del archivo QuickSort.java:
/**
* Ordenamiento rápido aleatorizado
*/
public class QuickSort {
// Realizar la operación de partición en la parte arr[l...r]
// Devolver p, tal que arr[l...p-1] < arr[p] ; arr[p+1...r] > arr[p]
private static int partition(Comparable[] arr, int l, int r){
// Elegir aleatoriamente un valor como pivote dentro del rango arr[l...r]
swap( arr, l , (int)(Math.random()*(r-l+1))+l );
Comparable v = arr[l];
// arr[l+1...j] < v ; arr[j+1...i) > v
int j = l;
for( int i = l + 1 ; i <= r ; i ++ )
if( arr[i].compareTo(v) < 0 ){
j ++;
swap(arr, j, i);
}
swap(arr, l, j);
return j;
}
// Usar recursivamente el ordenamiento rápido para ordenar el rango arr[l...r]
private static void sort(Comparable[] arr, int l, int r){
if (l >= r) {
return;
}
int p = partition(arr, l, r);
sort(arr, l, p-1 );
sort(arr, p+1, r);
}
public static void sort(Comparable[] arr){
int n = arr.length;
sort(arr, 0, n-1);
}
private static void swap(Object[] arr, int i, int j) {
Object t = arr[i];
arr[i] = arr[j];
arr[j] = t;
}
// Probar QuickSort
public static void main(String[] args) {
// Quick Sort es también un algoritmo de complejidad O(n log n)
// Puede manejar fácilmente datos del orden de 1 millón en menos de 1 segundo
int N = 1000000;
Integer[] arr = SortTestHelper.generateRandomArray(N, 0, 100000);
sort(arr);
SortTestHelper.printArray(arr);
}
}
Implementación del ordenamiento rápido aleatorizado
Implementación en Python
Ejemplo
def randomized_quick_sort(arr, low=None, high=None):
"""
Función principal del ordenamiento rápido aleatorizado
Parámetros:
arr: la lista a ordenar
low: índice inicial del subarray (por defecto 0)
high: índice final del subarray (por defecto len(arr)-1)
Retorna:
la lista ordenada (ordenamiento in situ; también devuelve la lista ordenada)
"""
# Establecer parámetros predeterminados
if low is None:
low = 0
if high is None:
high = len(arr) - 1
# Condición de terminación recursiva: longitud del subarray menor o igual a 1
if low < high:
# Elegir aleatoriamente el pivote y particionar
pivot_index = randomized_partition(arr, low, high)
# Ordenar recursivamente los subarrays izquierdo y derecho
randomized_quick_sort(arr, low, pivot_index - 1)
randomized_quick_sort(arr, pivot_index + 1, high)
return arr
def randomized_partition(arr, low, high):
"""
Función de partición aleatoria
Parámetros:
arr: la lista a particionar
low: índice inicial del subarray
high: índice final del subarray
Retorna:
índice de la posición final del valor pivote
"""
# Elegir aleatoriamente un índice como posición del pivote
random_index = random.randint(low, high)
# Intercambiar el elemento elegido aleatoriamente con el último elemento
arr[random_index], arr[high] = arr[high], arr[random_index]
# Usar el último elemento (ahora el elemento elegido aleatoriamente) como valor pivote
return partition(arr, low, high)
def partition(arr, low, high):
"""
Función de partición (igual que en el ordenamiento rápido)
Parámetros:
arr: la lista a particionar
low: índice inicial del subarray
high: índice final del subarray
Retorna:
índice de la posición final del valor pivote
"""
pivot = arr[high] # Valor pivote
i = low - 1 # Límite de la región menor que el pivote
for j in range(low, high):
if arr[j] <= pivot:
i += 1
# Intercambiar elementos
arr[i], arr[j] = arr[j], arr[i]
# Colocar el pivote en la posición correcta
arr[i + 1], arr[high] = arr[high], arr[i + 1]
return i + 1
# Datos de prueba
test_data = [3, 6, 8, 10, 1, 2, 1]
print("Array original:", test_data)
print("Array ordenado:", randomized_quick_sort(test_data.copy()))
Análisis de complejidad temporal
La complejidad temporal del ordenamiento rápido aleatorizado se puede expresar mediante la siguiente fórmula:
\[ T(n) = O(n) + T(k) + T(n - k - 1) \]
donde:
- \( O(n) \) es el tiempo de la operación de partición
- \( T(k) \) es el tiempo de ordenar el subarray izquierdo
- \( T(n - k - 1) \) es el tiempo de ordenar el subarray derecho
- \( k \) es el número de elementos a la izquierda del valor pivote
En la versión aleatorizada, el valor esperado de \( k \) es \( n/2 \), por lo tanto, la complejidad temporal esperada es:
\[ E[T(n)] = O(n \log n) \]
Variantes y optimizaciones del ordenamiento rápido aleatorizado
1. Ordenamiento rápido de tres vías
Cuando el array contiene muchos elementos repetidos, el ordenamiento rápido tradicional de dos vías no es eficiente. El ordenamiento rápido de tres vías divide el array en tres partes: menor que el pivote, igual al pivote y mayor que el pivote.
Ejemplo
"""Ordenamiento rápido aleatorizado de tres vías"""
if low is None:
low = 0
if high is None:
high = len(arr) - 1
if low < high:
# Elegir aleatoriamente el valor pivote
random_index = random.randint(low, high)
arr[random_index], arr[low] = arr[low], arr[random_index]
pivot = arr[low]
# Partición de tres vías
lt = low # Límite de la región menor que el pivote
gt = high # Límite de la región mayor que el pivote
i = low + 1 # Elemento actualmente examinado
while i <= gt:
if arr[i] < pivot:
arr[lt], arr[i] = arr[i], arr[lt]
lt += 1
i += 1
elif arr[i] > pivot:
arr[i], arr[gt] = arr[gt], arr[i]
gt -= 1
else:
i += 1
# Ordenar recursivamente las partes menor y mayor que el pivote
randomized_three_way_quick_sort(arr, low, lt - 1)
randomized_three_way_quick_sort(arr, gt + 1, high)
return arr
# Probar datos con elementos duplicados
test_data_with_duplicates = [3, 6, 3, 8, 1, 3, 6, 1]
print("Matriz original (con elementos duplicados):", test_data_with_duplicates)
print("Después de la ordenación rápida de tres vías:", randomized_three_way_quick_sort(test_data_with_duplicates.copy()))
2. Optimización para arrays pequeños
Para arreglos muy pequeños (generalmente menos de 10-20 elementos), la ordenación por inserción puede ser más eficiente que la ordenación rápida. Podemos combinar las ventajas de ambos algoritmos:
Ejemplo
"""Ordenación rápida aleatorizada optimizada: usa ordenación por inserción para arreglos pequeños"""
if low is None:
low = 0
if high is None:
high = len(arr) - 1
# Usar ordenación por inserción para arreglos pequeños
if high - low + 1 <= threshold:
insertion_sort(arr, low, high)
return arr
if low < high:
pivot_index = randomized_partition(arr, low, high)
optimized_randomized_quick_sort(arr, low, pivot_index - 1, threshold)
optimized_randomized_quick_sort(arr, pivot_index + 1, high, threshold)
return arr
def insertion_sort(arr, low, high):
"""Ordenación por inserción, para ordenar arreglos pequeños"""
for i in range(low + 1, high + 1):
key = arr[i]
j = i - 1
while j >= low and arr[j] > key:
arr[j + 1] = arr[j]
j -= 1
arr[j + 1] = key
# Probar la optimización de arreglos pequeños
small_test_data = [9, 3, 7, 1, 5, 2, 8, 4, 6]
print("Arreglo pequeño original:", small_test_data)
print("Después de la ordenación optimizada:", optimized_randomized_quick_sort(small_test_data.copy(), threshold=5))
Comparación de rendimiento y recomendaciones prácticas
Pruebas de rendimiento
Comparemos el rendimiento de diferentes algoritmos de ordenación mediante pruebas reales:
Ejemplo
import random as rand
def performance_test():
"""Pruebas de rendimiento: comparar el tiempo de ejecución de diferentes algoritmos de ordenación"""
algorithms = {
"Ordenación rápida aleatorizada": randomized_quick_sort,
"Ordenación rápida de tres vías": randomized_three_way_quick_sort,
"Ordenación rápida optimizada": optimized_randomized_quick_sort,
}
# Generar datos de prueba
test_sizes = [100, 1000, 10000]
for size in test_sizes:
print(f"\nTamaño del arreglo de prueba: {size}")
# Generar diferentes tipos de datos de prueba
test_cases = {
"Datos aleatorios": [rand.randint(0, 10000) for _ in range(size)],
"Datos ordenados": list(range(size)),
"Datos en orden inverso": list(range(size, 0, -1)),
"Datos con muchos duplicados": [rand.randint(0, 10) for _ in range(size)],
}
for case_name, test_data in test_cases.items():
print(f" {case_name}:")
for algo_name, algo_func in algorithms.items():
data_copy = test_data.copy()
start_time = time.time()
algo_func(data_copy)
end_time = time.time()
execution_time = (end_time - start_time) * 1000 # Convertir a milisegundos
print(f" {algo_name}: {execution_time:.2f} ms")
# Ejecutar pruebas de rendimiento (nota: para arreglos grandes, esto puede tomar algo de tiempo)
# performance_test()