Problèmes dérivés des algorithmes de tri
Une fois que nous maîtrisons les algorithmes de tri de base tels que le tri à bulles et le tri rapide, nous réalisons que le tri ne consiste pas seulement à mettre les données dans l'ordre.
Dans la programmation réelle et les entretiens, de nombreux problèmes sont des variantes ou des problèmes dérivés des algorithmes de tri.
Comprendre ces problèmes dérivés peut nous aider à saisir plus profondément l’essence des algorithmes de tri et à améliorer notre capacité à résoudre des problèmes complexes.
Cet article explorera plusieurs problèmes dérivés classiques des algorithmes de tri, vous aidant à construire une pensée algorithmique plus systématique en analysant leurs idées centrales, leurs solutions et leurs applications pratiques.
Que sont les problèmes dérivés des algorithmes de tri ?
Les problèmes dérivés des algorithmes de tri désignent ceuxqui ne nécessitent pas directement un trimais dont les idées centrales, le déroulement de l’algorithme ou les structures de données utilisées pour résoudre les problèmes sont étroitement liés aux algorithmes de tri classiques.Hautement pertinentsproblèmes.
De tels problèmes présentent généralement les caractéristiques suivantes :
- Objectifs différents: le but ultime n’est pas de produire une séquence ordonnée
- Idées courantesUtiliser des idées centrales du tri, telles que la comparaison, l’échange et diviser pour régner.
- Liés à la complexitéLa complexité temporelle est souvent du même ordre de grandeur que celle des algorithmes de tri.
- Largement utilisés: fréquemment rencontrés dans le développement réel
Ci-dessous, approfondissons notre compréhension à travers plusieurs problèmes concrets.
Variante classique du problème 1 : problème Top K
Définition du problème
Find from n elementsles K plus grands (ou plus petits) éléments。
Scénarios d'application pratiques:
- Site de commerce électronique : trouver les 10 produits les plus vendus
- Réseau social : trouver les 100 utilisateurs ayant le plus d'abonnés
- Analyse de données : trouver les 5 pages les plus visitées
Comparaison des solutions
| Méthodes | Complexité temporelle | Complexité spatiale | Scénarios applicables |
|---|---|---|---|
| Trier directement et prendre les K premiers | O(n log n) | O(1) ou O(n) | Lorsque K est proche de n |
| Tri à bulles K fois | O(n × K) | O(1) | K est très petit (K < 10) |
| Tas min / Tas max | O(n log K) | O(K) | Le plus couramment utilisé, K est bien plus petit que n |
| Algorithme Quickselect | O(n) en moyenne, O(n²) dans le pire des cas | O(1) | L'ordre complet n'est pas nécessaire ; seul le Top K est requis. |
Méthode 1 : Quickselect basé sur l'idée du tri rapide
L'algorithme quickselect est une variante du tri rapide. Il n'a pas besoin de trier complètement tout le tableau ; il doit seulement trouver la position du K-ième plus grand élément.
Exemple
"""
Utilisez l'algorithme quickselect pour trouver le k-ième plus petit élément
nums : tableau d'entrée
k : le k-ième plus petit élément à trouver (base 1)
Retour : la valeur du k-ième plus petit élément
"""
def partition(left, right, pivot_idx):
"""Fonction de partition qui divise le tableau en deux parties : les éléments inférieurs au pivot et les éléments supérieurs au pivot"""
pivot = nums[pivot_idx]
# Déplacer le pivot à la fin
nums[pivot_idx], nums[right] = nums[right], nums[pivot_idx]
store_idx = left
for i in range(left, right):
if nums[i] < pivot:
nums[store_idx], nums[i] = nums[i], nums[store_idx]
store_idx += 1
# Déplacer le pivot à sa position correcte
nums[right], nums[store_idx] = nums[store_idx], nums[right]
return store_idx
def select(left, right, k_smallest):
"""Fonction principale de sélection"""
if left == right:
return nums[left]
# Sélectionner aléatoirement un pivot
pivot_idx = left + (right - left) // 2
# Partitionner et obtenir la position finale du pivot
pivot_idx = partition(left, right, pivot_idx)
# Le pivot est exactement le k-ième plus petit élément
if k_smallest == pivot_idx:
return nums[k_smallest]
# Le k-ième plus petit élément se trouve dans la moitié gauche
elif k_smallest < pivot_idx:
return select(left, pivot_idx - 1, k_smallest)
# Le k-ième plus petit élément se trouve dans la moitié droite
else:
return select(pivot_idx + 1, right, k_smallest)
# k-1 car l'indexation à partir de 0 est utilisée en interne
return select(0, len(nums) - 1, k - 1)
def find_top_k(nums, k, largest=True):
"""
Trouver les k plus grands éléments
nums : tableau d'entrée
k : nombre d'éléments à trouver
largest : True pour trouver les k plus grands, False pour trouver les k plus petits
Renvoie : la liste des k plus grands éléments
"""
n = len(nums)
if k >= n:
return sorted(nums, reverse=largest)
if largest:
# Trouver les k plus grands éléments = trouver le (n-k+1)-ième plus petit élément
kth_value = quick_select(nums, n - k + 1)
# Collecter tous les éléments supérieurs ou égaux à kth_value
result = [x for x in nums if x > kth_value]
# Si le compte est insuffisant, ajouter des éléments égaux
while len(result) < k:
result.append(kth_value)
return result
else:
# Trouver les k plus petits éléments = trouver le k-ième plus petit élément
kth_value = quick_select(nums, k)
result = [x for x in nums if x < kth_value]
while len(result) < k:
result.append(kth_value)
return result
# Données de test
test_data = [3, 2, 1, 5, 6, 4, 9, 8, 7, 0]
print("Données d'origine :", test_data)
print("Les 3 plus grands éléments :", find_top_k(test_data.copy(), 3, largest=True))
print("Les 3 plus petits éléments :", find_top_k(test_data.copy(), 3, largest=False))
Méthode 2 : Solution basée sur le tri par tas
Un tas est une structure de données classique pour résoudre le problème Top K, particulièrement adapté aux scénarios de flux de données.
Exemple
def find_top_k_with_heap(nums, k, largest=True):
"""
Utiliser un tas pour trouver les k plus grands éléments
nums : tableau d'entrée
k : nombre d'éléments à trouver
largest : True pour trouver les k plus grands, False pour trouver les k plus petits
Renvoie : la liste des k plus grands éléments
"""
if largest:
# Trouver les k plus grands éléments : utiliser un tas min
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, num)
elif num > heap[0]: # L'élément actuel est plus grand que le sommet du tas
heapq.heapreplace(heap, num)
return sorted(heap, reverse=True)
else:
# Trouver les k plus petits éléments : utiliser un tas-max (implémenté en prenant les négatifs)
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, -num) # Stocker les négatifs
elif num < -heap[0]: # L'élément actuel est plus petit que le sommet du tas
heapq.heapreplace(heap, -num)
return sorted([-x for x in heap])
# Tester la méthode du tas
print("\nUtilisation de la méthode du tas :")
print("Les 3 plus grands éléments :", find_top_k_with_heap(test_data, 3, largest=True))
print("Les 3 plus petits éléments :", find_top_k_with_heap(test_data, 3, largest=False))
Problème dérivé classique 2 : Compter les inversions
Définition du problème
Dans un tableau, si un élément antérieur est supérieur à un élément postérieur, alors ces deux éléments forment uneinversionCalculez le nombre total d'inversions dans le tableau.
Scénarios d'application pratiques:
- Mesurer le degré d'ordre dans les données
- Analyse des préférences des utilisateurs dans les systèmes de recommandation
- Détection des conflits de modification dans les systèmes de contrôle de version
Solution : algorithme basé sur le tri fusion
Pendant le processus de tri fusion, le nombre de paires d'inversions peut être naturellement compté. C'est une application typique de l'idée de diviser pour régner.
Exemple
"""
Compter le nombre d'inversions dans un tableau
Utiliser une approche basée sur le tri fusion
"""
def merge_sort_count(left, right):
"""Tri fusion et comptage des inversions"""
if left >= right:
return 0, [nums[left]] if left == right else []
mid = (left + right) // 2
# Compter récursivement les inversions dans les parties gauche et droite
left_count, left_arr = merge_sort_count(left, mid)
right_count, right_arr = merge_sort_count(mid + 1, right)
# Compter les inversions qui traversent le milieu
cross_count = 0
merged = []
i = j = 0
while i < len(left_arr) and j < len(right_arr):
if left_arr[i] <= right_arr[j]:
merged.append(left_arr[i])
i += 1
else:
# left_arr[i] > right_arr[j] constitue une inversion
merged.append(right_arr[j])
cross_count += len(left_arr) - i # Clé : tous les éléments restants à gauche forment des inversions avec right_arr[j]
j += 1
# Ajouter les éléments restants
merged.extend(left_arr[i:])
merged.extend(right_arr[j:])
total_count = left_count + right_count + cross_count
return total_count, merged
if not nums:
return 0
count, _ = merge_sort_count(0, len(nums) - 1)
return count
# Test du nombre d'inversions
test_cases = [
([1, 2, 3, 4, 5], 0), # Entièrement ordonné, le nombre d'inversions est 0
([5, 4, 3, 2, 1], 10), # Entièrement inversé, le nombre d'inversions est C(5,2)=10
([2, 4, 1, 3, 5], 3), # Exemple
([7, 5, 6, 4], 5), # Exemple complexe
]
print("\nTest du nombre d'inversions :")
for nums, expected in test_cases:
result = count_inversions(nums.copy())
print(f"Tableau {nums} : valeur calculée={result}, valeur attendue={expected}, {'Correct' if result == expected else 'Faux'}")
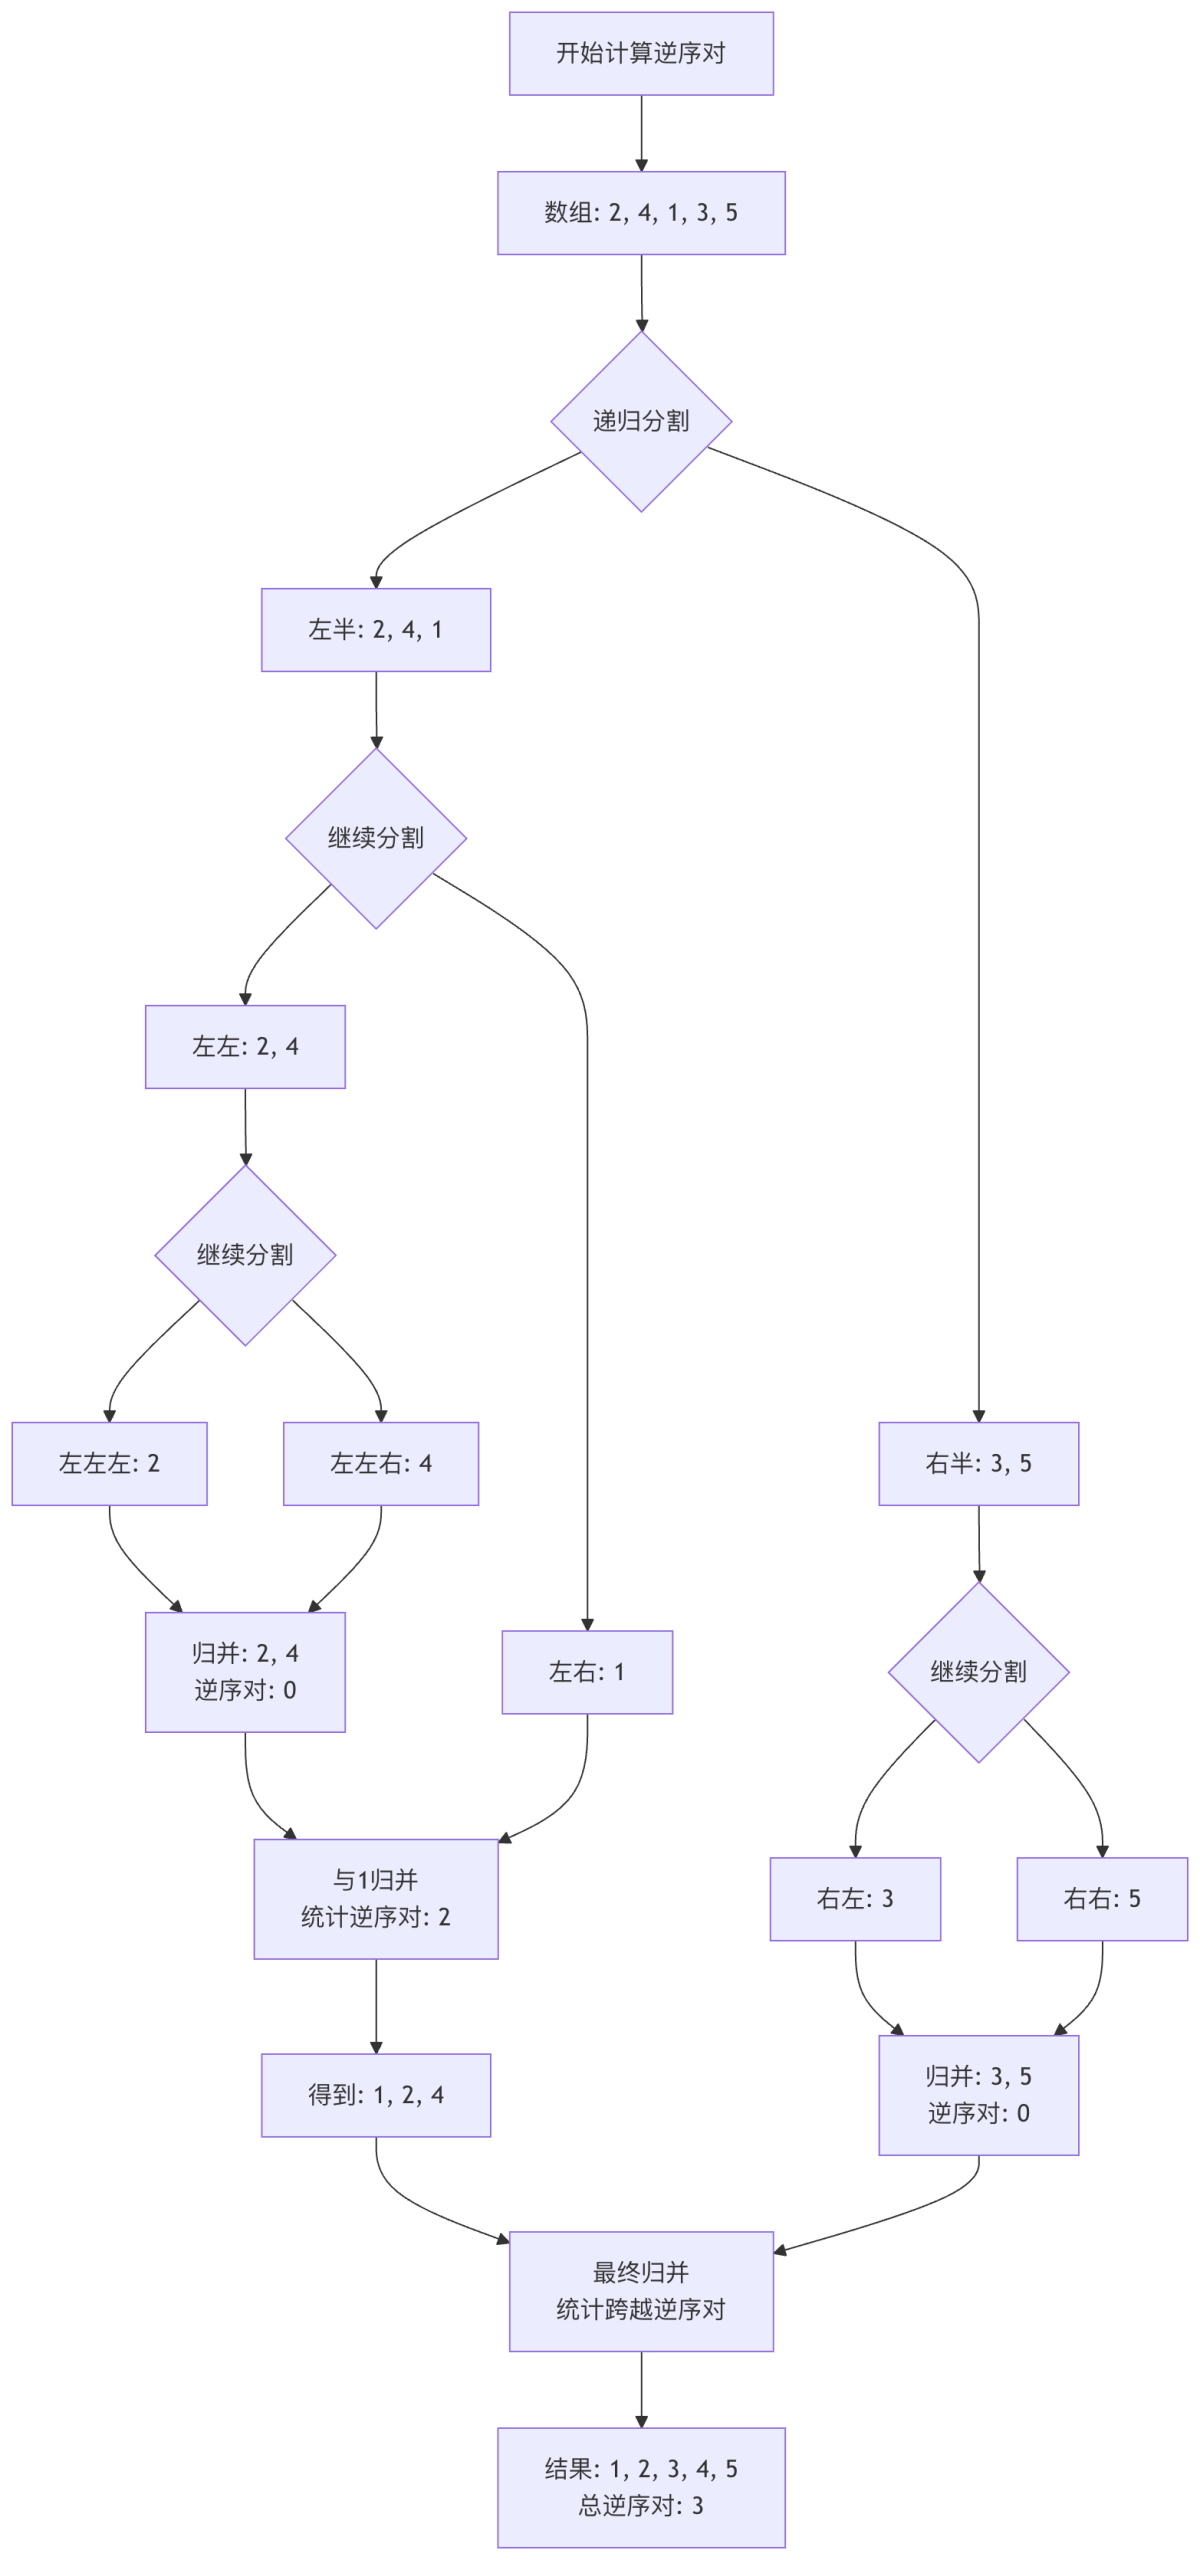
La figure ci-dessous montre comment compter les paires d'inversions pendant le processus de tri par fusion. Le point clé est :Lorsqu'un élément de la moitié droite est plus petit qu'un élément de la moitié gauche, tous les éléments restants de la moitié gauche forment des paires d'inversions avec cet élément de la moitié droite.。
Problème classique de variante 3 : K-ième plus grand / K-ième plus petit élément
Ce problème est un cas particulier du problème Top K, mais ses solutions sont plus variées.
Comparaison de plusieurs solutions
| Méthodes | Complexité temporelle | Complexité spatiale | Fonctionnalités |
|---|---|---|---|
| Prendre directement après tri | O(n log n) | O(1) ou O(n) | Le plus simple et le plus intuitif |
| Quickselect | O(n) en moyenne | O(1) | Complexité moyenne optimale |
| Méthode par tas | O(n log k) | O(k) | Adapté aux flux de données |
| Tri par comptage | O(n + m) | O(m) | Adapté aux cas où la plage de données est petite |
Exemple d'implémentation complet
Exemple
"""Trouver le k-ième plus petit élément (indexé à partir de 1)"""
# Méthode 1 : tri direct
def method_sort():
return sorted(nums)[k-1]
# Méthode 2 : Quickselect (implémentée ci-dessus)
def method_quick_select():
return quick_select(nums.copy(), k)
# Méthode 3 : méthode du tas
def method_heap():
# Utiliser un tas max pour trouver le k-ième plus petit
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, -num) # Le tas max est implémenté à l'aide de nombres négatifs
elif num < -heap[0]:
heapq.heapreplace(heap, -num)
return -heap[0]
# Méthode 4 : tri par comptage (convient aux petites plages de données)
def method_counting():
if not nums:
return None
# Trouver la plage de données
min_val, max_val = min(nums), max(nums)
range_size = max_val - min_val + 1
# Comptage
count = [0] * range_size
for num in nums:
count[num - min_val] += 1
# Trouver le k-ième plus petit
accumulated = 0
for i in range(range_size):
accumulated += count[i]
if accumulated >= k:
return i + min_val
return None
# Vérifier que toutes les méthodes produisent des résultats cohérents
result1 = method_sort()
result2 = method_quick_select()
result3 = method_heap()
result4 = method_counting()
print(f"\ntest de recherche du {k}-ième plus petit élément (Tableau : {nums}) :")
print(f"Méthode de tri : {result1}")
print(f"Quickselect : {result2}")
print(f"Méthode par tas : {result3}")
print(f"Méthode de comptage : {result4}")
# Vérifier la cohérence
assert result1 == result2 == result3 == result4, "Les différentes méthodes donnent des résultats incohérents !"
return result1
# Données de test
test_nums = [3, 2, 3, 1, 2, 4, 5, 5, 6]
for k in [1, 3, 5, 7]:
find_kth_smallest(test_nums.copy(), k)
Problème dérivé classique 4 : Fusion d'intervalles
Définition du problème
Étant donné un ensemble d'intervalles, fusionner tous les intervalles qui se chevauchent.
Scénarios d'application pratiques:
- Fusion de périodes temporelles dans les applications de calendrier
- Planification temporelle des tâches en gestion de projet
- Fusion de segments d'adresses IP réseau
Solution : tri + parcours linéaire
Exemple
"""
Fusionner les intervalles qui se chevauchent
intervals : une liste de listes, chaque sous-liste représente un intervalle [start, end]
Retourne : la liste fusionnée des intervalles
"""
if not intervals:
return []
# Étape clé 1 : trier les intervalles par point de départ
intervals.sort(key=lambda x: x[0])
merged = []
# Étape clé 2 : parcours linéaire et fusion
current_start, current_end = intervals[0]
for interval in intervals[1:]:
start, end = interval
if start <= current_end: # Chevauchement
# Fusionner les intervalles : prendre le point de fin le plus grand
current_end = max(current_end, end)
else: # Pas de chevauchement
# Enregistrer l'intervalle courant
merged.append([current_start, current_end])
# Démarrer un nouvel intervalle
current_start, current_end = start, end
# Ajouter le dernier intervalle
merged.append([current_start, current_end])
return merged
# Tester la fusion d'intervalles
test_intervals = [
[[1, 3], [2, 6], [8, 10], [15, 18]],
[[1, 4], [4, 5]],
[[1, 4], [0, 4]],
[[1, 4], [2, 3]], # Entièrement contenu
[[1, 4], [0, 2], [3, 5]], # Cas complexe
]
print("\nTest de fusion d'intervalles :")
for i, intervals in enumerate(test_intervals, 1):
result = merge_intervals(intervals.copy())
print(f"Cas de test {i} :")
print(f" Entrée : {intervals}")
print(f" Sortie : {result}")
print()
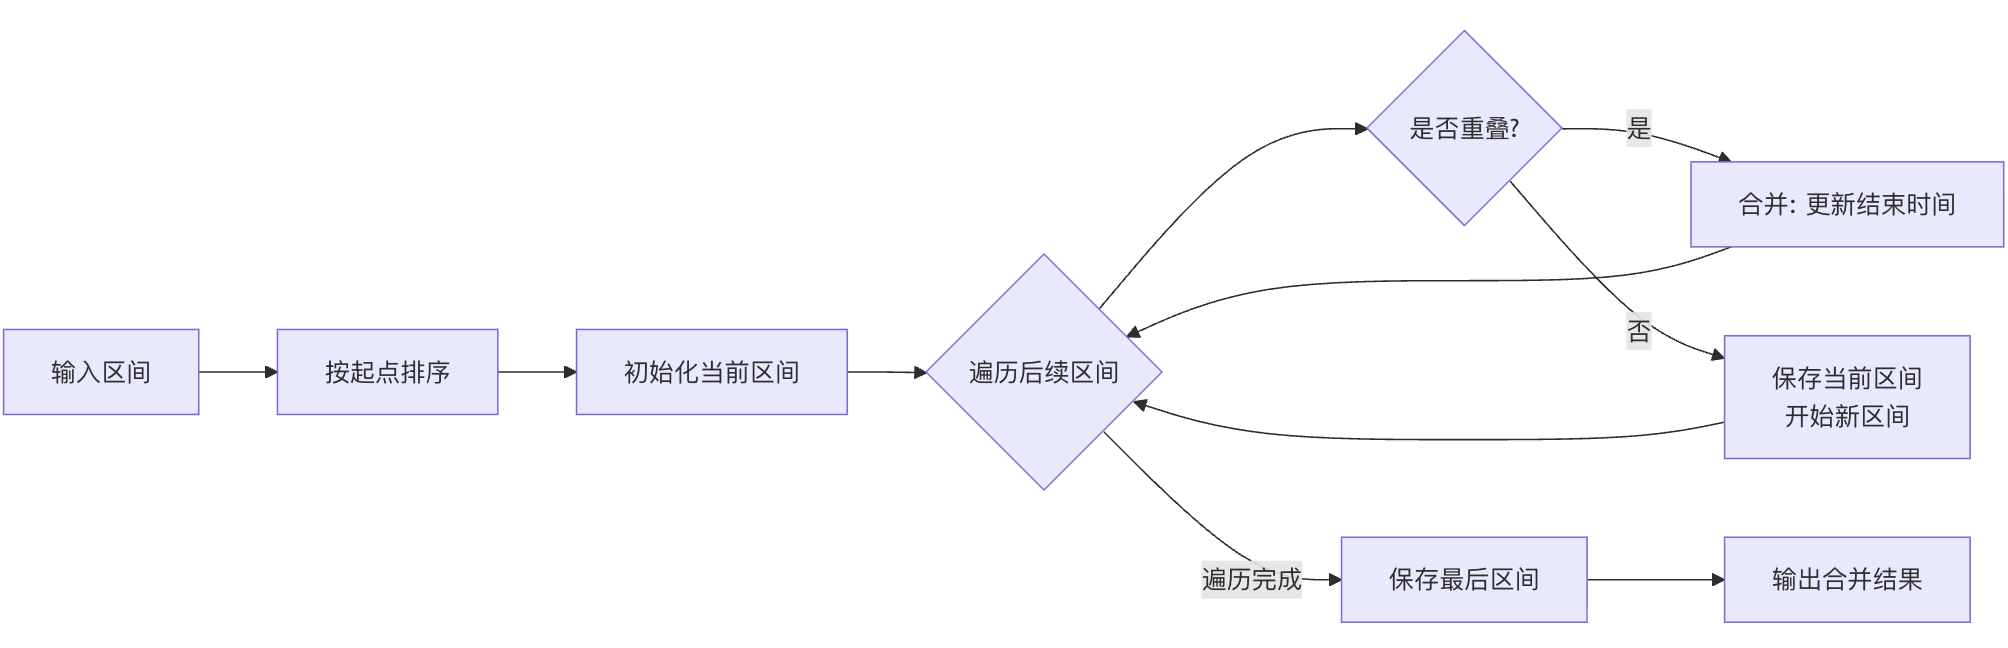
Analyse du processus de l'algorithme
Exercices pratiques
Maintenant, renforçons ce que nous avons appris avec quelques exercices :
Exercice 1 : Trier les couleurs (problème du drapeau national néerlandais)
Étant donné un tableau contenant n éléments qui sont rouges, blancs ou bleus, triez-les sur place de sorte que les éléments de même couleur soient adjacents et soient disposés dans l'ordre rouge, blanc et bleu.
Exemple
"""
Trier le tableau de couleurs sur place
0: rouge, 1: blanc, 2: bleu
Utiliser la méthode des trois pointeurs (similaire à l'idée de partition du tri rapide)
"""
# Initialiser trois pointeurs
left = 0 # Limite droite de la zone rouge
current = 0 # Élément actuel en cours de vérification
right = len(nums) - 1 # Limite gauche de la zone bleue
while current <= right:
if nums[current] == 0: # Rouge
nums[left], nums[current] = nums[current], nums[left]
left += 1
current += 1
elif nums[current] == 1: # Blanc
current += 1
else: # Bleu
nums[current], nums[right] = nums[right], nums[current]
right -= 1
# Remarque : ne pas incrémenter current ici, car l'élément échangé n'a pas encore été vérifié
return nums
# Test
colors = [2, 0, 2, 1, 1, 0]
print("Avant de trier les couleurs :", colors)
print("Après le tri des couleurs :", sort_colors(colors.copy()))
Exercice 2 : k-ième plus grand élément dans un tableau
Trouver le k-ième plus grand élément dans un tableau non trié.
Exemple
"""
Trouver le k-ième plus grand élément
Utiliser l'algorithme quickselect
"""
# Le k-ième plus grand = le (n-k+1)-ième plus petit
k_smallest = len(nums) - k + 1
def quick_select(arr, left, right, k_small):
if left == right:
return arr[left]
# Choisir un pivot
pivot_idx = (left + right) // 2
pivot = arr[pivot_idx]
# Partition
arr[pivot_idx], arr[right] = arr[right], arr[pivot_idx]
store_idx = left
for i in range(left, right):
if arr[i] < pivot:
arr[store_idx], arr[i] = arr[i], arr[store_idx]
store_idx += 1
arr[right], arr[store_idx] = arr[store_idx], arr[right]
# Sélection récursive
if k_small == store_idx:
return arr[store_idx]
elif k_small < store_idx:
return quick_select(arr, left, store_idx - 1, k_small)
else:
return quick_select(arr, store_idx + 1, right, k_small)
return quick_select(nums.copy(), 0, len(nums) - 1, k_smallest - 1)
# Test
test_array = [3, 2, 1, 5, 6, 4]
k = 2
print(f"\nle {k}-ième plus grand élément du tableau {test_array} est : {find_kth_largest(test_array, k)})