Abgeleitete Probleme zu Sortieralgorithmen
Sobald wir grundlegende Sortieralgorithmen wie Bubblesort und Quicksort beherrschen, werden wir erkennen, dass es beim Sortieren nicht nur darum geht, Daten in eine Reihenfolge zu bringen.
In der realen Programmierung und in Vorstellungsgesprächen sind viele Probleme Varianten oder abgeleitete Probleme von Sortieralgorithmen.
Das Verständnis dieser abgeleiteten Probleme kann uns helfen, das Wesen von Sortieralgorithmen tiefer zu erfassen und unsere Fähigkeit zur Lösung komplexer Probleme zu verbessern.
Dieser Artikel untersucht mehrere klassische abgeleitete Probleme von Sortieralgorithmen und hilft Ihnen, durch die Analyse ihrer Kernideen, Lösungen und praktischen Anwendungen ein systematischeres algorithmisches Denken aufzubauen.
Was sind abgeleitete Probleme von Sortieralgorithmen?
Von Sortieralgorithmen abgeleitete Probleme sind solche,die nicht direkt das Sortieren erfordern,aber deren Kernideen, Algorithmusablauf oder zur Problemlösung verwendete Datenstrukturen eng mit klassischen Sortieralgorithmen verwandt sind.Hochgradig relevanteProbleme.
Solche Probleme weisen typischerweise die folgenden Merkmale auf:
- Andere Ziele: Das endgültige Ziel ist nicht die Ausgabe einer geordneten Sequenz
- Übliche IdeenVerwenden von Kernideen aus dem Sortieren, wie Vergleich, Vertauschen und Teile-und-Herrsche.
- KomplexitätsbezogenDie Zeitkomplexität liegt oft in derselben Größenordnung wie bei Sortieralgorithmen.
- Weit verbreitet: häufig in der tatsächlichen Entwicklung anzutreffen
Im Folgenden wollen wir anhand einiger konkreter Probleme ein tieferes Verständnis gewinnen.
Klassisches Variantenproblem 1: Top-K-Problem
Problemdefinition
Finde aus n Elementendie K größten (oder kleinsten) Elemente。
Praktische Anwendungsszenarien:
- E-Commerce-Website: die 10 meistverkauften Produkte finden
- Soziales Netzwerk: die 100 Nutzer mit den meisten Followern finden
- Datenanalyse: die 5 meistbesuchten Seiten finden
Vergleich der Lösungen
| Methoden | Zeitkomplexität | Speicherkomplexität | Anwendbare Szenarien |
|---|---|---|---|
| Direkt sortieren und die ersten K nehmen | O(n log n) | O(1) oder O(n) | Wenn K nahe bei n liegt |
| Bubble Sort K-mal | O(n × K) | O(1) | K ist sehr klein (K < 10) |
| Min-Heap / Max-Heap | O(n log K) | O(K) | Am häufigsten verwendet, K ist viel kleiner als n |
| Quickselect-Algorithmus | O(n) im Durchschnitt, O(n²) im schlechtesten Fall | O(1) | Eine vollständige Sortierung ist nicht erforderlich; nur die Top K werden benötigt. |
Methode 1: Quickselect basierend auf der Idee von Quicksort
Der Quickselect-Algorithmus ist eine Variante von Quicksort. Er muss nicht das gesamte Array vollständig sortieren; er muss nur die Position des K-ten größten Elements finden.
Beispiel
"""
Verwende den Quickselect-Algorithmus, um das k-te kleinste Element zu finden
nums: Eingabe-Array
k: das k-te kleinste zu findende Element (1-basiert)
Rückgabe: der Wert des k-kleinsten Elements
"""
def partition(left, right, pivot_idx):
"""Partitionsfunktion, die das Array in zwei Teile aufteilt: kleiner als und größer als das Pivot"""
pivot = nums[pivot_idx]
# Verschiebe das Pivot an das Ende
nums[pivot_idx], nums[right] = nums[right], nums[pivot_idx]
store_idx = left
for i in range(left, right):
if nums[i] < pivot:
nums[store_idx], nums[i] = nums[i], nums[store_idx]
store_idx += 1
# Verschiebe das Pivot-Element an seine korrekte Position
nums[right], nums[store_idx] = nums[store_idx], nums[right]
return store_idx
def select(left, right, k_smallest):
"""Hauptfunktion zur Auswahl"""
if left == right:
return nums[left]
# Wähle zufällig ein Pivot-Element aus
pivot_idx = left + (right - left) // 2
# Partitioniere und ermittle die endgültige Position des Pivot-Elements
pivot_idx = partition(left, right, pivot_idx)
# Das Pivot-Element ist genau das k-te kleinste Element
if k_smallest == pivot_idx:
return nums[k_smallest]
# Das k-te kleinste Element befindet sich in der linken Hälfte
elif k_smallest < pivot_idx:
return select(left, pivot_idx - 1, k_smallest)
# Das k-te kleinste Element befindet sich in der rechten Hälfte
else:
return select(pivot_idx + 1, right, k_smallest)
# k-1, da intern 0-basierte Indizierung verwendet wird
return select(0, len(nums) - 1, k - 1)
def find_top_k(nums, k, largest=True):
"""
Finde die größten k Elemente
nums: Eingabe-Array
k: Anzahl der zu findenden Elemente
largest: True, um die größten k zu finden, False, um die kleinsten k zu finden
Rückgabe: die Liste der größten k Elemente
"""
n = len(nums)
if k >= n:
return sorted(nums, reverse=largest)
if largest:
# Finde die größten k Elemente = finde das (n-k+1)-te kleinste Element
kth_value = quick_select(nums, n - k + 1)
# Sammle alle Elemente, die größer oder gleich kth_value sind
result = [x for x in nums if x > kth_value]
# Wenn die Anzahl nicht ausreicht, gleiche Elemente hinzufügen
while len(result) < k:
result.append(kth_value)
return result
else:
# Die kleinsten k Elemente finden = das k-te kleinste Element finden
kth_value = quick_select(nums, k)
result = [x for x in nums if x < kth_value]
while len(result) < k:
result.append(kth_value)
return result
# Testdaten
test_data = [3, 2, 1, 5, 6, 4, 9, 8, 7, 0]
print("Originaldaten:", test_data)
print("Die 3 größten Elemente:", find_top_k(test_data.copy(), 3, largest=True))
print("Die 3 kleinsten Elemente:", find_top_k(test_data.copy(), 3, largest=False))
Methode 2: Lösung basierend auf Heap-Sort
Ein Heap ist eine klassische Datenstruktur zur Lösung des Top-K-Problems, besonders geeignet für Datenstrom-Szenarien.
Beispiel
def find_top_k_with_heap(nums, k, largest=True):
"""
Heap verwenden, um die größten k Elemente zu finden
nums: Eingabe-Array
k: Anzahl der zu findenden Elemente
largest: True, um die größten k zu finden, False, um die kleinsten k zu finden
Rückgabe: die Liste der größten k Elemente
"""
if largest:
# Die größten k Elemente finden: einen Min-Heap verwenden
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, num)
elif num > heap[0]: # Das aktuelle Element ist größer als das oberste Element des Heaps
heapq.heapreplace(heap, num)
return sorted(heap, reverse=True)
else:
# Finde die kleinsten k Elemente: Verwende einen Max-Heap (implementiert durch Negieren)
heap = []
for num in nums:
if len(heap) < k:
heap.heappush(heap, -num) # Negative Werte speichern
elif num < -heap[0]: # Das aktuelle Element ist kleiner als das oberste Element des Heaps
heapq.heapreplace(heap, -num)
return sorted([-x for x in heap])
# Heap-Methode testen
print("\nHeap-Methode wird verwendet:")
print("Die 3 größten Elemente:", find_top_k_with_heap(test_data, 3, largest=True))
print("Die 3 kleinsten Elemente:", find_top_k_with_heap(test_data, 3, largest=False))
Klassisches abgeleitetes Problem 2: Inversionen zählen
Problemdefinition
In einem Array: Wenn ein früheres Element größer als ein späteres Element ist, dann liegt eineInversionvor. Berechne die Gesamtzahl der Inversionen im Array.
Praktische Anwendungsszenarien:
- Den Grad der Ordnung in Daten messen
- Analyse der Nutzerpräferenzen in Empfehlungssystemen
- Erkennung von Änderungskonflikten in Versionskontrollsystemen
Lösung: Algorithmus basierend auf Merge Sort
Während des Merge-Sort-Prozesses kann die Anzahl der Inversionspaare auf natürliche Weise gezählt werden. Dies ist eine typische Anwendung der Divide-and-Conquer-Idee.
Beispiel
"""
Zähle die Anzahl der Inversionen in einem Array
Verwende einen auf Merge Sort basierenden Ansatz
"""
def merge_sort_count(left, right):
"""Merge Sort und Inversionen zählen"""
if left >= right:
return 0, [nums[left]] if left == right else []
mid = (left + right) // 2
# Inversionen in den linken und rechten Teilen rekursiv zählen
left_count, left_arr = merge_sort_count(left, mid)
right_count, right_arr = merge_sort_count(mid + 1, right)
# Inversionen zählen, die den Mittelpunkt überqueren
cross_count = 0
merged = []
i = j = 0
while i < len(left_arr) and j < len(right_arr):
if left_arr[i] <= right_arr[j]:
merged.append(left_arr[i])
i += 1
else:
# left_arr[i] > right_arr[j] stellt eine Inversion dar
merged.append(right_arr[j])
cross_count += len(left_arr) - i # Wichtig: Alle verbleibenden Elemente auf der linken Seite bilden Inversionen mit right_arr[j]
j += 1
# Verbleibende Elemente hinzufügen
merged.extend(left_arr[i:])
merged.extend(right_arr[j:])
total_count = left_count + right_count + cross_count
return total_count, merged
if not nums:
return 0
count, _ = merge_sort_count(0, len(nums) - 1)
return count
# Inversionsanzahl testen
test_cases = [
([1, 2, 3, 4, 5], 0), # Vollständig geordnet, Inversionsanzahl ist 0
([5, 4, 3, 2, 1], 10), # Vollständig umgekehrt, Inversionsanzahl ist C(5,2)=10
([2, 4, 1, 3, 5], 3), # Beispiel
([7, 5, 6, 4], 5), # Komplexes Beispiel
]
print("\nTest der Inversionsanzahl:")
for nums, expected in test_cases:
result = count_inversions(nums.copy())
print(f"Array {nums}: berechneter Wert={result}, erwarteter Wert={expected}, {'Richtig' if result == expected else 'Falsch'}")
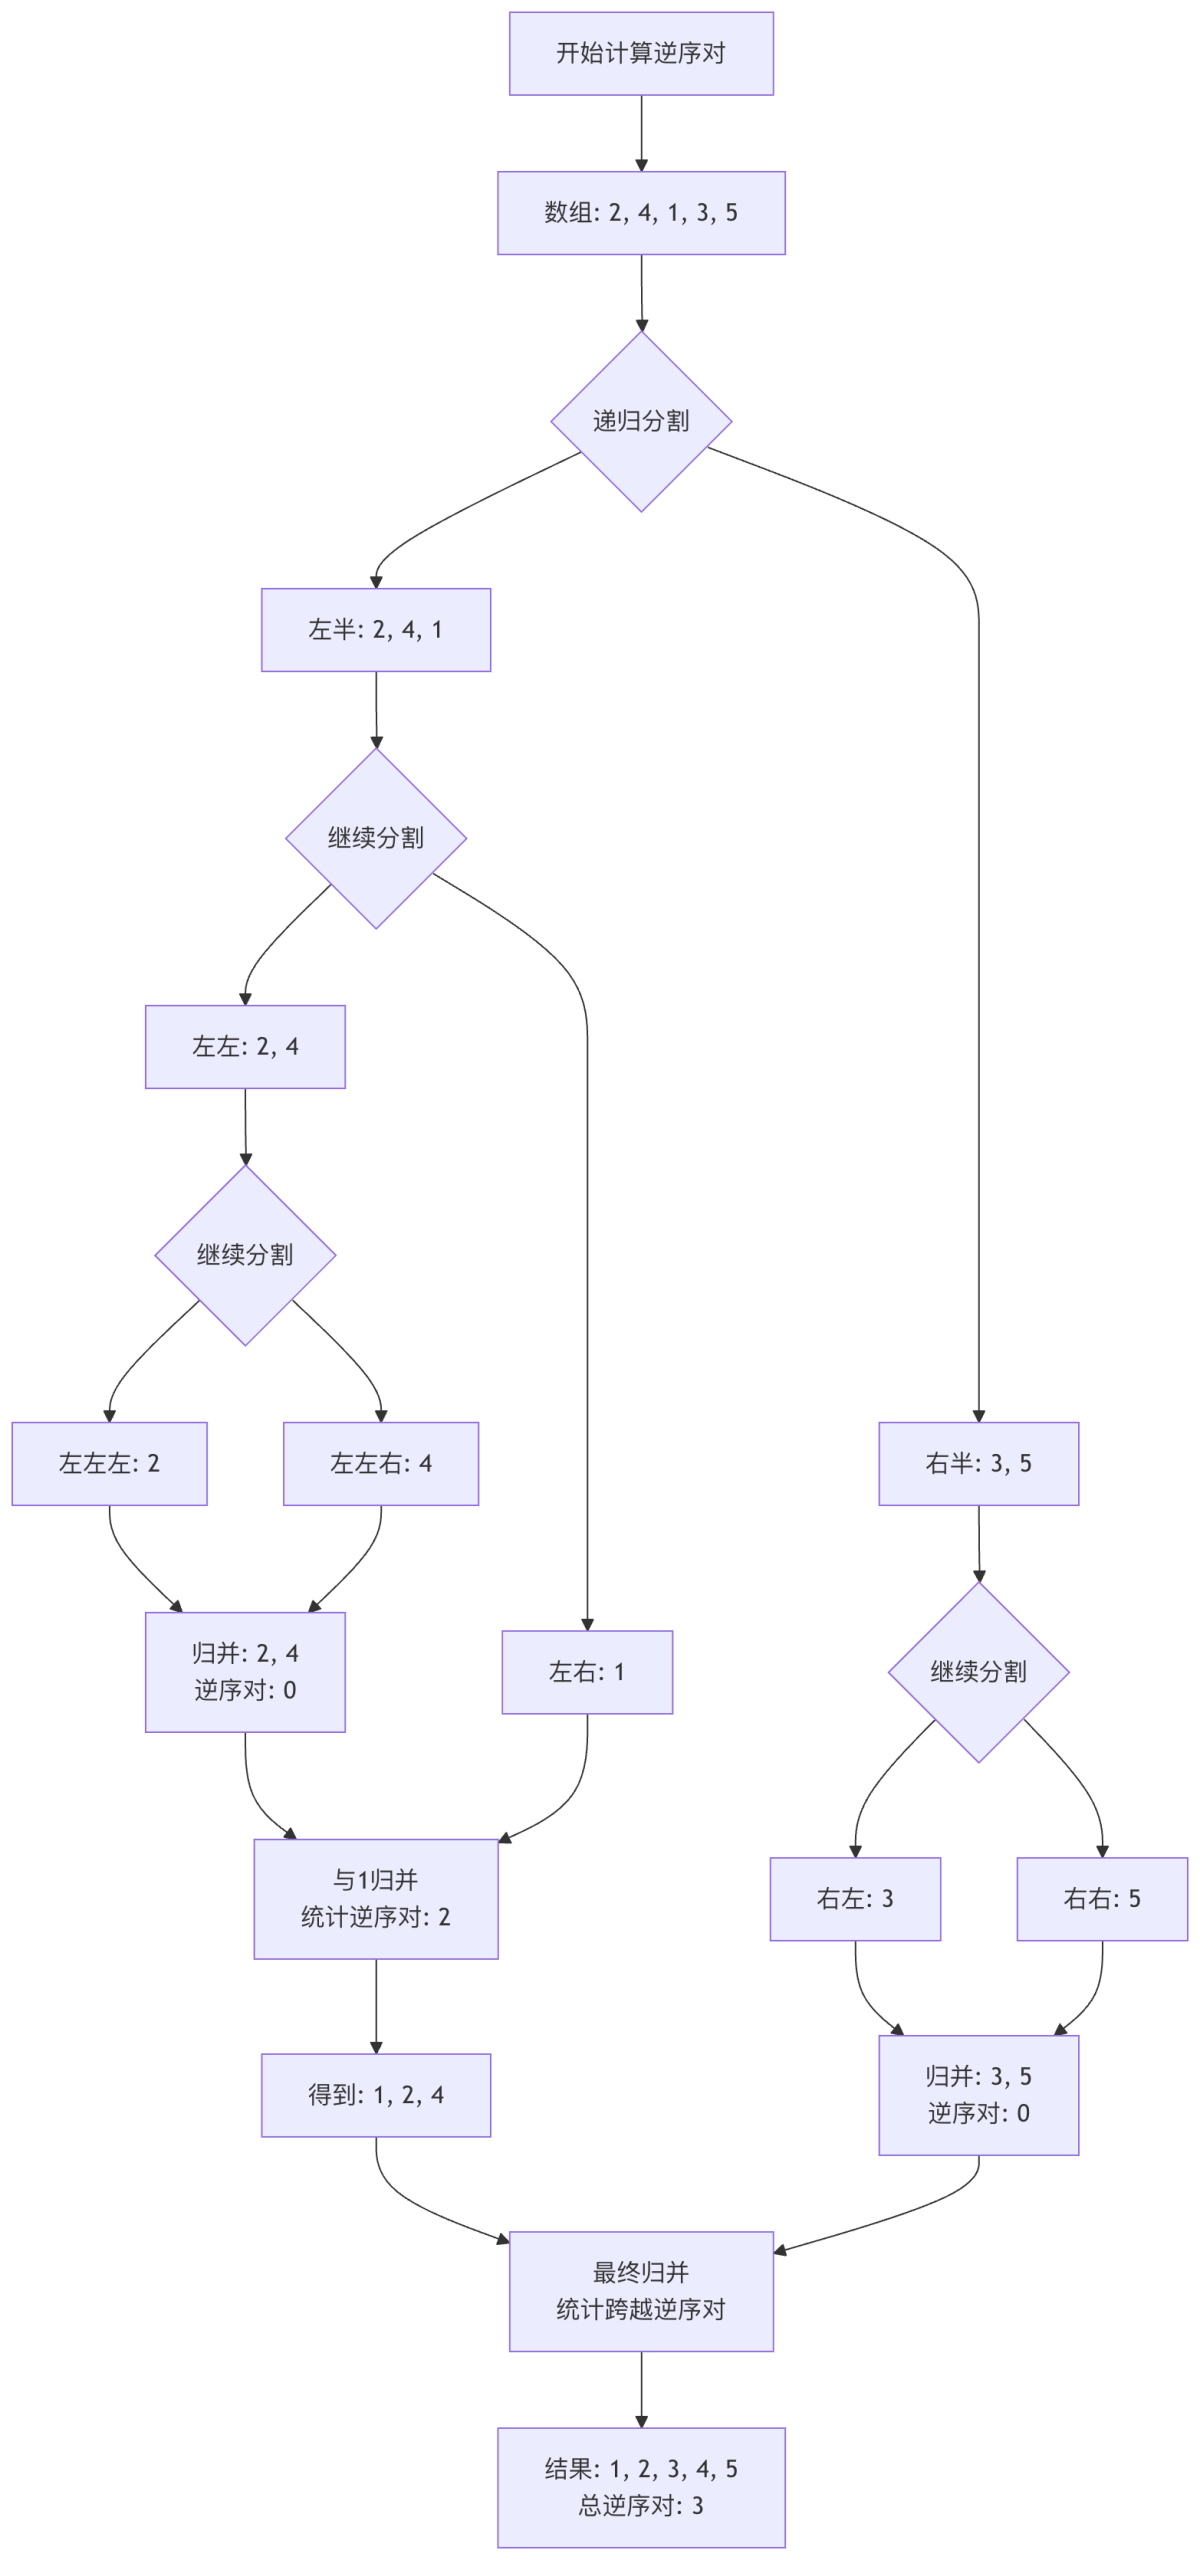
Die folgende Abbildung zeigt, wie Inversionspaare während des Merge-Sort-Prozesses gezählt werden. Der entscheidende Punkt ist:Wenn ein Element in der rechten Hälfte kleiner als ein Element in der linken Hälfte ist, bilden alle verbleibenden Elemente in der linken Hälfte Inversionspaare mit diesem Element der rechten Hälfte.。
Klassisches Variantenproblem 3: K-tes größtes / K-tes kleinstes Element
Dieses Problem ist ein Spezialfall des Top-K-Problems, aber seine Lösungen sind vielfältiger.
Vergleich mehrerer Lösungen
| Methoden | Zeitkomplexität | Speicherkomplexität | Funktionen |
|---|---|---|---|
| Nach dem Sortieren direkt entnehmen | O(n log n) | O(1) oder O(n) | Einfachste und intuitivste |
| Quickselect | O(n) im Durchschnitt | O(1) | Optimale durchschnittliche Komplexität |
| Heap-Methode | O(n log k) | O(k) | Für Datenströme geeignet |
| Counting Sort | O(n + m) | O(m) | Geeignet für Fälle mit einem kleinen Datenbereich |
Vollständiges Implementierungsbeispiel
Beispiel
"""Finde das k-kleinste Element (1-basiert)"""
# Methode 1: Direktes Sortieren
def method_sort():
return sorted(nums)[k-1]
# Methode 2: Quickselect (oben implementiert)
def method_quick_select():
return quick_select(nums.copy(), k)
# Methode 3: Heap-Methode
def method_heap():
# Verwende einen Max-Heap, um das k-te kleinste Element zu finden
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, -num) # Max-Heap wird mithilfe negativer Zahlen implementiert
elif num < -heap[0]:
heapq.heapreplace(heap, -num)
return -heap[0]
# Methode 4: Zählsortierung (geeignet für kleine Datenbereiche)
def method_counting():
if not nums:
return None
# Ermittle den Datenbereich
min_val, max_val = min(nums), max(nums)
range_size = max_val - min_val + 1
# Zählen
count = [0] * range_size
for num in nums:
count[num - min_val] += 1
# Finde das k-te kleinste
accumulated = 0
for i in range(range_size):
accumulated += count[i]
if accumulated >= k:
return i + min_val
return None
# Überprüfe, ob alle Methoden konsistente Ergebnisse liefern
result1 = method_sort()
result2 = method_quick_select()
result3 = method_heap()
result4 = method_counting()
print(f"\nTest zur Suche nach dem {k}-ten kleinsten Element (Array: {nums}):")
print(f"Sortiermethode: {result1}")
print(f"Quickselect: {result2}")
print(f"Heap-Methode: {result3}")
print(f"Zählmethode: {result4}")
# Konsistenz überprüfen
assert result1 == result2 == result3 == result4, "Verschiedene Methoden liefern inkonsistente Ergebnisse!"
return result1
# Testdaten
test_nums = [3, 2, 3, 1, 2, 4, 5, 5, 6]
for k in [1, 3, 5, 7]:
find_kth_smallest(test_nums.copy(), k)
Klassisches abgeleitetes Problem 4: Intervallzusammenführung
Problemdefinition
Gegeben eine Menge von Intervallen, führe alle überlappenden Intervalle zusammen.
Praktische Anwendungsszenarien:
- Zusammenführen von Zeiträumen in Kalenderanwendungen
- Zeitplanung von Aufgaben im Projektmanagement
- Zusammenführen von Netzwerk-IP-Adresssegmenten
Lösung: Sortieren + linearer Scan
Beispiel
"""
Überlappende Intervalle zusammenführen
intervals: eine Liste von Listen, jede Unterliste repräsentiert ein Intervall [start, end]
Rückgabe: die zusammengeführte Liste der Intervalle
"""
if not intervals:
return []
# Schlüsselschritt 1: Intervalle nach Startpunkt sortieren
intervals.sort(key=lambda x: x[0])
merged = []
# Schlüsselschritt 2: Linearer Scan und Zusammenführen
current_start, current_end = intervals[0]
for interval in intervals[1:]:
start, end = interval
if start <= current_end: # Überlappung
# Intervalle zusammenführen: den größten Endpunkt nehmen
current_end = max(current_end, end)
else: # Keine Überlappung
# Aktuelles Intervall speichern
merged.append([current_start, current_end])
# Ein neues Intervall beginnen
current_start, current_end = start, end
# Das letzte Intervall hinzufügen
merged.append([current_start, current_end])
return merged
# Intervallzusammenführung testen
test_intervals = [
[[1, 3], [2, 6], [8, 10], [15, 18]],
[[1, 4], [4, 5]],
[[1, 4], [0, 4]],
[[1, 4], [2, 3]], # Vollständig enthalten
[[1, 4], [0, 2], [3, 5]], # Komplexer Fall
]
print("\nIntervall-Zusammenführungstest:")
for i, intervals in enumerate(test_intervals, 1):
result = merge_intervals(intervals.copy())
print(f"Testfall {i}:")
print(f" Eingabe: {intervals}")
print(f" Ausgabe: {result}")
print()
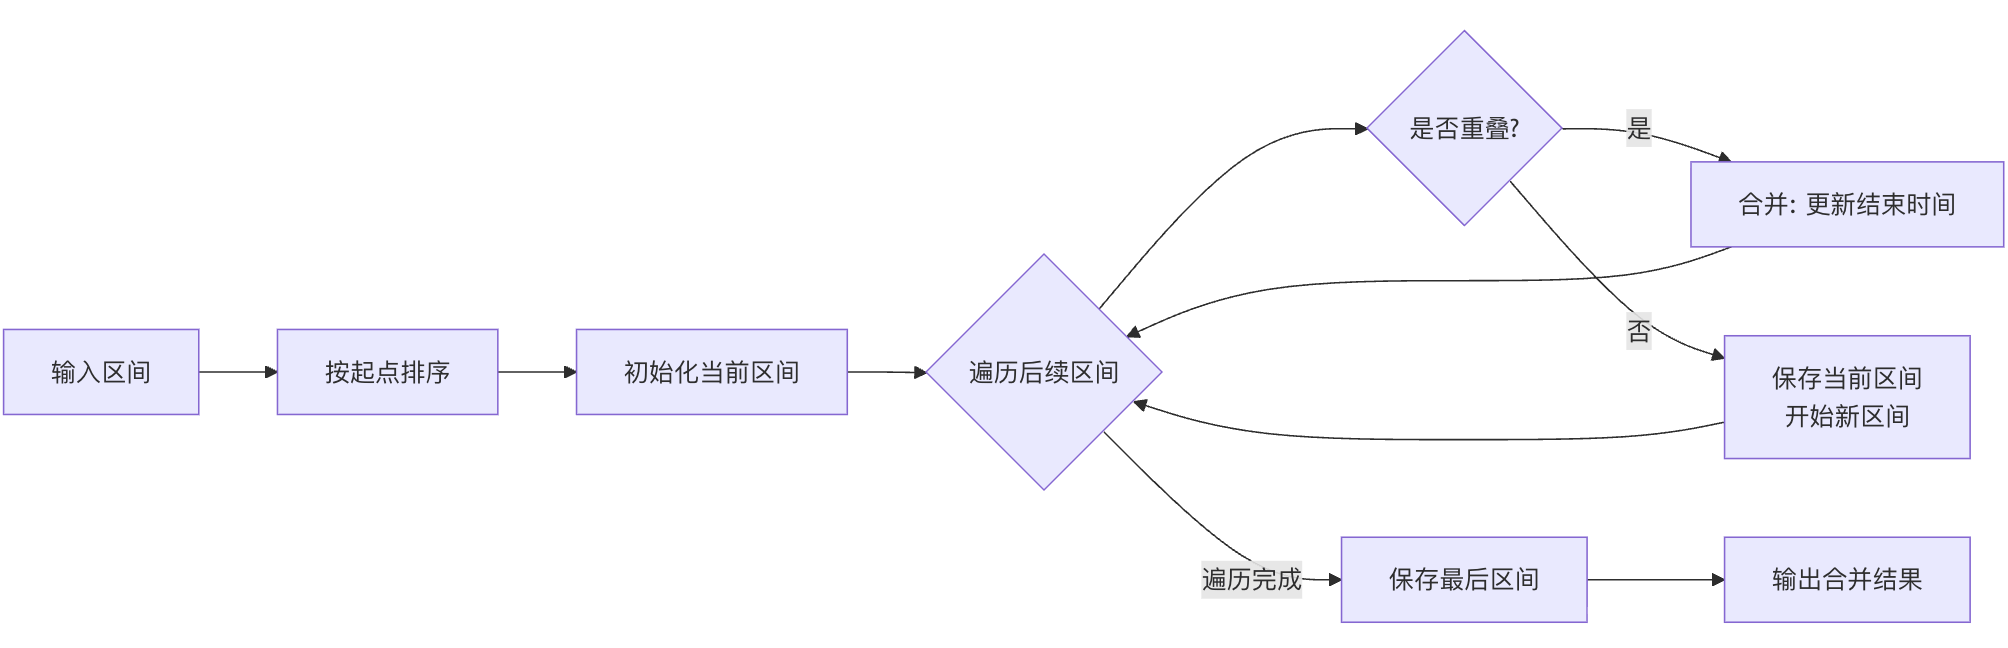
Analyse des Algorithmusprozesses
Übungsaufgaben
Jetzt festigen wir das Gelernte mit einigen Übungen:
Übung 1: Farben sortieren (Problem der niederländischen Flagge)
Gegeben sei ein Array mit n Elementen, die rot, weiß oder blau sind; sortiere sie in-place, sodass Elemente derselben Farbe nebeneinander liegen und in der Reihenfolge rot, weiß, blau angeordnet sind.
Beispiel
"""
Sortiere das Farbarray in-place
0: Rot, 1: Weiß, 2: Blau
Verwende die Drei-Zeiger-Methode (ähnlich der Partitionierungsidee von Quicksort)
"""
# Initialisiere drei Zeiger
left = 0 # Rechte Grenze des roten Bereichs
current = 0 # Aktuelles Element, das geprüft wird
right = len(nums) - 1 # Linke Grenze des blauen Bereichs
while current <= right:
if nums[current] == 0: # Rot
nums[left], nums[current] = nums[current], nums[left]
left += 1
current += 1
elif nums[current] == 1: # Weiß
current += 1
else: # Blau
nums[current], nums[right] = nums[right], nums[current]
right -= 1
# Hinweis: current hier nicht inkrementieren, da das eingetauschte Element noch nicht überprüft wurde
return nums
# Test
colors = [2, 0, 2, 1, 1, 0]
print("Vor dem Sortieren der Farben:", colors)
print("Nach dem Sortieren der Farben:", sort_colors(colors.copy()))
Übung 2: K-tes größtes Element in einem Array
Finde das k-te größte Element in einem unsortierten Array.
Beispiel
"""
Finde das k-größte Element
Verwende den Quickselect-Algorithmus
"""
# Das k-größte = das (n-k+1)-kleinste
k_smallest = len(nums) - k + 1
def quick_select(arr, left, right, k_small):
if left == right:
return arr[left]
# Wähle einen Pivot
pivot_idx = (left + right) // 2
pivot = arr[pivot_idx]
# Partitionierung
arr[pivot_idx], arr[right] = arr[right], arr[pivot_idx]
store_idx = left
for i in range(left, right):
if arr[i] < pivot:
arr[store_idx], arr[i] = arr[i], arr[store_idx]
store_idx += 1
arr[right], arr[store_idx] = arr[store_idx], arr[right]
# Rekursive Auswahl
if k_small == store_idx:
return arr[store_idx]
elif k_small < store_idx:
return quick_select(arr, left, store_idx - 1, k_small)
else:
return quick_select(arr, store_idx + 1, right, k_small)
return quick_select(nums.copy(), 0, len(nums) - 1, k_smallest - 1)
# Test
test_array = [3, 2, 1, 5, 6, 4]
k = 2
print(f"\nDas {k}-te größte Element im Array {test_array} ist: {find_kth_largest(test_array, k)})