Производные задачи алгоритмов сортировки
Освоив базовые алгоритмы сортировки, такие как пузырьковая сортировка и быстрая сортировка, мы поймём, что сортировка — это не просто упорядочивание данных.
В реальном программировании и на собеседованиях многие задачи являются вариантами или производными задачами алгоритмов сортировки.
Понимание этих производных задач помогает глубже постичь суть алгоритмов сортировки и улучшить наши навыки решения сложных задач.
В этой статье мы рассмотрим несколько классических производных задач алгоритмов сортировки; анализ их ключевых идей, решений и практического применения поможет вам выстроить более системное алгоритмическое мышление.
Что такое производные задачи алгоритмов сортировки?
Производные задачи алгоритмов сортировки — это текоторые не требуют сортировки напрямуюно ключевые идеи, ход алгоритма или структуры данных, используемые для решения задач, тесно связаны с классическими алгоритмами сортировки.Высокая релевантностьзадачи.
Такие задачи обычно имеют следующие характеристики:
- Разные цели: конечная цель — не вывести упорядоченную последовательность
- Общие идеиИспользование ключевых идей сортировки, таких как сравнение, обмен и разделяй и властвуй.
- Связано со сложностьюВременная сложность часто того же порядка, что и у алгоритмов сортировки.
- Широко используются: часто встречаются в реальной разработке
Ниже давайте глубже разберёмся на нескольких конкретных задачах.
Классический вариант задачи 1: задача Top K
Постановка задачи
Найти среди n элементовK наибольших (или наименьших) элементов。
Практические сценарии применения:
- Сайт электронной коммерции: найти 10 самых продаваемых товаров
- Социальная сеть: найти 100 пользователей с наибольшим числом подписчиков
- Анализ данных: найти 5 самых посещаемых страниц
Сравнение решений
| Методы | Временная сложность | Пространственная сложность | Применимые сценарии |
|---|---|---|---|
| Отсортировать напрямую и взять первые K | O(n log n) | O(1) или O(n) | Когда K близко к n |
| Сортировка пузырьком K раз | O(n × K) | O(1) | K очень мало (K < 10) |
| Min-куча / Max-куча | O(n log K) | O(K) | Наиболее часто используется, K намного меньше n |
| Алгоритм Quickselect | O(n) в среднем, O(n²) в худшем случае | O(1) | Полное упорядочивание не требуется; требуется только Top K. |
Метод 1: Quickselect на основе идеи быстрой сортировки
Алгоритм Quickselect — это вариант быстрой сортировки. Ему не нужно полностью сортировать весь массив; нужно только найти позицию K-го наибольшего элемента.
Пример
"""
Используйте алгоритм quickselect, чтобы найти k-й наименьший элемент
nums: входной массив
k: k-й наименьший элемент, который нужно найти (с нумерацией от 1)
Возвращает: значение k-го наименьшего элемента
"""
def partition(left, right, pivot_idx):
"""Функция partition, которая делит массив на две части: меньшие и большие, чем опорный элемент"""
pivot = nums[pivot_idx]
# Переместить опорный элемент в конец
nums[pivot_idx], nums[right] = nums[right], nums[pivot_idx]
store_idx = left
for i in range(left, right):
if nums[i] < pivot:
nums[store_idx], nums[i] = nums[i], nums[store_idx]
store_idx += 1
# Переместить опорный элемент на его правильную позицию
nums[right], nums[store_idx] = nums[store_idx], nums[right]
return store_idx
def select(left, right, k_smallest):
"""Основная функция выбора"""
if left == right:
return nums[left]
# Случайно выбрать опорный элемент
pivot_idx = left + (right - left) // 2
# Выполнить разбиение и получить итоговую позицию опорного элемента
pivot_idx = partition(left, right, pivot_idx)
# Опорный элемент — это ровно k-й наименьший элемент
if k_smallest == pivot_idx:
return nums[k_smallest]
# k-й наименьший элемент находится в левой половине
elif k_smallest < pivot_idx:
return select(left, pivot_idx - 1, k_smallest)
# k-й наименьший элемент находится в правой половине
else:
return select(pivot_idx + 1, right, k_smallest)
# k-1, потому что внутри используется индексация с нуля
return select(0, len(nums) - 1, k - 1)
def find_top_k(nums, k, largest=True):
"""
Найти k наибольших элементов
nums: входной массив
k: количество элементов для поиска
largest: True — найти k наибольших, False — найти k наименьших
Возвращает: список k наибольших элементов
"""
n = len(nums)
if k >= n:
return sorted(nums, reverse=largest)
if largest:
# Найти k наибольших элементов = найти (n-k+1)-й наименьший элемент
kth_value = quick_select(nums, n - k + 1)
# Собрать все элементы, большие или равные kth_value
result = [x for x in nums if x > kth_value]
# Если количество недостаточно, добавьте равные элементы
while len(result) < k:
result.append(kth_value)
return result
else:
# Найти k наименьших элементов = найти k-й наименьший элемент
kth_value = quick_select(nums, k)
result = [x for x in nums if x < kth_value]
while len(result) < k:
result.append(kth_value)
return result
# Тестовые данные
test_data = [3, 2, 1, 5, 6, 4, 9, 8, 7, 0]
print("Исходные данные:", test_data)
print("3 наибольших элемента:", find_top_k(test_data.copy(), 3, largest=True))
print("3 наименьших элемента:", find_top_k(test_data.copy(), 3, largest=False))
Метод 2: Решение на основе пирамидальной сортировки
Куча — это классическая структура данных для решения задачи Top K, особенно подходящая для сценариев потоковой передачи данных.
Пример
def find_top_k_with_heap(nums, k, largest=True):
"""
Использовать кучу для поиска k наибольших элементов
nums: входной массив
k: количество элементов для поиска
largest: True — найти k наибольших, False — найти k наименьших
Возвращает: список k наибольших элементов
"""
if largest:
# Найти k наибольших элементов: использовать минимальную кучу
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, num)
elif num > heap[0]: # Текущий элемент больше вершины кучи
heapq.heapreplace(heap, num)
return sorted(heap, reverse=True)
else:
# Найти k наименьших элементов: используйте max-кучу (реализованную через отрицательные значения)
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, -num) # Сохранить отрицательные значения
elif num < -heap[0]: # Текущий элемент меньше вершины кучи
heapq.heapreplace(heap, -num)
return sorted([-x for x in heap])
# Проверка метода кучи
print("\nИспользование метода кучи:")
print("3 наибольших элемента:", find_top_k_with_heap(test_data, 3, largest=True))
print("3 наименьших элемента:", find_top_k_with_heap(test_data, 3, largest=False))
Классическая производная задача 2: Подсчёт инверсий
Постановка задачи
В массиве, если более ранний элемент больше более позднего, то эти два элемента образуютинверсиюВычислите общее количество инверсий в массиве.
Практические сценарии применения:
- Измерение степени упорядоченности данных
- Анализ предпочтений пользователей в рекомендательных системах
- Обнаружение конфликтов модификаций в системах контроля версий
Решение: алгоритм на основе сортировки слиянием
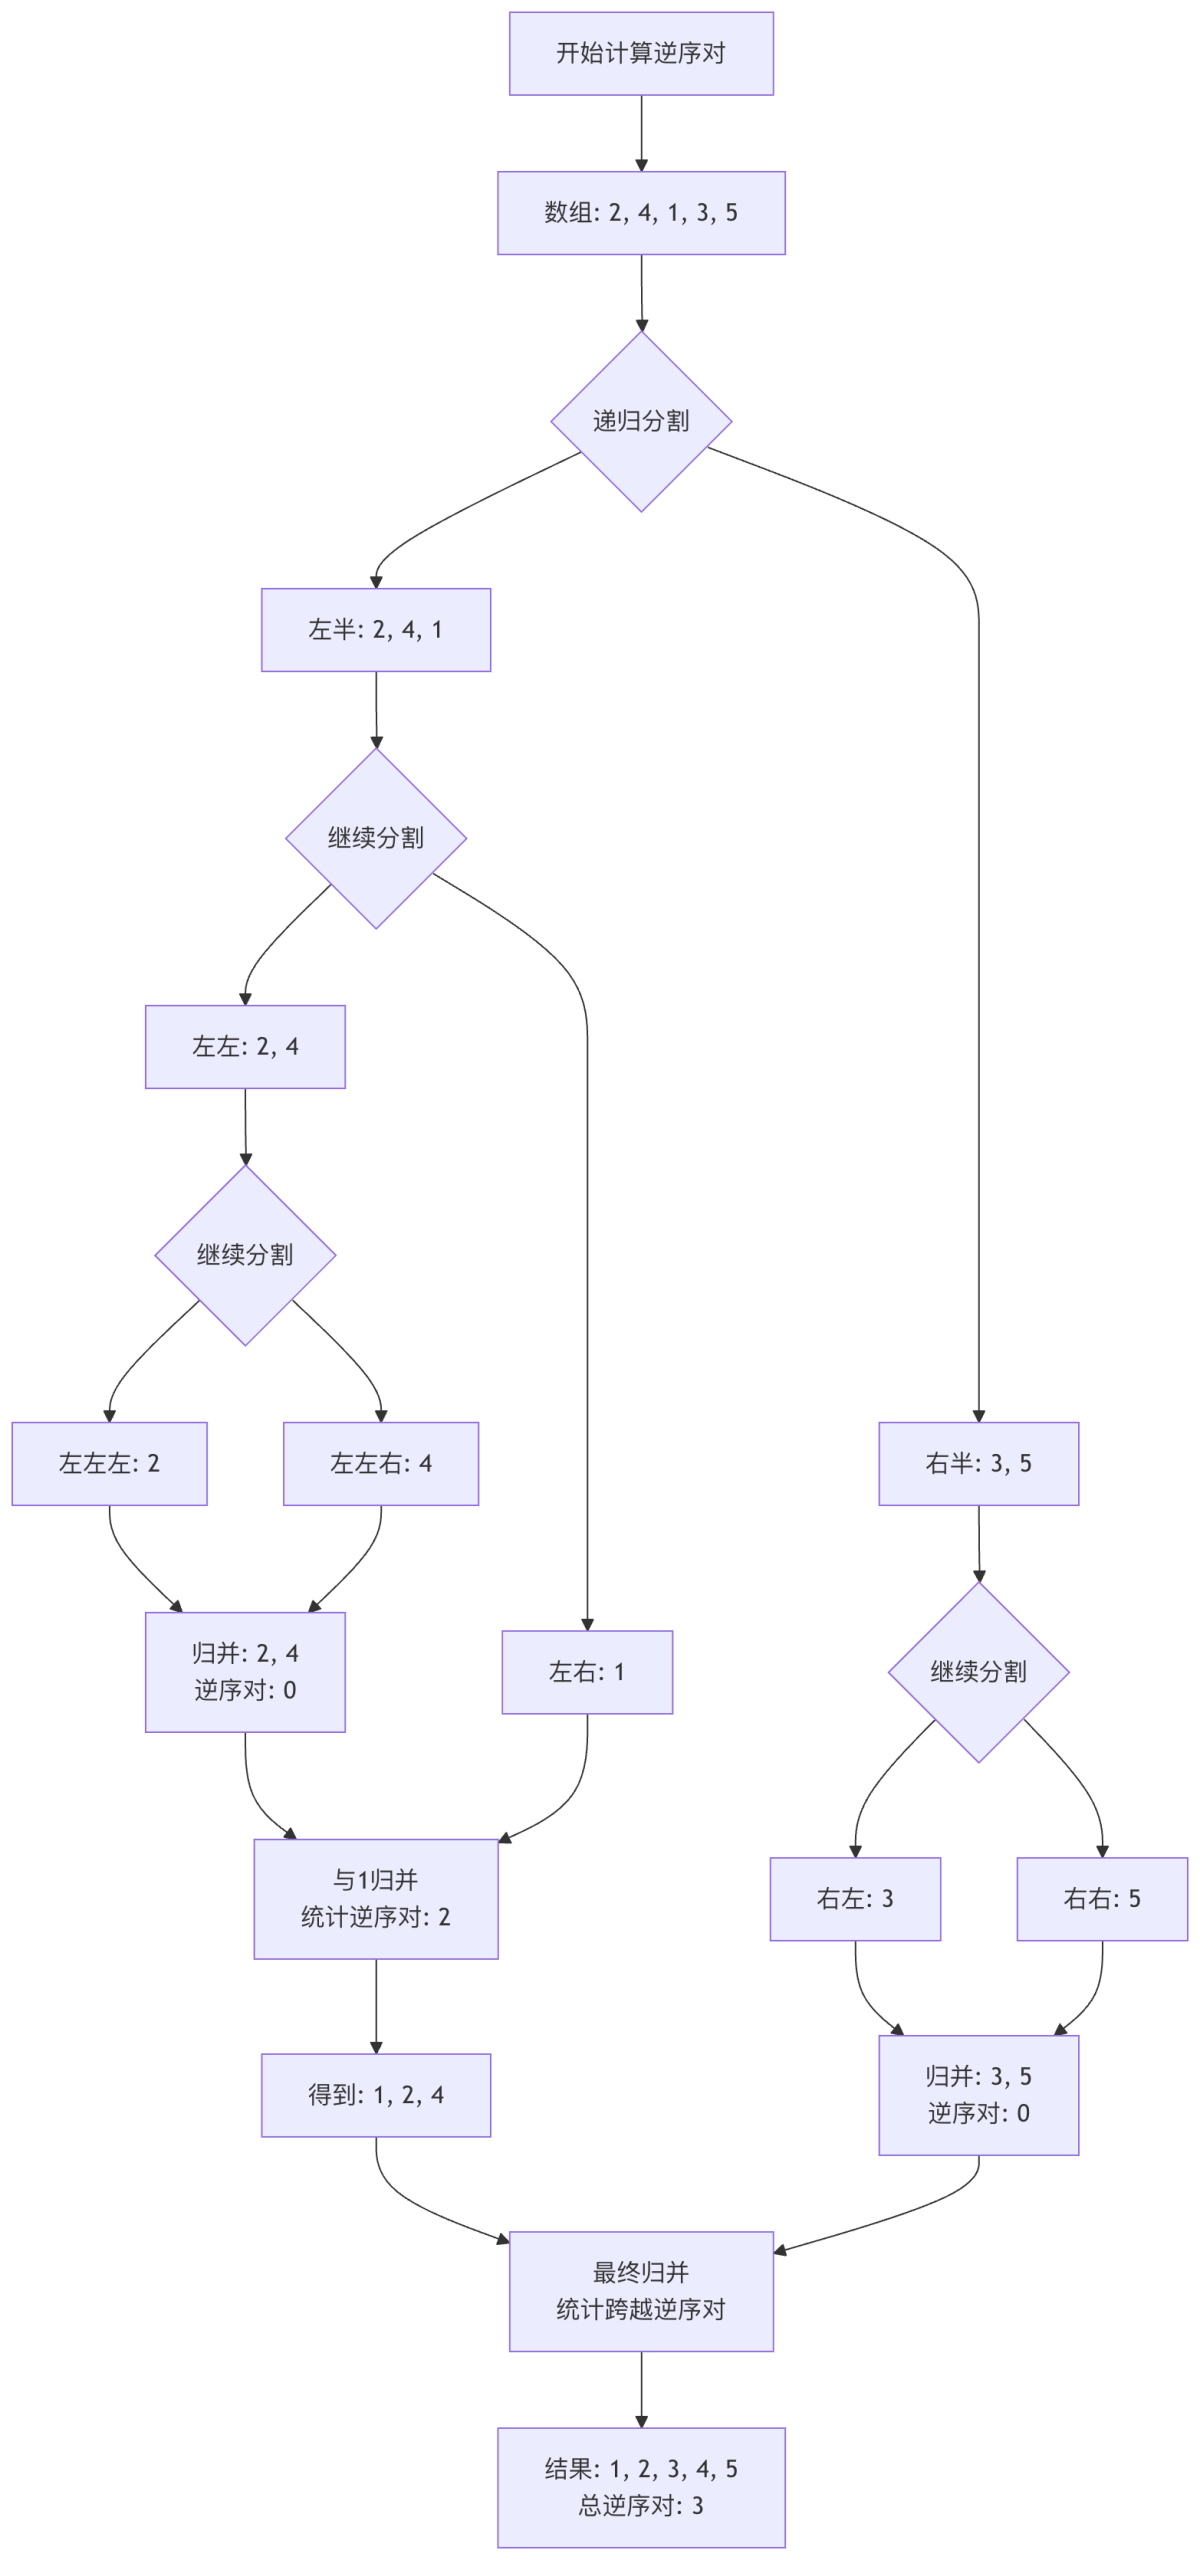
В процессе сортировки слиянием количество инверсионных пар можно естественным образом подсчитать. Это типичный пример применения идеи «разделяй и властвуй».
Пример
"""
Подсчитать количество инверсий в массиве
Использовать подход на основе сортировки слиянием
"""
def merge_sort_count(left, right):
"""Сортировка слиянием и подсчёт инверсий"""
if left >= right:
return 0, [nums[left]] if left == right else []
mid = (left + right) // 2
# Рекурсивно подсчитать инверсии в левой и правой частях
left_count, left_arr = merge_sort_count(left, mid)
right_count, right_arr = merge_sort_count(mid + 1, right)
# Подсчитать инверсии, которые пересекают середину
cross_count = 0
merged = []
i = j = 0
while i < len(left_arr) and j < len(right_arr):
if left_arr[i] <= right_arr[j]:
merged.append(left_arr[i])
i += 1
else:
# left_arr[i] > right_arr[j] образует инверсию
merged.append(right_arr[j])
cross_count += len(left_arr) - i # Ключевой момент: все оставшиеся элементы слева образуют инверсии с right_arr[j]
j += 1
# Добавить оставшиеся элементы
merged.extend(left_arr[i:])
merged.extend(right_arr[j:])
total_count = left_count + right_count + cross_count
return total_count, merged
if not nums:
return 0
count, _ = merge_sort_count(0, len(nums) - 1)
return count
# Тест подсчёта инверсий
test_cases = [
([1, 2, 3, 4, 5], 0), # Полностью упорядочен, количество инверсий равно 0
([5, 4, 3, 2, 1], 10), # Полностью в обратном порядке, количество инверсий равно C(5,2)=10
([2, 4, 1, 3, 5], 3), # Пример
([7, 5, 6, 4], 5), # Сложный пример
]
print("\nТест подсчёта инверсий:")
for nums, expected in test_cases:
result = count_inversions(nums.copy())
print(f"Массив {nums}: вычисленное значение={result}, ожидаемое значение={expected}, {'Верно' if result == expected else 'Неверно'}")
На рисунке ниже показано, как подсчитывать пары инверсий в процессе сортировки слиянием. Ключевой момент:Когда элемент в правой половине меньше элемента в левой половине, все оставшиеся элементы в левой половине образуют пары инверсий с этим элементом правой половины.。
Классический вариант задачи 3: K-й наибольший / K-й наименьший элемент
Эта задача — частный случай задачи Top K, но её решения более разнообразны.
Сравнение нескольких решений
| Методы | Временная сложность | Пространственная сложность | Особенности |
|---|---|---|---|
| Взять напрямую после сортировки | O(n log n) | O(1) или O(n) | Самый простой и интуитивно понятный |
| Quickselect | O(n) в среднем | O(1) | Оптимальная средняя сложность |
| Метод с кучей | O(n log k) | O(k) | Подходит для потоков данных |
| Сортировка подсчётом | O(n + m) | O(m) | Подходит для случаев с небольшим диапазоном данных |
Полный пример реализации
Пример
"""Найти k-й наименьший элемент (нумерация с 1)"""
# Метод 1: прямая сортировка
def method_sort():
return sorted(nums)[k-1]
# Метод 2: Quickselect (реализован выше)
def method_quick_select():
return quick_select(nums.copy(), k)
# Метод 3: метод с кучей
def method_heap():
# Использовать максимальную кучу для поиска k-го наименьшего элемента
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, -num) # Максимальная куча реализуется с помощью отрицательных чисел
elif num < -heap[0]:
heapq.heapreplace(heap, -num)
return -heap[0]
# Метод 4: Сортировка подсчётом (подходит для небольших диапазонов данных)
def method_counting():
if not nums:
return None
# Найти диапазон данных
min_val, max_val = min(nums), max(nums)
range_size = max_val - min_val + 1
# Подсчёт
count = [0] * range_size
for num in nums:
count[num - min_val] += 1
# Найти k-й наименьший
accumulated = 0
for i in range(range_size):
accumulated += count[i]
if accumulated >= k:
return i + min_val
return None
# Проверить, что все методы дают согласованные результаты
result1 = method_sort()
result2 = method_quick_select()
result3 = method_heap()
result4 = method_counting()
print(f"\nТест поиска {k}-го наименьшего элемента (Массив: {nums}):")
print(f"Метод сортировки: {result1}")
print(f"Быстрый выбор: {result2}")
print(f"Метод кучи: {result3}")
print(f"Метод подсчёта: {result4}")
# Проверить согласованность
assert result1 == result2 == result3 == result4, "Разные методы дают несогласованные результаты!"
return result1
# Тестовые данные
test_nums = [3, 2, 3, 1, 2, 4, 5, 5, 6]
for k in [1, 3, 5, 7]:
find_kth_smallest(test_nums.copy(), k)
Классическая производная задача 4: Объединение интервалов
Постановка задачи
Дано множество интервалов, объединить все перекрывающиеся интервалы.
Практические сценарии применения:
- Объединение временных промежутков в календарных приложениях
- Планирование сроков задач в управлении проектами
- Объединение сегментов сетевых IP-адресов
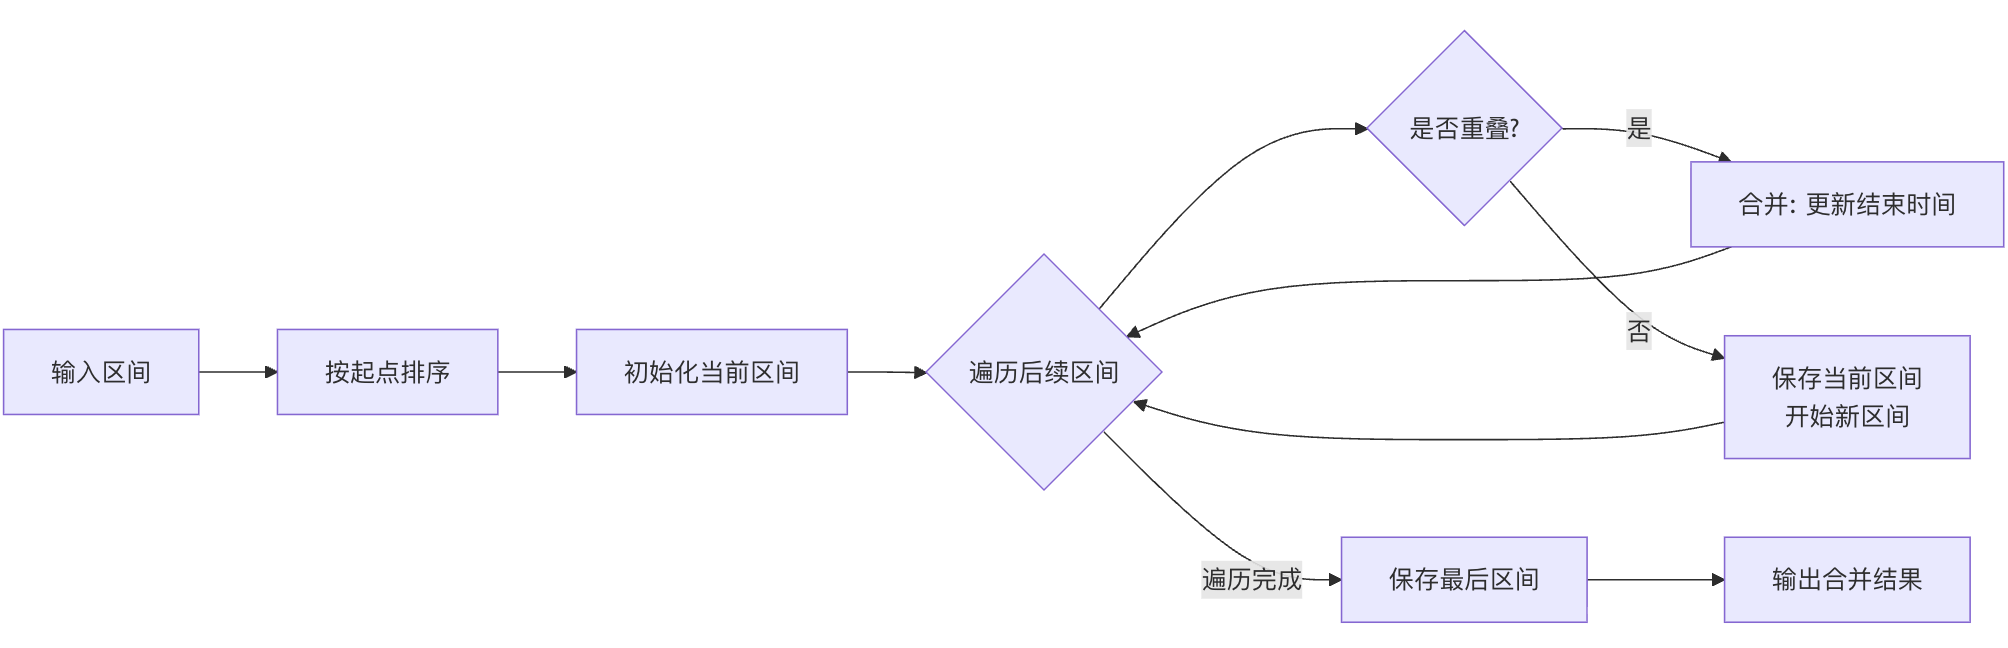
Решение: сортировка + линейное сканирование
Пример
"""
Объединение перекрывающихся интервалов
intervals: список списков, каждый подсписок представляет интервал [start, end]
Возвращает: объединённый список интервалов
"""
if not intervals:
return []
# Ключевой шаг 1: сортировка интервалов по начальной точке
intervals.sort(key=lambda x: x[0])
merged = []
# Ключевой шаг 2: линейное сканирование и объединение
current_start, current_end = intervals[0]
for interval in intervals[1:]:
start, end = interval
if start <= current_end: # Перекрытие
# Объединить интервалы: взять наибольшую конечную точку
current_end = max(current_end, end)
else: # Нет перекрытия
# Сохранить текущий интервал
merged.append([current_start, current_end])
# Начать новый интервал
current_start, current_end = start, end
# Добавить последний интервал
merged.append([current_start, current_end])
return merged
# Проверка объединения интервалов
test_intervals = [
[[1, 3], [2, 6], [8, 10], [15, 18]],
[[1, 4], [4, 5]],
[[1, 4], [0, 4]],
[[1, 4], [2, 3]], # Полностью содержится
[[1, 4], [0, 2], [3, 5]], # Сложный случай
]
print("\nТест объединения интервалов:")
for i, intervals in enumerate(test_intervals, 1):
result = merge_intervals(intervals.copy())
print(f"Тестовый случай {i}:")
print(f" Вход: {intervals}")
print(f" Выход: {result}")
print()
Анализ процесса алгоритма
Практические упражнения
Теперь давайте закрепим то, что мы изучили, с помощью нескольких упражнений:
Упражнение 1: Сортировка цветов (задача о голландском национальном флаге)
Дан массив из n элементов, которые могут быть красного, белого или синего цвета; отсортируйте его на месте так, чтобы элементы одного цвета были рядом и располагались в порядке красный, белый, синий.
Пример
"""
Отсортируйте массив цветов на месте
0: красный, 1: белый, 2: синий
Используйте метод трёх указателей (аналогично идее разбиения в быстрой сортировке)
"""
# Инициализировать три указателя
left = 0 # Правая граница красной области
current = 0 # Текущий проверяемый элемент
right = len(nums) - 1 # Левая граница синей области
while current <= right:
if nums[current] == 0: # Красный
nums[left], nums[current] = nums[current], nums[left]
left += 1
current += 1
elif nums[current] == 1: # Белый
current += 1
else: # Синий
nums[current], nums[right] = nums[right], nums[current]
right -= 1
# Примечание: не увеличивайте current здесь, потому что заменённый элемент ещё не проверен
return nums
#
colors = [2, 0, 2, 1, 1, 0]
print("Перед сортировкой цветов:", colors)
print("После сортировки цветов:", sort_colors(colors.copy()))
Упражнение 2: K-й по величине элемент в массиве
Найдите k-й по величине элемент в неотсортированном массиве.
Пример
"""
Найти k-й наибольший элемент
Использовать алгоритм quickselect
"""
# k-й наибольший = (n-k+1)-й наименьший
k_smallest = len(nums) - k + 1
def quick_select(arr, left, right, k_small):
if left == right:
return arr[left]
# Выбрать опорный элемент
pivot_idx = (left + right) // 2
pivot = arr[pivot_idx]
# Разбиение
arr[pivot_idx], arr[right] = arr[right], arr[pivot_idx]
store_idx = left
for i in range(left, right):
if arr[i] < pivot:
arr[store_idx], arr[i] = arr[i], arr[store_idx]
store_idx += 1
arr[right], arr[store_idx] = arr[store_idx], arr[right]
# Рекурсивный выбор
if k_small == store_idx:
return arr[store_idx]
elif k_small < store_idx:
return quick_select(arr, left, store_idx - 1, k_small)
else:
return quick_select(arr, store_idx + 1, right, k_small)
return quick_select(nums.copy(), 0, len(nums) - 1, k_smallest - 1)
#
test_array = [3, 2, 1, 5, 6, 4]
k = 2
print(f"\n{k}-й по величине элемент в массиве {test_array}: {find_kth_largest(test_array, k)})