Algoritmo de ordenamiento de tres vías
Algoritmo de ordenamiento de tres vías(Three-Way Partitioning) es una variante especial del ordenamiento rápido, optimizada específicamente para manejar arrays con muchos elementos duplicados. Su idea central es dividir el array en tres partes durante un solo proceso de partición, en lugar de las dos partes tradicionales.
El ordenamiento rápido de tres vías es una versión mejorada del ordenamiento rápido de dos vías. El algoritmo de ordenamiento de tres vías divide los datos a ordenar en tres partes: menor que v, igual a v y mayor que v, donde v es el valor pivote. De este modo, entre las tres partes, los datos iguales a v no necesitan volver a ordenarse en la siguiente recursión, y los datos menores que v o mayores que v tampoco presentan un caso en el que uno sea particularmente abundante). De esta manera, el rendimiento del algoritmo de ordenamiento rápido de tres vías es superior.
Imagina que tienes un gran cubo de canicas de colores mezcladas, con tres colores: rojo, blanco y azul. Tu tarea es separarlas rápidamente, dejando todas las canicas rojas a la izquierda, las blancas en el centro y las azules a la derecha. El algoritmo de ordenamiento de tres vías es un maestro de clasificación para resolver este tipo de problemas.
Ordenamiento rápido tradicional vs ordenamiento rápido de tres vías
Usemos una tabla sencilla para comparar las diferencias entre ambos:
| Característica | Ordenamiento rápido tradicional | Ordenamiento rápido de tres vías |
|---|---|---|
| Número de particiones | 2 (menor que el pivote, mayor que el pivote) | 3 (menor que el pivote, igual al pivote, mayor que el pivote) |
| Manejo de elementos duplicados | Menos eficiente, los elementos duplicados pueden compararse e intercambiarse múltiples veces | Muy eficiente, los elementos duplicados se manejan de forma concentrada |
| Complejidad temporal | Promedio O(n log n), peor caso O(n²) | Promedio O(n log n), peor caso O(n²) |
| Complejidad espacial | O(log n) (pila de recursión) | O(log n) (pila de recursión) |
| Escenarios de aplicación | Ordenamiento general, baja tasa de elementos duplicados | Alta tasa de elementos duplicados, como ordenamiento de colores, segmentación de calificaciones |
Instrucciones de aplicabilidad
La complejidad temporal y espacial es la misma que la del ordenamiento rápido aleatorizado.
El algoritmo de ordenamiento rápido de tres vías utiliza una estrategia de partición en tres vías para dividir el array, lo que resulta muy eficaz para manejar arrays con muchos elementos duplicados y mejora el proceso de ordenamiento rápido. Añade lógica para manejar los elementos iguales al valor de partición, agrupando todos los valores iguales al elemento de partición.
Ilustración del proceso

Analicemos el proceso de partición en tres casos; i representa la posición actual del índice durante el recorrido:
(1) Si el elemento actual e = V, el elemento e se incluye directamente en el intervalo azul, y i se desplaza una posición hacia atrás.

(2) Si el elemento actual e < v, e se intercambia con el valor de la primera posición del intervalo igual a V, y tanto el índice lt como i se desplazan una posición hacia atrás.

(3) Si el elemento actual e > v, e se intercambia con el valor en la posición del índice gt-1, y el índice gt se desplaza una posición hacia adelante.

Finalmente, cuandoi=gt..., se finaliza el recorrido; también es necesario intercambiar v con el valor apuntado por el índice lt. Así se completa el proceso de ordenamiento, y luego se aplica recursivamente el mismo método a las partes del array <V y >V.
Código de ejemplo en Java
Descargar el paquete de código fuente:Download
Código del archivo QuickSort3Ways.java:
/**
* Ordenamiento rápido de tres vías
*/
public class QuickSort3Ways {
//Inicio del código principal---
// Usar recursivamente el ordenamiento rápido para ordenar el rango arr[l...r]
private static void sort(Comparable[] arr, int l, int r){
if (l >= r) {
return;
}
// Seleccionar aleatoriamente un valor como pivote en el rango arr[l...r]
swap( arr, l, (int)(Math.random()*(r-l+1)) + l );
Comparable v = arr[l];
int lt = l; // arr[l+1...lt] < v
int gt = r + 1; // arr[gt...r] > v
int i = l+1; // arr[lt+1...i) == v
while( i < gt ){
if( arr[i].compareTo(v) < 0 ){
swap( arr, i, lt+1);
i ++;
lt ++;
}
else if( arr[i].compareTo(v) > 0 ){
swap( arr, i, gt-1);
gt --;
}
else{ // arr[i] == v
i ++;
}
}
swap( arr, l, lt );
sort(arr, l, lt-1);
sort(arr, gt, r);
}
//Fin del código principal---
public static void sort(Comparable[] arr){
int n = arr.length;
sort(arr, 0, n-1);
}
private static void swap(Object[] arr, int i, int j) {
Object t = arr[i];
arr[i] = arr[j];
arr[j] = t;
}
// Probar QuickSort3Ways
public static void main(String[] args) {
// El algoritmo de ordenamiento rápido de tres vías también es un algoritmo de complejidad O(n log n)
// Puede manejar fácilmente datos del orden de un millón en menos de 1 segundo
int N = 1000000;
Integer[] arr = SortTestHelper.generateRandomArray(N, 0, 100000);
sort(arr);
SortTestHelper.printArray(arr);
}
}
Idea central y principio de funcionamiento del algoritmo
La elegancia del algoritmo de ordenamiento de tres vías radica en que utiliza tres punteros para rastrear diferentes regiones del array, completando la clasificación en tres categorías en un solo recorrido.
Estado de partición del algoritmo
Entendamos el proceso de partición del algoritmo mediante un diagrama de estado:
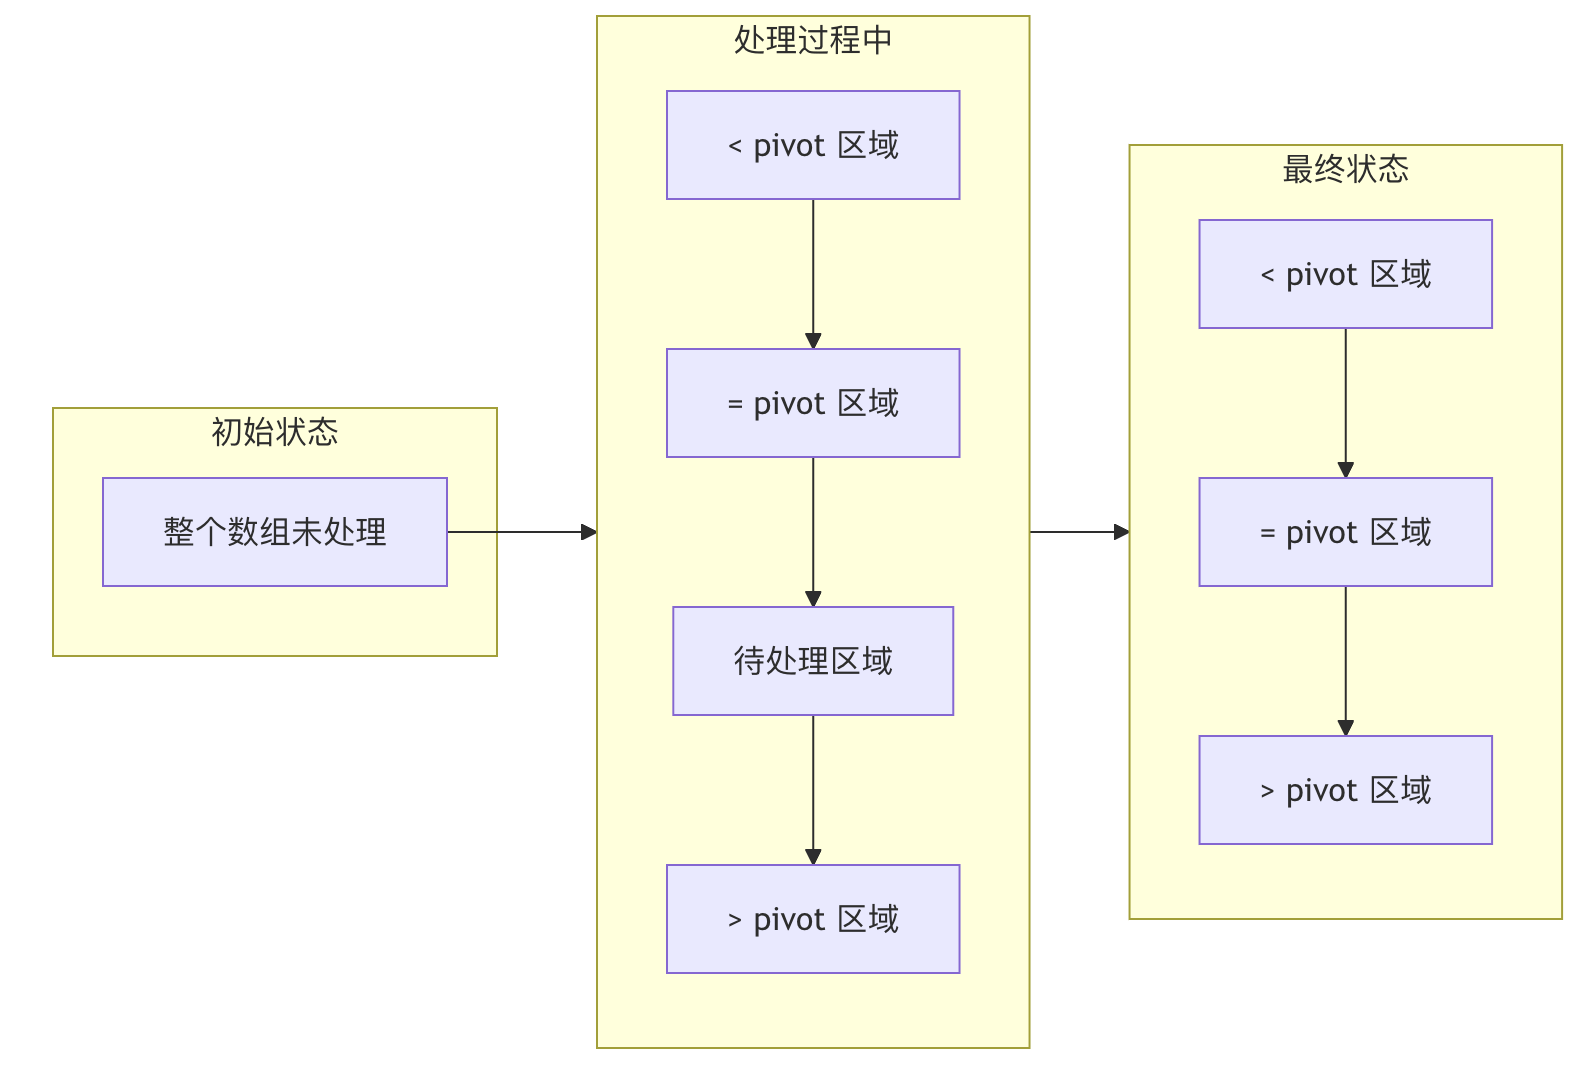
Descripción de la figura: el algoritmo mantiene tres punteros (lt, i, gt) que dividen el array en cuatro regiones; a medida que avanza el procesamiento, la región pendiente de procesar se reduce gradualmente, hasta formar finalmente tres particiones definidas.
Función de los tres punteros clave
ltPuntero (less than): apunta al final de la región de elementos menores que el pivoteiPuntero (current): posición del elemento que se está examinando actualmentegtPuntero (greater than): apunta al inicio de la región de elementos mayores que el pivote
Implementación en Python
Función básica de partición de tres vías
A continuación se muestra una implementación estándar de la función de partición de tres vías; la analizaremos línea por línea:
Ejemplo
"""
Realiza la partición de tres vías en el rango de low a high del array arr
Parámetros:
arr: el array a particionar
low: índice inicial de la partición
high: índice final de la partición
Retorna:
(lt, gt): límites izquierdo y derecho de la región igual al valor pivote
"""
# Seleccionar el valor pivote (aquí se elige el primer elemento)
pivot = arr[low]
# Inicializar los tres punteros
lt = low # Límite derecho de la región menor que el pivote (inicialmente low)
i = low + 1 # Posición del elemento que se está examinando actualmente
gt = high # Límite izquierdo de la región mayor que el pivote (inicialmente high)
# Bucle principal: continuar mientras haya elementos sin procesar
while i <= gt:
if arr[i] < pivot:
# Caso 1: el elemento actual es menor que el pivote
# Intercambiarlo con el siguiente elemento del puntero lt para expandir la región menor
arr[lt], arr[i] = arr[i], arr[lt]
lt += 1
i += 1
elif arr[i] > pivot:
# Caso 2: el elemento actual es mayor que el pivote
# Intercambiarlo con el elemento del puntero gt para expandir la región mayor
arr[i], arr[gt] = arr[gt], arr[i]
gt -= 1
# Nota: aquí no se incrementa i, porque el elemento intercambiado aún no se ha examinado
else:
# Caso 3: el elemento actual es igual al pivote
# Simplemente omitirlo, expandiendo la región igual
i += 1
# Retornar los límites de la región igual al valor pivote
return lt, gt
Implementación completa del ordenamiento rápido de tres vías
Basándonos en la función de partición anterior, podemos implementar el ordenamiento rápido de tres vías completo:
Ejemplo
"""
Función principal del ordenamiento rápido de tres vías
Parámetros:
arr: el array a ordenar
low: índice inicial de ordenamiento (por defecto 0)
high: índice final de ordenamiento (por defecto el final del array)
"""
if high is None:
high = len(arr) - 1
# Condición de terminación recursiva: longitud del subarray menor o igual que 1
if low >= high:
return
# Realizar la partición de tres vías
lt, gt = three_way_partition(arr, low, high)
# Ordenar recursivamente la parte menor que el pivote
three_way_quicksort(arr, low, lt - 1)
# Ordenar recursivamente la parte mayor que el pivote
three_way_quicksort(arr, gt + 1, high)
# Nota: la parte igual al pivote ya está en la posición correcta, no necesita ordenarse de nuevo
Ejemplos de aplicación práctica
Ejemplo 1: Problema de ordenamiento de colores
Este es un escenario clásico de aplicación del algoritmo de ordenamiento de tres vías, también conocido como el "problema de la bandera nacional holandesa".
Ejemplo
"""
Ordenamiento de colores: ordena un array que solo contiene 0 (rojo), 1 (blanco) y 2 (azul) en secuencia
Parámetros:
colors: array de colores, con elementos 0, 1, 2
Retorna:
El array de colores ordenado
"""
# Inicializar los tres punteros
red_ptr = 0 # Final de la región roja
white_ptr = 0 # Posición actual de examen (también el final de la región blanca)
blue_ptr = len(colors) - 1 # Inicio de la región azul
while white_ptr <= blue_ptr:
if colors[white_ptr] == 0:
# Rojo: intercambiar a la región roja
colors[red_ptr], colors[white_ptr] = colors[white_ptr], colors[red_ptr]
red_ptr += 1
white_ptr += 1
elif colors[white_ptr] == 1:
# Blanco: permanece en la región central
white_ptr += 1
else:
# Azul: intercambiar a la región azul
colors[white_ptr], colors[blue_ptr] = colors[blue_ptr], colors[white_ptr]
blue_ptr -= 1
# Nota: aquí no se incrementa white_ptr, porque el elemento intercambiado aún no se ha examinado
return colors
# Datos de prueba
test_colors = [2, 0, 2, 1, 1, 0, 1, 2, 0, 1, 0, 2]
print("Array de colores original:", test_colors)
print("Array de colores ordenado:", sort_colors(test_colors.copy()))
Descripción de los datos de prueba: El array anterior representa los números de color (0=rojo, 1=blanco, 2=azul). Después de ordenar, todos los 0 deben estar al principio, los 1 en el medio y los 2 al final.
Ejemplo 2: Segmentación de calificaciones de estudiantes
Supongamos que necesitamos clasificar las calificaciones de los estudiantes: menos de 60 es suspenso, 60-80 es notable, mayor de 80 es sobresaliente.
Ejemplo
"""
Dividir las calificaciones en tres niveles: suspenso (<60), notable (60-80), sobresaliente (>80)
Parámetros:
scores: array de calificaciones
Retorna:
array de calificaciones clasificadas
"""
if not scores:
return scores
# Usar la idea de partición de tres vías, con 60 y 80 como puntos de referencia
# Primero particionar por 60: suspenso vs aprobado
low = 0
mid = 0
high = len(scores) - 1
# Primera ronda: separar las calificaciones de suspenso (<60)
while mid <= high:
if scores[mid] < 60:
scores[low], scores[mid] = scores[mid], scores[low]
low += 1
mid += 1
elif scores[mid] <= 80:
mid += 1
else:
scores[mid], scores[high] = scores[high], scores[mid]
high -= 1
# Segunda ronda: en la parte de aprobados, separar notable y sobresaliente
# En este punto, low apunta a la posición de la primera calificación notable
mid = low
high = len(scores) - 1
while mid <= high:
if scores[mid] <= 80:
mid += 1
else:
scores[mid], scores[high] = scores[high], scores[mid]
high -= 1
return scores
# Datos de prueba
test_scores = [45, 78, 92, 56, 85, 67, 72, 88, 59, 95, 61, 73]
print("Calificaciones originales:", test_scores)
print("Calificaciones clasificadas:", categorize_grades(test_scores.copy()))
print("Explicación: parte inicial <60, parte media 60-80, parte final >80")
Análisis de complejidad del algoritmo
Complejidad temporal
El análisis de complejidad temporal del algoritmo de ordenación de tres vías se puede expresar con la siguiente fórmula:
$$ T(n) = O(n) + T(k) + T(n - k - m) $$
donde:
- $n$ es la longitud del array
- $k$ es el número de elementos menores que el valor pivote
- $m$ es el número de elementos iguales al valor pivote
- $n - k - m$ es el número de elementos mayores que el valor pivote
Mejor caso: Cada partición divide el array uniformemente en tres partes, la complejidad temporal es $O(n \log_3 n)$, aunque en la práctica sigue siendo $O(n \log n)$.
Peor caso: Cada partición es extremadamente desigual, la complejidad temporal es $O(n^2)$.
Caso promedio: Para datos aleatorios, la complejidad temporal promedio es $O(n \log n)$.
Complejidad espacial
El algoritmo se implementa mediante recursión, la profundidad de recursión depende de la partición:
- Mejor caso:$O(\log n)$
- Peor caso:$O(n)$
Se puede reducir el uso de espacio mediante optimización de recursión de cola o usando un enfoque iterativo.