TensorFlow-Produktionsumgebung
Als führendes Framework für maschinelles Lernen in der Branche erfordert TensorFlow die Berücksichtigung vieler Faktoren beim Übergang von einer experimentellen Umgebung in eine Produktionsumgebung.
Dieser Artikel stellt umfassend die wichtigsten Überlegungen für TensorFlow in einer Produktionsumgebung vor und hilft Entwicklern, stabile und effiziente Systeme für maschinelles Lernen zu erstellen.
1. Modelloptimierung
1.1 Modellquantisierung
Beispiel
# Beispiel für Post-Training-Quantisierung
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
- 8-Bit-Ganzzahl-Quantisierung: Reduziert die Modellgröße um 75%, verbessert die Inferenzgeschwindigkeit um das 3- bis 4-Fache
- 16-Bit-Gleitkomma-Quantisierung: Leistungsverbesserung auf GPU, minimaler Genauigkeitsverlust
- Dynamische Bereichsquantisierung: Quantisiert nur Gewichte, Aktivierungen bleiben während der Inferenz Gleitkommazahlen
1.2 Modell-Pruning
Beispiel
# Pruning mit dem TensorFlow Model Optimization Toolkit
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
- Entfernt Neuronverbindungen, die wenig Einfluss auf die Ausgabe haben
- Reduziert typischerweise die Parameter um 60%, ohne die Genauigkeit wesentlich zu beeinträchtigen
- Erfordert Feinabstimmung, um einen Teil des Genauigkeitsverlusts auszugleichen
1.3 Modell-Destillation
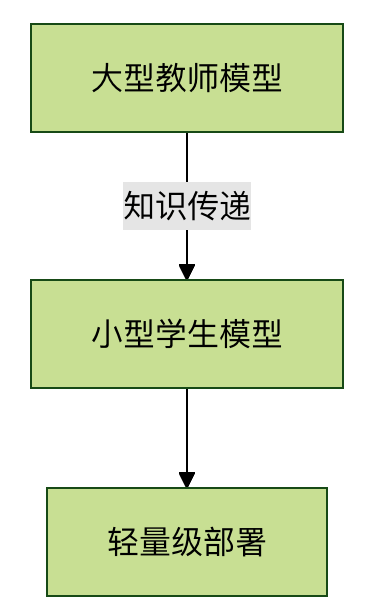
- Verwendet ein großes Modell, um das Training eines kleinen Modells zu leiten
- Behält über 90% Genauigkeit bei, während die Parameteranzahl um 90% reduziert wird
- Besonders geeignet für Deployment-Szenarien auf Edge-Geräten
2. Bereitstellungsarchitektur
2.1 Vergleich der Service-Modi
| Bereitstellungsmethode | Latenz | Durchsatz | Ressourcennutzung | Geeignete Szenarien |
|---|---|---|---|---|
| TensorFlow Serving | Mittel | Hoch | Mittel | Cloud-Dienste, hohe Nebenläufigkeit |
| TFLite | Niedrig | Mittel | Niedrig | Mobile/IoT-Geräte |
| ONNX Runtime | Mittel | Hoch | Mittel | Einheitliche Bereitstellung über mehrere Frameworks hinweg |
| Benutzerdefinierter gRPC-Dienst | Anpassbar | Anpassbar | Anpassbar | Szenarien mit speziellen Anforderungen |
2.2 Microservices-Architektur
Beispiel
# Einfacher Modellservice, mit Flask erstellt
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
- Containerisierung: Es wird empfohlen, Docker zum Paketieren des Modells und der Umgebung zu verwenden
- Service Discovery: Kombiniert mit Kubernetes für automatische Skalierung
- Monitoring-Integration: Prometheus + Grafana Monitoring-System
3. Leistungsoptimierung
3.1 Hardwarebeschleunigung
GPU-Optimierungstechniken:
- Verwenden Sie
tf.config.optimizer.set_jit(True)XLA-Kompilierung aktivieren - Eingabedaten im Batch verarbeiten (typische Batch-Größe 32-256)
- Mixed-Precision-Training verwenden (
tf.keras.mixed_precision)
TPU-Konfiguration:
Beispiel
resolver = tf.distribute.cluster_resolver.TPUClusterResolver()
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
3.2 Graph-Optimierung
Beispiel
# Optimierung der Sitzungskonfiguration
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
- Konstantenfaltung
- Operationsfusion
- Eliminierung toten Codes
- Speicheroptimierung
4. Monitoring und Wartung
4.1 Wichtige Monitoring-Metriken
Systemmetriken:
- GPU/CPU-Auslastung
- Speicherverbrauch
- Anfragelatenz (P50/P90/P99)
Modellmetriken:
- Verteilung der Vorhersagekonfidenz
- Drift der Eingabedatenverteilung
- Metriken für Modellzerfall
4.2 A/B-Testing-Framework
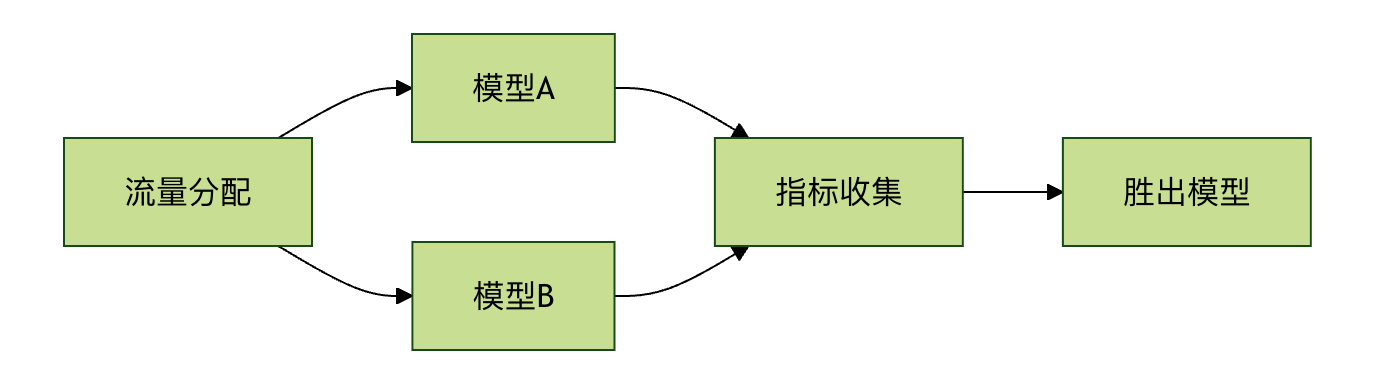
- Schrittweise Traffic-Umschaltung (5% → 50% → 100%)
- Mehrdimensionaler Metrikvergleich (Geschäftsmetriken + technische Metriken)
- Automatischer Rollback-Mechanismus
5. Sicherheitsüberlegungen
5.1 Modellschutz
- Verwenden Sie
tf.saved_model.saveVerschlüsselte Modelle - Modell-Wasserzeichen-Technologie implementieren
- Deployment-Schlüssel regelmäßig rotieren
5.2 Eingabevalidierung
Beispiel
# Beispiel für Eingabedatenvalidierung
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("Die Eingabe muss ein numpy-Array sein")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"Die Form muss {EXPECTED_SHAPE} sein")
if np.isnan(input_data).any():
raise ValueError("Eingabe enthält NaN-Werte")
- Überprüfung des Datentyps
- Validierung des numerischen Bereichs
- Filterung abnormaler Eingaben
6. Kontinuierliche Integration und Bereitstellung
6.1 ML-Pipeline-Entwurf
Beispiel
# Einfache Pipeline, erstellt mit TFX
from tfx.components import Trainer
from tfx.proto import trainer_pb2
trainer = Trainer(
module_file=module_file,
transformed_examples=transform.outputs['transformed_examples'],
schema=infer_schema.outputs['schema'],
train_args=trainer_pb2.TrainArgs(num_steps=10000),
eval_args=trainer_pb2.EvalArgs(num_steps=5000))
- Automatisiertes Modelltraining
- Automatisierte Modellbewertung
- Automatisiertes Modell-Deployment
6.2 Versionskontrollstrategie
- Modellversion an Codeversion gebunden
- Beibehaltung von Daten-Snapshots
- Vollständige Experimentaufzeichnungen