TensorFlow-Datenverarbeitung und Pipelines
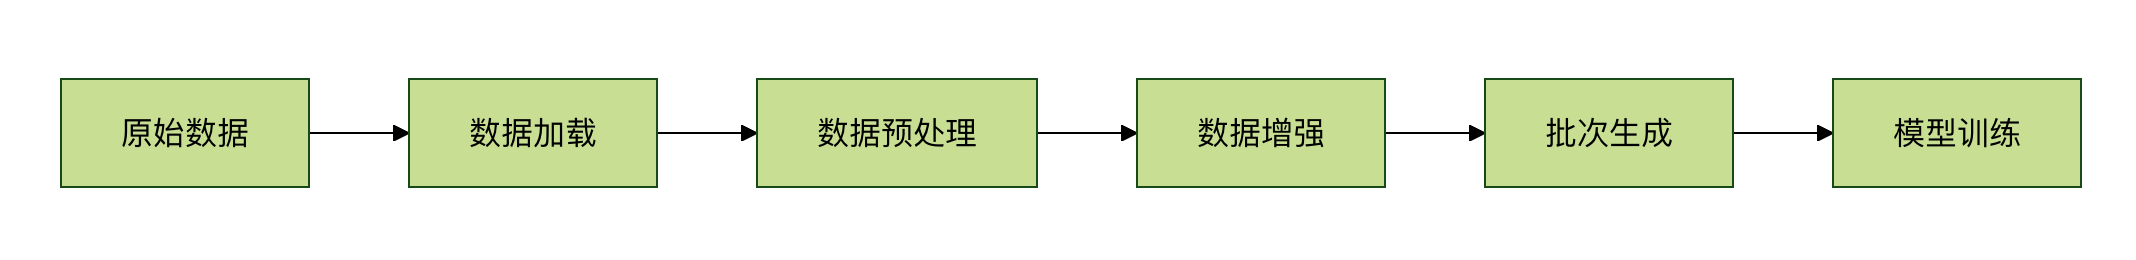
Die TensorFlow-Datenverarbeitungspipeline ist ein zentraler Bestandteil des Machine-Learning-Workflows. Sie ist für das effiziente Laden, Vorverarbeiten und Übertragen von Daten an das Modell verantwortlich.
Im Vergleich zu traditionellen direkten Datenlademethoden bietet die TensorFlow-Pipeline drei wesentliche Vorteile:
- Leistungsoptimierung: Reduzierung von I/O-Engpässen durch Parallelisierung und Prefetching
- Speichereffizienz: Vermeidung des gleichzeitigen Ladens aller Daten in den Speicher
- Sauberer Code: Entkopplung der Datenverarbeitungslogik vom Modellcode
Kernkonzepte
Dataset-API
Die TensorFlow Dataset API ist das Kernwerkzeug für den Aufbau von Datenpipelines. Sie bietet verschiedene Datenquellenschnittstellen und Transformationsoperationen:
Beispiel
# Datensatz aus dem Arbeitsspeicher erstellen
data = tf.data.Dataset.from_tensor_slices([1, 2, 3])
# Aus Textdatei erstellen
text_data = tf.data.TextLineDataset(["file1.txt", "file2.txt"])
# Aus TFRecord erstellen
tfrecord_data = tf.data.TFRecordDataset("data.tfrecord")
Techniken zur Datenvorverarbeitung
Übliche Vorverarbeitungsoperationen umfassen:
- Standardisierung:
(x - mean) / std - Normalisierung:
(x - min) / (max - min) - One-Hot-Encoding:
tf.one_hot() - Auffüllen/Kürzen:
tf.keras.preprocessing.sequence.pad_sequences
Schritte zum Aufbau einer Pipeline
1. Datenladen
Wählen Sie die geeignete Lademethode basierend auf der Datenquelle:
Beispiel
def load_image(path):
img = tf.io.read_file(path)
img = tf.image.decode_jpeg(img, channels=3)
return tf.image.resize(img, [256, 256])
image_dataset = tf.data.Dataset.list_files("images/*.jpg")
image_dataset = image_dataset.map(load_image)
2. Datenvorverarbeitung
Verwenden Siemap()Methode zum Anwenden der Vorverarbeitungsfunktion:
Beispiel
return image / 255.0 # Normalisieren auf den Bereich 0-1
normalized_dataset = image_dataset.map(normalize)
3. Daten-Augmentierung
Häufige Augmentierungstechniken, die während des Trainings verwendet werden:
Beispiel
image = tf.image.random_flip_left_right(image)
image = tf.image.random_brightness(image, max_delta=0.2)
return image
augmented_dataset = normalized_dataset.map(augment)
4. Batch-Verarbeitung
Batchgröße und Prefetching konfigurieren:
Beispiel
train_dataset = augmented_dataset.batch(BATCH_SIZE)
train_dataset = train_dataset.prefetch(tf.data.AUTOTUNE)
Fortgeschrittene Optimierungstechniken
Strategien zur Leistungsoptimierung
| Strategie | Methode | Wirkung |
|---|---|---|
| Parallelisierung | num_parallel_calls=tf.data.AUTOTUNE |
Datenladen beschleunigen |
| Vorabrufen | prefetch(buffer_size=tf.data.AUTOTUNE) |
Wartezeit reduzieren |
| Zwischenspeicherung | cache() |
Wiederholte Berechnungen vermeiden |
Beispiel
.map(load_image, num_parallel_calls=tf.data.AUTOTUNE)
.cache()
.map(augment, num_parallel_calls=tf.data.AUTOTUNE)
.batch(32)
.prefetch(tf.data.AUTOTUNE))
Gedächtnisverwaltung
Beim Umgang mit großen Datensätzen:
- Verwenden Sie
TFRecordFormat zum Speichern von Daten - Sharded-Verarbeitung:
dataset.shard(num_shards, index) - Streaming-Verarbeitung: vermeiden
cache()groß
Praktisches Beispiel: Bildklassifizierungs-Pipeline
Vollständiger Datenverarbeitungsablauf für die Bildklassifizierung:
Beispiel
# 1. Daten laden
dataset = tf.data.Dataset.list_files(f"{image_dir}/*/*.jpg")
# 2. Parsen und Vorverarbeiten
def process_path(file_path):
label = tf.strings.split(file_path, os.sep)[-2]
image = load_image(file_path)
return image, label
dataset = dataset.map(process_path, num_parallel_calls=tf.data.AUTOTUNE)
# 3. Augmentation während des Trainings
if is_training:
dataset = dataset.map(
lambda x, y: (augment(x), y),
num_parallel_calls=tf.data.AUTOTUNE
)
# 4. Konfiguration optimieren
dataset = dataset.batch(batch_size)
dataset = dataset.prefetch(tf.data.AUTOTUNE)
return dataset
Häufige Probleme und Lösungen
Fehlerbehebung bei Leistungsengpässen
Geringe CPU-Auslastung
- Erhöhen
num_parallel_calls - Verwenden Sie
interleave()E/A parallelisieren
- Erhöhen
Geringe GPU-Auslastung
- Erhöhen
prefetch_buffer_size - Prüfen Sie, ob die Batch-Größe angemessen ist
- Erhöhen
Umgang mit Datenverzerrung
Beispiel
dataset = dataset.apply(
tf.data.experimental.sample_from_datasets(
[class1_ds, class2_ds],
weights=[0.7, 0.3]
)
)
Best-Practice-Empfehlungen
1. Prinzipien des Pipeline-Designs
- Zeitaufwändige Operationen in frühe Phasen legen
- Vorverarbeitungsoperationen deterministisch halten
- Daten-Augmentierung für das Validierungsset deaktivieren
2. Überwachungswerkzeuge
Beispiel
tf.data.experimental.latency_stats()
3. Versionskompatibilität
- Für TF 2.x wird die Verwendung empfohlen
tf.dataAPI - Vermeiden Sie das Mischen
feed_dictAnsätze
Durch die richtige Gestaltung der TensorFlow-Datenpipeline können Sie die Trainingsgeschwindigkeit um das 2- bis 5-Fache erhöhen und gleichzeitig den Code sauber und wartbar halten.
Andere Erweiterungen