TensorFlow Modellbewertung und -überwachung
1. Grundlegende Konzepte der Modellbewertung
In Projekten des maschinellen Lernens ist die Modellbewertung ein entscheidender Schritt zur Validierung der Modellleistung. Sie hilft uns zu verstehen, wie das Modell in realen Szenarien abschneidet, und leitet uns bei der Modelloptimierung.
1.1 Warum benötigen wir Modellbewertung
- Leistungsüberprüfung: Bestätigen, ob das Modell die erwarteten Ergebnisse erreicht
- Modellauswahl: Stärken und Schwächen verschiedener Modelle vergleichen
- Parametertuning: Die Richtung der Hyperparameter-Anpassung vorgeben
- Overfitting vermeiden: Erkennen, ob das Modell an die Trainingsdaten überangepasst ist
1.2 Arten von Bewertungsmetriken
| Metriktyp | Anwendungsfall | Gängige Metriken |
|---|---|---|
| Klassifikationsmetriken | Klassifikationsprobleme | Genauigkeit, Präzision, Recall, F1-Score |
| Regressionsmetriken | Regressionsprobleme | MSE, MAE, R² |
| Clustering-Metriken | Unüberwachtes Lernen | Silhouette-Koeffizient, Davies-Bouldin-Index |
2. TensorFlow-Evaluierungswerkzeuge
TensorFlow bietet eine Vielzahl von Werkzeugen und Methoden zur Bewertung der Modellleistung.
2.1 Integrierte Evaluierungsmetriken
Beispiel
import tensorflow as tf
# Häufig verwendete Klassifikationsmetriken
metrics = [
tf.keras.metrics.BinaryAccuracy(),
tf.keras.metrics.Precision(),
tf.keras.metrics.Recall(),
tf.keras.metrics.AUC()
]
# Häufig verwendete Regressionsmetriken
metrics = [
tf.keras.metrics.MeanSquaredError(),
tf.keras.metrics.MeanAbsoluteError(),
tf.keras.metrics.RootMeanSquaredError()
]
2.2 Evaluierungsprozess
1. Metriken beim Kompilieren des Modells angeben
Beispiel
model.compile(
optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy', tf.keras.metrics.AUC()]
)
optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy', tf.keras.metrics.AUC()]
)
2. Verwende die evaluate-Methode zur Auswertung
Beispiel
test_loss, test_acc, test_auc = model.evaluate(
test_images, test_labels, verbose=2
)
test_images, test_labels, verbose=2
)
3. Benutzerdefinierte Auswertungsfunktionen
Beispiel
import tensorflow as tf
@tf.function
def custom_metric(y_true, y_pred):
threshold = 0.5
y_pred = tf.cast(y_pred > threshold, tf.float32)
# Berechne die Genauigkeit, nicht nur den Anteil positiver Beispiele
correct_predictions = tf.cast(tf.equal(y_true, y_pred), tf.float32)
return tf.reduce_mean(correct_predictions)
model.compile(
optimizer='adam',
loss='binary_crossentropy',
metrics=[custom_metric, 'accuracy'] # Du kannst auch die Standard-Genauigkeitsmetrik als Referenz beibehalten
)
3. Modellüberwachung und Visualisierung
1. TensorBoard-Integration
TensorBoard ist TensorFlows Visualisierungstool, das die Echtzeitüberwachung des Trainingsprozesses ermöglicht.
Beispiel
# Callback-Funktion einrichten
tensorboard_callback = tf.keras.callbacks.TensorBoard(
log_dir='./logs',
histogram_freq=1,
write_graph=True,
write_images=True
)
# Callback beim Trainieren des Modells hinzufügen
model.fit(
train_data,
epochs=10,
validation_data=val_data,
callbacks=[tensorboard_callback]
)
tensorboard_callback = tf.keras.callbacks.TensorBoard(
log_dir='./logs',
histogram_freq=1,
write_graph=True,
write_images=True
)
# Callback beim Trainieren des Modells hinzufügen
model.fit(
train_data,
epochs=10,
validation_data=val_data,
callbacks=[tensorboard_callback]
)
TensorBoard starten:
tensorboard --logdir=./logs
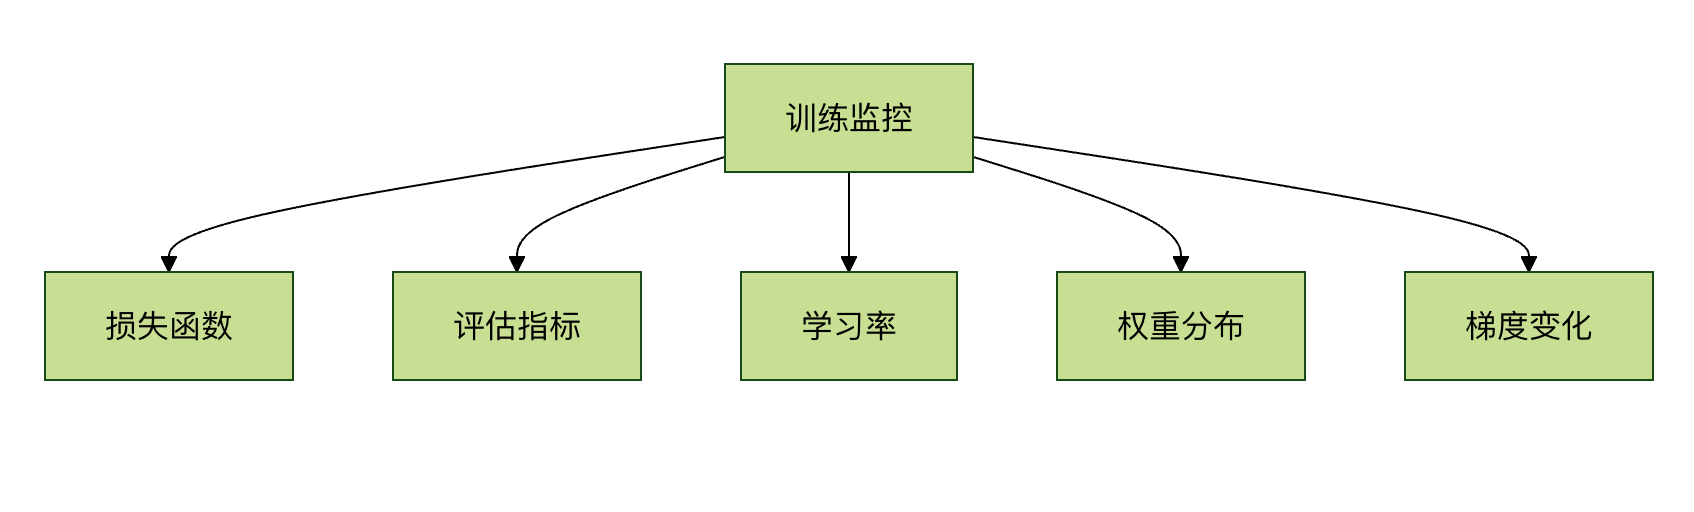
2. Wichtige Metriken zur Überwachung
4. Fortgeschrittene Evaluierungstechniken
4.1 Kreuzvalidierung
Beispiel
from sklearn.model_selection import KFold
import numpy as np
# Daten vorbereiten
X = np.array(...)
y = np.array(...)
# 5-fache Kreuzvalidierung
kfold = KFold(n_splits=5, shuffle=True)
fold_no = 1
for train, test in kfold.split(X, y):
# Modell erstellen
model = create_model()
# Modell trainieren
model.fit(X[train], y[train], epochs=10)
# Modell evaluieren
scores = model.evaluate(X[test], y[test])
print(f'Fold {fold_no} - {model.metrics_names[0]}: {scores[0]}')
fold_no += 1
4.2 Analyse der Konfusionsmatrix
Beispiel
from sklearn.metrics import confusion_matrix
import seaborn as sns
import matplotlib.pyplot as plt
# Vorhersageergebnisse abrufen
y_pred = model.predict(test_images)
y_pred_classes = np.argmax(y_pred, axis=1)
# Konfusionsmatrix generieren
conf_mat = confusion_matrix(test_labels, y_pred_classes)
# Visualisierung
plt.figure(figsize=(10, 8))
sns.heatmap(conf_mat, annot=True, fmt='d')
plt.xlabel('Vorhergesagt')
plt.ylabel('Tatsächlich')
plt.show()
5. Modellüberwachung nach dem Deployment
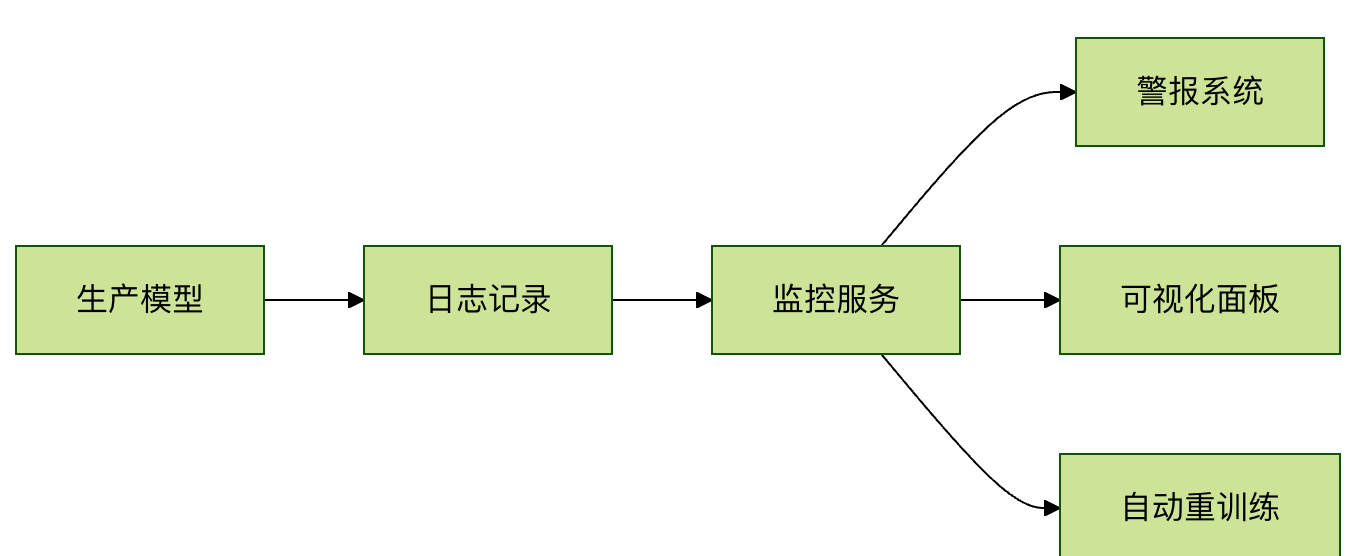
5.1 Wichtige Punkte für die Überwachung der Produktionsumgebung
- Data-Drift-Erkennung: Überwachen Sie Änderungen in der Verteilung der Eingabedaten
- Konzeptdrift-Erkennung: Überwachen Sie Änderungen in der Beziehung zwischen Merkmalen und Zielvariablen
- Erkennung von Leistungsverschlechterung: Modellleistung regelmäßig bewerten
- Erkennung anomaler Eingaben: Anomale Eingabebeispiele identifizieren
5.2 Monitoring-Systemarchitektur
6. Praktische Übung
6.1 Praktische Aufgaben
- Ein einfaches CNN-Modell auf dem MNIST-Datensatz trainieren
- Implementieren Sie die folgenden Evaluierungsfunktionen:
- Überwachung von Genauigkeit und Verlust während des Trainingsprozesses
- Konfusionsmatrix-Analyse auf dem Testset
- Verwenden Sie TensorBoard, um den Trainingsprozess zu visualisieren
- Versuchen Sie, benutzerdefinierte Evaluierungsmetriken zu implementieren
6.2 Referenzcode-Framework
Beispiel
import tensorflow as tf
from tensorflow.keras import layers
# 1. Datenvorbereitung
(train_images, train_labels), (test_images, test_labels) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape((60000, 28, 28, 1)).astype('float32') / 255
test_images = test_images.reshape((10000, 28, 28, 1)).astype('float32') / 255
# 2. Modellaufbau
model = tf.keras.Sequential([
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
layers.Flatten(),
layers.Dense(10, activation='softmax')
])
# 3. Kompilieren Sie das Modell (fügen Sie die Metriken Ihrer Wahl hinzu)
model.compile(...)
# 4. Trainieren Sie das Modell (TensorBoard-Callback hinzufügen)
history = model.fit(...)
# 5. Modell evaluieren
test_loss, test_acc = model.evaluate(...)
# 6. Konfusionsmatrix-Analyse
# Ihr Code...