TensorFlow 本番環境
TensorFlowは業界をリードする機械学習フレームワークであり、実験環境から本番環境へ移行する際には多くの要素を考慮する必要があります。
本記事では、TensorFlowを本番環境で利用する際の重要な考慮点を包括的に紹介し、開発者が安定した高効率な機械学習システムを構築するのに役立ちます。
1. モデル最適化
1.1 モデル量子化
例
# 学習後量子化の例
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
- 8ビット整数量子化:モデルサイズを75%削減し、推論速度を3〜4倍向上
- 16ビット浮動小数点数量子化:GPU上でのパフォーマンス向上、精度の損失は小さい
- ダイナミックレンジ量子化:重みのみ量子化し、推論時のアクティベーションは浮動小数点を維持
1.2 モデル枝刈り
例
# TensorFlow Model Optimization Toolkitを使用した枝刈り
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
- 出力への影響が小さいニューロン接続を除去
- 通常、精度に大きな影響を与えずにパラメータを60%削減可能
- 精度の一部を回復するためにファインチューニングが必要
1.3 モデル蒸留
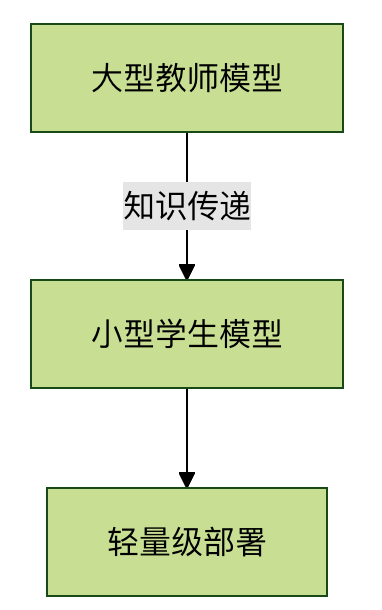
- 大規模モデルを使って小規模モデルのトレーニングを指導
- 90%以上の精度を維持しつつ、パラメータ数を90%削減
- エッジデバイスへのデプロイに特に適している
2. デプロイアーキテクチャ
2.1 サービスモードの比較
| デプロイ方式 | レイテンシ | スループット | リソース使用量 | 適用シナリオ |
|---|---|---|---|---|
| TensorFlow Serving | 中 | 高 | 中 | クラウドサービス、高並行処理 |
| TFLite | 低 | 中 | 低 | モバイル/IoTデバイス |
| ONNX Runtime | 中 | 高 | 中 | マルチフレームワーク統一的デプロイ |
| カスタムgRPCサービス | 調整可能 | 調整可能 | 調整可能 | 特殊な要件のシナリオ |
2.2 マイクロサービスアーキテクチャ
例
# Flaskで構築したシンプルなモデルサービス
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
- コンテナ化:Dockerを使ってモデルと環境をパッケージ化することを推奨
- サービスディスカバリ:Kubernetesと連携して自動スケーリングを実現
- 監視統合:Prometheus + Grafanaの監視システム
3. パフォーマンス最適化
3.1 ハードウェアアクセラレーション
GPU最適化のヒント:
- 使用
tf.config.optimizer.set_jit(True)XLAコンパイルを有効にする - 入力データをバッチ処理する(一般的なバッチサイズは32〜256)
- 混合精度トレーニングを使用(
tf.keras.mixed_precision)
TPU構成:
例
resolver = tf.distribute.cluster_resolver.TPUClusterResolver()
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
3.2 グラフ最適化
例
# セッション構成の最適化
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
- 定数折りたたみ
- オペレーション融合
- デッドコード除去
- メモリ最適化
4. 監視とメンテナンス
4.1 主要な監視指標
システム指標:
- GPU/CPU使用率
- メモリ使用量
- リクエストレイテンシ(P50/P90/P99)
モデル指標:
- 予測信頼度の分布
- 入力データ分布のシフト
- モデル劣化指標
4.2 A/Bテストフレームワーク
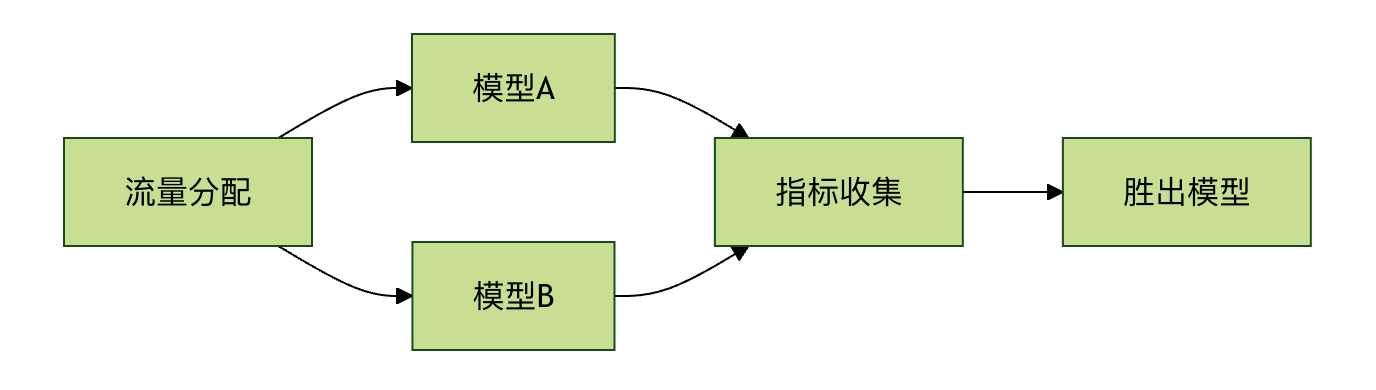
- 段階的なトラフィック切り替え(5% → 50% → 100%)
- 多次元の指標比較(ビジネス指標+技術指標)
- 自動ロールバック機構
5. セキュリティへの考慮
5.1 モデル保護
- 使用
tf.saved_model.saveモデルの暗号化 - モデル透かし技術の実装
- デプロイキーを定期的にローテーション
5.2 入力検証
例
# 入力データ検証の例
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("Input must be numpy array")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"Shape must be {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("Input contains NaN values")
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("Input must be numpy array")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"Shape must be {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("Input contains NaN values")
- データ型チェック
- 数値範囲の検証
- 異常な入力のフィルタリング
6. 継続的インテグレーションとデリバリー
6.1 MLパイプライン設計
例
# TFXで構築したシンプルなパイプライン
from tfx.components import Trainer
from tfx.proto import trainer_pb2
trainer = Trainer(
module_file=module_file,
transformed_examples=transform.outputs['transformed_examples'],
schema=infer_schema.outputs['schema'],
train_args=trainer_pb2.TrainArgs(num_steps=10000),
eval_args=trainer_pb2.EvalArgs(num_steps=5000))
- 自動化されたモデルトレーニング
- 自動化されたモデル評価
- 自動化されたモデルデプロイ
6.2 バージョン管理戦略
- モデルバージョンとコードバージョンの紐付け
- データスナップショットの保存
- 完全な実験記録