Entorno de producción de TensorFlow
TensorFlow, como marco líder en la industria para el aprendizaje automático, requiere considerar muchos factores al migrar del entorno experimental al entorno de producción.
Este artículo presenta de manera integral los puntos clave a considerar para TensorFlow en el entorno de producción, ayudando a los desarrolladores a construir sistemas de aprendizaje automático estables y eficientes.
1. Optimización del modelo
1.1 Cuantización del modelo
Ejemplo
# Ejemplo de cuantización posterior al entrenamiento
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
- Cuantización de enteros de 8 bits: reduce el tamaño del modelo en un 75% y mejora la velocidad de inferencia de 3 a 4 veces
- Cuantización de coma flotante de 16 bits: mejora el rendimiento en GPU con una pérdida de precisión menor
- Cuantización de rango dinámico: solo cuantiza los pesos; las activaciones permanecen en coma flotante durante la inferencia
1.2 Poda del modelo
Ejemplo
# Poda usando el Kit de herramientas de optimización de modelos de TensorFlow
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
- Elimina conexiones neuronales con poco impacto en la salida
- Típicamente puede reducir el 60% de los parámetros sin afectar significativamente la precisión
- Requiere ajuste fino para recuperar parte de la pérdida de precisión
1.3 Destilación del modelo
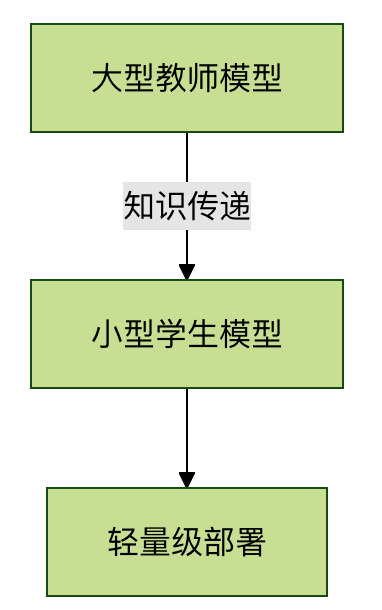
- Utiliza un modelo grande para guiar el entrenamiento de un modelo pequeño
- Mantiene más del 90% de la precisión mientras reduce el 90% de los parámetros
- Especialmente adecuado para escenarios de implementación en dispositivos periféricos
2. Arquitectura de implementación
2.1 Comparación de modos de servicio
| Método de implementación | Latencia | Rendimiento (throughput) | Uso de recursos | Escenarios aplicables |
|---|---|---|---|---|
| TensorFlow Serving | Medio | Alto | Medio | Servicios en la nube, alta concurrencia |
| TFLite | bajo | Medio | bajo | Dispositivos móviles/IoT |
| ONNX Runtime | Medio | Alto | Medio | Implementación unificada de múltiples marcos |
| Servicio gRPC personalizado | Ajustable | Ajustable | Ajustable | Escenarios con requisitos especiales |
2.2 Arquitectura de microservicios
Ejemplo
# Servicio de modelo simple construido con Flask
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
- Contenerización: se recomienda usar Docker para empaquetar el modelo y el entorno
- Descubrimiento de servicios: se integra con Kubernetes para lograr escalado automático
- Integración de monitoreo: sistema de monitoreo con Prometheus + Grafana
3. Optimización del rendimiento
3.1 Aceleración de hardware
Técnicas de optimización de GPU:
- Usar
tf.config.optimizer.set_jit(True)Habilitar la compilación XLA - Procesar datos de entrada por lotes (tamaño de lote típico de 32-256)
- Usar entrenamiento de precisión mixta (
tf.keras.mixed_precision)
Configuración de TPU:
Ejemplo
resolver = tf.distribute.cluster_resolver.TPUClusterResolver()
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
3.2 Optimización de grafos
Ejemplo
# Optimización de la configuración de sesión
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
- Plegado de constantes
- Fusión de operaciones
- Eliminación de código muerto
- Optimización de memoria
4. Monitoreo y mantenimiento
4.1 Métricas clave de monitoreo
Métricas del sistema:
- Utilización de GPU/CPU
- Uso de memoria
- Latencia de solicitudes (P50/P90/P99)
Métricas del modelo:
- Distribución de confianza de predicciones
- Desviación en la distribución de datos de entrada
- Métricas de degradación del modelo
4.2 Marco de pruebas A/B
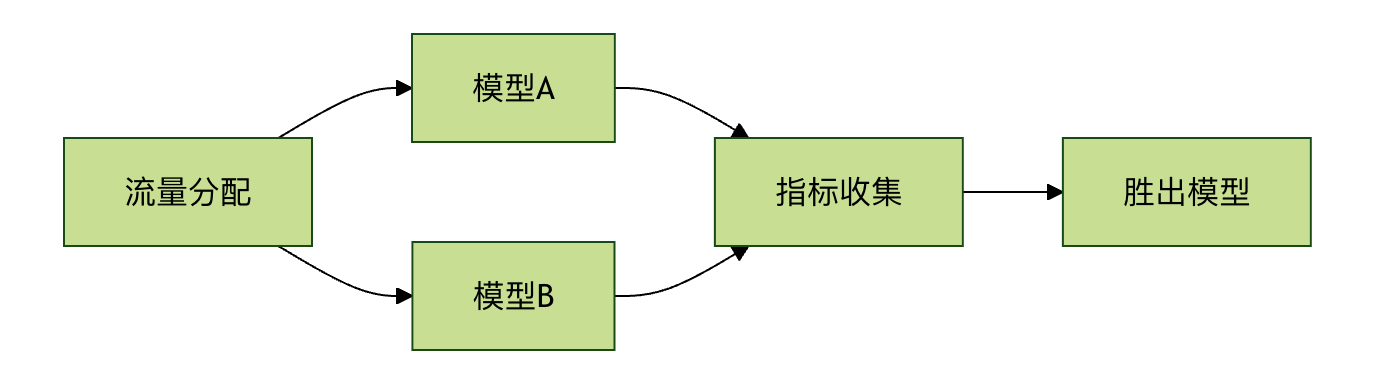
- Cambio gradual de tráfico (5% → 50% → 100%)
- Comparación de métricas multidimensionales (métricas de negocio + métricas técnicas)
- Mecanismo de reversión automática
5. Consideraciones de seguridad
5.1 Protección del modelo
- Usar
tf.saved_model.saveCifrar el modelo - Implementar tecnología de marcas de agua en el modelo
- Rotar periódicamente las claves de implementación
5.2 Validación de entrada
Ejemplo
# Ejemplo de validación de datos de entrada
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("Input must be numpy array")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"Shape must be {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("Input contains NaN values")
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("Input must be numpy array")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"Shape must be {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("Input contains NaN values")
- Verificación del tipo de datos
- Validación del rango de valores
- Filtrado de entradas anómalas
6. Integración y entrega continuas
6.1 Diseño de pipelines de ML
Ejemplo
# Pipeline simple construido con TFX
from tfx.components import Trainer
from tfx.proto import trainer_pb2
trainer = Trainer(
module_file=module_file,
transformed_examples=transform.outputs['transformed_examples'],
schema=infer_schema.outputs['schema'],
train_args=trainer_pb2.TrainArgs(num_steps=10000),
eval_args=trainer_pb2.EvalArgs(num_steps=5000))
- Entrenamiento automatizado de modelos
- Evaluación automatizada de modelos
- Implementación automatizada de modelos
6.2 Estrategia de control de versiones
- Vincular la versión del modelo con la versión del código
- Guardado de instantáneas de datos
- Registro completo de experimentos