Node.js-Grundkonzepte
Node.js ist eine JavaScript-Laufzeitumgebung, die auf der Chrome V8 JavaScript-Engine basiert. Einfach ausgedrückt ermöglicht Node.js, JavaScript serverseitig auszuführen, nicht nur in Browsern.
Kernmerkmale von Node.js
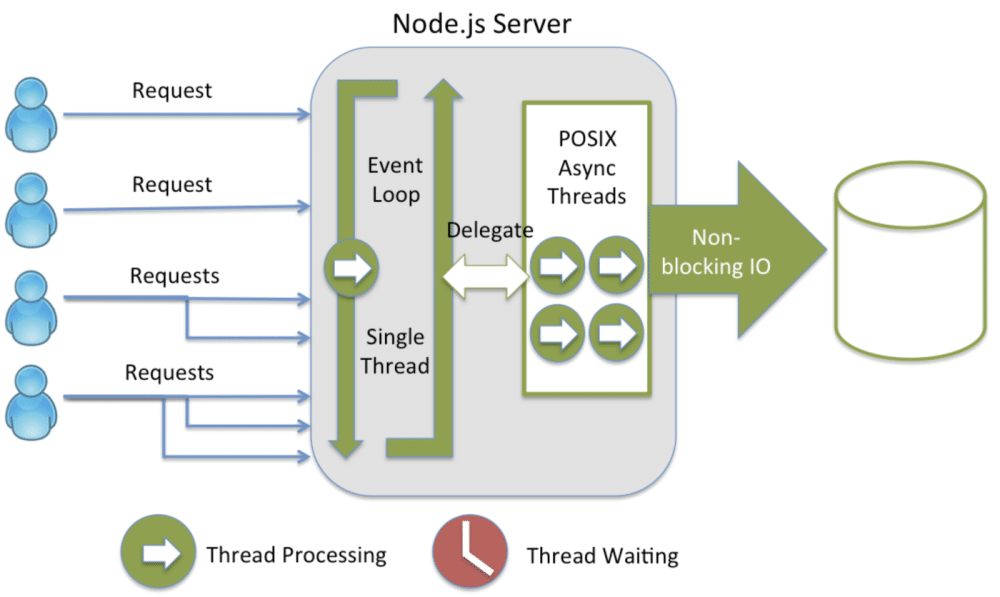
1. Single-Threaded Event-Loop
- Node.js verwendet ein Single-Threaded-Event-Loop-Modell
- Verarbeitet gleichzeitige Anfragen durch ereignisgesteuerte Mechanismen und Callback-Funktionen
- Vermeidet den Thread-Wechsel-Overhead der traditionellen Multithread-Programmierung
2. Nicht blockierendes I/O
- Alle I/O-Operationen (Dateilesen/-schreiben, Netzwerkanfragen usw.) sind asynchron
- Während auf den Abschluss einer I/O-Operation gewartet wird, wird das Programm nicht blockiert und kann weiterhin andere Aufgaben bearbeiten
- Verbessert den Anwendungsdurchsatz erheblich
3. Plattformübergreifend
- Unterstützt mehrere Betriebssysteme wie Windows, macOS und Linux
- Einmal schreiben, überall ausführen
4. Reichhaltiges Ökosystem
- npm (Node Package Manager) verfügt über Millionen von Open-Source-Paketen
- Aktive Entwickler-Community
Unterschiede zu traditionellen serverseitigen Technologien
1. Traditionelle serverseitige Technologien (z. B. Apache + PHP):
请求1 → 创建线程1 → 处理请求 → 返回响应 → 销毁线程1
请求2 → 创建线程2 → 处理请求 → 返回响应 → 销毁线程2
请求3 → 创建线程3 → 处理请求 → 返回响应 → 销毁线程3
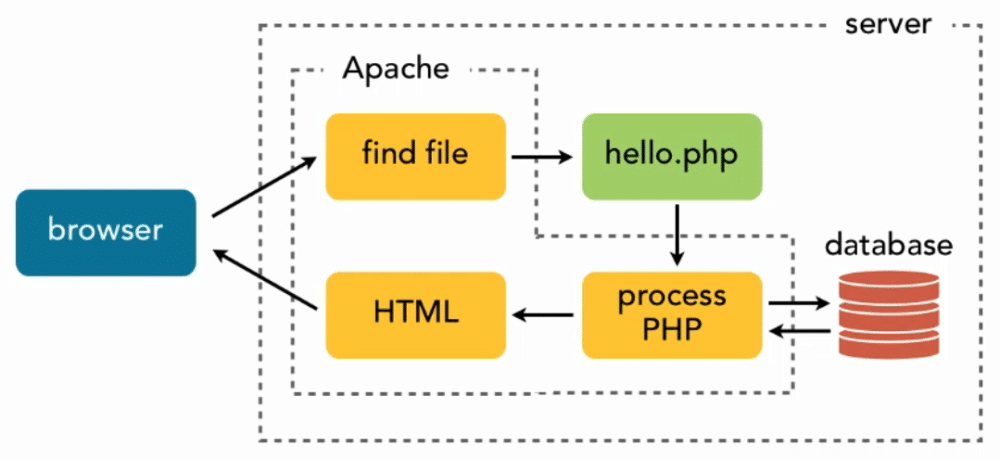
2. Wie Node.js Anfragen verarbeitet:
请求1 → 事件循环 → 处理请求 → 返回响应
请求2 → 事件循环 → 处理请求 → 返回响应  (复用同一线程)
请求3 → 事件循环 → 处理请求 → 返回响应
| Merkmal | Traditionelles Multi-Threaded-Modell | Node.js-Single-Threaded-Modell |
|---|---|---|
| Speicherverbrauch | Jeder Thread belegt etwa 2MB | Single-Threaded, geringer Speicherverbrauch |
| Umgang mit Nebenläufigkeit | Die Anzahl der Threads begrenzt die Nebenläufigkeit | Event-Loop bewältigt hohe Nebenläufigkeit |
| Kontextwechsel | Overhead durch häufige Thread-Wechsel | Kein Overhead durch Thread-Wechsel |
| Programmierkomplexität | Erfordert Umgang mit Thread-Synchronisierung | Vermeidet Probleme mit Sperren und Thread-Synchronisierung |
| Geeignete Szenarien | CPU-intensive Aufgaben | I/O-intensive Aufgaben |
Anwendungsszenarien von Node.js
1. Geeignete Anwendungsszenarien
Webanwendungen
- RESTful-API-Dienste
- Backend-Dienste für Single-Page-Anwendungen (SPA)
- Echtzeit-Webanwendungen
Echtzeitanwendungen
- Chat-Anwendungen
- Online-Spiele
- Kollaborationstools (z. B. Online-Dokumentbearbeitung)
Microservices-Architektur
- Leichtgewichtige Microservices
- API-Gateways
- Kommunikation zwischen Diensten
Werkzeuge und Kommandozeilenanwendungen
- Build-Tools (z. B. Webpack, Gulp)
- Scaffolding-Tools
- Automatisierungsskripte
Internet der Dinge (IoT)-Anwendungen
- Gerätedatenerfassung
- Sensordatenverarbeitung
2. Ungeeignete Anwendungsszenarien
CPU-intensive Aufgaben
- Bild-/Videoverarbeitung
- Komplexe mathematische Berechnungen
- Big-Data-Analyse
Anwendungen, die intensive Berechnungen erfordern
- Training für maschinelles Lernen
- Wissenschaftliches Rechnen
- Kryptowährungs-Mining
Ereignisgesteuertes und nicht blockierendes E/A-Modell
Beispiel für das traditionelle blockierende E/A-Modell:
Beispiel
// Jeder readFileSync-Aufruf "blockiert" das Programm und wartet, bis der Dateilesevorgang abgeschlossen ist, bevor es fortfährt
const data1 = readFileSync('file1.txt'); // Das Programm pausiert hier und wartet, bis der Lesevorgang abgeschlossen ist
const data2 = readFileSync('file2.txt'); // Nachdem data1 gelesen wurde, pausiert es erneut, um zu warten
const data3 = readFileSync('file3.txt'); // Nachdem data2 gelesen wurde, pausiert es erneut, um zu warten
console.log('All files read'); // Diese Zeile wird erst ausgeführt, nachdem alle drei Dateien gelesen wurden
// Gesamtzeit = Zeit zum Lesen von file1 + Zeit zum Lesen von file2 + Zeit zum Lesen von file3
Beispiel für das nicht-blockierende I/O-Modell von Node.js:
Beispiel
const fs = require('fs');
// Die drei Dateileseoperationen werden nahezu gleichzeitig initiiert; das Programm wartet nicht auf den Abschluss einer von ihnen
fs.readFile('file1.txt', (err, data1) => {
// Diese Callback-Funktion wird automatisch aufgerufen, nachdem file1.txt gelesen wurde
console.log('Datei 1 vollständig gelesen');
});
fs.readFile('file2.txt', (err, data2) => {
// Diese Callback-Funktion wird automatisch aufgerufen, nachdem file2.txt gelesen wurde
console.log('Datei 2 vollständig gelesen');
});
fs.readFile('file3.txt', (err, data3) => {
// Diese Callback-Funktion wird automatisch aufgerufen, nachdem file3.txt gelesen wurde
console.log('Datei 3 vollständig gelesen');
});
// Hinweis: Diese Codezeile wird zuerst ausgeführt! Weil die drei obigen Dateilesevorgänge asynchron sind,
// Nach dem Absenden der Leseanforderungen fährt das Programm sofort fort, ohne auf den Abschluss der Dateilesevorgänge zu warten
console.log('Programm wird weiter ausgeführt, ohne auf Dateilesevorgänge zu warten');
// Beispiel der tatsächlichen Ausgabereihenfolge:
// Programm wird weiter ausgeführt, ohne auf Dateilesevorgänge zu warten ← zuerst ausgegeben
// Datei 2 vollständig gelesen ← welche Datei zuerst fertig wird, wird zuerst ausgegeben, die Reihenfolge ist nicht festgelegt
// Datei 1 vollständig gelesen
// Datei 3 vollständig gelesen
// Gesamtzeit ≈ die Zeit der langsamsten unter den drei Dateien (gleichzeitige Ausführung, nicht sequenzielle Akkumulation)
Event-Loop-Mechanismus:
Der Event-Loop ist der Kernmechanismus, mit dem Node.js nicht blockierende E/A implementiert. Er läuft kontinuierlich und prüft ständig auf ausstehende Aufgaben, wodurch der Effekt der "Single-Thread-Nebenläufigkeit" erreicht wird:
- Call Stack: Führt synchronen Code aus. Funktionsaufrufe werden auf den Stack gelegt und nach der Ausführung entfernt.
- Event Queue: Speichert Callbacks von abgeschlossenen asynchronen Operationen, die der Reihe nach ausgeführt werden, wenn der Call Stack leer ist.
- Event Loop: Überwacht kontinuierlich den Call Stack und die Event Queue. Sobald der Call Stack leer ist, entnimmt er einen Callback aus der Event Queue und legt ihn zur Ausführung auf den Call Stack.
Der Event Loop verarbeitet die folgenden Phasen in einer festen Reihenfolge:
┌───────────────────────────┐
┌─>│           timers          │  ← 执行 setTimeout、setInterval 的到期回调
│  └─────────────┬─────────────┘
│  ┌─────────────┴─────────────┐
│  │     pending callbacks     │  ← 执行上一轮循环中延迟的 I/O 回调(如某些系统错误回调)
│  └─────────────┬─────────────┘
│  ┌─────────────┴─────────────┐
│  │       idle, prepare       │  ← Node.js 内部使用,开发者一般不需要关心
│  └─────────────┬─────────────┘
│  ┌─────────────┴─────────────┐
│  │           poll            │  ← 核心阶段:获取新的 I/O 事件并执行其回调(如文件读取、网络请求完成)
│  └─────────────┬─────────────┘
│  ┌─────────────┴─────────────┐
│  │           check           │  ← 执行 setImmediate 的回调(在 poll 阶段之后立即执行)
│  └─────────────┬─────────────┘
│  ┌─────────────┴─────────────┐
└──┤      close callbacks      │  ← 执行关闭事件的回调,如 socket.on('close', ...)
   └───────────────────────────┘
Für Anfänger ist das Wichtigste, das man sich merken sollte:Synchroner Code wird immer zuerst ausgeführt. Asynchrone Callbacks (z. B. die Behandlung des Abschlusses eines Dateilesevorgangs) werden erst ausgeführt, nachdem der Call Stack geleert wurde.
JavaScript-Laufzeitumgebung
Einführung in die V8-Engine
V8 ist eine von Google entwickelte Hochleistungs-JavaScript-Engine und eine Kernkomponente des Chrome-Browsers.
Node.js verwendet die V8-Engine, um JavaScript-Code auszuführen.
Merkmale der V8-Engine:
Just-in-Time-Kompilierung (JIT)
- Kompiliert JavaScript-Code direkt in Maschinencode
- Kein Zwischenbytecode erforderlich, was zu höherer Ausführungseffizienz führt
Speicherbereinigung
- Automatische Speicherverwaltung; Entwickler müssen Speicher nicht manuell freigeben
- Verwendet einen generationellen Speicherbereinigungsalgorithmus, der den Speicher in die junge Generation und die alte Generation unterteilt und getrennt verwaltet, wodurch die Effizienz der Speicherbereinigung verbessert wird
Optimierungstechniken
- Inline-Caching: Speichert die Ergebnisse von Objekteigenschafts-Nachschlagevorgängen zwischen, um wiederholte Nachschlagevorgänge zu vermeiden
- Hidden Classes: Machen die Objektstruktur dynamischer Sprachen statisch, um den Eigenschaftszugriff zu beschleunigen
- Dynamische Optimierung: Analysiert Hot Code zur Laufzeit und führt gezielte Optimierungen durch
Browser-JavaScript vs. Node.js-JavaScript
Obwohl beide die JavaScript-Sprache verwenden, führen Unterschiede in der Laufzeitumgebung zu einigen wichtigen Unterscheidungen:
Gemeinsamkeiten:
- Beide verwenden dieselbe JavaScript-Syntax
- Beide unterstützen ES6+-Funktionen
- Beide verwenden die V8-Engine (Chrome-Browser)
Unterschiede:
| Merkmal | Browser-JavaScript | Node.js-JavaScript |
|---|---|---|
| Globales Objekt | window |
global |
| Modulsystem | ES6-Module, AMD | CommonJS, ES6-Module |
| Dateisystemzugriff | Nicht zugänglich (aufgrund von Sicherheitsbeschränkungen) | Voller Zugriff |
| Netzwerkanfragen | XMLHttpRequest, Fetch | http-, https-Module |
| DOM-Manipulation | Unterstützt (Manipulation von Seitenelementen) | Nicht unterstützt (keine Seiten auf der Serverseite) |
| Prozesssteuerung | Nicht unterstützt | Unterstützt (kann Umgebungsvariablen lesen, den Prozess beenden usw.) |
Browser-Umgebungsbeispiel:
Beispiel
console.log(window); // Globales Browser-Objekt, enthält alle Browser-APIs
document.getElementById('app'); // Seitenelement anhand der ID abrufen (in Node.js nicht verfügbar)
localStorage.setItem('key', 'value'); // Lokaler Speicher des Browsers (in Node.js nicht verfügbar)
Node.js-Umgebungsbeispiel:
Beispiel
console.log(global); // Node.js globales Objekt (entspricht window im Browser)
const fs = require('fs'); // Importiert das eingebaute Dateisystemmodul (im Browser nicht verfügbar)
fs.readFile('data.txt', 'utf8', callback); // Eine lokale Datei auf dem Server lesen (im Browser nicht verfügbar)
Unterschiede bei globalen Objekten
Globales Objekt im Browser:
Beispiel
console.log(this === window); // true, das this auf oberster Ebene ist das window-Objekt
var globalVar = 'hello';
console.log(window.globalVar); // 'hello', mit var deklarierte Variablen werden Eigenschaften von window
Globales Objekt in Node.js:
Beispiel
// Hinweis: In Node.js ist jede Datei ein unabhängiges Modul, und this innerhalb eines Moduls ist nicht gleich global
console.log(this === global); // false (this verweist im Modulbereich auf module.exports)
var globalVar = 'hello';
console.log(global.globalVar); // undefined, Variablen innerhalb eines Moduls werden nicht automatisch an global angehängt
// Modulbereich in Node.js
console.log(this); // {} leeres Objekt, d. h. der Anfangswert von module.exports
console.log(module.exports === this); // true, this innerhalb eines Moduls zeigt auf module.exports
Node.js-spezifische globale Variablen:
Beispiel
console.log(__filename); // Absoluter Pfad der aktuellen Moduldatei, z. B. /home/user/project/app.js
console.log(process); // Prozessobjekt, kann Kommandozeilenargumente (process.argv), Umgebungsvariablen (process.env) usw. lesen.
console.log(Buffer); // Konstruktor für die Verarbeitung binärer Daten, häufig verwendet für Datei-Lesen/Schreiben und Netzwerkkommunikation
Vorteile und Einschränkungen von Node.js
Detaillierte Vorteile
1. Hohe Verarbeitungskapazität für Nebenläufigkeit
Ein traditioneller Multithread-Server benötigt etwa 20GB Arbeitsspeicher, um 10,000 gleichzeitige Verbindungen zu verarbeiten (etwa 2MB pro Thread), während Node.js sehr wenig Arbeitsspeicher benötigt, um dieselbe Anzahl von Verbindungen zu verarbeiten.
Beispiel
const http = require('http');
const server = http.createServer((req, res) => {
// Simuliert eine asynchrone Operation (z. B. eine Datenbankabfrage), die nach 100ms eine Antwort zurückgibt
// Während dieser 100ms kann die Event-Loop weiterhin andere Anfragen verarbeiten, ohne blockiert zu werden
setTimeout(() => {
res.writeHead(200, {'Content-Type': 'text/plain'});
res.end('Hello World\n');
}, 100);
});
server.listen(3000, () => {
console.log('Server running at http://localhost:3000/');
});
// Dank nicht blockierender I/O und des Event-Loop-Mechanismus kann dieser Server Tausende von Anfragen gleichzeitig verarbeiten, ohne zu blockieren
2. Schnelle Entwicklung
Ein einheitlicher JavaScript-Sprachstack (sowohl Frontend als auch Backend verwenden JavaScript) macht die Frontend- und Backend-Entwicklung effizienter. Entwickler müssen nur eine Sprache beherrschen, um sowohl Frontend- als auch Backend-Code zu schreiben, und können Codelogik zwischen beiden Seiten teilen:
Beispiel
function validateEmail(email) {
const regex = /^[^\s@]+@[^\s@]+\.[^\s@]+$/;
return regex.test(email);
}
// Frontend-Verwendung (läuft im Browser): Wenn ein Benutzer ein Formular absendet, validieren Sie es zuerst im Frontend, um zu vermeiden, dass ungültige Anfragen an den Server gesendet werden
if (validateEmail(userInput)) {
// Validierung erfolgreich, an den Server senden
}
// Backend-Verwendung (läuft in Node.js): Der Server validiert erneut, um direkte API-Anfragen zu verhindern, die das Frontend umgehen
if (validateEmail(req.body.email)) {
// Validierung erfolgreich, in der Datenbank speichern
}
3. Vorteile eines einheitlichen Sprach-Stacks
- Code-Wiederverwendung: Frontend und Backend können Hilfsfunktionen, Datenvalidierungslogik, Konstantendefinitionen usw. gemeinsam nutzen.
- Teameffizienz: Entwickler können gleichzeitig sowohl Frontend- als auch Backend-Entwicklung übernehmen, wodurch Kommunikationskosten reduziert werden
- Vereinfachter Technologie-Stack: Man muss nur die JavaScript-Sprache beherrschen, wodurch Lernkosten und technische Komplexität reduziert werden
4. Umfangreiches npm-Ökosystem
# npm 提供了数百万个开源包,几乎任何功能都能找到现成的库
npm search express     # 搜索名为 express 的包
npm install express    # 安装 express 包到当前项目
npm update            # 更新当前项目中所有包到最新兼容版本
Analyse der Einschränkungen
1. Leistungsprobleme bei CPU-intensiven Aufgaben
Beispiel
// fibonacciSync ist eine reine Berechnungsaufgabe, die die CPU dauerhaft auslastet, währenddessen die Event-Loop keine anderen Anfragen bearbeiten kann
function fibonacciSync(n) {
if (n < 2) return n;
return fibonacciSync(n - 1) + fibonacciSync(n - 2);
}
// Dies blockiert die gesamte Anwendung für mehrere Sekunden, in denen alle Anfragen nicht beantwortet werden können
console.log(fibonacciSync(40));
// Lösung: Verwenden Sie Worker Threads, um CPU-intensive Aufgaben in separaten Threads auszuführen,
// sodass die Event-Loop des Hauptthreads nicht blockiert wird
const { Worker, isMainThread, parentPort, workerData } = require('worker_threads');
if (isMainThread) {
// Hauptthread: einen Worker erstellen und das Argument { n: 40 } an ihn übergeben
// Der Worker führt die aktuelle Datei in einem separaten Thread aus (__filename verweist auf den Pfad der aktuellen Datei)
const worker = new Worker(__filename, {
workerData: { n: 40 }
});
// Auf vom Worker gesendete Nachrichten lauschen (das Berechnungsergebnis)
worker.on('message', (result) => {
console.log('Result:', result); // Nachdem der Worker die Berechnung abgeschlossen hat, empfängt der Hauptthread hier das Ergebnis
});
} else {
// Worker-Thread: Parameter abrufen, die vom Hauptthread über workerData übergeben wurden, die Berechnung ausführen und dann das Ergebnis senden
const result = fibonacciSync(workerData.n);
parentPort.postMessage(result); // Das Ergebnis zurück an den Hauptthread senden
}
2. Problem der Callback-Hölle
Beispiel
fs.readFile('file1.txt', (err, data1) => {
if (err) throw err;
fs.readFile('file2.txt', (err, data2) => { // Erste Verschachtelungsebene
if (err) throw err;
fs.readFile('file3.txt', (err, data3) => { // Zweite Verschachtelungsebene
if (err) throw err;
// In echten Projekten kann diese Verschachtelung ein Dutzend oder mehr Ebenen tief sein, was die Wartbarkeit des Codes erheblich beeinträchtigt
console.log('Alle Dateien erfolgreich gelesen');
});
});
});
// Moderne Lösung: Promise + async/await verwenden, um asynchronen Code so intuitiv wie synchronen Code zu machen
const fsPromises = require('fs').promises;
async function readFiles() {
try {
// await wartet darauf, dass jede Datei gelesen wird, aber die gesamte Funktion blockiert nicht die Event-Loop
// Hinweis: Dies liest sequenziell; um mehrere Dateien gleichzeitig zu lesen, verwende Promise.all()
const data1 = await fsPromises.readFile('file1.txt');
const data2 = await fsPromises.readFile('file2.txt');
const data3 = await fsPromises.readFile('file3.txt');
console.log('Alle Dateien erfolgreich gelesen');
} catch (err) {
// try/catch kann alle asynchronen Fehler einheitlich behandeln, ohne in jedem Callback separat prüfen zu müssen
console.error('Fehler beim Lesen der Dateien:', err);
}
}
3. Anfälligkeit von Single-Threading
Beispiel
// Anders als beim Multithreading stoppt ein einziger unbehandelter Fehler in einer Single-Threaded-Umgebung den gesamten Dienst
setTimeout(() => {
throw new Error('Nicht abgefangene Ausnahme'); // Dies bringt die gesamte Anwendung zum Absturz, und alle Anfragen werden nicht mehr beantwortet
}, 1000);
// Lösung: Registriere einen globalen Ausnahmehandler, um Fehler zu protokollieren und vor dem Absturz der Anwendung sauber zu beenden
process.on('uncaughtException', (err) => {
console.error('Nicht abgefangene Ausnahme:', err);
// Hier sollte zuerst der Fehler protokolliert und dann beendet werden, um stille Abstürze zu vermeiden, die Probleme schwer diagnostizierbar machen
process.exit(1); // Exit-Code 1 kennzeichnet einen abnormalen Abbruch
});
process.on('unhandledRejection', (reason, promise) => {
// Wird ausgelöst, wenn ein Promise abgelehnt wird, aber keinen .catch()-Handler hat
console.error('Unbehandelte Promise-Ablehnung:', reason);
process.exit(1);
});
Analyse geeigneter Szenarien
1. RESTful-API-Dienst
Beispiel
// Zuerst müssen Sie express installieren: npm install express
const express = require('express');
const app = express();
app.use(express.json()); // Middleware: JSON-Daten im Request-Body automatisch parsen
// GET-Anfrage: Benutzerliste abrufen (entspricht HTTP-Methode GET, Pfad /api/users)
app.get('/api/users', (req, res) => {
const users = [
{ id: 1, name: 'Zhang San' },
{ id: 2, name: 'Li Si' }
];
res.json(users); // Daten im JSON-Format zurückgeben
});
// POST-Anfrage: Einen neuen Benutzer erstellen (der Client sendet Benutzerinformationen im Request-Body)
app.post('/api/users', (req, res) => {
const newUser = req.body; // Die vom Client gesendeten JSON-Daten abrufen
// In echten Projekten werden Benutzerinformationen hier normalerweise in einer Datenbank gespeichert
res.status(201).json({ message: 'Benutzer erfolgreich erstellt', user: newUser });
});
// PUT-Anfrage: Angegebene Benutzerinformationen aktualisieren (:id ist ein Routenparameter, z. B. /api/users/1 bedeutet, den Benutzer mit ID 1 zu aktualisieren)
app.put('/api/users/:id', (req, res) => {
const { id } = req.params; // Benutzer-ID aus dem Pfad abrufen
const updatedData = req.body; // Den Update-Inhalt aus dem Request-Body abrufen
res.json({ message:`Benutzer ${id}erfolgreich aktualisiert`, data: updatedData });
});
// DELETE-Anfrage: Löschen Sie den angegebenen Benutzer
app.delete('/api/users/:id', (req, res) => {
const { id } = req.params;
res.json({ message:`Benutzer ${id}erfolgreich gelöscht`});
});
app.listen(3000, () => {
console.log('API-Server läuft unter http://localhost:3000/');
});
2. Echtzeitanwendungen
Beispiel
// Zuerst müssen Sie Folgendes installieren: npm install socket.io
const io = require('socket.io')(server);
// Auf Verbindungsereignisse von Clients lauschen, die jedes Mal ausgelöst werden, wenn sich ein neuer Benutzer verbindet
io.on('connection', (socket) => {
// Auf das Ereignis 'chat message' lauschen, das vom aktuell verbundenen Client gesendet wird
socket.on('chat message', (msg) => {
io.emit('chat message', msg); // Die Nachricht an alle Online-Clients senden (einschließlich des Absenders)
});
});
3. Middleware- und Proxy-Dienste
Beispiel
// /api/xxx-Anfragen vom Frontend an den echten Backend-API-Server weiterleiten, wodurch die echte Adresse verborgen wird; wird häufig verwendet, um CORS-Probleme zu lösen
// Zuerst müssen Sie installieren: npm install http-proxy-middleware
const httpProxy = require('http-proxy-middleware');
const proxy = httpProxy({
target: 'http://api.example.com', // Adresse des echten Backend-API-Servers
changeOrigin: true, // Den Host im Request-Header auf die Zieladresse ändern
pathRewrite: {
'^/api': '' // Entferne das /api-Präfix aus dem Pfad vor der Weiterleitung, z. B. /api/users → /users
}
});