Vortrainierte Modelle
Vortrainierte Modelle gehören zu den wichtigsten technologischen Durchbrüchen im Bereich des Natural Language Processing (NLP) in den letzten Jahren. Solche Modelle werden auf umfangreichen Textdaten vortrainiert, um allgemeine Sprachrepräsentationsfähigkeiten zu erlernen, und können anschließend für spezifische Aufgaben feinabgestimmt werden.
Kernidee
- Zweistufiges Lernen: Zuerst auf groß angelegten allgemeinen Daten trainieren, dann auf kleinen aufgabenspezifischen Daten feinabstimmen
- Transferlernen: Allgemeines Sprachwissen auf spezifische Aufgaben übertragen
- Parameter-Sharing: Derselbe Satz von Modellparametern kann für mehrere nachgelagerte Aufgaben verwendet werden
Vergleich mit traditionellen Methoden
| Merkmal | Traditionelle NLP-Modelle | Vortrainierte Modelle |
|---|---|---|
| Datenanforderungen | Erfordert große Mengen an annotierten Daten | Erfordert nur kleine Mengen an annotierten Daten |
| Trainingsmethode | Von Grund auf trainieren | Vorab-Training + Feinabstimmung |
| Generalisierungsfähigkeit | Aufgabenspezifisch | Aufgabenübergreifend allgemein |
| Entwicklungseffizienz | Niedrig | Hoch |
Entwicklungsgeschichte vortrainierter Modelle
1. Word-Embedding-Ära (2013-2017)
- Repräsentative Modelle:Word2Vec、GloVe、FastText
- Eigenschaften:
- Statische Wortvektordarstellung
- Kann Polysemie nicht verarbeiten
- Kontextunabhängig
Beispiel
# Word2Vec-Beispiel
from gensim.models import Word2Vec
sentences = [["natural", "language", "processing"], ["pre-trained", "model", "is very powerful"]]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1)
print(model.wv["natural"]) # Wortvektor ausgeben
from gensim.models import Word2Vec
sentences = [["natural", "language", "processing"], ["pre-trained", "model", "is very powerful"]]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1)
print(model.wv["natural"]) # Wortvektor ausgeben
2. Kontextbewusste Ära (2018-2019)
- Repräsentative Modelle: ELMo, ULMFiT
- Durchbruch:
- Dynamische Wortvektordarstellung
- Kann Polysemie verarbeiten
- Bidirektionales Sprachmodell
3. Transformer-Ära (2019-heute)
- Meilensteinmodelle: BERT, GPT, T5
- Revolutionäre Verbesserungen:
- Basiert auf der Transformer-Architektur
- Großskaliges Pre-Training
- Starke Transferlernfähigkeit
Gängige Architekturen vortrainierter Modelle
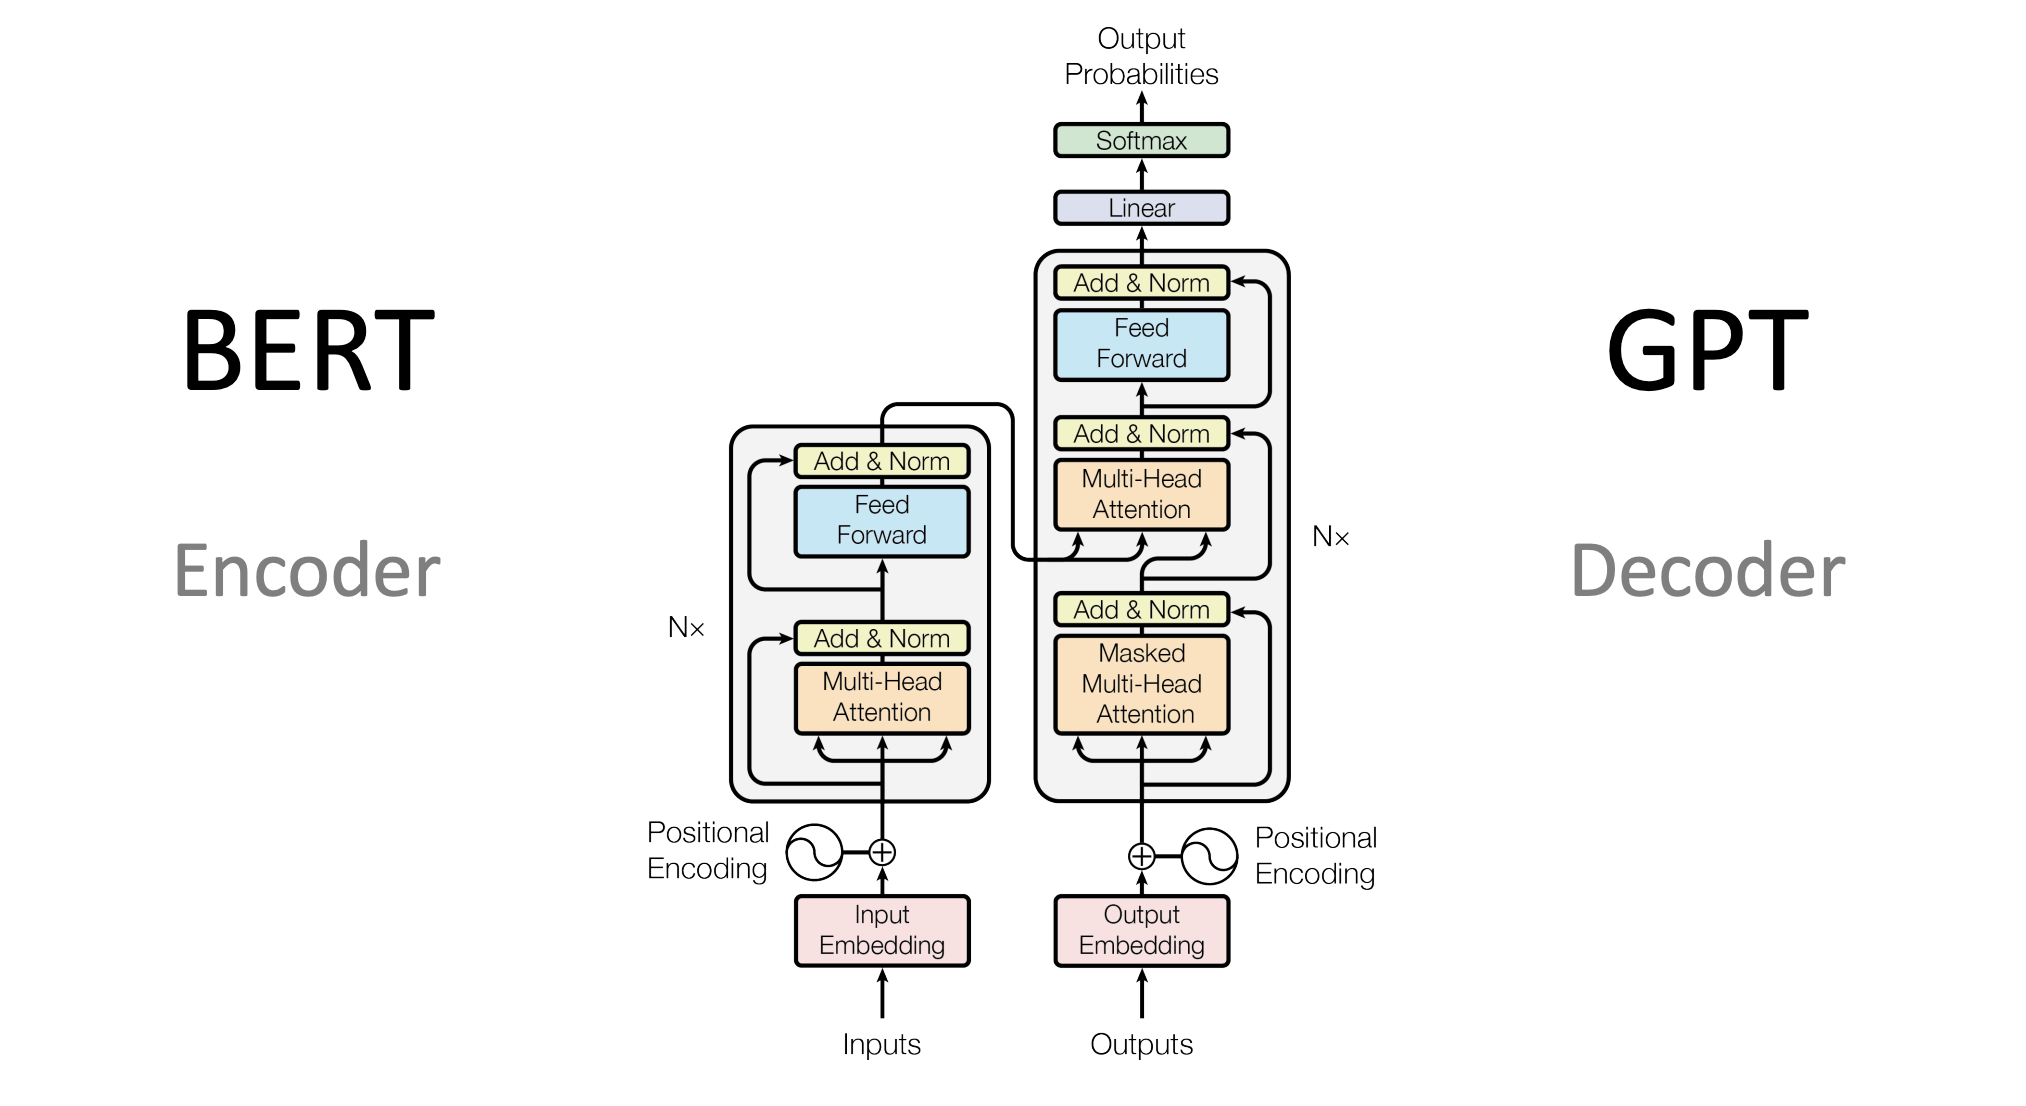
1. Encoder-Architektur (BERT-Serie)

- Eigenschaften:
- Bidirektionales Kontextverständnis
- Geeignet für Klassifikation, QA und andere Aufgaben
- Repräsentative Modelle: BERT, RoBERTa, ALBERT
2. Decoder-Architektur (GPT-Serie)

- Eigenschaften:
- Unidirektionaler Kontext (von links nach rechts)
- Gut für Textgenerierung
- Repräsentative Modelle: GPT-3, GPT-4
3. Encoder-Decoder-Architektur

- Eigenschaften:
- Geeignet für Sequence-to-Sequence-Aufgaben
- Repräsentative Modelle: T5, BART
Arten von Vorabtrainingsaufgaben
1. Sprachmodell (LM)
- Ziel: Das nächste Wort vorhersagen
- Formel:P(w_t | w_1, ..., w_{t-1})
2. Maskiertes Sprachmodell (MLM)
- Beispiel:
- Originalsatz: "Ein vortrainiertes Modell ist sehr leistungsfähig"
- Nach der Maskierung: "Ein vortrainiertes [MASK] ist sehr leistungsfähig"
- Modellvorhersage: "Modell"
3. Vorhersage des nächsten Satzes (NSP)
- Feststellen, ob zwei Sätze aufeinanderfolgend sind
- Positives Beispiel:
- Satz A: "Ein vortrainiertes Modell ist sehr leistungsfähig"
- Satz B: "Sie können mehrere NLP-Aufgaben bewältigen"
- Negativbeispiel:
- Satz A: "Ein vortrainiertes Modell ist sehr leistungsfähig"
- Satz B: "Das Wetter ist heute wirklich schön"
- Positives Beispiel:
4. Weitere Aufgaben
- Erkennung ersetzter Token (RTD)
- Satzreihenfolge-Vorhersage (SOP)
Wie man vortrainierte Modelle verwendet
1. Verwendung von Hugging Face Transformers
Beispiel
from transformers import pipeline
# Beispiel für Sentimentanalyse
classifier = pipeline("sentiment-analysis")
result = classifier("Pre-trained models are really amazing!")
print(result) # [{'label': 'POSITIVE', 'score': 0.9998}]
# Beispiel für Sentimentanalyse
classifier = pipeline("sentiment-analysis")
result = classifier("Pre-trained models are really amazing!")
print(result) # [{'label': 'POSITIVE', 'score': 0.9998}]
2. Modell-Feinabstimmungsprozess
- Ein vortrainiertes Modell laden
- Einen aufgabenspezifischen Datensatz vorbereiten
- Eine aufgabenspezifische Ausgabeschicht hinzufügen
- Feinabstimmung des Trainings
Beispiel
from transformers import BertForSequenceClassification, Trainer
model = BertForSequenceClassification.from_pretrained("bert-base-chinese")
# Trainingsdaten vorbereiten...
trainer = Trainer(model=model, args=training_args, train_dataset=train_dataset)
trainer.train()
model = BertForSequenceClassification.from_pretrained("bert-base-chinese")
# Trainingsdaten vorbereiten...
trainer = Trainer(model=model, args=training_args, train_dataset=train_dataset)
trainer.train()
3. Beschreibungen der wichtigsten Parameter
| Parameter | Beschreibung | Typischer Wert |
|---|---|---|
| learning_rate | Lernrate | 2e-5 |
| batch_size | Batch-Größe | 16/32 |
| num_train_epochs | Anzahl der Trainingsepochen | 3-5 |
| max_length | Maximale Sequenzlänge | 512 |
Anwendungsszenarien vortrainierter Modelle
1. Textklassifikation
- Sentimentanalyse
- Spam-Erkennung
- Themenklassifikation
2. Frage-Antwort-Systeme
- Extraktive QA
- Open-Domain-QA
3. Textgenerierung
- Textzusammenfassung
- Dialogsysteme
- Inhaltserstellung
4. Weitere Anwendungen
- Erkennung benannter Entitäten (NER)
- Maschinelle Übersetzung
- Berechnung der Textähnlichkeit
Praktische Empfehlungen
Modellauswahl:
- Bei Klassifikationsaufgaben BERT-ähnliche Modelle priorisieren
- Für Generierungsaufgaben GPT-ähnliche Modelle wählen
- Wenn Ressourcen begrenzt sind, sollten Sie destillierte Modelle in Betracht ziehen (z. B. DistilBERT)
Ressourcenverwaltung:
- Verringern Sie batch_size, wenn der GPU-Speicher nicht ausreicht
- Achten Sie beim Verarbeiten langer Texte auf die max_length-Grenzen
- Erwägen Sie den Einsatz von Modellquantisierungstechniken
Leistungsoptimierung:
- Die Lernrate muss fein angepasst werden
- Frühzeitiges Stoppen verhindert Overfitting
- Probieren Sie verschiedene Optimierer aus (AdamW usw.)
Kontinuierliches Lernen:
- Folgen Sie der Hugging Face-Community
- Verfolgen Sie die neuesten Paper auf arXiv
- Beteiligen Sie sich an der Praxis in Open-Source-Projekten
Zukünftige Entwicklungsrichtungen
- Größere Skalierung: Modellparameter wachsen weiter (z. B. GPT-4s Billionen Parameter)
- Multimodale Fusion: Kombination von Text mit Bildern und Sprache
- Energieeffizienzoptimierung: Effizientere Trainings- und Inferenzmethoden
- Domänenanpassung: Vortrainierte Modelle für spezialisierte Domänen
- Ethik und Sicherheit: Probleme wie Bias und Toxizität adressieren
Vortrainierte Modelle verändern die technologische Landschaft des NLP-Bereichs. Das Verständnis ihrer Kernprinzipien und die Beherrschung der Anwendungsmethoden werden zu wesentlichen Fähigkeiten für NLP-Ingenieure.
Weitere Erweiterungen Linux-Befehlsreferenz