Modelos preentrenados
Los modelos preentrenados (Pre-trained Models) son uno de los avances técnicos más importantes en el campo del procesamiento del lenguaje natural (NLP) en los últimos años. Estos modelos, mediante un entrenamiento previo en datos de texto a gran escala, aprenden capacidades generales de representación del lenguaje y luego pueden ajustarse para tareas específicas (Fine-tuning).
Idea central
- Aprendizaje en dos etapas: primero entrenar con datos generales a gran escala y luego ajustar con datos de tareas específicas a pequeña escala
- Aprendizaje por transferencia: transferir el conocimiento general del lenguaje a tareas específicas
- Compartición de parámetros: el mismo conjunto de parámetros del modelo puede usarse en múltiples tareas posteriores
Comparación con métodos tradicionales
| Característica | Modelos NLP tradicionales | Modelos preentrenados |
|---|---|---|
| Requisitos de datos | Requiere gran cantidad de datos etiquetados | Solo requiere pocos datos etiquetados |
| Método de entrenamiento | Entrenamiento desde cero | Preentrenamiento + ajuste fino |
| Capacidad de generalización | Específica de la tarea | General entre tareas |
| Eficiencia de desarrollo | bajo | Alto |
Evolución de los modelos preentrenados
1. Era de los word embeddings (2013-2017)
- Modelos representativos:Word2Vec、GloVe、FastText
- Características:
- Representación estática de vectores de palabras
- Incapaz de manejar la polisemia
- Independiente del contexto
Ejemplo
# Ejemplo de Word2Vec
from gensim.models import Word2Vec
sentences = [["natural", "lenguaje", "procesamiento"], ["preentrenamiento", "modelo", "es muy poderoso"]]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1)
print(model.wv["natural"]) # Salida de word embeddings
from gensim.models import Word2Vec
sentences = [["natural", "lenguaje", "procesamiento"], ["preentrenamiento", "modelo", "es muy poderoso"]]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1)
print(model.wv["natural"]) # Salida de word embeddings
2. Era del contexto (2018-2019)
- Modelos representativos:ELMo、ULMFiT
- Avance:
- Representación dinámica de vectores de palabras
- Capaz de manejar la polisemia
- Modelo de lenguaje bidireccional
3. Era de Transformer (2019-presente)
- Modelos hito:BERT、GPT、T5
- Mejoras revolucionarias:
- Basados en la arquitectura Transformer
- Preentrenamiento a gran escala
- Gran capacidad de aprendizaje por transferencia
Arquitecturas principales de modelos preentrenados
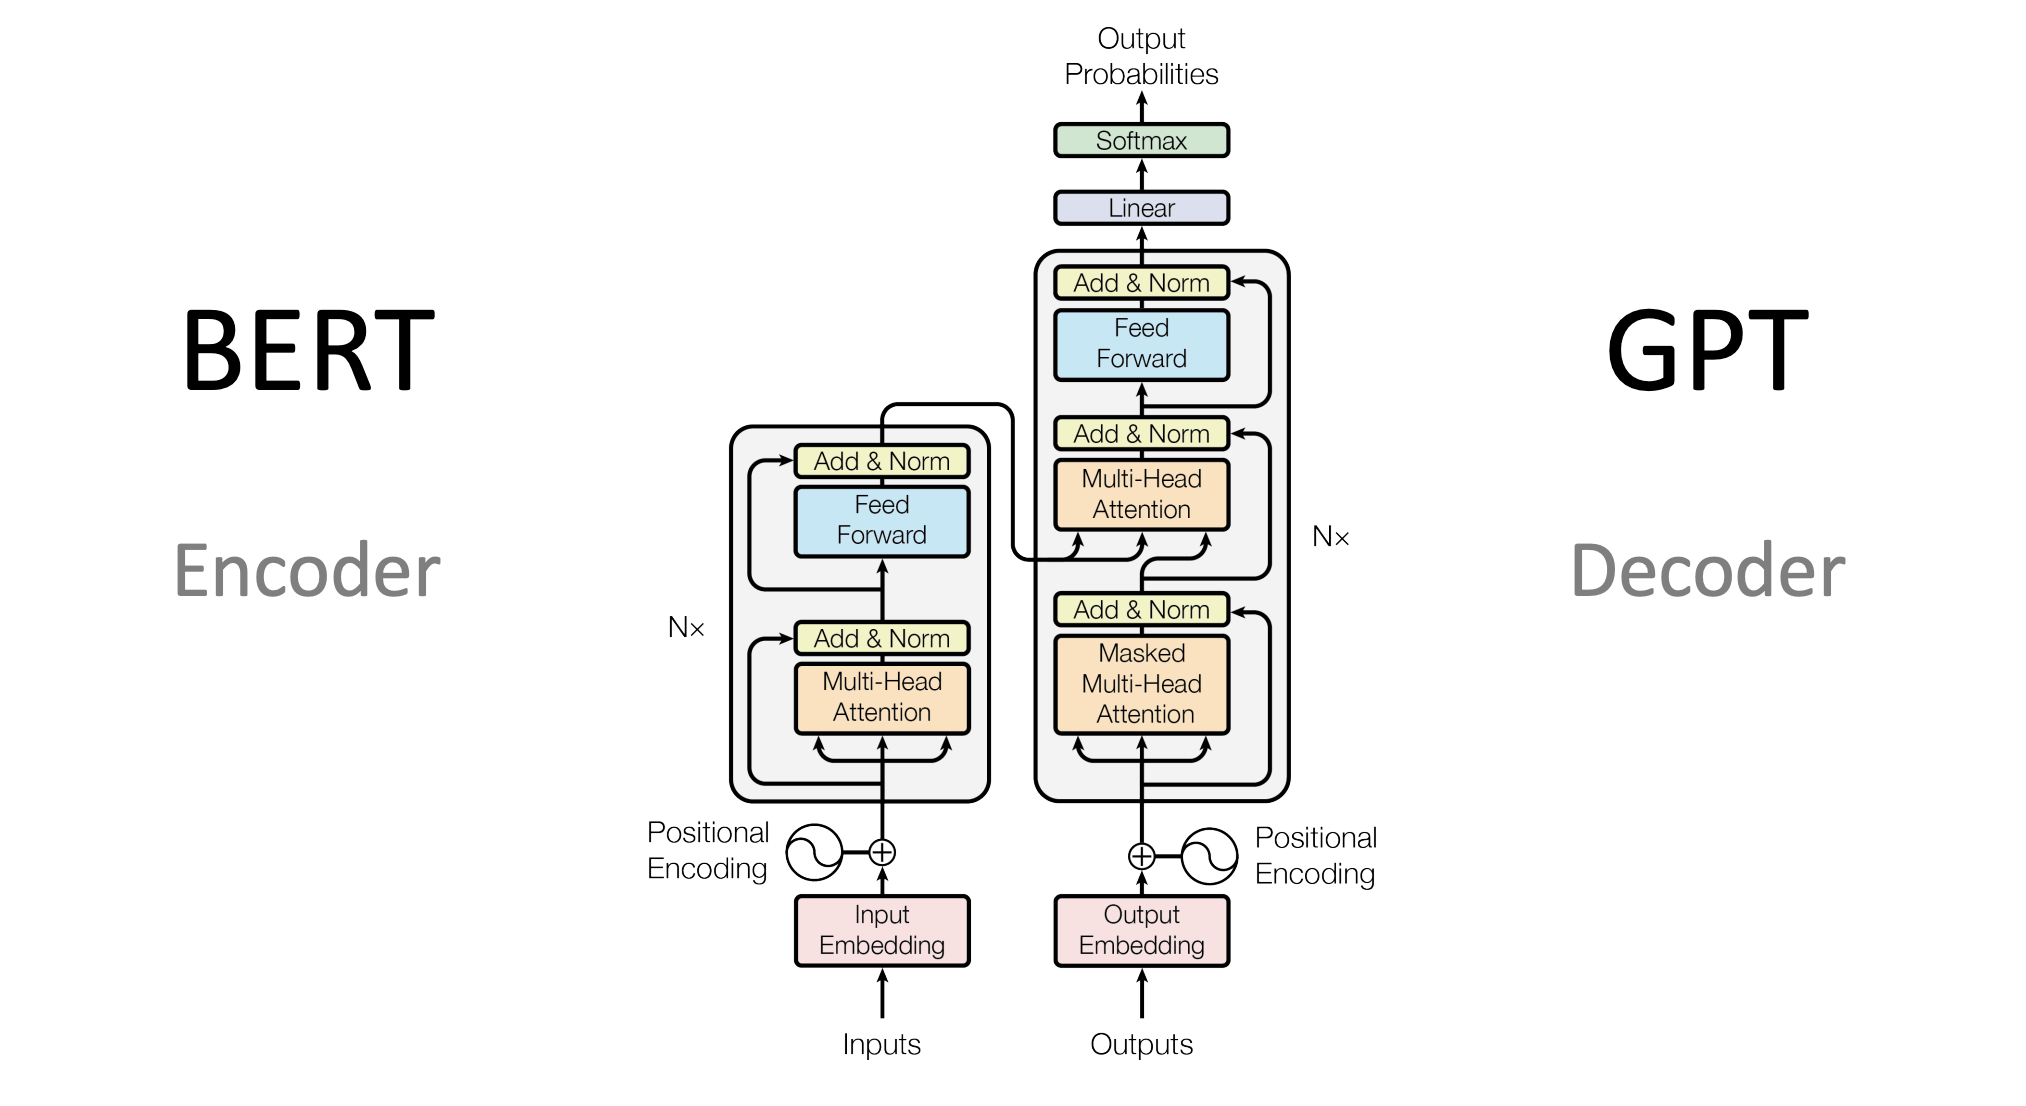
1. Arquitectura de encoder (serie BERT)
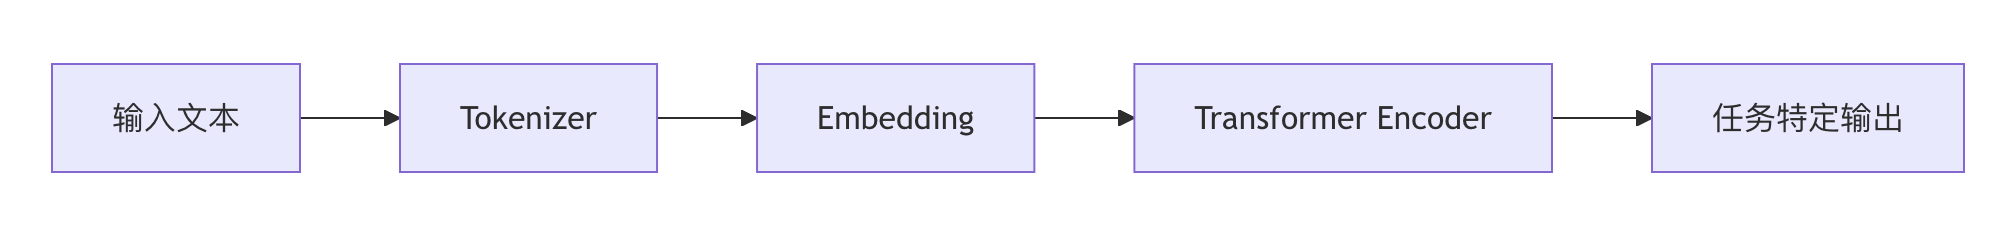
- Características:
- Comprensión bidireccional del contexto
- Adecuado para tareas de clasificación, preguntas y respuestas, etc.
- Modelos representativos: BERT, RoBERTa, ALBERT
2. Arquitectura de decoder (serie GPT)

- Características:
- Contexto unidireccional (de izquierda a derecha)
- Especializado en generación de texto
- Modelos representativos: GPT-3, GPT-4
3. Arquitectura encoder-decoder

- Características:
- Adecuado para tareas de secuencia a secuencia
- Modelos representativos: T5, BART
Tipos de tareas de preentrenamiento
1. Modelo de lenguaje (LM)
- Objetivo: predecir la siguiente palabra
- Fórmula:P(w_t | w_1, ..., w_{t-1})
2. Modelo de lenguaje enmascarado (MLM)
- Ejemplo:
- Oración original: "El modelo preentrenado es muy poderoso"
- Después del enmascarado: "El [MASK] preentrenado es muy poderoso"
- El modelo predice: "modelo"
3. Predicción de la siguiente oración (NSP)
- Determinarsi dos oraciones son consecutivas
- Ejemplo positivo:
- Oración A: "El modelo preentrenado es muy poderoso"
- Oración B: "Pueden manejar múltiples tareas de NLP"
- Ejemplo negativo:
- Oración A: "El modelo preentrenado es muy poderoso"
- Oración B: "Hoy hace muy buen día"
- Ejemplo positivo:
4. Otras tareas
- Detección de token reemplazado (RTD)
- Predicción de orden de oraciones (SOP)
Cómo usar modelos preentrenados
1. Usando Hugging Face Transformers
Ejemplo
from transformers import pipeline
# Ejemplo de análisis de sentimientos
classifier = pipeline("sentiment-analysis")
result = classifier("¡El modelo preentrenado es realmente increíble!")
print(result) # [{'label': 'POSITIVE', 'score': 0.9998}]
# Ejemplo de análisis de sentimientos
classifier = pipeline("sentiment-analysis")
result = classifier("¡El modelo preentrenado es realmente increíble!")
print(result) # [{'label': 'POSITIVE', 'score': 0.9998}]
2. Proceso de ajuste fino del modelo
- Cargar el modelo preentrenado
- Preparar el conjunto de datos específico de la tarea
- Añadir la capa de salida específica de la tarea
- Entrenamiento de ajuste fino
Ejemplo
from transformers import BertForSequenceClassification, Trainer
model = BertForSequenceClassification.from_pretrained("bert-base-chinese")
# Preparando los datos de entrenamiento...
trainer = Trainer(model=model, args=training_args, train_dataset=train_dataset)
trainer.train()
model = BertForSequenceClassification.from_pretrained("bert-base-chinese")
# Preparando los datos de entrenamiento...
trainer = Trainer(model=model, args=training_args, train_dataset=train_dataset)
trainer.train()
3. Explicación de parámetros clave
| Parámetro | Descripción | Valor típico |
|---|---|---|
| learning_rate | Tasa de aprendizaje | 2e-5 |
| batch_size | Tamaño de lote (batch) | 16/32 |
| num_train_epochs | Número de épocas | 3-5 |
| max_length | Longitud máxima de secuencia | 512 |
Escenarios de aplicación de los modelos preentrenados
1. Clasificación de texto
- Análisis de sentimientos
- Detección de spam
- Clasificación de temas
2. Sistemas de preguntas y respuestas
- Preguntas y respuestas extractivas
- Preguntas y respuestas de dominio abierto
3. Generación de texto
- Generación de resúmenes
- Sistemas de diálogo
- Creación de contenido
4. Otras aplicaciones
- Reconocimiento de entidades nombradas (NER)
- Traducción automática
- Cálculo de similitud de textos
Consejos prácticos
Selección de modelos:
- Para tareas de clasificación, prioriza los modelos tipo BERT
- Para tareas de generación, elige modelos tipo GPT
- Si los recursos son limitados, considera modelos destilados (como DistilBERT)
Gestión de recursos:
- Si la memoria de la GPU es insuficiente, reduce el batch_size
- Al procesar textos largos, presta atención al límite de max_length
- Considera usar técnicas de cuantificación de modelos
Optimización del rendimiento:
- La tasa de aprendizaje requiere un ajuste cuidadoso
- Detención temprana (Early Stopping) para evitar el sobreajuste
- Prueba diferentes optimizadores (AdamW, etc.)
Aprendizaje continuo:
- Sigue la comunidad de Hugging Face
- Sigue los últimos artículos en arXiv
- Participa en proyectos de código abierto
Direcciones de desarrollo futuro
- Mayor escala: los parámetros del modelo siguen creciendo (por ejemplo, los billones de parámetros de GPT-4)
- Fusión multimodal: combinación de texto con imágenes y voz
- Optimización de eficiencia energética: métodos de entrenamiento e inferencia más eficientes
- Adaptación a dominios específicos: modelos preentrenados para dominios especializados
- Ética y seguridad: abordar problemas como sesgos y toxicidad
Los modelos preentrenados están remodelando el panorama técnico del campo del NLP. Comprender sus principios fundamentales y dominar los métodos de aplicación se convertirá en una habilidad esencial para los ingenieros de NLP.
Otras extensiones Guía completa de comandos de Linux