Transformer-Architektur
Die Transformer-Architektur ist ein Deep-Learning-Modell, das auf dem Self-Attention-Mechanismus basiert und vom Google-Team in einem Paper aus dem Jahr 2017《Attention Is All You Need》erstmals vorgeschlagen wurde.
Der Transformer hat den Bereich der natürlichen Sprachverarbeitung (NLP) vollständig verändert und ist zur Kernbasis moderner großer Sprachmodelle (wie GPT, BERT usw.) geworden.
Ähnlich wie rekurrente neuronale Netze (RNNs) ist der Transformer darauf ausgelegt, sequenzielle Eingabedaten wie natürliche Sprache zu verarbeiten, und eignet sich für Aufgaben wie maschinelle Übersetzung und Textzusammenfassung. Im Gegensatz zu RNNs muss der Transformer Sequenzen jedoch nicht Schritt für Schritt verarbeiten; stattdessen kann er die gesamte Eingabe auf einmal parallel verarbeiten.
Dieses Kapitel führt Sie tief in die Kernideen, Architektur und Funktionsprinzipien des Transformers ein und hilft Ihnen, die Grundlagen dieser revolutionären Technologie zu verstehen.
Transformer-Architektur-Diagramm
Links ist der Encoder, rechts ist der Decoder.
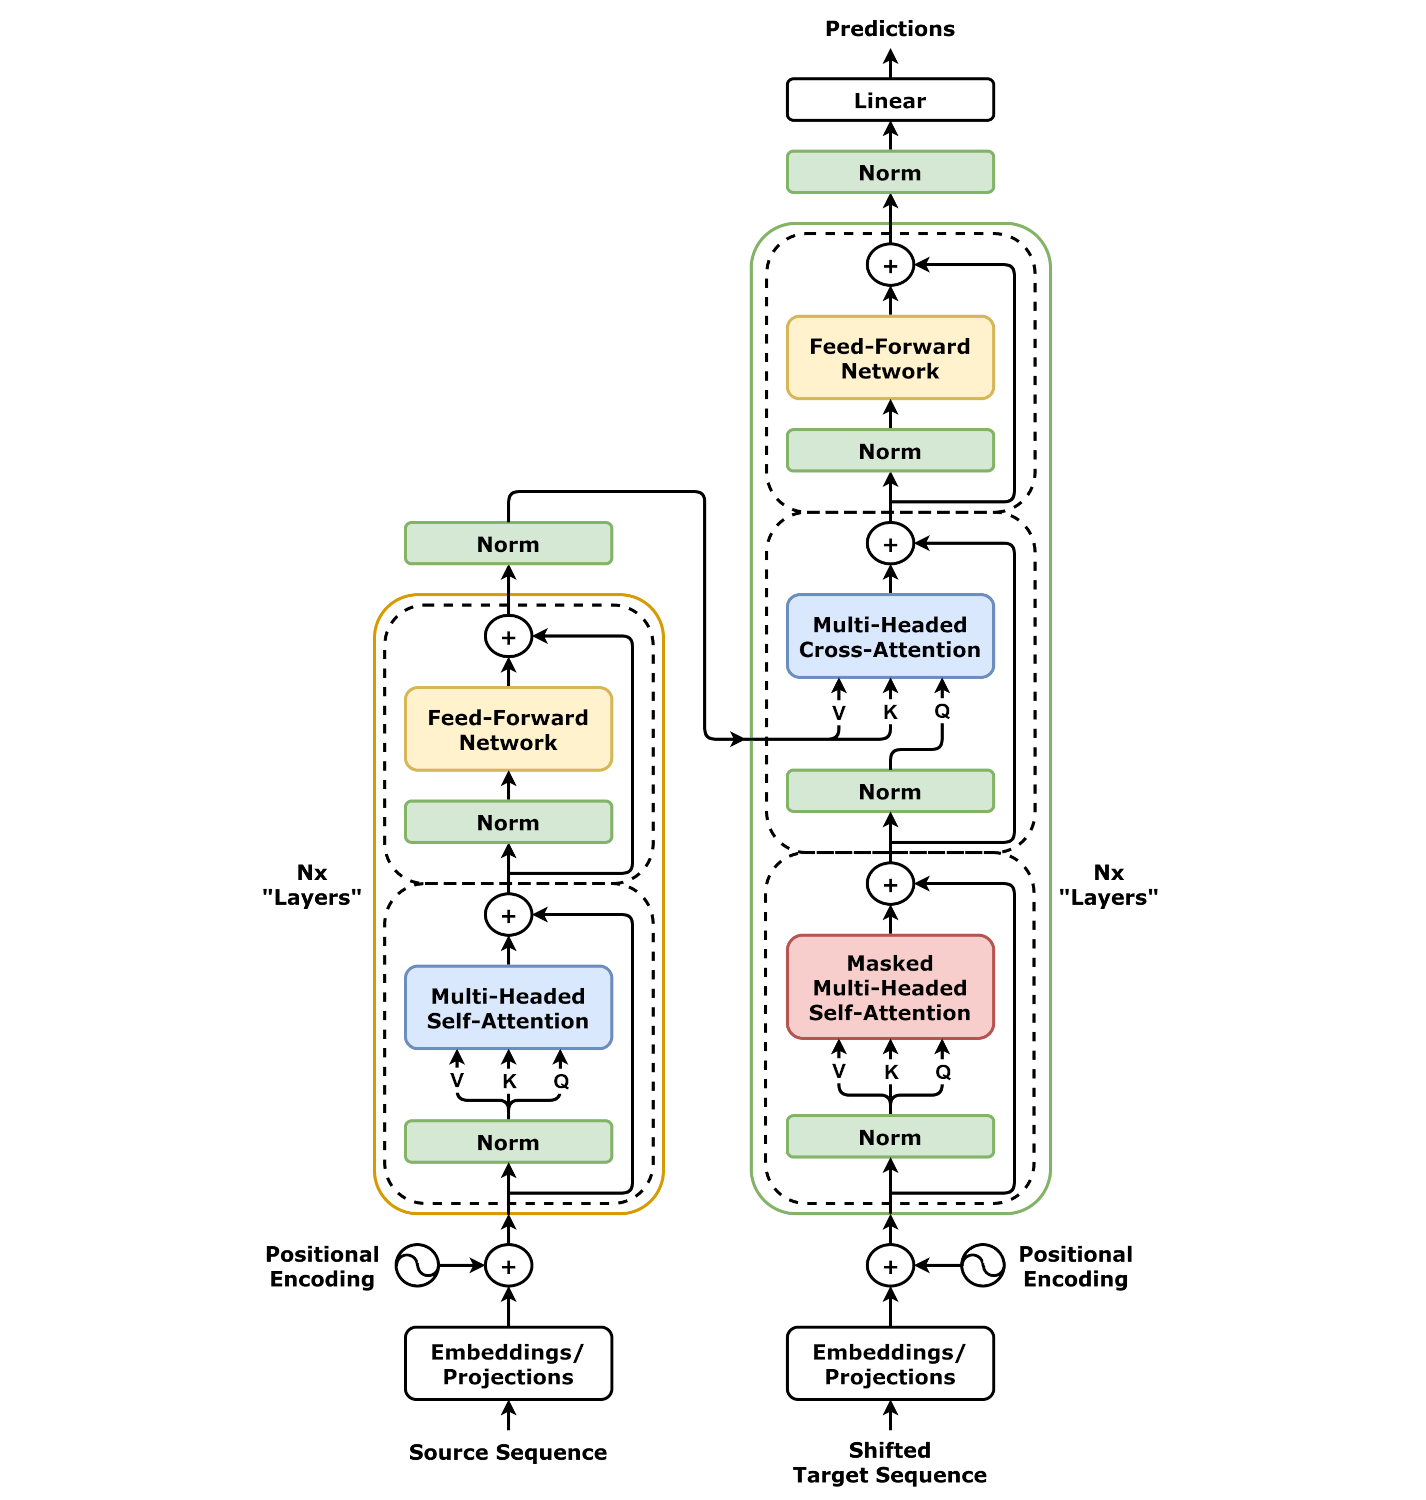
1. Eingabeverarbeitung (unten)
- Embeddings/Projektionen (Embedding-/Projektionsschicht)
- Funktion: Eingabewörter (oder Tokens) in numerische Vektoren umwandeln (z. B. „cat“ → [0.2, -0.5, 0.7…]).
- Analogie: Es ist, als würde man jedem Wort eine eindeutige „ID-Nummer“ zuweisen, aber intelligenter (sie enthält semantische Informationen).
2. Encoder (links)
-
Multi-Head-Selbstaufmerksamkeit (Multi-Head Self-Attention)
- Funktion: Ermöglicht es dem Modell, allen Wörtern in der Eingabe gleichzeitig Aufmerksamkeit zu schenken und ihre Beziehungen zu berechnen.
- Beispiel: Im Satz „cat chases mouse“ lernt das Modell, dass „cat“ und „mouse“ stärker miteinander assoziiert sind als „cat“ und „chases“.
- Wichtiger Punkt:Alle Wörter parallel verarbeiten, anders als bei RNN, das eins nach dem anderen berechnen muss.
-
Norm (Layer-Normalisierung)
- Funktion: Stabilisiert den Trainingsprozess und verhindert, dass Werte zu groß oder zu klein werden (ähnlich wie das Anpassen der „Lautstärke“ auf einen passenden Bereich).
-
Feed-Forward-Netzwerk
- Funktion: Verarbeitet die Repräsentation jedes Wortes weiter (z. B. das Extrahieren komplexerer Merkmale).
- Analogie: Wie eine tiefgehende Interpretation des Vektors für "Katze" und das Hinzufügen von Details (z. B. "eine Katze ist ein Säugetier").
3. Decoder (rechts)
-
Maskierte Multi-Head-Selbstaufmerksamkeit
- Funktion: Verhindert, dass das Modell während des Trainings "schummelt" (es kann nur aktuelle und vorherige Wörter sehen, keine zukünftigen).
- Beispiel: Wenn es "Ich liebe __" generiert, kann das Modell das nächste Wort nur auf Grundlage von "Ich" und "liebe" vorhersagen und nicht im Voraus wissen, dass die Antwort "du" lautet.
-
Multi-Head-Kreuzaufmerksamkeit
- Funktion: Ermöglicht es dem Decoder, den Encoder zu fragen: "Worauf sollte ich mich bezüglich der Eingabe konzentrieren?"
- Szenario: Bei Übersetzungsaufgaben, wenn der Decoder Englisch generiert, bezieht er sich auf die vom Encoder verarbeitete chinesische Eingabe.
-
Norm und Feed-Forward-Netzwerk
- Ähnlich wie der Encoder normalisiert es die Repräsentationen des Decoders und verarbeitet sie tiefgehend.
4. Ausgabe (oben)
- Linear (lineare Schicht)
- Funktion: Bildet die Ausgabe des Decoders auf das Vokabular ab (z. B. Vorhersage, dass das nächste Wort "you" mit der höchsten Wahrscheinlichkeit ist).
- Beispiel: Bei der Eingabe "I love," kann das Modell eine Wahrscheinlichkeit von 80% für "you" und 10% für "eat" ausgeben...
Kernidee des Transformers
Self-Attention-Mechanismus
Die Kernidee des Transformers besteht darin, sich vollständig auf den Attention-Mechanismus zu verlassen (ohne rekurrente oder konvolutionale Strukturen), um globale Abhängigkeiten in der Eingabesequenz zu erfassen und dadurch effiziente parallele Berechnung und eine stärkere Modellierung langreichweitiger Abhängigkeiten zu erreichen.
Beispiel
def self_attention(query, key, value):
scores = torch.matmul(query, key.transpose(-2, -1)) # Ähnlichkeit berechnen
weights = torch.softmax(scores, dim=-1) # In Wahrscheinlichkeitsverteilung umwandeln
output = torch.matmul(weights, value) # Gewichtete Summe
return output
Formel:
\[ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
- \(Q\) (Query), \(K\) (Key) und \(V\) (Value) sind Matrizen, die durch lineare Transformationen der Eingabe erhalten werden.
- \(\sqrt{d_k}\) ist ein Skalierungsfaktor, der verhindert, dass das Skalarprodukt zu groß wird, was ein Gradientenverschwinden verursachen würde.
Multi-Head Attention
- Führt den Self-Attention-Mechanismus mehrfach parallel aus (mehrere "Köpfe"), wobei jeder Kopf ein anderes Attention-Muster lernt und schließlich die Ergebnisse konkateniert werden.
- Vorteil: Reichhaltigere kontextuelle Informationen erfassen (wie lokale/globale Abhängigkeiten, syntaktische/semantische Merkmale).
Positionale Codierung
- Der Transformer selbst besitzt keine rekurrente oder konvolutionale Struktur und kann die Reihenfolge der Sequenz nicht direkt wahrnehmen, daher muss Positionsinformation explizit injiziert werden.
- Sinus-/Kosinusfunktionen oder lernbare Positionskodierung verwenden:

Feed-Forward-Netzwerk (FFN)
- Die Repräsentation an jeder Position wird durch ein zweischichtiges vollständig verbundenes Netzwerk (mit einer nichtlinearen Aktivierung wie ReLU) weiter transformiert.
- Formel: \( \text{FFN}(x) = \max(0, xW_1 + b_1)W_2 + b_2 \).
Residualverbindung & Layer-Normalisierung
- Residualverbindung: Addiert die Eingabe direkt zur Ausgabe (z. B. \( x + \text{Sublayer}(x) \)), um verschwindende Gradienten abzumildern.
- Layer-Normalisierung: Normalisiert die Ausgabe jeder Schicht, um das Training zu beschleunigen.
Fähigkeit zur parallelen Verarbeitung
Im Gegensatz zu traditionellen RNN/LSTM kann der Transformer die gesamte Sequenz parallel verarbeiten, was die Trainingseffizienz erheblich verbessert.
Modellierung globaler Abhängigkeiten
Egal wie weit Wörter voneinander entfernt sind, der Transformer kann direkt Abhängigkeiten zwischen ihnen herstellen und löst damit das Problem langreichweitiger Abhängigkeiten.
Encoder-Decoder-Architektur
Der Transformer verwendet die klassische Encoder-Decoder-Architektur, aber jeder Teil besteht aus mehreren gestapelten identischen Modulen.
Encoder
| Komponente | Funktionsbeschreibung | Bedeutung |
|---|---|---|
| Multi-Head Attention | Erfasst semantische Informationen aus verschiedenen Unterräumen | ★★★★★ |
| Feed-Forward-Netzwerk | Nichtlineare Transformation und Merkmalsextraktion | ★★★★ |
| Residualverbindung | Lindert das Problem der verschwindenden Gradienten | ★★★★ |
| Layer-Normalisierung | Stabilisiert den Trainingsprozess | ★★★★ |

Decoder
Der Decoder fügt zusätzlich zum Encoder Folgendes hinzu:
- Maskierte Multi-Head-Attention: Verhindert, dass die aktuelle Position auf zukünftige Informationen achtet
- Encoder-Decoder-Attention: Integriert Quellspracheninformationen
Positionale Codierung
Da der Transformer keine rekurrente Struktur besitzt, müssen Positionsinformationen explizit injiziert werden.
Sinusförmige Positionskodierungsformel
Die Formel ist in zwei Teile unterteilt, die den geraden und ungeraden Dimensionen des Positionskodierungsvektors entsprechen:Gerade Dimensionen (2i),Ungerade Dimensionen (2i+1)。
Parameter description:
pos: Die Position des Wortes in der Sequenz (z. B. das 1. Wort, das 2. Wort, usw.).i: Der Dimensionsindex des Positionskodierungsvektors (0 ≤ i < d_model/2)。d_model: Die Dimension der Positionskodierung (normalerweise dieselbe wie die Wortvektordimension, wie 512, 768 usw.).
Eigenschaften der Positionskodierung
- Empfindlichkeit gegenüber relativer Position: Kann relative Positionsbeziehungen lernen
- Erweiterbare Länge: Kann Sequenzen verarbeiten, die länger sind als die im Training gesehenen
- Determinismus: Kein Lernen erforderlich, direkt berechnet
Beispiel
class PositionalEncoding(nn.Module):
def __init__(self, d_model, max_len=5000):
super().__init__()
position = torch.arange(max_len).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model))
pe = torch.zeros(max_len, d_model)
pe[:, 0::2] = torch.sin(position * div_term)
pe[:, 1::2] = torch.cos(position * div_term)
self.register_buffer('pe', pe)
Vorteile von Transformer
Vergleich mit traditionellen Architekturen
| Eigenschaften | Transformer | RNN/LSTM | CNN |
|---|---|---|---|
| Parallelität | Vollständig parallel | Sequenzverarbeitung | Lokal parallel |
| Langreichweitige Abhängigkeiten | Direkte Modellierung | Schrittweise Übertragung | Begrenztes rezeptives Feld |
| Trainingsgeschwindigkeit | Schnell | Langsam | Mittel |
| Speicherverbrauch | Relativ hoch | Mittel | Niedrig |
Praktische Anwendungsvorteile
- Hervorragende Leistung: Erreicht State-of-the-Art bei den meisten NLP-Aufgaben
- Skalierbarkeit: Die Modellgröße kann leicht erweitert werden (z. B. GPT-3)
- Multimodale Anpassung: Kann auf verschiedene Datentypen wie Text, Bilder und Sprache angewendet werden
- Transfer-Learning-freundlich: Das Paradigma aus Pretraining + Fine-Tuning ist sehr effektiv
Praktische Übungen
Übung 1: Grundlegende Self-Attention implementieren
Beispiel
import torch.nn.functional as F
def scaled_dot_product_attention(Q, K, V, mask=None):
d_k = Q.size(-1)
scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(d_k)
if mask is not None:
scores = scores.masked_fill(mask == 0, -1e9)
weights = F.softmax(scores, dim=-1)
return torch.matmul(weights, V)
Übung 2: Positionskodierung verstehen
- Positionskodierungsvektoren an verschiedenen Positionen visualisieren
- Ähnlichkeit zwischen Positionskodierungen berechnen und Positionsbeziehungen beobachten
Häufig gestellte Fragen
F: Warum ist Transformer für langen Text besser geeignet als RNN?A: RNN muss Informationen Schritt für Schritt übertragen, und langreichweitige Abhängigkeiten gehen leicht verloren; Transformer kann jedoch direkt Beziehungen zwischen zwei beliebigen Wörtern herstellen.
F: Warum wird die Sinusfunktion für die Positionskodierung gewählt?A: Die Sinusfunktion ist periodisch, kann relative Positionsbeziehungen darstellen und lässt sich auf Sequenzlängen erweitern, die während des Trainings nicht gesehen wurden.
F: Wo liegt der wichtigste Rechenengpass des Transformers?A: Die Speicherkomplexität des Selbstaufmerksamkeitsmechanismus ist O(n²), was bei der Verarbeitung langer Sequenzen viel Speicher verbraucht.
Zusammenfassung
Die Transformer-Architektur hat die Sequenzmodellierung durch den Selbstaufmerksamkeitsmechanismus grundlegend verändert. Ihre Kernvorteile sind:
- Leistungsstarke parallele Rechenfähigkeit
- Effiziente Modellierung langfristiger Abhängigkeiten
- Flexible Skalierbarkeit
- Ausgezeichnete Performance
Die Beherrschung der Grundlagen von Transformer ist eine wichtige Grundlage für das Erlernen moderner NLP-Technologie und zugleich der Schlüssel zum Verständnis modernster Modelle wie BERT und GPT.
Andere Erweiterungen