Modèles pré-entraînés
Les modèles pré-entraînés constituent l'une des avancées technologiques les plus importantes dans le domaine du traitement du langage naturel (NLP) ces dernières années. Ces modèles sont pré-entraînés sur des données textuelles à grande échelle afin d'apprendre des capacités générales de représentation du langage, puis peuvent être affinés pour des tâches spécifiques.
Idée centrale
- Apprentissage en deux étapes: entraîner d'abord sur des données générales à grande échelle, puis ajuster finement sur des données spécifiques à la tâche à petite échelle
- Apprentissage par transfert: transférer des connaissances linguistiques générales vers des tâches spécifiques
- Partage de paramètres: le même ensemble de paramètres de modèle peut être utilisé pour plusieurs tâches en aval
Comparaison avec les méthodes traditionnelles
| Fonctionnalité | Modèles NLP traditionnels | Modèles pré-entraînés |
|---|---|---|
| Besoins en données | Nécessite de grandes quantités de données étiquetées | Ne nécessite que de petites quantités de données étiquetées |
| Méthode d'entraînement | Entraînement à partir de zéro | Pré-entraînement + ajustement fin |
| Capacité de généralisation | Spécifique à la tâche | Général inter-tâches |
| Efficacité de développement | Faible | Élevée |
Historique du développement des modèles pré-entraînés
1. Ère du plongement de mots (2013-2017)
- Modèles représentatifs: Word2Vec, GloVe, FastText
- Caractéristiques:
- Représentation vectorielle statique des mots
- Ne peut pas gérer la polysémie
- Indépendant du contexte
Exemple
# Exemple Word2Vec
from gensim.models import Word2Vec
sentences = [["natural", "language", "processing"], ["pre-trained", "model", "is very powerful"]]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1)
print(model.wv["natural"]) # Vecteur de mot en sortie
from gensim.models import Word2Vec
sentences = [["natural", "language", "processing"], ["pre-trained", "model", "is very powerful"]]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1)
print(model.wv["natural"]) # Vecteur de mot en sortie
2. Ère sensible au contexte (2018-2019)
- Modèles représentatifs: ELMo, ULMFiT
- Percée:
- Représentation dynamique des mots
- Peut gérer la polysémie
- Modèle de langage bidirectionnel
3. Ère des Transformers (2019)
- Modèles emblématiques: BERT, GPT, T5
- Améliorations révolutionnaires:
- Basé sur l'architecture Transformer
- Pré-entraînement à grande échelle
- Forte capacité d'apprentissage par transfert
Architectures des modèles pré-entraînés courants
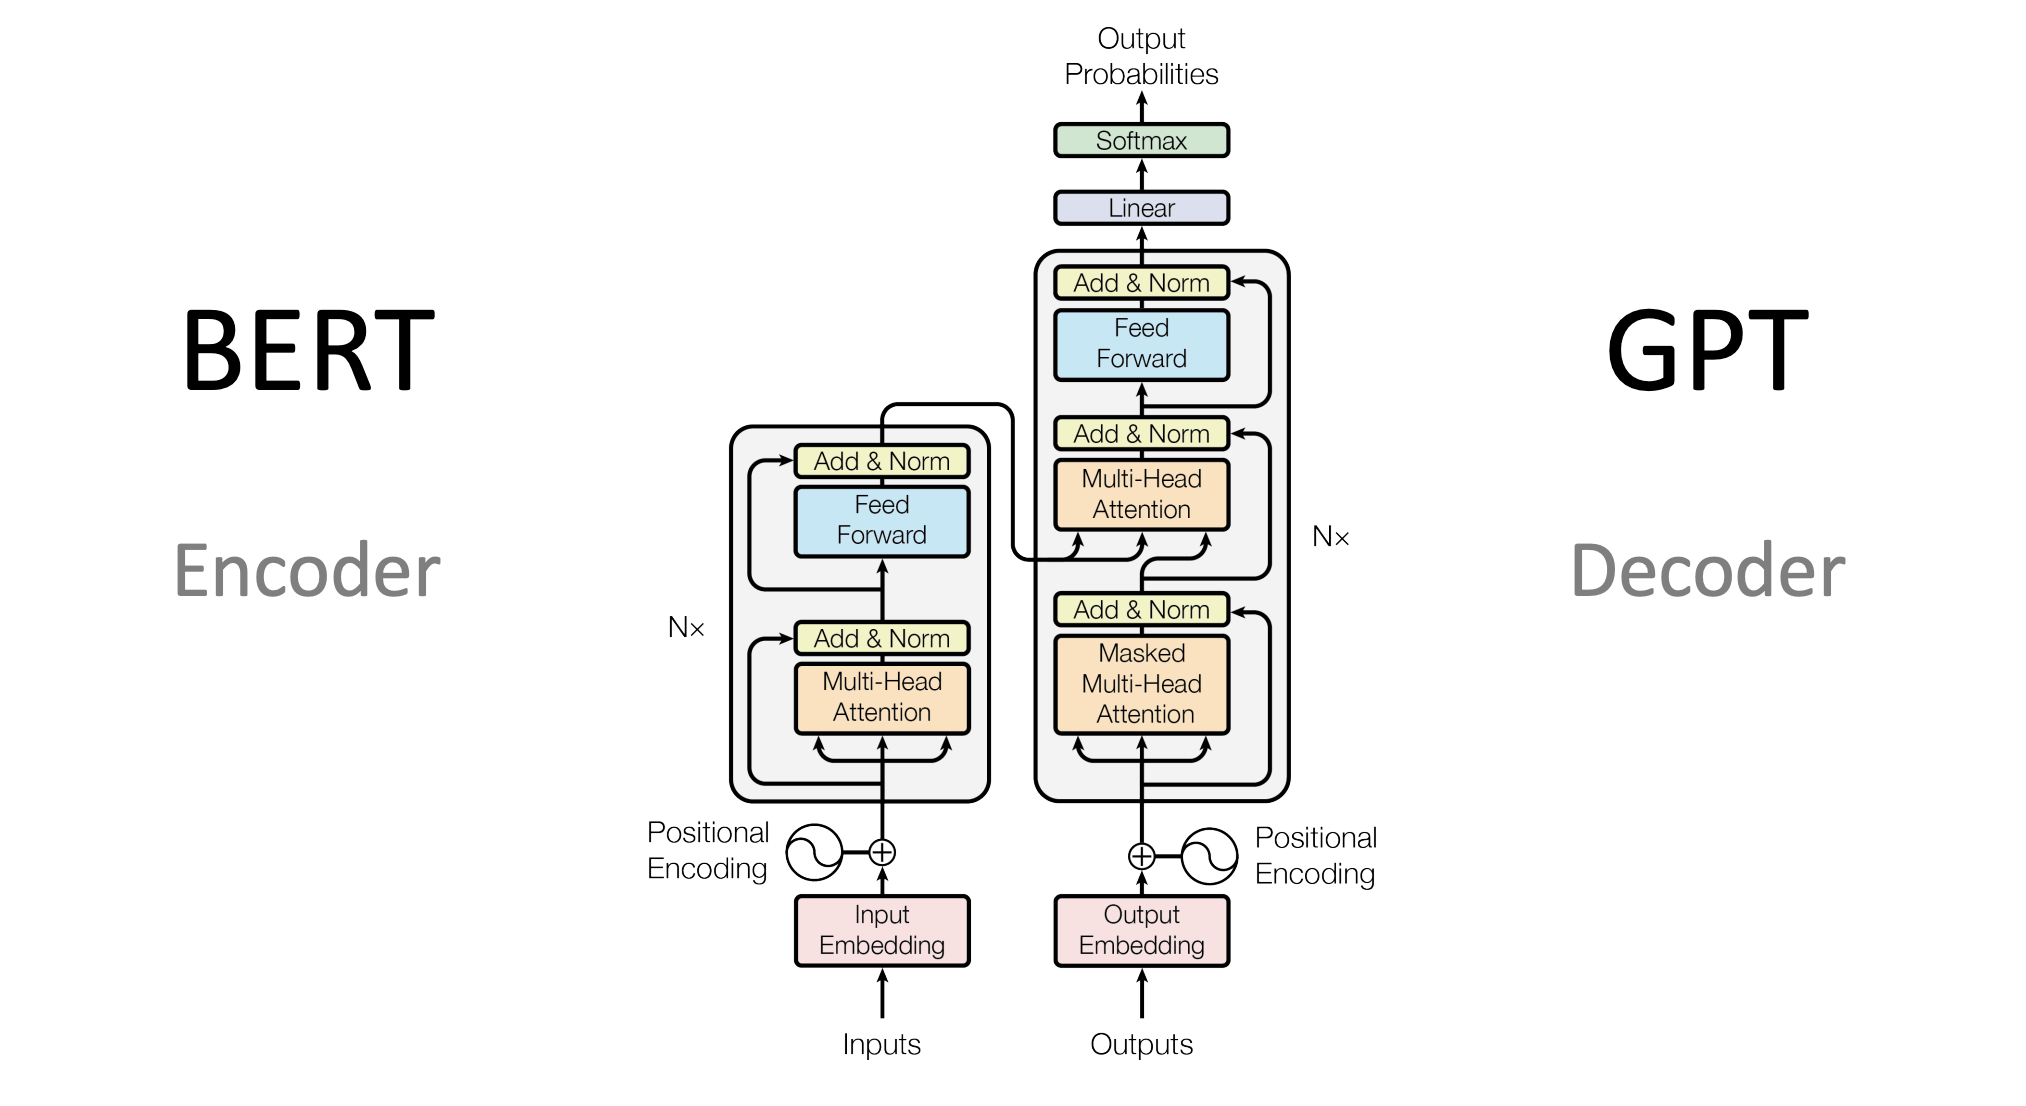
1. Architecture encodeur (série BERT)
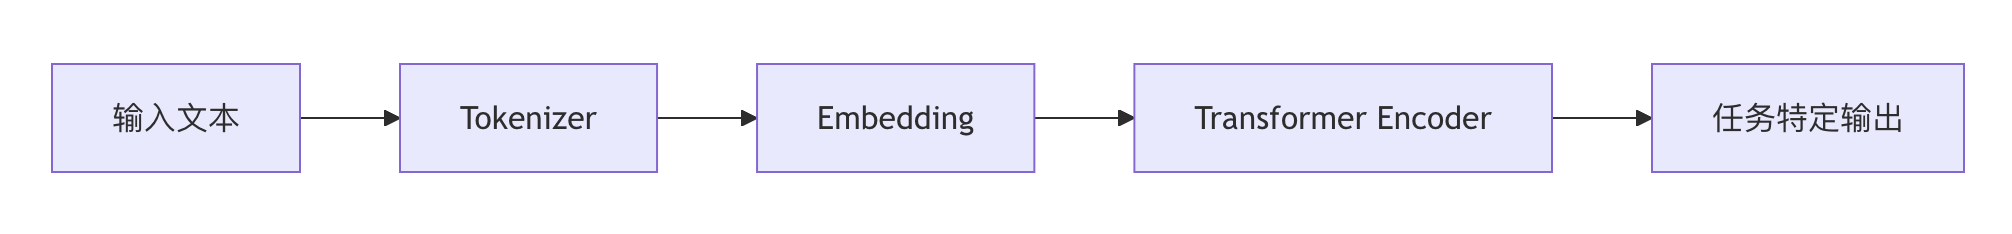
- Caractéristiques:
- Compréhension du contexte bidirectionnel
- Adapté à la classification, aux questions-réponses et à d'autres tâches
- Modèles représentatifs : BERT, RoBERTa, ALBERT
2. Architecture décodeur (série GPT)

- Caractéristiques:
- Contexte unidirectionnel (de gauche à droite)
- Performant pour la génération de texte
- Modèles représentatifs : GPT-3, GPT-4
3. Architecture encodeur-décodeur

- Caractéristiques:
- Adapté aux tâches de séquence à séquence
- Modèles représentatifs : T5, BART
Types de tâches de pré-entraînement
1. Modèle de langage (LM)
- Objectif: Prédire le mot suivant
- Formule:P(w_t | w_1, ..., w_{t-1})
2. Modèle de langage masqué (MLM)
- Exemple:
- Phrase originale : « Le modèle pré-entraîné est très puissant »
- Après masquage : « Le [MASK] pré-entraîné est très puissant »
- Prédiction du modèle : « modèle »
3. Prédiction de la phrase suivante (NSP)
- Déterminersi deux phrases sont consécutives
- Exemple positif :
- Phrase A : « Le modèle pré-entraîné est très puissant »
- Phrase B : « Ils peuvent gérer plusieurs tâches NLP »
- Exemple négatif :
- Phrase A : « Le modèle pré-entraîné est très puissant »
- Phrase B : "Le temps est vraiment agréable aujourd'hui"
- Exemple positif :
4. Autres tâches
- Détection de jetons remplacés (RTD)
- Prédiction de l'ordre des phrases (SOP)
Comment utiliser les modèles pré-entraînés
1. Utilisation de Hugging Face Transformers
Exemple
from transformers import pipeline
# Exemple d'analyse de sentiment
classifier = pipeline("sentiment-analysis")
result = classifier("Les modèles pré-entraînés sont vraiment incroyables !")
print(result) # [{'label': 'POSITIVE', 'score': 0.9998}]
# Exemple d'analyse de sentiment
classifier = pipeline("sentiment-analysis")
result = classifier("Les modèles pré-entraînés sont vraiment incroyables !")
print(result) # [{'label': 'POSITIVE', 'score': 0.9998}]
2. Processus d'affinage du modèle
- Charger un modèle pré-entraîné
- Préparer un jeu de données spécifique à la tâche
- Ajouter une couche de sortie spécifique à la tâche
- Entraînement par ajustement fin
Exemple
from transformers import BertForSequenceClassification, Trainer
model = BertForSequenceClassification.from_pretrained("bert-base-chinese")
# Préparer les données d'entraînement...
trainer = Trainer(model=model, args=training_args, train_dataset=train_dataset)
trainer.train()
model = BertForSequenceClassification.from_pretrained("bert-base-chinese")
# Préparer les données d'entraînement...
trainer = Trainer(model=model, args=training_args, train_dataset=train_dataset)
trainer.train()
3. Descriptions des paramètres clés
| Paramètre | Description | Valeur typique |
|---|---|---|
| learning_rate | Taux d'apprentissage | 2e-5 |
| batch_size | Taille du lot | 16/32 |
| num_train_epochs | Nombre d'époques d'entraînement | 3-5 |
| max_length | Longueur maximale de séquence | 512 |
Scénarios d'application des modèles pré-entraînés
1. Classification de texte
- Analyse de sentiment
- Détection de spam
- Classification thématique
2. Systèmes de questions-réponses
- Questions-réponses extractives
- Questions-réponses en domaine ouvert
3. Génération de texte
- Résumé automatique
- Systèmes de dialogue
- Création de contenu
4. Autres applications
- Reconnaissance d'entités nommées (NER)
- Traduction automatique
- Calcul de similarité textuelle
Suggestions pratiques
Sélection du modèle:
- Pour les tâches de classification, privilégiez les modèles de type BERT
- Pour les tâches de génération, choisissez les modèles de type GPT
- Lorsque les ressources sont limitées, envisagez des modèles distillés (par ex., DistilBERT)
Gestion des ressources:
- Réduisez batch_size lorsque la mémoire GPU est insuffisante
- Faites attention aux limites de max_length lors du traitement de textes longs
- Envisagez d'utiliser des techniques de quantification de modèle
Optimisation des performances:
- Le taux d'apprentissage nécessite un réglage fin
- L'arrêt précoce permet d'éviter le surapprentissage
- Essayez différents optimiseurs (AdamW, etc.)
Apprentissage continu:
- Suivez la communauté Hugging Face
- Suivez les derniers articles sur arXiv
- Participez à la pratique de projets open source
Orientations futures de développement
- À plus grande échelle: Les paramètres du modèle continuent de croître (par ex., les mille milliards de paramètres de GPT-4)
- Fusion multimodale: Combinaison de texte avec des images et de la parole
- Optimisation de l'efficacité énergétique: des méthodes d'entraînement et d'inférence plus efficaces
- Adaptation de domaine: des modèles pré-entraînés pour des domaines spécialisés
- Éthique et sécurité: traiter des problèmes tels que les biais et la toxicité
Les modèles pré-entraînés transforment le paysage technologique du domaine du NLP. Comprendre leurs principes fondamentaux et maîtriser leurs méthodes d'application deviendront des compétences essentielles pour les ingénieurs en NLP.
Autres extensions Référence des commandes Linux