Rekurrentes neuronales Netz (RNN)
Ein rekurrentes neuronales Netz (RNN) ist ein neuronales Netz, das speziell für die Verarbeitung sequenzieller Daten (wie Text, Sprache und Zeitreihen) entwickelt wurde.
Im Gegensatz zu traditionellen Feedforward-Netzen haben RNNs eine "Gedächtnis"-Fähigkeit, die Informationen aus vorherigen Schritten behalten kann.
RNNs verwenden den verborgenen Zustand aus dem vorherigen Schritt, um die Ausgabe des aktuellen Schritts zu beeinflussen, und erfassen dadurch zeitliche Abhängigkeiten in Sequenzen.
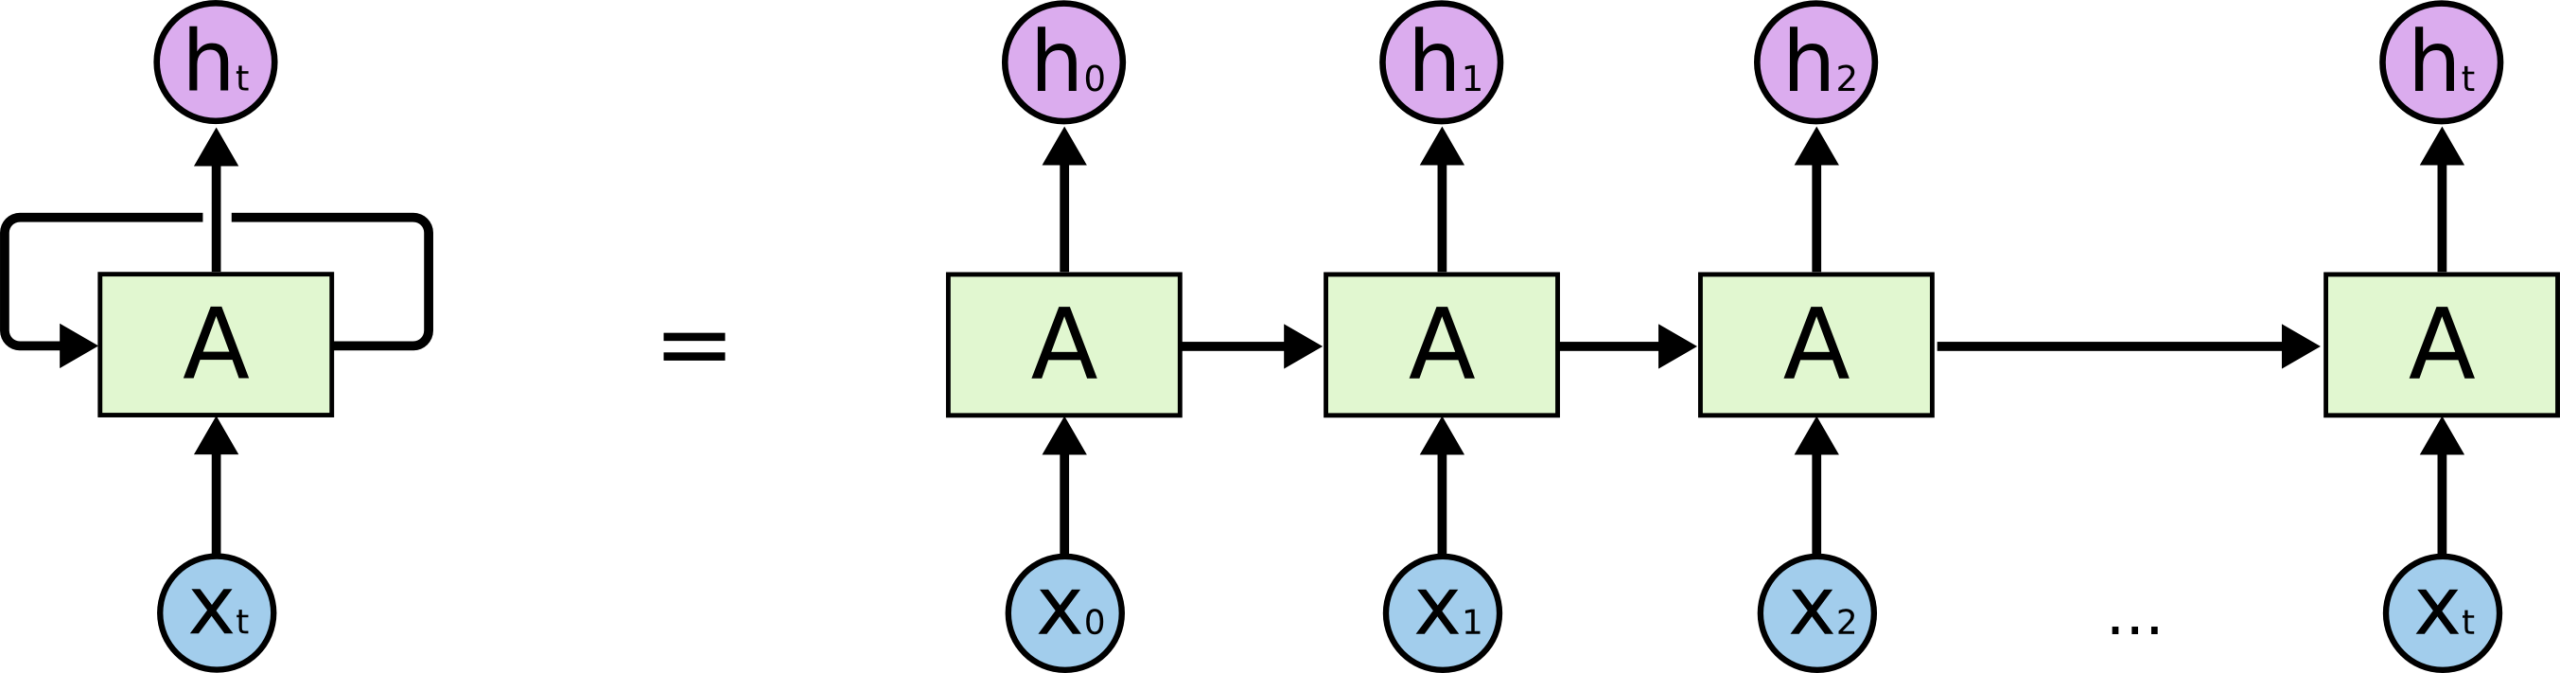
Kernidee von RNN
The core of RNN lies inwiederkehrenden Verbindungen(Recurrent Connection), was bedeutet, dass die Ausgabe des Netzwerks nicht nur von der aktuellen Eingabe abhängt, sondern auch von den Eingaben aus allen vorherigen Zeitschritten. Diese Struktur ermöglicht es RNNs, sequenzielle Daten beliebiger Länge zu verarbeiten.
Traditional neural networks: Eingaben und Ausgaben sind unabhängig (z. B. Bildklassifizierung, bei der einzelne Bilder nichts miteinander zu tun haben).
RNN: Durchwiederkehrende Verbindungen(Recurrent Connection) wird der verborgene Zustand aus dem vorherigen Schritt an den nächsten Schritt weitergegeben, wodurch ein "Gedächtnis" entsteht.
Eingabe bei jedem Schritt = aktuelle Daten + verborgener Zustand aus dem vorherigen Schritt.
Die Ausgabe hängt nicht nur von der aktuellen Eingabe ab, sondern auch vom Kontext aus allen vorherigen Schritten.
Genauso wie beim Lesen eines Satzes hängt das Verständnis des aktuellen Wortes von zuvor gelesenem Inhalt ab (z. B. "Er öffnete die __", würde man "Tür" oder "Buch" vorhersagen).
Beispiel
import numpy as np
class SimpleRNN:
def __init__(self, input_size, hidden_size):
self.Wx = np.random.randn(hidden_size, input_size) # Eingabegewichte
self.Wh = np.random.randn(hidden_size, hidden_size) # Gewichte des verborgenen Zustands
self.b = np.zeros((hidden_size, 1)) # Bias-Term
def forward(self, x, h_prev):
h_next = np.tanh(np.dot(self.Wx, x) + np.dot(self.Wh, h_prev) + self.b)
return h_next
Wie RNN funktioniert
Bei jedem Zeitschritt t führt das RNN die folgenden Berechnungen aus:
- Erhält die aktuelle Eingabe xₜ und den verborgenen Zustand hₜ₋₁ vom vorherigen Zeitschritt
- Berechnet den neuen verborgenen Zustand hₜ = f(Wₕₕ·hₜ₋₁ + Wₓₕ·xₜ + b)
- Erzeugt die Ausgabe yₜ = g(Wₕᵧ·hₜ + c)
Dabei sind f und g typischerweise Aktivierungsfunktionen (wie tanh oder softmax).
Vor- und Nachteile von RNN
Vorteile:
- Kann Sequenzen variabler Länge verarbeiten
- Kann theoretisch historische Informationen beliebiger Länge speichern
- Parameter-Sharing (für alle Zeitschritte wird derselbe Satz Gewichte verwendet)
Nachteile:
- Problem verschwindender/explodierender Gradienten (schwierig, langfristige Abhängigkeiten zu erlernen)
- Geringe Recheneffizienz (Zeitschritte können nicht parallel verarbeitet werden)
Long Short-Term Memory (LSTM)
LSTM (Long Short-Term Memory) ist eine verbesserte Architektur von RNN, die speziell entwickelt wurde, um das Problem langfristiger Abhängigkeiten von Standard-RNNs zu lösen.
2.1 Kernstruktur von LSTM
LSTM führt drei Gating-Mechanismen und eine Speicherzelle ein:
| Komponente | Funktion |
|---|---|
| Eingangstor | Steuert den Fluss neuer Informationen |
| Vergessensgatter | Entscheidet, welche alten Informationen verworfen werden |
| Ausgabegatter | Steuert die Menge an Informationen, die ausgegeben werden |
| Speicherzelle | Speichert den Langzeitzustand |
Beispiel
class LSTMCell:
def __init__(self, input_size, hidden_size):
# Kombiniere die Gewichte aller Gatter
self.W = np.random.randn(4*hidden_size, input_size+hidden_size)
self.b = np.random.randn(4*hidden_size, 1)
def forward(self, x, h_prev, c_prev):
combined = np.vstack((h_prev, x))
gates = np.dot(self.W, combined) + self.b
# Aufteilen, um jedes Gate zu erhalten
f_gate = sigmoid(gates[:hidden_size]) # Vergessens-Gate
i_gate = sigmoid(gates[hidden_size:2*hidden_size]) # Eingabe-Gate
o_gate = sigmoid(gates[2*hidden_size:3*hidden_size]) # Ausgabe-Gate
c_candidate = np.tanh(gates[3*hidden_size:]) # Kandidatenspeicher
# Speicher und verborgenen Zustand aktualisieren
c_next = f_gate * c_prev + i_gate * c_candidate
h_next = o_gate * np.tanh(c_next)
return h_next, c_next
Wie LSTM das Problem der langfristigen Abhängigkeiten löst
- Selektives Gedächtnis: Das Vergessens-Gate kann entscheiden, bestimmte Informationen beizubehalten oder zu verwerfen
- Gradientenpfad: Die Speicherzelle bietet einen relativ direkten Pfad für die Gradientenausbreitung
- Informationsschutz: Der gespeicherte Gedächtnisinhalt wird nicht direkt durch die Operationen bei jedem Zeitschritt verändert
Gated Recurrent Unit (GRU)
GRU (Gated Recurrent Unit) ist eine vereinfachte Version von LSTM, die die Anzahl der Parameter reduziert und dabei eine ähnliche Leistung beibehält.
Kernstruktur von GRU
GRU führt bestimmte Komponenten von LSTM zusammen:
| Komponente | Funktion |
|---|---|
| Update-Gate | Entscheidet, wie viele alte Informationen beibehalten werden |
| Reset-Gate | Entscheidet, wie neue und alte Informationen kombiniert werden |
| Kandidatenaktivierung | Neuer Zustand, berechnet auf Basis des Reset-Gates |
Beispiel
class GRUCell:
def __init__(self, input_size, hidden_size):
self.W = np.random.randn(3*hidden_size, input_size+hidden_size)
self.b = np.random.randn(3*hidden_size, 1)
def forward(self, x, h_prev):
combined = np.vstack((h_prev, x))
gates = np.dot(self.W, combined) + self.b
# Gating-Signale aufteilen
z = sigmoid(gates[:hidden_size]) # Update-Gate
r = sigmoid(gates[hidden_size:2*hidden_size]) # Reset-Gate
h_candidate = np.tanh(np.dot(self.W[2*hidden_size:],
np.vstack((r*h_prev, x))) + self.b[2*hidden_size:]
# Versteckten Zustand aktualisieren
h_next = (1-z)*h_prev + z*h_candidate
return h_next
GRU vs. LSTM
| Merkmal | GRU | LSTM |
|---|---|---|
| Anzahl der Parameter | Weniger | Mehr |
| Trainingsgeschwindigkeit | Schneller | Langsamer |
| Speicherzelle | Keine | Ja |
| Anzahl der Gates | 2 | 3 |
| Leistung | Besser für kleine Datensätze | Kann bei großen Datensätzen besser sein |
Bidirektionales RNN (Bi-RNN)
Bidirektionales RNN verbessert die Fähigkeit zur Sequenzmodellierung, indem es gleichzeitig vergangene und zukünftige Kontextinformationen berücksichtigt.
Bidirektionale RNN-Architektur
Bi-RNN besteht aus zwei unabhängigen RNN-Schichten:
- Vorwärtsschicht: verarbeitet die Sequenz in chronologischer Reihenfolge
- Rückwärtsschicht: verarbeitet die Sequenz in umgekehrter chronologischer Reihenfolge
Die endgültige Ausgabe ist eine Kombination der Ausgaben aus beiden Richtungen (üblicherweise Konkatenation oder Summation).

Anwendungsszenarien von bidirektionalen RNNs
- Verarbeitung natürlicher Sprache: Part-of-Speech-Tagging, Erkennung benannter Entitäten
- Spracherkennung: Nutzt den umgebenden Kontext, um die Genauigkeit zu verbessern
- Bioinformatik: Proteinstrukturvorhersage
- Zeitreihenvorhersage: Berücksichtigt historische und zukünftige Trends
Bidirektionale LSTM/GRU
In modernen Anwendungen verwenden bidirektionale RNNs typischerweise LSTM oder GRU als Grundeinheit:
Beispiel
model.add(Bidirectional(LSTM(64))) # Eine bidirektionale LSTM-Schicht erstellen
Praktische Übungen
Übung 1: Implementieren Sie ein einfaches RNN
Verwenden Sie Python und NumPy, um ein einfaches RNN zu implementieren, das Text auf Zeichenebene generieren kann.
Übung 2: LSTM-Sentimentanalyse
Verwende Keras, um einen LSTM-basierten Sentiment-Klassifikator für Filmkritiken zu erstellen.
Übung 3: Bidirektionale GRU-Erkennung benannter Entitäten
Implementiere ein bidirektionales GRU-Modell, um Entitäten wie Personennamen und Orte im Text zu identifizieren.
Übung 4: Vergleichendes Experiment
Vergleiche die Leistungsunterschiede von Vanilla-RNN, LSTM und GRU auf demselben Datensatz.
Zusammenfassung und weiterführendes Lernen
RNN und seine Varianten sind leistungsstarke Werkzeuge zur Verarbeitung sequenzieller Daten. Um sie tiefgehend zu beherrschen:
- Verstehe, wie Gradienten in RNNs propagieren
- Lerne, wie der Attention-Mechanismus RNNs verbessert
- Erkunde die Beziehung zwischen der Transformer-Architektur und RNNs
- Übe verschiedene Aufgaben der Sequenzmodellierung (maschinelle Übersetzung, Sprachsynthese usw.)