Codex CLI-Modellauswahl
Codex unterstützt mehrere KI-Modelle, und verschiedene Modelle haben ihre eigenen Eigenschaften hinsichtlich Geschwindigkeit, Fähigkeiten und Kosten. In diesem Abschnitt wird detailliert beschrieben, wie man das richtige Modell auswählt.
Verfügbare Modelle
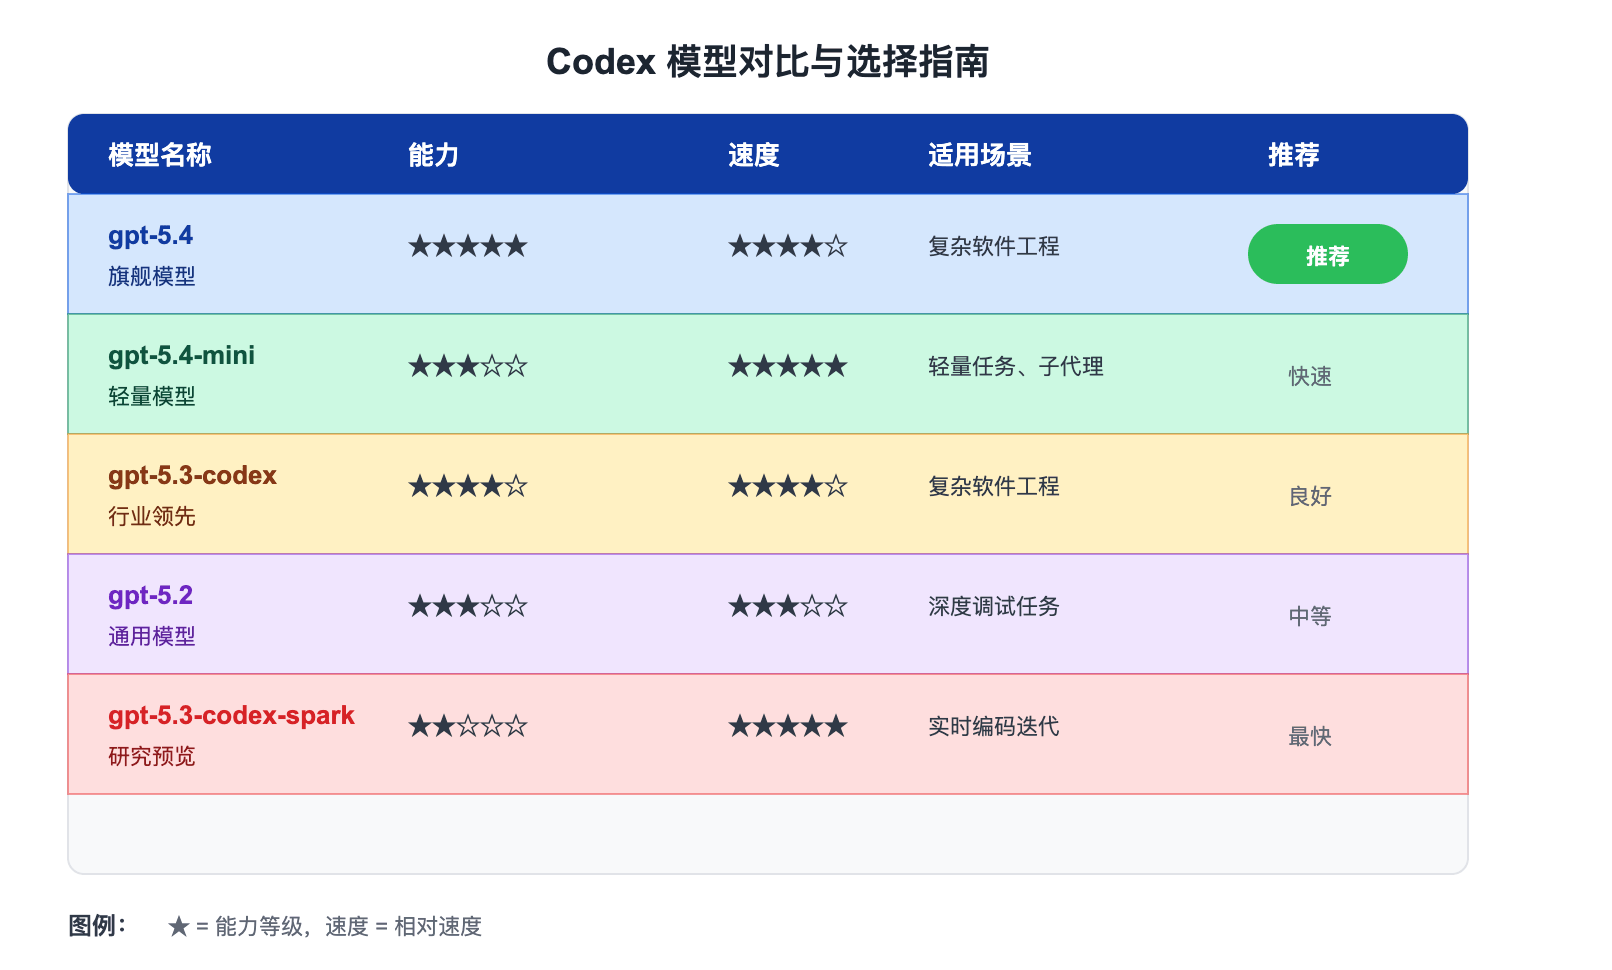
Empfohlene Modelle
| Modell | Funktionen | Anwendungsfälle |
|---|---|---|
| gpt-5.4 | Neuestes Flaggschiffmodell mit den stärksten Programmierfähigkeiten | Komplexe Softwareentwicklung, professionelle Arbeit |
| gpt-5.4-mini | Schnelles und effizientes, leichtgewichtiges Modell | Reaktionsschnelle Coding-Aufgaben, Subagenten |
| gpt-5.3-codex | Branchenführendes Coding-Modell | Komplexe Software-Engineering-Aufgaben |
Für die meisten Codex-Aufgaben wird empfohlen, mit gpt-5.4 zu beginnen. Es kombiniert leistungsstarkes Coding, Reasoning, native Computernutzung und umfassendere professionelle Workflows in einem einzigen Modell.
Alternative Modelle
| Modell | Funktionen | Anwendungsfälle |
|---|---|---|
| gpt-5.2 | Allzweckmodell, das zuvor für Coding- und Agent-Aufgaben verwendet wurde | Komplexe Debugging-Aufgaben, die tiefes Nachdenken erfordern |
Empfehlungen zur Auswahl
Tägliche Coding-Aufgaben
Verwenden Siegpt-5.4als Standardauswahl. Es schneidet bei verschiedenen Coding-Aufgaben hervorragend ab.
Einfache/Schnelle Aufgaben
Verwenden Siegpt-5.4-miniwenn du eine schnellere, kostengünstigere Option für leichtgewichtige Coding-Aufgaben oder Subagenten möchtest.
Komplexe Reasoning-Aufgaben
Wenn du auf schwierige Debugging-Aufgaben stößt, die tiefes Nachdenken erfordern, kannst du Folgendes versuchengpt-5.2。
Standardmodell konfigurieren
Du kannst das Standardmodell in der Konfigurationsdatei festlegen:
Standardmodell konfigurieren
# Standardmodell festlegen
model = "gpt-5.4"
Wenn kein Modell angegeben ist, verwendet die Codex-App, das CLI oder die IDE-Erweiterung standardmäßig das empfohlene Modell.
Modell vorübergehend ändern
Verwenden von Befehlszeilenargumenten
Modell über die Befehlszeile angeben
codex -m gpt-5.4
# Den exec-Befehl verwenden
codex exec -m gpt-5.4 "diesen Fehler beheben"
Innerhalb einer Sitzung wechseln
Modelle innerhalb einer Sitzung wechseln
/model gpt-5.4-mini
# Oder den Befehl /model verwenden
/gpt-5.2
Wechseln in der IDE-Erweiterung
Verwenden Sie in der IDE-Erweiterung die Modellauswahl unter dem Eingabefeld, um zwischen Modellen zu wechseln.
Reasoning-Konfiguration
Codex unterstützt die Anpassung des Reasoning-Aufwands
| Konfigurationswert | Beschreibung |
|---|---|
minimal | Minimales Reasoning |
low | Geringes Reasoning |
medium | Mittleres Reasoning (Standard) |
high | Hohes Reasoning |
xhigh | Sehr hohes Reasoning (modellabhängig) |
Reasoning-Aufwand konfigurieren
model_reasoning_effort = "medium"
# Spezifischen Reasoning-Aufwand für den Plan-Modus festlegen
plan_mode_reasoning_effort = "high"
Ein höherer Reasoning-Aufwand erzeugt durchdachtere Antworten, kann aber langsamer sein und mehr Ressourcen verbrauchen.
Reasoning-Zusammenfassung
Sie können den Detaillierungsgrad der Reasoning-Zusammenfassung steuern:
| Konfigurationswert | Beschreibung |
|---|---|
auto | Automatische Auswahl |
concise | Kurze Zusammenfassung |
detailed | Detaillierte Zusammenfassung |
none | Zusammenfassung deaktivieren |
Reasoning-Zusammenfassung konfigurieren
model_reasoning_summary = "auto"
Benutzerdefinierte Modellanbieter
Zusätzlich zu OpenAI-Modellen können Sie auch andere Modellanbieter konfigurieren:
Benutzerdefiniert konfigurieren
# Anzeigename des Anbieters
name = "My Custom Provider"
# API-Basis-URL
base_url = "https://api.example.com/v1"
# API-Schlüssel-Umgebungsvariable
env_key = "CUSTOM_PROVIDER_API_KEY"
# Weitere Konfiguration
http_headers = {
"X-Custom-Header": "value"
}
Unterstützt jedes Modell und jeden Anbieter, der die Chat Completions- oder Responses-API unterstützt.
Service-Tier
Codex unterstützt verschiedene Service-Tiers:
| Service-Tier | Beschreibung |
|---|---|
flex | Flexible Stufe, optimiert für Kosten |
fast | Schnelle Stufe, Priorität auf Geschwindigkeit |
Service-Tier konfigurieren
service_tier = "fast"
Best Practices für die Modellauswahl
Ein neues Projekt starten
Verwenden Siegpt-5.4für die beste Gesamterfahrung.
Einfache Aufgaben
Verwenden Siegpt-5.4-minium Kosten zu sparen.
Komplexes Debugging
Erwäge die Verwendung vongpt-5.2für gründliches Debugging.
Subagenten
Subagenten verwendengpt-5.4-minifür bessere Effizienz.
Prüfen Sie regelmäßig auf Updates, da kontinuierlich neue Modelle und Verbesserungen veröffentlicht werden.
FAQ
F: Welches Modell ist am besten für tägliches Programmieren?
gpt-5.4 ist die beste Wahl für alltägliche Programmieraufgaben und bietet eine ausgewogene Mischung aus hoher Leistungsfähigkeit und angemessener Geschwindigkeit.
F: Warum wird das Mini-Modell für Subagenten empfohlen?
Subagenten führen einfachere Aufgaben aus, und Mini-Modelle können sie schneller erledigen und dabei Kosten sparen.
F: Kann ich mein eigenes Modell verwenden?
Ja, Sie können jedes Modell verwenden, das die Responses-API unterstützt, indem Sie model_providers konfigurieren.
F: Beeinflusst die Modellauswahl die Kosten?
Ja, verschiedene Modelle haben unterschiedliche Preise. Weitere Details finden Sie auf der Preisseite.
Weitere Erweiterungen