Selección de modelos de Codex CLI
Codex admite múltiples modelos de IA, y cada modelo tiene sus propias características en velocidad, capacidad y costo. Esta sección detalla cómo elegir el modelo adecuado.
Modelos disponibles
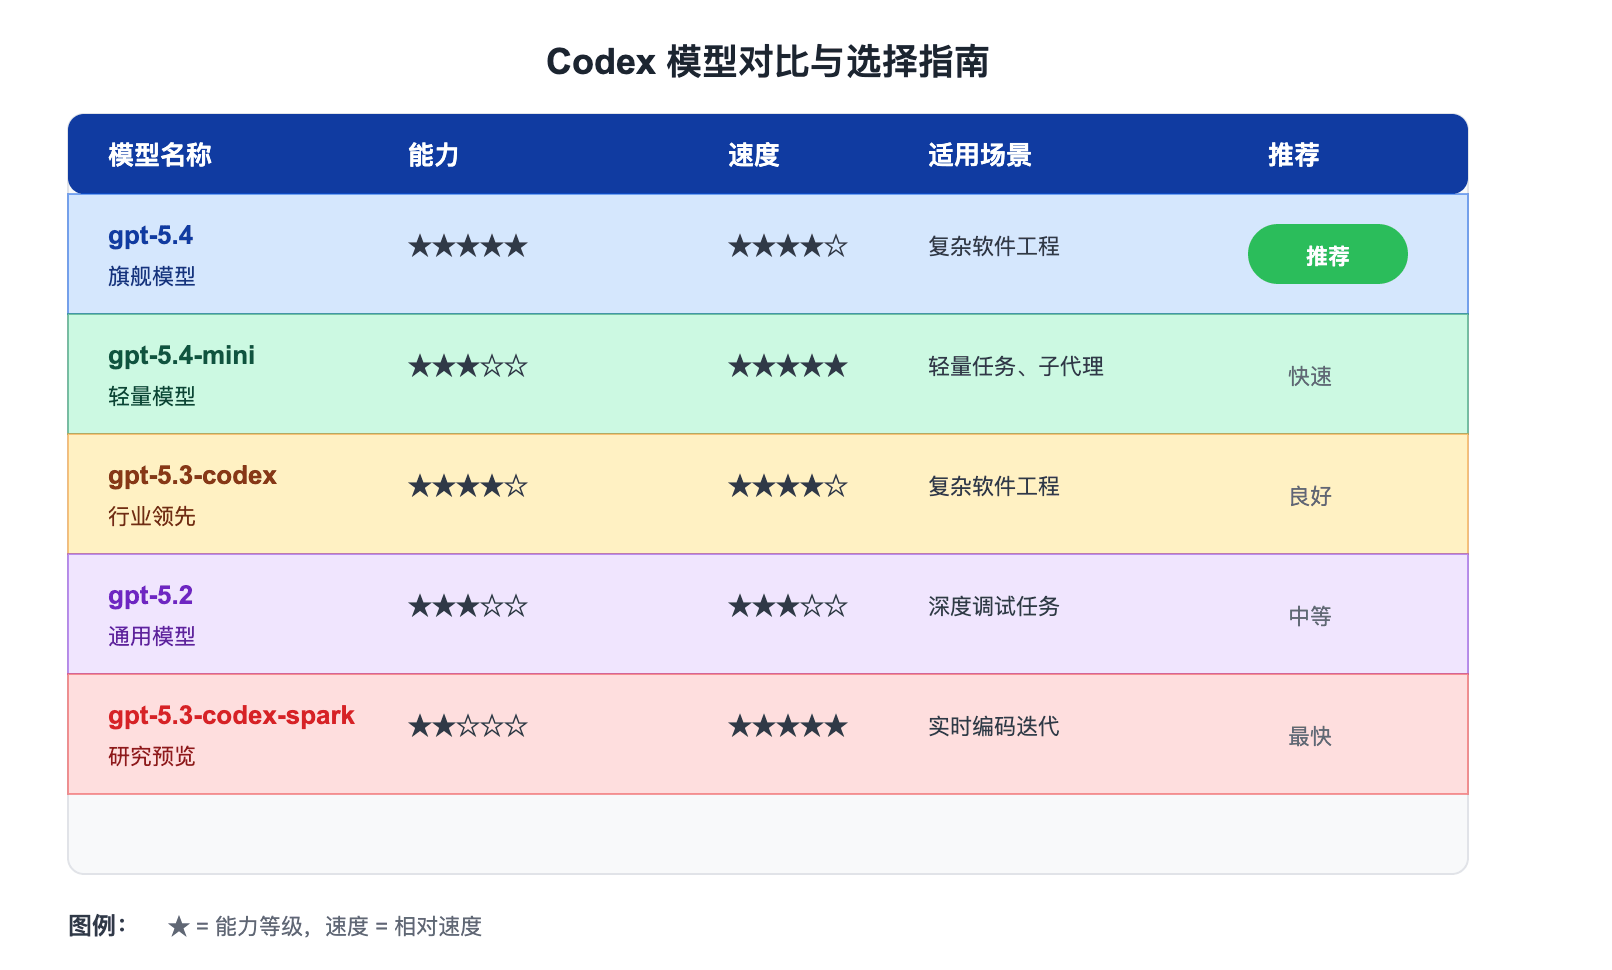
Modelos recomendados
| Modelo | Características | Escenarios de uso |
|---|---|---|
| gpt-5.4 | El último modelo insignia, la capacidad de codificación más potente | Ingeniería de software compleja, trabajo profesional |
| gpt-5.4-mini | Modelo ligero rápido y eficiente | Tareas de codificación receptivas, subagentes |
| gpt-5.3-codex | Modelo de codificación líder en la industria | Tareas de ingeniería de software complejas |
Para la mayoría de las tareas de Codex, se recomienda comenzar con gpt-5.4. Combina potentes capacidades de codificación, razonamiento, uso nativo de computadora y flujos de trabajo profesionales más amplios en un solo modelo.
Modelos alternativos
| Modelo | Características | Escenarios de uso |
|---|---|---|
| gpt-5.2 | Modelo de propósito general utilizado anteriormente para tareas de codificación y agentes | Tareas de depuración complejas que requieren pensamiento profundo |
Recomendaciones de selección
Tareas de codificación diarias
Usagpt-5.4como opción predeterminada. Funciona muy bien en una variedad de tareas de codificación.
Tareas simples/rápidas
Usagpt-5.4-minicuando quieras una opción más rápida y de menor costo para tareas de codificación ligeras o subagentes.
Tareas de razonamiento complejo
Cuando te encuentres con tareas de depuración difíciles que requieran pensamiento profundo, puedes probargpt-5.2。
Configurar el modelo predeterminado
Puedes configurar el modelo predeterminado en el archivo de configuración:
Configurar el modelo predeterminado
# Establecer el modelo predeterminado
model = "gpt-5.4"
Si no se especifica un modelo, la aplicación Codex, la CLI o la extensión del IDE usarán el modelo recomendado por defecto.
Cambiar temporalmente de modelo
Usar argumentos de línea de comandos
Especificar modelo por línea de comandos
codex -m gpt-5.4
# Usar el comando exec
codex exec -m gpt-5.4 "fix this bug"
Cambiar durante la sesión
Cambiar de modelo durante la sesión
/model gpt-5.4-mini
# O usar el comando /model
/model gpt-5.2
Cambiar en la extensión del IDE
En la extensión del IDE, usa el selector de modelos debajo del campo de entrada para cambiar de modelo.
Configuración de razonamiento
Codex permite ajustar el esfuerzo de razonamiento (reasoning effort):
| Valor de configuración | Descripción |
|---|---|
minimal | Razonamiento mínimo |
low | Razonamiento bajo |
medium | Razonamiento medio (predeterminado) |
high | Razonamiento alto |
xhigh | Razonamiento extremadamente alto (depende del modelo) |
Configurar la intensidad de razonamiento
model_reasoning_effort = "medium"
# Establecer una intensidad de razonamiento específica para el modo de planificación
plan_mode_reasoning_effort = "high"
Un mayor esfuerzo de razonamiento produce respuestas más meditadas, pero puede ser más lento y consumir más recursos.
Resumen de razonamiento
Puedes controlar el nivel de detalle del resumen de razonamiento:
| Valor de configuración | Descripción |
|---|---|
auto | Selección automática |
concise | Resumen conciso |
detailed | Resumen detallado |
none | Deshabilitar resumen |
Configurar el resumen de razonamiento
model_reasoning_summary = "auto"
Proveedores de modelos personalizados
Además de los modelos de OpenAI, también puedes configurar otros proveedores de modelos:
Configurar proveedores personalizados
# Nombre para mostrar del proveedor
name = "My Custom Provider"
# URL base de la API
base_url = "https://api.example.com/v1"
# Variable de entorno de la clave de API
env_key = "CUSTOM_PROVIDER_API_KEY"
# Otra configuración
http_headers = {
"X-Custom-Header": "value"
}
Admite cualquier modelo y proveedor que sea compatible con Chat Completions o la API de Responses.
Niveles de servicio
Codex admite diferentes niveles de servicio:
| Nivel de servicio | Descripción |
|---|---|
flex | Nivel flexible, optimiza el costo |
fast | Nivel rápido, prioriza la velocidad |
Configurar el nivel de servicio
service_tier = "fast"
Mejores prácticas para la selección de modelos
Iniciar un nuevo proyecto
Usagpt-5.4para obtener la mejor experiencia general.
Tareas simples
Usagpt-5.4-minipara ahorrar costos.
Depuración compleja
Considera usargpt-5.2para depuración profunda.
Subagentes
Los subagentes usangpt-5.4-minipara mejorar la eficiencia.
Revisa las actualizaciones periódicamente, ya que se lanzan nuevos modelos y mejoras constantemente.
Preguntas frecuentes
P: ¿Qué modelo es el mejor para la codificación diaria?
gpt-5.4 es la mejor opción para tareas de codificación diarias, ofreciendo un equilibrio entre potentes capacidades y una velocidad razonable.
P: ¿Por qué se recomienda usar el modelo mini para subagentes?
Los subagentes realizan tareas más simples; el modelo mini puede completarlas más rápido y al mismo tiempo ahorrar costos.
P: ¿Puedo usar mi propio modelo?
Sí, puedes usar cualquier modelo compatible con la API de Responses configurando model_providers.
P: ¿La selección del modelo afecta el costo?
Sí, los diferentes modelos tienen precios distintos. Consulta la página de precios para obtener más información.
Otras extensiones