Union-Find基礎
一、概念とその紹介
Union-Findはツリー型のデータ構造であり、いくつかの互いに素な集合の合併および検索問題を処理するために使用されます。
Union-Findの考え方は、1つの配列で森全体(parent)を表し、木のルートノードが集合を一意に識別します。ある要素の木のルートを見つけさえすれば、それがどの集合にあるかを特定できます。
二、適用説明
Union-FindはいくつかのN要素を持つ集合応用問題で使用されます。通常は開始時に各要素を単一要素の集合として構成し、次に一定の順序で同じグループに属する要素が存在する集合を合併し、その間に要素がどの集合にあるかを繰り返し検索します。このプロセスは一見複雑ではありませんが、データ量が非常に多い場合、他のデータ構造で記述すると、往々にして空間が大きすぎてコンピュータが耐えられず、短時間で結果を計算することもできないため、Union-Findしか使用できません。
三、Union-Findの基本データ表現
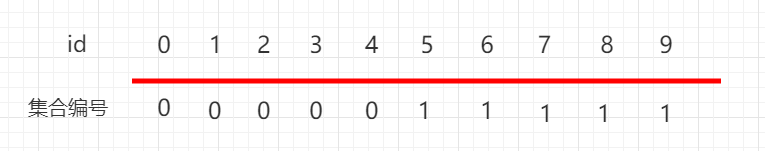

もう一度上図のように0、2、4、6、8以下はすべて0この集合は、0、2、4、6、8これら5つの要素は接続されており、1、3、5、7、9以下はすべて1この集合は、0,1、3、5、7、9これら5つの要素は連結されています。
クラスUnionFindを構築し、初期化します。各id[i]は自分自身を指し、合併されていない要素:
...
public UnionFind1(int n) {
count = n;
id = new int[n];
// 初期化、各id[i]は自分自身を指す、合併されていない要素
for (int i = 0; i < n; i++)
id[i] = i;
}
...
public UnionFind1(int n) {
count = n;
id = new int[n];
// 初期化、各id[i]は自分自身を指す、合併されていない要素
for (int i = 0; i < n; i++)
id[i] = i;
}
...
Java サンプルコード
ソースコードパッケージのダウンロード:Download
UnionFind.java ファイルコード:
package サンプル.union;
public class UnionFind{
private int[] id;
// データ数
private int count;
public UnionFind1(int n) {
count = n;
id = new int[n];
for (int i = 0; i < n; i++)
id[i] = i;
}
}
public class UnionFind{
private int[] id;
// データ数
private int count;
public UnionFind1(int n) {
count = n;
id = new int[n];
for (int i = 0; i < n; i++)
id[i] = i;
}
}