高度なグラフアルゴリズム
これまでの基礎チュートリアルでは、グラフの基本概念、表現方法、および幅優先探索(BFS)や深さ優先探索(DFS)などの基礎アルゴリズムを学びました。これらのアルゴリズムは、2点間が接続されているかどうか、グラフの走査などの問題を解決するのに役立ちました。
しかし、現実世界の多くの複雑な問題、例えばソーシャルネットワークの友達推薦、地図ナビゲーションの最短経路計画、物流配送の最適ルート手配、さらにはインターネットのWebページランキングなどは、より強力で効率的なアルゴリズムを必要とします。これらこそが高度なグラフアルゴリズムが解決すべき課題です。
高度なグラフアルゴリズムは、特定の複雑な問題を解決するために設計された専門ツールのようなものです:
- ネットワークフロー:交通、物流などの流量配分問題を解決します
- 二部グラフマッチング:タスク割り当て、結婚マッチングなどのペアリング問題を解決します
- 強連結成分:グラフの連結構造を分析します
- トポロジカルソート:依存関係の問題を解決します
実生活の例:
- ネットワークフロー:都市交通システムの流量最適化のようなもの
- 二部グラフマッチング:婚活マッチングシステムのようなもの
- 強連結成分:ソーシャルネットワークにおける友達グループ分析のようなもの
- トポロジカルソート:タスクの依存関係のソートのようなもの
| 問題の種類 | 通常のアルゴリズム | 高度なグラフアルゴリズム |
|---|---|---|
| 流量最適化 | モデル化と解決が難しい | ネットワークフローアルゴリズムが専門的に解決 |
| ペアリング問題 | 力任せ探索は効率が低い | 二部グラフマッチングが効率的に解決 |
| 連結性分析 | 基本的なDFS/BFSでは情報が限られている | 強連結成分が深い分析を提供 |
| 依存関係のソート | 複雑な依存関係の処理が難しい | トポロジカルソートが完璧に解決 |
最短経路問題とダイクストラ法
想像してみてください。地図アプリを使って自宅から会社までのルートを計画しているとします。地図上には無数の経路があり、各経路の所要時間(重み)は異なります。あなたの目標は、合計所要時間が最短の経路を見つけることです。これが古典的な単一始点最短経路問題。
アルゴリズムの核となる考え方
ダイクストラ法は解決する非負の重みを持つグラフにおける単一始点最短経路問題の貪欲アルゴリズムです。その核となる考え方は、慎重な探検家のようなものです:
- 「既知の最短距離」の集合を維持します。
- 毎回「未知の領域」から、現在始点から最も距離が短いノードを選び、その最短距離を確定します。
- そして、この新たに確定したノードを使って、そのすべての隣接ノードの「推定最短距離」を更新します。
- すべてのノードの最短距離が確定するまで、このプロセスを繰り返します。
アルゴリズムの手順の詳細
フローチャートを通して、ダイクストラ法の実行プロセスを直感的に理解しましょう:
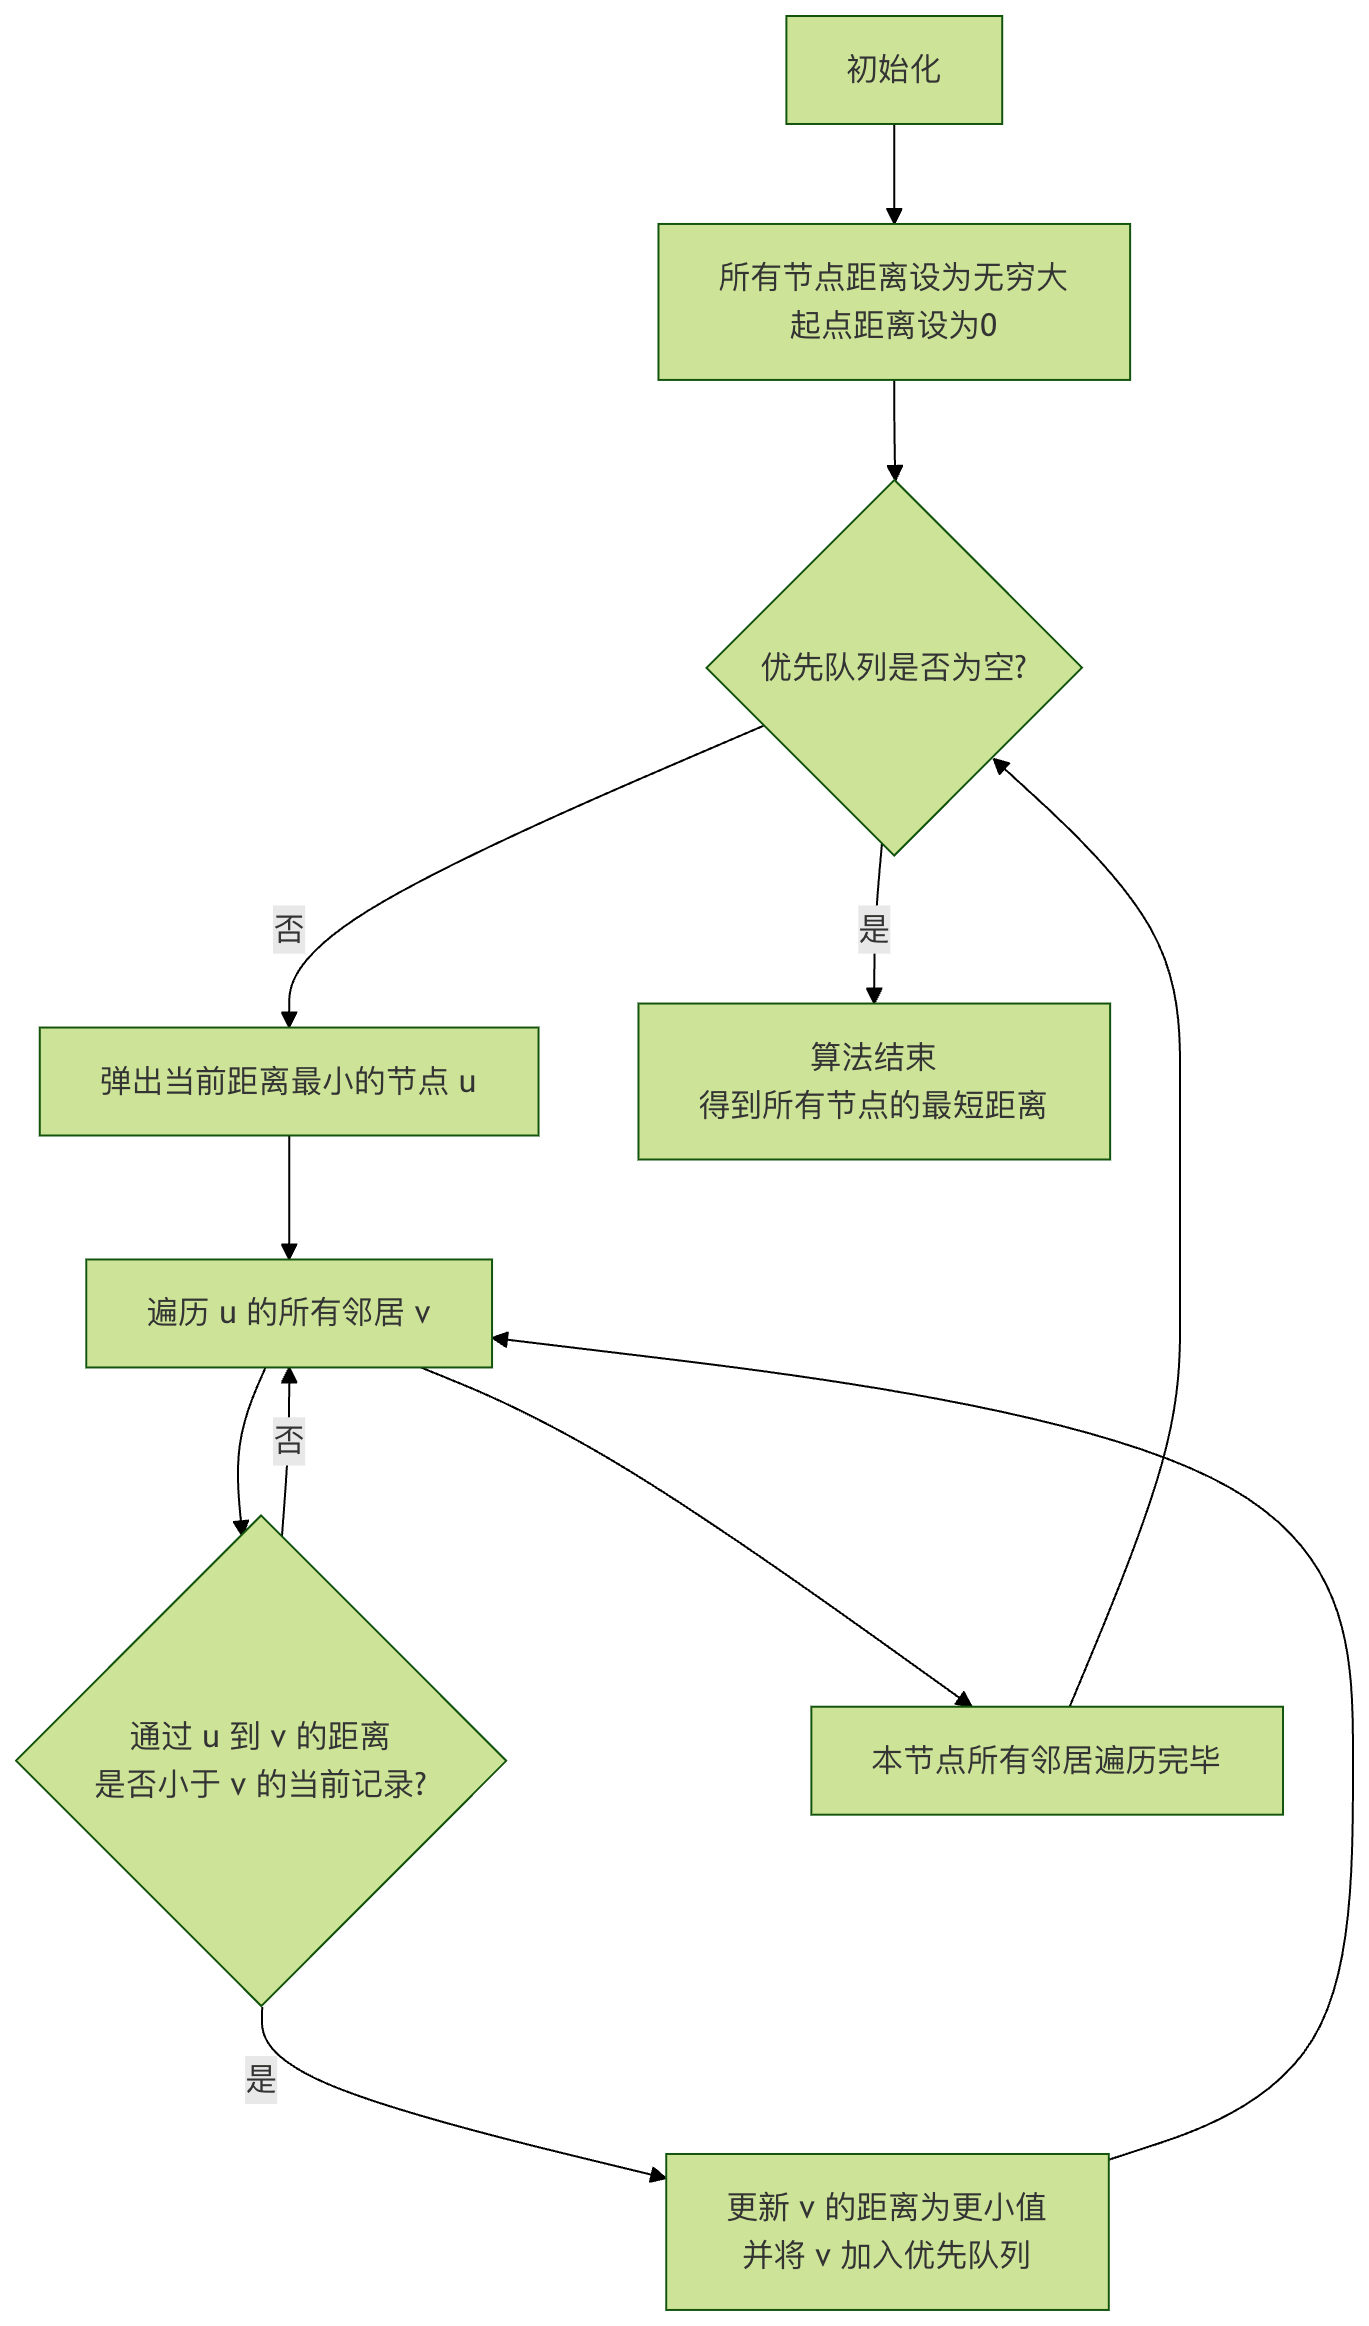
フローチャートの説明:アルゴリズムは初期化から始まり、優先度付きキューから現在始点に最も近い未処理ノードを取り出し続け、それを使って隣接ノードの距離推定値を緩和(更新)します。キューが空になるまで繰り返し、その時点で全ての最短経路が確定します。
コード実装と例
以下では、Pythonを使用してダイクストラ法を実装します。使用するのはheapqこの優先度付きキュー(最小ヒープ)モジュールで、現在距離が最小のノードを効率的に取得します。
例
def dijkstra(graph, start):
"""
ダイクストラ法を使用して、始点startからグラフ内の他のすべてのノードまでの最短距離を計算します。
パラメータ:
graph: 辞書で表現された隣接リスト。形式は {ノード: [(隣接1, 重み1), (隣接2, 重み2), ...]}
start: 開始ノード。
戻り値:
すべてのノードから始点までの最短距離を含む辞書。
"""
# 初期化:すべてのノードの最短距離を無限大に設定
shortest_distances = {node: float('inf') for node in graph}
shortest_distances[start] = 0 # 始点から自身への距離は0
# 優先度付きキュー(最小ヒープ)を使用、要素は (現在の距離, ノード)
priority_queue = [(0, start)]
while priority_queue:
current_distance, current_node = heapq.heappop(priority_queue)
# 現在取り出した距離が記録されている距離より大きい場合、古いデータなのでスキップ
if current_distance > shortest_distances[current_node]:
continue
# 現在のノードのすべての隣接ノードを走査
for neighbor, weight in graph[current_node]:
distance = current_distance + weight
# より短い経路が見つかった場合、更新
if distance < shortest_distances[neighbor]:
shortest_distances[neighbor] = distance
heapq.heappush(priority_queue, (distance, neighbor))
return shortest_distances
# --- テスト例 ---
# 重み付き有向グラフを定義 (ノード: [(隣接, 重み), ...])
test_graph = {
'A': [('B', 4), ('C', 2)],
'B': [('C', 1), ('D', 5)],
'C': [('B', 1), ('D', 8), ('E', 10)],
'D': [('E', 2)],
'E': []
}
start_node = 'A'
distances = dijkstra(test_graph, start_node)
print(f"ノード {start_node} から各ノードへの最短距離:")
for node, dist in distances.items():
print(f" ノード {node} まで: {dist}")
コード解説:
shortest_distances辞書は、始点から各ノードまでの最終確定された最短距離を記録するために使用され、初期値は無限大です。priority_queueは最小ヒープであり、「現在始点からの推定距離が最も近い」ノードを常に素早く取り出すことができます。- メインループでは、
heapq.heappopヒープの先頭ノード(現在最も近いノード)を取り出します。 if current_distance > ... : continueは重要な最適化であり、ヒープ内に存在し得る同一ノードの複数の古いバージョン(距離値)を処理します。- 隣接ノードを走査するとき、計算するのは
distance = current_distance + weight、これは「現在のノードを経由して隣接ノードに到達する新しい距離」です。 - 新しい距離がより短い場合、更新し
shortest_distances并隣接ノードとその新しい距離をヒープにプッシュします、後続の処理に備えます。
上記のコードを実行すると、以下のような出力が得られます:
从节点 A 出发到各节点的最短距离:
  到节点 A: 0
  到节点 B: 3  # 路径: A -> C -> B
  到节点 C: 2  # 路径: A -> C
  到节点 D: 8  # 路径: A -> C -> B -> D
  到节点 E: 10 # 路径: A -> C -> B -> D -> E
最小全域木とプリム法
ここで別の問題を考えてみましょう。新しく建設された住宅地に光ファイバーネットワークを敷設する必要があり、すべての家を接続する必要がありますが、コストを抑えるため、使用する光ファイバーの全長を最短にしたいとします。各2軒の家の間に光ファイバーを敷設するコスト(重み)は既知です。どの回線を敷設するかを選択すればよいでしょうか?
この問題は、私たちにすべてのノードを接続する部分グラフを見つけることを要求します。この部分グラフは木(無サイクル)であり、そのすべての辺の重みの合計が最小である必要があります。この木は最小全域木(MST)。
プリム法の考え方
プリム法はMSTを見つけるための貪欲アルゴリズムです。そのプロセスは「木を育てる」ようなものです:
- 任意のノードから始め、そのノードのみを含むように木を初期化します。
- すべてのこの木の内部ノードと外部ノードを接続する辺の中から、重みが最小の辺を1つ選びます。
- この辺と、それによって接続される外部ノードを木に追加します。
- すべてのノードが木に含まれるまで、手順2と3を繰り返します。
コード実装と例
プリム法の実装はダイクストラ法と非常に似ていますが、距離の定義が異なります。
プリム法では、各ノードから現在の全域木への最小接続コストを維持します。
例
def prim_mst(graph):
"""
プリム法を使用して、グラフの最小全域木(MST)の総重みを計算します。
パラメータ:
graph: 辞書で表現された隣接リスト。形式は {ノード: [(隣接1, 重み1), (隣接2, 重み2), ...]}
グラフは連結であると仮定します。
戻り値:
最小全域木の総重み。
"""
start_node = list(graph.keys())[0] # 任意のノードから開始、ここでは最初のノードを取得
visited = set([start_node]) # MSTに追加済みのノード集合
# 優先度付きキュー、(辺の重み, 隣接ノード)を格納
# 初期化:開始ノードのすべての辺をキューに追加
edges = [(weight, start_node, neighbor) for neighbor, weight in graph[start_node]]
heapq.heapify(edges)
total_weight = 0
while edges:
weight, from_node, to_node = heapq.heappop(edges)
if to_node not in visited:
visited.add(to_node) # 新しいノードをMSTに追加
total_weight += weight # MSTの総重みを累積
print(f"辺を追加: {from_node} - {to_node}, 重み: {weight}") # 選択した辺を出力
# 新しいノードの外部ノードに接続するすべての辺をキューに追加
for neighbor, w in graph[to_node]:
if neighbor not in visited:
heapq.heappush(edges, (w, to_node, neighbor))
return total_weight
# --- テスト例 ---
# 無向重み付きグラフを定義する(各辺は隣接リストに2回現れる)
test_graph_undirected = {
'A': [('B', 4), ('C', 2)],
'B': [('A', 4), ('C', 1), ('D', 5)],
'C': [('A', 2), ('B', 1), ('D', 8), ('E', 10)],
'D': [('B', 5), ('C', 8), ('E', 2)],
'E': [('C', 10), ('D', 2)]
}
print("最小全域木を構築する過程:")
mst_weight = prim_mst(test_graph_undirected)
print(f"\n"最小全域木の総重み: {mst_weight}")
コード解説:
visited集合は、すでに MST に属するノードを記録する。edgesは最小ヒープであり、すべてのMST の内外にまたがる辺(すなわち、一方の端点がvisited中にあり、もう一方の端点が中にない)を格納する。- メインループでは、常にヒープから重みが最小の辺を取り出す
(weight, from_node, to_node)。 - この辺が接続する
to_nodeがまだ訪問されていなければ、それは有効な MST 辺である。それを結果に追加し、更新するvisitedとtotal_weight。 - 新しいノード
to_nodeの外部ノードへ通じるすべての辺をヒープに追加し、次のラウンドの選択に備える。
上記のコードを実行すると、MST の構築過程がわかる:
构建最小生成树的过程:
添加边: A - C, 权重: 2
添加边: C - B, 权重: 1
添加边: A - B, 权重: 4  # 注意:这条边连接B和A,但B已在树中,所以会被下一行的if语句跳过,不会添加。
添加边: B - D, 权重: 5
添加边: D - E, 权重: 2

最小生成树的总权重为: 10
(注:実際の出力では、A - B という辺は、to_nodeB がすでにvisited中にあるため、実行されないprint文。上記のコメントは説明のためのものである。)最終的な MST の辺は A-C, C-B, B-D, D-E で、総重みは 2+1+5+2=10 である。
トポロジカルソート:依存関係のあるタスクを処理する
一連のタスクを計画するとき、特定のタスクは他のタスクが完了するまで開始できない場合(例:靴下を履くのは靴を履く前でなければならない)、どのように合理的な実行順序を決めればよいだろうか?このタスク間の依存関係は、有向非巡回グラフ(DAG)で表すことができ、実行可能な線形の実行順序を見つけるプロセスが、トポロジカルソートである。
カーン法(入次数に基づく)
Kahn のアルゴリズムは、トポロジカルソートの最も直感的なアルゴリズムの1つであり、入度(そのノードを指す辺の数)に基づく。
- 入度が 0 のノードをすべて見つける。それらはすぐに実行できるタスク(前置依存関係がない)である。
- これらのノードをキューに入れ、グラフから「削除」する(ソート結果に出力する)。
- 「削除」した後、そのすべての隣接ノードの入度を更新する(1減らす)。ある隣接ノードの入度がこれにより 0 になったら、そのノードをキューに追加する。
- キューが空になるまで手順 2 と 3 を繰り返す。
- 出力されたノード数がグラフの総ノード数と等しければソートは成功;そうでなければ、グラフに循環が存在し、トポロジカルソートは不可能である。
コード実装と例
例
def topological_sort_kahn(graph):
"""
Kahn のアルゴリズムを使用してトポロジカルソートを行う。
パラメータ:
graph: 辞書で表された隣接リスト。形式は {ノード: [隣接ノード1, 隣接ノード2, ...]}
戻り値:
トポロジカルソートが存在する場合はリスト(ソート順)を返す;存在しない場合は None を返す(循環が存在する)。
"""
# 1. すべてのノードの入度を計算する
in_degree = {node: 0 for node in graph}
for node in graph:
for neighbor in graph[node]:
in_degree[neighbor] = in_degree.get(neighbor, 0) + 1
# 2. キューを初期化し、入度が0のノードをすべてエンキューする
queue = deque([node for node in in_degree if in_degree[node] == 0])
topo_order = []
# 3. キューを処理する
while queue:
current_node = queue.popleft()
topo_order.append(current_node)
# 現在のノードを「削除」し、その隣接ノードの入度を更新する
for neighbor in graph.get(current_node, []):
in_degree[neighbor] -= 1
if in_degree[neighbor] == 0:
queue.append(neighbor)
# 4. すべてのノードがソートされたか確認する
if len(topo_order) == len(graph):
return topo_order
else:
return None # グラフに循環が存在する
# --- テスト例 ---
# コースの依存関係を表す有向グラフを定義する
# 例:アルゴリズム(Algo)の授業を受ける前に、データ構造(DS)の授業を受ける必要がある
course_graph = {
'プログラミング': ['データ構造', 'アルゴリズム'],
'データ構造': ['アルゴリズム', 'データベース'],
'アルゴリズム': ['機械学習'],
'データベース': ['システム設計'],
'数学': ['機械学習'],
'機械学習': [],
'システム設計': []
}
print("コース依存関係グラフ:")
for course, deps in course_graph.items():
print(f" {course} -> {deps}")
result = topological_sort_kahn(course_graph)
if result:
print(f"\n"実行可能なコースの学習順序(トポロジカルソート)は次のとおり:")
print(" -> ".join(result))
else:
print("\n"コース計画に循環依存が存在するため、ソートできません!")
コードの行ごとの解説:
in_degree辞書は各ノードの入度を記録する。隣接リストを走査することで、各ノードが何本の辺に指されているかを計算できる。- キューを初期化する
queue、すべての「前置タスクがない」(入度が0)ノードを追加する。 - メインループでは、キューからノードを取り出し、結果リストに追加する
topo_order。これはそのタスクを完了したことに相当する。 - そのタスクのすべての後続タスク(隣接ノード)を走査し、その入度を1減らす。0になった場合、そのタスクのすべての前置タスクが完了したことを意味するので、キューに追加して実行を待つことができる。
- 最後にソート結果の長さを確認する。グラフのノード数と等しければ成功;そうでなければ、一部のノードが常に前置依存関係を持つ(入度が0でない)ことを意味し、すなわちグラフに循環が存在する。
上記のコードを実行すると、実行可能な学習順序が得られる:
コース依存関係図:
  プログラミング -> ['データ構造', 'アルゴリズム']
  データ構造 -> ['アルゴリズム', 'データベース']
  アルゴリズム -> ['機械学習']
  データベース -> ['システム設計']
  数学 -> ['機械学習']
  機械学習 -> []
  システム設計 -> []

実行可能なコース学習順序(トポロジカルソート):
プログラミング -> 数学 -> データ構造 -> アルゴリズム -> データベース -> 機械学習 -> システム設計
注意:トポロジカルソートの結果は一意とは限らない。例えば、数学とプログラミングはどちらも入度が 0 の開始ノードなので、どちらが先でもよい。
アルゴリズムの比較と応用シーン
これらのアルゴリズムをよりよく理解し選択するために、以下の表にそれらの重要な特徴をまとめた:
| アルゴリズム | 主な用途 | 適用可能なグラフの種類 | 核心的な考え方 | 時間計算量(優先度付きキュー使用時) | 典型的な適用シナリオ |
|---|---|---|---|---|---|
| Dijkstra | 単一始点最短経路 | 非負の重みを持つ有向/無向グラフ | 貪欲法。毎回、現在始点から最も近いノードを拡張する | O((V+E) log V) | 地図ナビゲーション、ネットワークルーティング |
| Prim | 最小全域木(MST) | 重み付きの連結無向グラフ | 貪欲法。毎回、現在の全域木から最も近いノードを組み込む | O((V+E) log V) | ネットワーク配線、回路基板設計、クラスタリング分析 |
| Kahn(トポロジカルソート) | タスクスケジューリングの順序付け | 有向非巡回グラフ(DAG) | 入度に基づき、前置依存関係のないノードを継続的に削除する | O(V+E) | コース設定、ビルドシステムの依存関係、コンパイル順序 |
実践演習
見るだけでは不十分です。実際に手を動かしてこそ理解が深まります!以下の演習を試してみてください。
演習1:ダイクストラ法の修正
以下のコードは Dijkstra アルゴリズムを実装しようとしていますが、いくつかバグがあります。それらを見つけて修正してください。
例
def wrong_dijkstra(graph, start):
dist = {node: float('inf') for node in graph}
dist[start] = 0
pq = [(0, start)]
while pq:
cur_dist, cur_node = pq.pop(0) # ここに問題がある可能性がある
for neighbor, weight in graph[cur_node]:
if cur_dist + weight < dist[neighbor]:
dist[neighbor] = cur_dist + weight
# ここに何かが不足している可能性がある
return dist
演習2:クラスカル法の実装
Prim アルゴリズムは MST を見つける1つの方法です。もう1つの古典的な方法は、Kruskal アルゴリズム。その考え方は次のとおりです:
- グラフ内のすべての辺を重みの小さい順にソートする。
- 各辺を順に検討し、この辺が接続する2つのノードが同じ連結成分にない場合(つまり、追加しても循環が形成されない場合)、その辺を MST に追加する。
- MST に V-1 本の辺(V はノード数)が含まれるまで、手順2を繰り返す。
あなたのタスク:2つのノードが連結しているかを効率的に判定するために、「Union-Find(Disjoint Set Union, DSU)」データ構造を使って Kruskal アルゴリズムを実装してみましょう。
演習3:実データチャレンジ
あなたは次のものを持っていると仮定します:friendships.jsonファイルがあり、ソーシャルネットワーク内のユーザー(IDで表記)とその友達関係が記録されている。各関係には「親密度」の重みがある。
[
  {"user_id": 1, "friend_id": 2, "closeness": 5},
  {"user_id": 1, "friend_id": 3, "closeness": 2},
  {"user_id": 2, "friend_id": 3, "closeness": 1},
  {"user_id": 2, "friend_id": 4, "closeness": 6},
  {"user_id": 3, "friend_id": 4, "closeness": 3},
  {"user_id": 4, "friend_id": 5, "closeness": 4}
]
問題:もし「親密度」の重みを距離(値が小さいほど親密)とみなせる場合、ユーザー1から出発して、他のすべてのユーザーへの「最も親密な経路」(つまり重みの和が最小の経路)を計算してください。どのアルゴリズムを使うべきでしょうか?コードを書いて解決してください。