貪欲アルゴリズム
貪欲アルゴリズム(英語: greedy algorithm)は、貪欲法とも呼ばれ、各ステップの選択において現在の状態で最良または最適(つまり最も有利)な選択を行い、それによって結果が全体として最良または最適になることを期待するアルゴリズム戦略です。
貪欲アルゴリズムよく言う「目先の利益しか考えない」ようなもので、全体の最適性は考慮せず、行う選択はあくまである意味での局所最適解にすぎません。
想像してみてください。目の前にさまざまな額面の硬貨(たとえば1元、5角、1角)があり、最小限の枚数の硬貨で1.8元を用意する必要があります。
ごく自然な考え方は次のとおりです:毎回、まず額面が最も大きい硬貨を取る。
まず1元を取り、残り0.8元。次に5角を取り、残り0.3元。最後に1角を3枚取ります。
この一連のプロセスで、私たちは各ステップで現在最善と思われる選択を行い、これが貪欲アルゴリズムの核心的な考え方です。
貪欲アルゴリズムまるで、目先しか見えないが決断力のある人のようです:
- 各ステップの選択:現在の状態で最も良さそうな選択を行う
- 全体を考慮しない:その選択が将来に与える影響を考慮しない
- 期待される結果:局所最適な選択が全体最適解につながることを期待する
現実の例:
- お釣り:常に最大額面の硬貨を先に使う
- 山登り:常に最も急な方向へ進む
- 買い物:常に現在最もお得な商品を買う
- 経路選択:常に現在最短の経路を選ぶ
貪欲アルゴリズムの特徴
- 貪欲選択性:各ステップの最適解は、それまでの各ステップの局所最適解から導出できます。後の選択が前の選択に影響することはありません。
- 最適部分構造:ある問題の最適解は、その部分問題の最適解を含みます。これは動的計画法も持つ性質ですが、貪欲アルゴリズムは各ステップで「貪欲に」部分問題の最適解を選択します。
| 特徴 | 説明 | 利点 | 欠点 |
|---|---|---|---|
| 局所最適 | 各ステップで現在の最適解を選択する | シンプルで直感的 | 全体最適でない可能性がある |
| 取り消し不可 | 選択後に後戻りできない | 意思決定が速い | 局所最適に陥りやすい |
| 高効率性 | 通常、時間計算量が低い | 実用性が高い | 適用範囲が限られる |
| 実装が簡単 | ロジックが明確で分かりやすい | コーディングしやすい | 正当性の証明が必要 |
動的計画法との違い
これは初心者が混同しやすいポイントです。表で比較してみましょう。
| 特性 | 貪欲アルゴリズム | 動的計画法 |
|---|---|---|
| 判断基準 | 各ステップで現在の最適な選択を行い、後戻り不可。 | 各ステップの選択は部分問題の解に依存し、中間結果を保存して複数の選択肢を比較できます。 |
| 最適解の保証 | 必ずしも全体最適解を得られるとは限りません。問題自体が貪欲選択性を持つ必要があります。 | 通常、全体最適解を得られます。 |
| 効率 | 高効率で、通常は時間計算量が低い。 | 比較的低い。重複する部分問題を解く必要があるため。 |
| 適用場面 | 問題が貪欲選択性と最適部分構造を持つ場合。例:Huffman符号化、最小全域木。 | 問題が最適部分構造と重複する部分問題を持つ場合。例:ナップサック問題、最短経路。 |
簡単に言うと、動的計画法は「謀定而后動(考えてから動く)」で、長期的な利益のために目先を犠牲にします。一方、貪欲アルゴリズムは「今朝有酒今朝醉(その日暮らし)」で、目先の利益だけを追求します。
貪欲アルゴリズムの基本フレームワーク
貪欲アルゴリズムには固定のコードテンプレートはありませんが、その考え方は次のステップにまとめられます。
- 数学モデルを構築する:実際の問題を数学の問題として抽象化する。
- 貪欲戦略を定義する:各ステップで「最適解」を選択する基準を決める。これはアルゴリズムの核心であり難所です。
- 貪欲戦略を証明する:定義した貪欲戦略が全体最適解をもたらすことを証明する(任意ですが重要です。アルゴリズム問題では、通常その正当性を理解する必要があります)。
- 反復して解を求める:戦略に従って初期状態から一歩ずつ貪欲な選択を行い、問題の解が得られるまで続けます。
一般的な擬似コードのフレームワークは次のとおりです:
例
# 1. 初期化:ソート、結果用コンテナの作成などを含む場合がある
solution = []
# 2. すべての選択肢を走査する。通常は何らかのルールで事前にソートしておく
for item in sorted(problem.items, key=貪欲戦略のルール):
# 3. 貪欲な選択:現在の選択が条件を満たすなら採用する
if is_feasible(solution, item):
solution.append(item)
# 4. 最終的に構築された解を返す
return solution
古典的な問題とコード例
いくつかの古典的な問題を通して、貪欲アルゴリズムの応用を具体的に実感しましょう。各問題について、1)問題と貪欲戦略の分析、2)完全なコードの提供、3)行ごとの解説を行います。
例1:釣り銭問題(Coin Change)
問題説明:硬貨体系が [100, 50, 20, 10, 5, 1](単位:分)であるとし、お釣りamount分を用意するのに使う硬貨の最小枚数を求めます。
貪欲戦略:毎回、残り金額以下の額面の最大硬貨を選ぶ。人民元の硬貨体系では、この戦略は有効です。
コード実装:
例
"""
貪欲アルゴリズムを使って釣り銭問題を解く(特定の硬貨体系向け)
:param coins: list[int]、硬貨の額面リスト。降順に並んでいる必要があります
:param amount: int、お釣りとして必要な合計金額
:return: list[int]、使用する硬貨の額面リスト
"""
coins.sort(reverse=True) # 硬貨を額面の大きい順にソートしておく
result = [] # お釣りの硬貨を格納する変数
remaining = amount # 残りのお釣り金額
for coin in coins:
# 現在の硬貨の額面が残り金額以下の場合、できるだけ多く使う
while remaining >= coin:
result.append(coin)
remaining -= coin # 残り金額から現在の硬貨の額面を差し引く
# ちょうどお釣りを渡せるか確認する
if remaining == 0:
return result
else:
# ちょうどお釣りを渡せない場合の処理(この硬貨体系では発生しないが)
return None
# テストデータ
test_coins = [100, 50, 20, 10, 5, 1]
test_amount = 186 # 1元8角6分
change = coin_change_greedy(test_coins, test_amount)
print(f"お釣り {test_amount} 分、必要な硬貨:{change}")
print(f"硬貨の枚数:{len(change)} 枚")
# 出力:お釣り 186 分、必要な硬貨:[100, 50, 20, 10, 5, 1]
# 硬貨の枚数:6 枚
コード解説:
- 8行目:
coins.sort(reverse=True)貪欲戦略の重要な準備であり、常に大きな額面の硬貨を先に考慮できるようにします。 - 12〜15行目:
whileループにより、現在の額面の硬貨を使える限り使い続け、「できるだけ多く」という貪欲な選択を実現します。 - 18〜22行目:最終結果をチェックし、金額がちょうど一致することを確認します。
重要な注意点:貪欲アルゴリズムによる釣り銭問題の解決は常に最適解を得られるとは限りません!例えば、硬貨体系が [25, 20, 10, 5, 1] の場合に40分を用意するとします。貪欲法では25+10+5(3枚)を選びますが、最適解は20+20(2枚)です。特定の通貨体系(人民元など)でのみ貪欲戦略は有効です。
例2:区間スケジューリング問題(Interval Scheduling)
問題説明}]"
貪欲戦略:毎回、終了時刻が最も早い会議を選ぶ。そうすることで、後により多くの時間を残せる。
コード実装:
例
"""
最大非交差区間問題(区間スケジューリング)を解く
:param intervals: list of [start, end], 区間リスト
:return: list of [start, end], 選択された区間リスト
"""
# 1. 終了時刻の昇順でソートする
intervals_sorted = sorted(intervals, key=lambda x: x[1])
selected = [] # 選択された区間を格納する
last_end_time = -float('inf') # 直前に選択した区間の終了時刻を初期化する
for interval in intervals_sorted:
start, end = interval
# 2. 貪欲選択:現在の区間の開始時刻が直前に選択した区間の終了時刻より早くなければ、それを選択する
if start >= last_end_time:
selected.append(interval)
last_end_time = end # 最後の終了時刻を更新する
return selected
# テストデータ:各サブリストが1つの会議を表す [開始時刻, 終了時刻]
test_intervals = [
[1, 3], [2, 4], [3, 5], [4, 6], [5, 7],
[1, 2], [2, 3], [1, 4]
]
result = interval_scheduling(test_intervals)
print(最大で開催できる会議(終了時刻でソート後):)
for meeting in result:
print(f" 会議 [{meeting)
print(f"合計 {len(result)} 件の会議")
# 可能な出力の一例(ソート後の順序は異なる場合があるが、数は最適):
# 会議 [1, 2]
# 会議 [2, 3]
# 会議 [3, 5] または [4, 6] など
# 合計 4 件の会議
コード解析:
- 10行目:
sorted(intervals, key=lambda x: x[1])貪欲戦略を実現する中核であり、終了時刻でソートする。 - 16〜19行目:
if start >= last_end_time現在の会議が選択済みの会議と重ならないことを確認する実現可能性チェックである。 - このアルゴリズムの時間計算量は O(n log n) であり、主にソートに由来する。
例3:ハフマン符号化(Huffman Coding) - 概念と簡易実装
ハフマン符号化は、可逆データ圧縮に用いられる貪欲アルゴリズムである。その中心的な考え方は:出現頻度の高い文字には短い符号を割り当て、出現頻度の低い文字には長い符号を割り当てる。
貪欲戦略:頻度が最小の2つのノードを繰り返し結合して、二分木を構築する。
完全な実装は長いため、ここでは中核となる貪欲な結合プロセスを示す:
例
class Node:
"""ハフマン木のノードクラス"""
def __init__(self, char, freq):
self.char = char # 文字(葉ノードのみ)
self.freq = freq # 頻度
self.left = None
self.right = None
# ヒープ内で比較できるように比較メソッドを定義する
def __lt__(self, other):
return self.freq < other.freq
def build_huffman_tree(char_freq):
"""
ハフマン木を構築する
:param char_freq: dict, 文字とその頻度、例:{'a': 5, 'b': 9, 'c': 12, 'd': 13, 'e': 16, 'f': 45}
:return: Node, ハフマン木のルートノード
"""
# 1. 初期化:各文字に対して葉ノードを作成し、最小ヒープ(優先度付きキュー)に入れる
heap = [Node(char, freq) for char, freq in char_freq.items()]
heapq.heapify(heap) # リストを最小ヒープに変換する
# 2. 貪欲な結合:ヒープ内にノードが複数ある間
while len(heap) > 1:
# 頻度が最小の2つのノードを取り出す
left = heapq.heappop(heap)
right = heapq.heappop(heap)
# 子ノードの頻度の合計を頻度とする新しい内部ノードを作成する
merged = Node(None, left.freq + right.freq)
merged.left = left
merged.right = right
# 新しいノードをヒープに戻す
heapq.heappush(heap, merged)
# ヒープに残った最後のノードがハフマン木のルートノードである
return heap[0] if heap else None
# テストデータ
test_freq = {'a': 5, 'b': 9, 'c': 12, 'd': 13, 'e': 16, 'f': 45}
root = build_huffman_tree(test_freq)
print(ハフマン木の構築完了!ルートノードの頻度 =, root.freq if root else 0)
# 出力:ハフマン木の構築完了!ルートノードの頻度 = 100
アルゴリズムの可視化:次の図は、上記のテストデータを使ってハフマン木を構築する最初の数ステップの結合プロセスを示している:
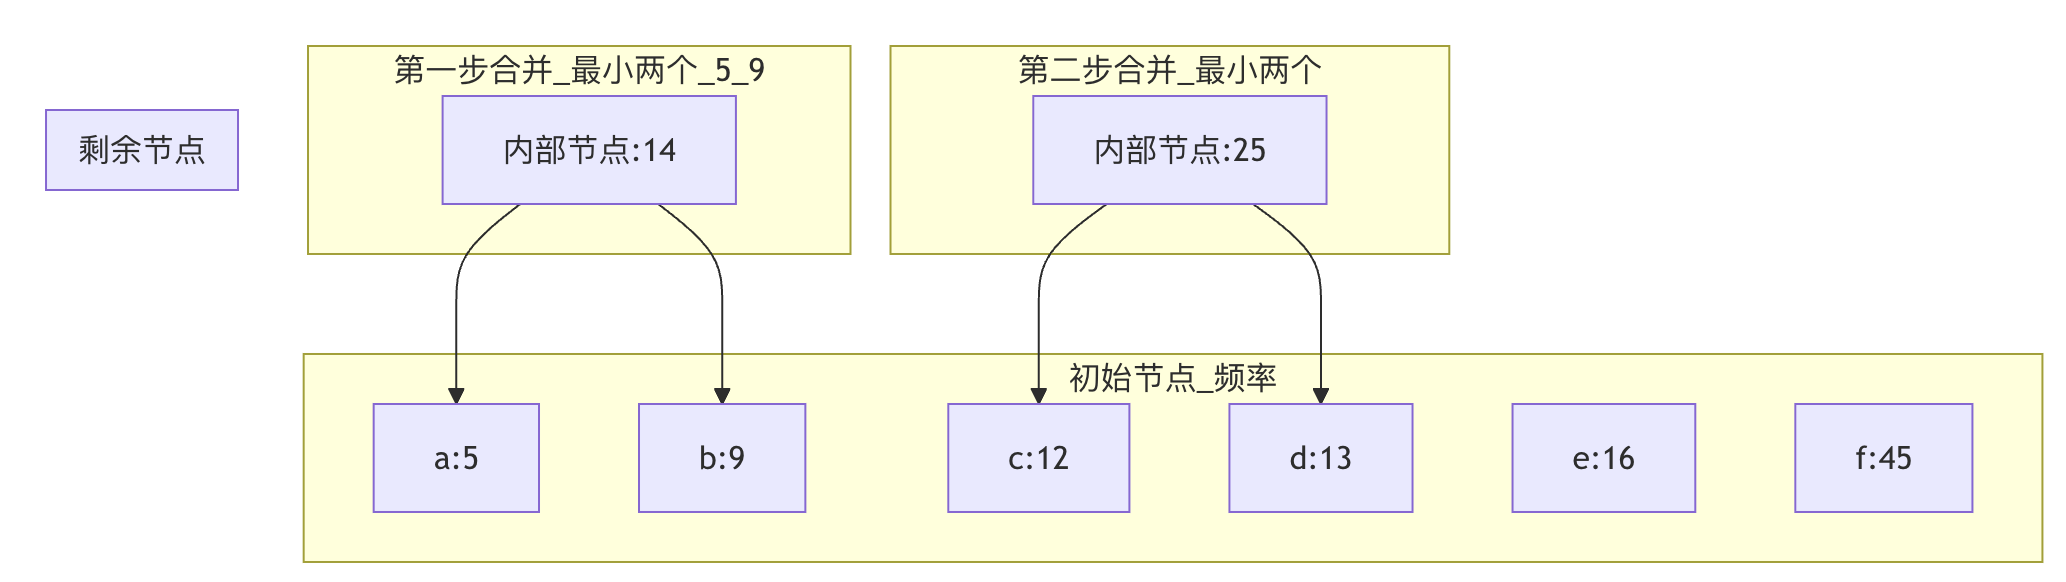
図解の説明:アルゴリズムは常に、利用可能なすべてのノード(最初は葉ノード、その後は内部ノードも含む)から頻度が最小の2つを選んで結合し、新しい内部ノードを生成する。このプロセスを完全な二分木が形成されるまで繰り返す。この木の葉ノードは元の文字に対応し、根から葉への経路(左の分岐を0、右の分岐を1とする)がその文字のハフマン符号となる。
貪欲アルゴリズムの正当性の証明
ある問題が貪欲アルゴリズムで解けるかどうかを判断するにはどうすればよいか?通常、次の2点を証明する必要がある:
- 貪欲選択性:数学的帰納法または背理法によって、最初のステップの最適な選択が何らかの大域的最適解に含まれることを証明できる。
- 最適部分構造:最初の貪欲な選択を行った後、元の問題がより小規模な同種の部分問題に簡約されることを証明する。。
以 区間スケジューリング問題を例にした証明の考え方:
- 貪欲選択:すべての区間の中で終了時刻が最も早いものを I とする。
iこのとき、区間 I を含む最適解が存在する。i。- 証明:ある最適解が区間 I を含まないと仮定する。
iその最適解の最初の区間を J とする。j。なぜなら、iI が最も早く終了するので、I でiJ を置き換えても、j他の区間と衝突せず、解の大きさも変わらない。したがって、I をi含む解も最適解である。
- 証明:ある最適解が区間 I を含まないと仮定する。
- 最適部分構造:区間 I を選択
iした後、残りの問題は、すべての I とi重ならない区間の中から最適解を探すことである。これは元の問題の部分問題を構成する。
実践練習
では、貪欲アルゴリズムを使って以下の問題を解き、理解を定着させてみよう。
練習1:ジャンプゲーム
問題:非負整数の配列numsが与えられる。あなたは最初、配列の最初のインデックスにいる。配列の各要素は、その位置からジャンプできる最大の長さを表す。最後のインデックスに到達できるかどうかを判定せよ。例:nums = [2,3,1,1,4]、返すTrue(インデックス0から1歩でインデックス1へ、さらに3歩で最後のインデックスへ)。貪欲戦略のヒント:各ステップでどれだけ跳ぶかをシミュレートするのではなく、最遠到達可能位置。
練習2:クッキーの配分
問題:子どもたちのグループとクッキーの山がある。各子どもには食欲値g[i]があり、各クッキーにはサイズs[j]がある。クッキーのサイズが子どもの食欲以上のときだけ、その子どもは満足できる。最大で何人の子どもを満足させられるかを求めよ。例:g = [1,2,3], s = [1,1]、出力1。
貪欲戦略のヒント:より多くの子どもを満足させるためには、最小のクッキーで最も食欲の小さい子どもを満足させるべきである(または逆に考える)。
練習3:株式売買の最適なタイミング II
問題:配列pricesが与えられる。ここでprices[i]は、与えられた株式の第i日目の価格である。あなたは無限回の取引(つまり株式の売買)を行うことができるが、複数の取引を同時に行うことはできない(再度購入する前に以前の株式を売却しなければならない)。得られる最大の利益を計算せよ。例:prices = [7,1,5,3,6,4]、出力7(1で買って5で売ると利益4、3で買って6で売ると利益3、合計利益7)。貪欲戦略のヒント:利益は日ごとの差額に分解できる。今日の価格が昨日より高ければ、その差額を利益として計上する。