三路ソートアルゴリズム
三路ソートアルゴリズム(Three-Way Partitioning)は、大量の重複要素を含む配列を処理するために特化した、特殊なクイックソートの変種です。その核心的な考え方は、1回のパーティション処理で配列を従来の2つの部分ではなく、3つの部分に分割するというものです。
三路クイックソートは二路クイックソートをさらに改良したバージョンです。三路ソートアルゴリズムは、ソートするデータを3つの部分、すなわち v より小さい、v と等しい、v より大きい(v は基準値)に分けます。これにより、3つの部分のうち v と等しいデータは次の再帰でソートする必要がなくなり、v より小さいデータと v より大きいデータのどちらかが極端に多くなることもありません。この方法によって、三路クイックソートアルゴリズムの性能はより優れています。
想像してみてください。赤・白・青の3色が混ざった大量のビー玉が入ったバケツがあります。それらをすばやく分けて、赤いビー玉を左に、白を中央に、青を右に並べるのがあなたの仕事です。三路ソートアルゴリズムは、まさにこのような問題を解決する仕分けの達人です。
従来のクイックソート vs 三路クイックソート
2つの違いを比較するために、簡単な表を使いましょう:
| 特性 | 従来のクイックソート | 三路クイックソート |
|---|---|---|
| パーティション数 | 2つ(基準より小さい、基準より大きい) | 3つ(基準より小さい、基準と等しい、基準より大きい) |
| 重複要素の処理 | 効率が低く、重複要素が何度も比較・交換される可能性がある | 効率が非常に高く、重複要素がまとめて処理される |
| 時間計算量 | 平均 O(n log n)、最悪 O(n²) | 平均 O(n log n)、最悪 O(n²) |
| 空間計算量 | O(log n)(再帰スタック) | O(log n)(再帰スタック) |
| 適用シーン | 一般的なソート、要素の重複率が低い | 要素の重複率が高い場合、例:色ソート、成績の段階分け |
適用説明
時間・空間計算量はランダム化クイックソートと同じです。
三路クイックソートアルゴリズムは、三路パーティション戦略を用いて配列を分割します。大量の重複要素を含む配列の処理に非常に効果的で、クイックソートのプロセスを向上させます。パーティション要素の値と等しい要素を処理するロジックを追加し、パーティション要素と等しいすべての値を1か所に集めます。
プロセス図解

パーティションプロセスを3つのケースに分けて説明します。i は走査中の現在のインデックス位置を表します:
(1)現在処理中の要素 e=V の場合、要素 e はそのまま青の区間に含め、同時に i を1つ後ろに移動します。

(2)現在処理中の要素 e<v の場合、e と V と等しい区間の最初の位置の値を交換し、同時にインデックス lt と i の両方を1つ後ろに移動します。

(3)現在処理中の要素 e>v の場合、e と gt-1 インデックス位置の値を交換し、同時に gt インデックスを1つ前に移動します。

最後に、i=gtそのとき、走査を終了し、同時に v とインデックス lt が指す値を交換します。これでこのソートプロセスが完了します。その後、<V と >V の配列部分に対して同じ方法で再帰ソートを行います。
Java サンプルコード
ソースコードパッケージのダウンロード:Download
QuickSort3Ways.java ファイルコード:
/**
* 三路クイックソート
*/
public class QuickSort3Ways {
//核心コード---開始
// 再帰的にクイックソートを使用し、arr[l...r] の範囲をソートする
private static void sort(Comparable[] arr, int l, int r){
if (l >= r) {
return;
}
// ランダムに arr[l...r] の範囲から1つの値を基準点pivotとして選択する
swap( arr, l, (int)(Math.random()*(r-l+1)) + l );
Comparable v = arr[l];
int lt = l; // arr[l+1...lt] < v
int gt = r + 1; // arr[gt...r] > v
int i = l+1; // arr[lt+1...i) == v
while( i < gt ){
if( arr[i].compareTo(v) < 0 ){
swap( arr, i, lt+1);
i ++;
lt ++;
}
else if( arr[i].compareTo(v) > 0 ){
swap( arr, i, gt-1);
gt --;
}
else{ // arr[i] == v
i ++;
}
}
swap( arr, l, lt );
sort(arr, l, lt-1);
sort(arr, gt, r);
}
//核心コード---終了
public static void sort(Comparable[] arr){
int n = arr.length;
sort(arr, 0, n-1);
}
private static void swap(Object[] arr, int i, int j) {
Object t = arr[i];
arr[i] = arr[j];
arr[j] = t;
}
// QuickSort3Ways をテスト
public static void main(String[] args) {
// 三路クイックソートアルゴリズムも O(nlogn) 計算量のアルゴリズムである
// 100万オーダーのデータを1秒以内で簡単に処理できる
int N = 1000000;
Integer[] arr = SortTestHelper.generateRandomArray(N, 0, 100000);
sort(arr);
SortTestHelper.printArray(arr);
}
}
アルゴリズムの核心的な考え方と動作原理
三路ソートアルゴリズムの巧妙さは、3つのポインタを使って配列の異なる領域を追跡し、1回の走査で3つの分類を完了する点にあります。
アルゴリズムのパーティション状態
状態図を使ってアルゴリズムのパーティションプロセスを理解しましょう:
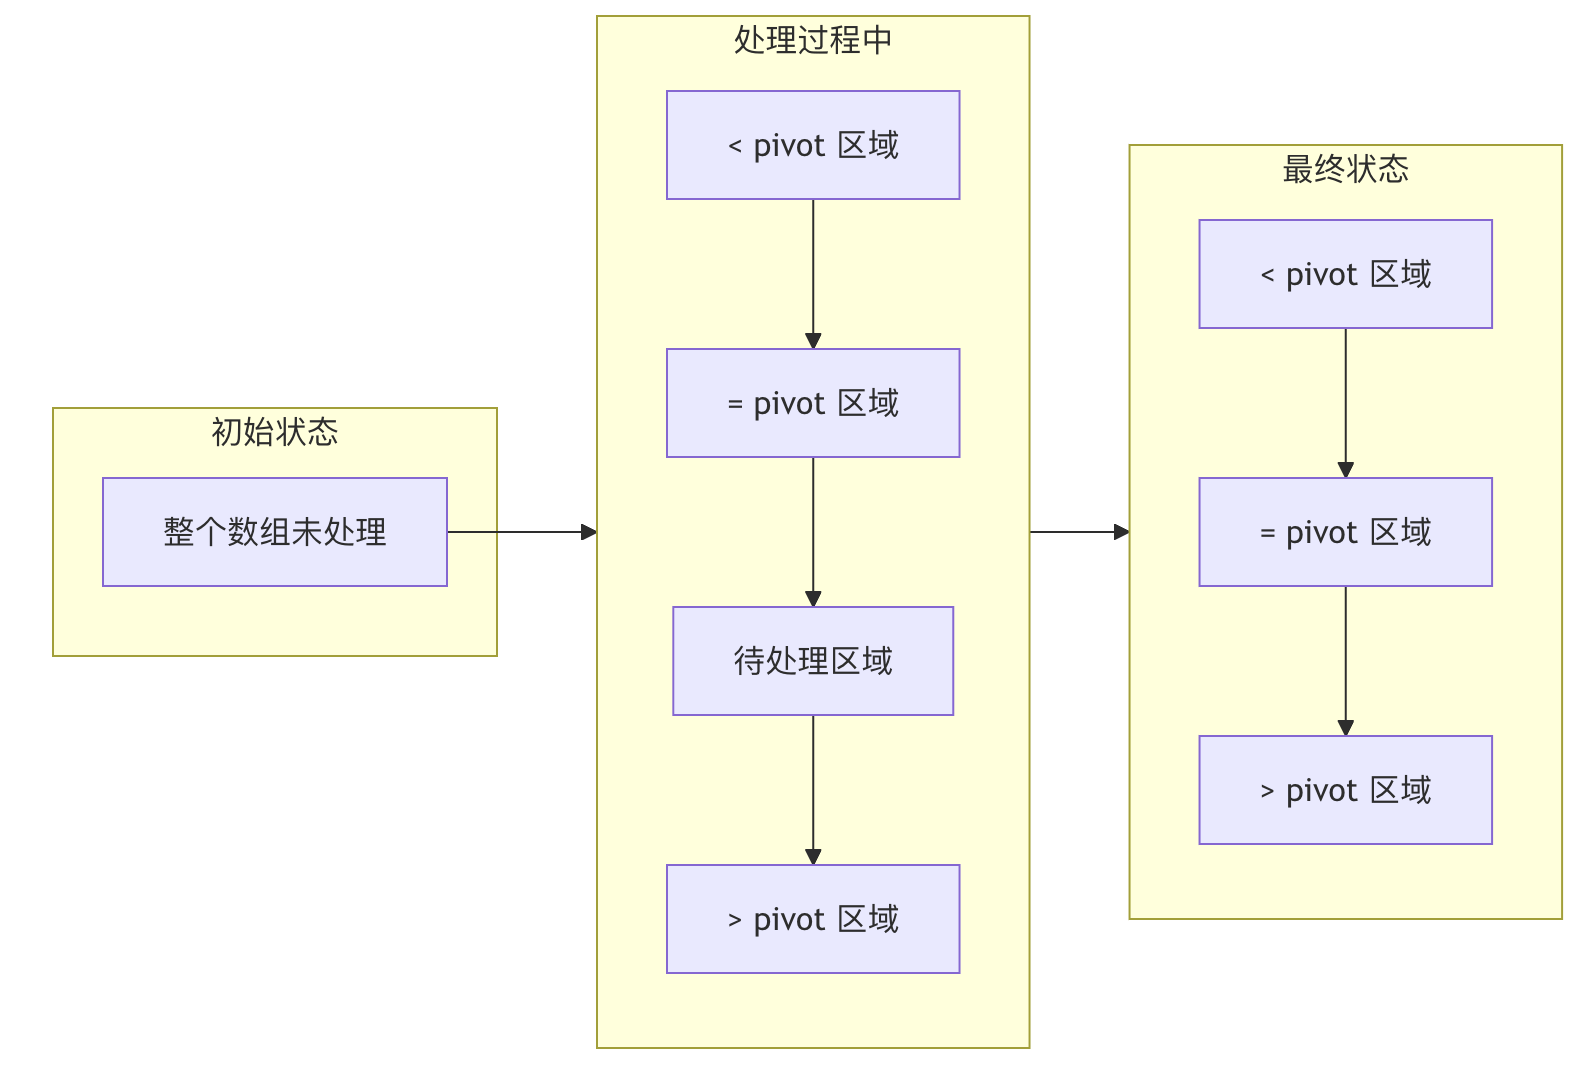
図の説明:アルゴリズムは3つのポインタ(lt, i, gt)を使用して配列を4つの領域に分割します。処理が進むにつれて未処理領域は徐々に縮小し、最終的に3つのはっきりしたパーティションが形成されます。
3つの重要なポインタの役割
lt(less than)ポインタ:基準値より小さい領域の末尾を指しますi(current)ポインタ:現在チェック中の要素の位置gt(greater than)ポインタ:基準値より大きい領域の先頭を指します
Python 実装
基本の三路パーティション関数
以下は標準的な三路パーティション関数の実装です。1行ずつ解説していきます:
例
"""
配列 arr の low から high の範囲を三路パーティションします。
パラメータ:
arr: パーティション対象の配列
low: パーティション開始インデックス
high: パーティション終了インデックス
戻り値:
(lt, gt): 基準値と等しい領域の左右の境界
"""
# 基準値を選択(ここでは最初の要素を選択)
pivot = arr[low]
# 3つのポインタを初期化
lt = low # 基準値より小さい領域の右境界(初期値は low)
i = low + 1 # 現在チェック中の要素の位置
gt = high # 基準値より大きい領域の左境界(初期値は high)
# メインループ:未処理の要素がある間は続ける
while i <= gt:
if arr[i] < pivot:
# ケース1:現在の要素が基準値より小さい
# それを lt ポインタの次の要素と交換し、小さい領域を拡大する
arr[lt], arr[i] = arr[i], arr[lt]
lt += 1
i += 1
elif arr[i] > pivot:
# ケース2:現在の要素が基準値より大きい
# それを gt ポインタの要素と交換し、大きい領域を拡大する
arr[i], arr[gt] = arr[gt], arr[i]
gt -= 1
# 注意:ここでは i を増やさない。交換されてきた要素がまだチェックされていないため
else:
# ケース3:現在の要素が基準値と等しい
# そのままスキップし、等しい領域を拡大する
i += 1
# 基準値と等しい領域の境界を返す
return lt, gt
完全な三路クイックソート実装
上記のパーティション関数に基づいて、完全な三路クイックソートを実装できます:
例
"""
三路クイックソートのメイン関数
パラメータ:
arr: ソート対象の配列
low: ソート開始インデックス(デフォルトは0)
high: ソート終了インデックス(デフォルトは配列の末尾)
"""
if high is None:
high = len(arr) - 1
# 再帰終了条件:部分配列の長さが1以下
if low >= high:
return
# 三路パーティションを実行
lt, gt = three_way_partition(arr, low, high)
# 基準値より小さい部分を再帰ソート
three_way_quicksort(arr, low, lt - 1)
# 基準値より大きい部分を再帰ソート
three_way_quicksort(arr, gt + 1, high)
# 注意:基準値と等しい部分はすでに正しい位置にあるため、再ソートは不要
実践的な応用例
例1:色ソート問題
これは三路ソートアルゴリズムの古典的な応用シーンであり、「オランダ国旗問題」とも呼ばれます。
例
"""
色ソート:0(赤)、1(白)、2(青)のみを含む配列を順番に並べる
パラメータ:
colors: 色配列、要素は0, 1, 2
戻り値:
ソート後の色配列
"""
# 3つのポインタを初期化
red_ptr = 0 # 赤い領域の末尾
white_ptr = 0 # 現在チェック中の位置(白い領域の末尾でもある)
blue_ptr = len(colors) - 1 # 青い領域の先頭
while white_ptr <= blue_ptr:
if colors[white_ptr] == 0:
# 赤:赤い領域へ交換
colors[red_ptr], colors[white_ptr] = colors[white_ptr], colors[red_ptr]
red_ptr += 1
white_ptr += 1
elif colors[white_ptr] == 1:
# 白:中央の領域に残す
white_ptr += 1
else:
# 青:青い領域へ交換
colors[white_ptr], colors[blue_ptr] = colors[blue_ptr], colors[white_ptr]
blue_ptr -= 1
# 注意:ここでは white_ptr を増やさない。交換されてきた要素がまだチェックされていないため
return colors
# テストデータ
test_colors = [2, 0, 2, 1, 1, 0, 1, 2, 0, 1, 0, 2]
print("元の色配列:", test_colors)
print("ソート後の色配列:", sort_colors(test_colors.copy()))
テストデータの説明:上記の配列は色番号を表します(0=赤、1=白、2=青)。ソート後は、すべての0が先頭、1が中央、2が後ろになるはずです。
例2:学生の成績の段階分け
学生の成績に基づいて区分する必要があると仮定します:60未満は不合格、60-80は良好、80超は優秀です。
例
"""
成績を3つの等級に分けます:不合格(<60)、良好(60-80)、優秀(>80)
パラメータ:
scores: 成績配列
戻り値:
区分後の成績配列
"""
if not scores:
return scores
# 三路パーティションの考え方を用い、60と80を境界点とする
# まず60でパーティション:不合格 vs 合格以上
low = 0
mid = 0
high = len(scores) - 1
# 第1ラウンド:不合格の成績(<60)を分離する
while mid <= high:
if scores[mid] < 60:
scores[low], scores[mid] = scores[mid], scores[low]
low += 1
mid += 1
elif scores[mid] <= 80:
mid += 1
else:
scores[mid], scores[high] = scores[high], scores[mid]
high -= 1
# 第2ラウンド:合格以上の部分で良好と優秀を分離する
# このときlowは最初の良好な成績の位置を指す
mid = low
high = len(scores) - 1
while mid <= high:
if scores[mid] <= 80:
mid += 1
else:
scores[mid], scores[high] = scores[high], scores[mid]
high -= 1
return scores
# テストデータ
test_scores = [45, 78, 92, 56, 85, 67, 72, 88, 59, 95, 61, 73]
print("元の成績:", test_scores)
print("区分後の成績:", categorize_grades(test_scores.copy()))
print("説明: 前部分<60, 中間60-80, 後部分>80")
アルゴリズムの計算量分析
時間計算量
三路ソートアルゴリズムの時間計算量の分析は次の式で表せます:
$$ T(n) = O(n) + T(k) + T(n - k - m) $$
ここで:
- $n$ は配列の長さ
- $k$ は基準値より小さい要素の数
- $m$ は基準値に等しい要素の数
- $n - k - m$ は基準値より大きい要素の数
最良の場合:毎回のパーティションで配列を均等に3つに分割できる場合、時間計算量は $O(n \log_3 n)$ となり、実際には依然として $O(n \log n)$ です。
最悪の場合:毎回のパーティションが極めて不均等な場合、時間計算量は $O(n^2)$ です。
平均の場合:ランダムデータに対して、平均時間計算量は $O(n \log n)$ です。
空間計算量
アルゴリズムは再帰で実装されており、再帰の深さはパーティションの状況に依存します:
- 最良の場合:$O(\log n)$
- 最悪の場合:$O(n)$
末尾再帰の最適化や反復方式を使用することで、空間使用量を減らせます。