Drei-Wege-Sortieralgorithmus
Drei-Wege-Sortieralgorithmus(Three-Way Partitioning) ist eine spezielle Variante von Quicksort, die speziell für Arrays mit vielen doppelten Elementen optimiert wurde. Ihre Kernidee besteht darin, das Array in einem einzigen Partitionierungsdurchlauf in drei Teile zu zerlegen statt in die traditionellen zwei Teile.
Drei-Wege-Quicksort ist eine weiter verbesserte Version von Zwei-Wege-Quicksort. Der Drei-Wege-Sortieralgorithmus teilt die zu sortierenden Daten in drei Teile: kleiner als v, gleich v und größer als v, wobei v der Pivot ist. Auf diese Weise müssen die Daten, die gleich v sind, in der nächsten Rekursion nicht mehr sortiert werden, und bei den Daten, die kleiner oder größer als v sind, tritt nicht der Fall auf, dass eine Seite besonders groß ist. Mit diesem Ansatz erzielt der Drei-Wege-Quicksort-Algorithmus eine bessere Leistung.
Stellen Sie sich einen großen Eimer mit gemischten farbigen Murmeln in drei Farben vor: Rot, Weiß und Blau. Ihre Aufgabe ist es, sie schnell zu trennen, sodass alle roten Murmeln links, die weißen in der Mitte und die blauen rechts liegen. Der Drei-Wege-Partitionierungsalgorithmus ist der Sortiermeister für die Lösung dieser Art von Problem.
Traditionelles Quicksort vs. Drei-Wege-Quicksort
Vergleichen wir die Unterschiede zwischen den beiden anhand einer einfachen Tabelle:
| Funktionen | Traditioneller Quicksort | Drei-Wege-Quicksort |
|---|---|---|
| Anzahl der Partitionen | 2 (kleiner als Pivot, größer als Pivot) | 3 (kleiner als Pivot, gleich Pivot, größer als Pivot) |
| Umgang mit doppelten Elementen | Weniger effizient; doppelte Elemente können mehrfach verglichen und getauscht werden | Äußerst effizient, doppelte Elemente werden gemeinsam behandelt |
| Zeitkomplexität | Durchschnittlich O(n log n), im schlimmsten Fall O(n²) | Durchschnittlich O(n log n), im schlimmsten Fall O(n²) |
| Speicherkomplexität | O(log n) (Rekursionsstack) | O(log n) (Rekursionsstack) |
| Anwendbare Szenarien | Allzweck-Sortierung, geringe Elementduplikatrate | Hohe Duplikatrate von Elementen, z. B. Farbsortierung und Score-Segmentierung |
Anwendbarkeit
Die Zeit- und Raumkomplexität sind dieselben wie bei randomisiertem Quicksort.
Der Drei-Wege-Quicksort-Algorithmus partitioniert das Array mithilfe einer Drei-Wege-Partitionierungsstrategie, die bei Arrays mit vielen doppelten Elementen sehr effektiv ist und den Quicksort-Prozess verbessert. Er fügt Logik hinzu, um Elemente gleich dem Partitionierungswert zu behandeln, und gruppiert alle Werte gleich dem Partitionselement zusammen.
Prozessdiagramm
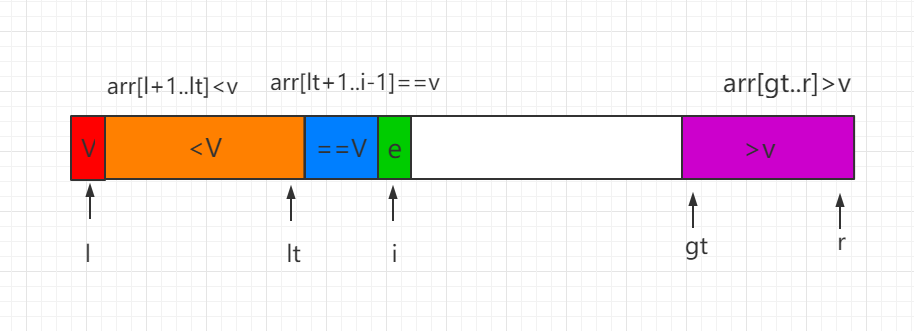
Wir besprechen den Partitionierungsprozess in drei Fällen, wobei i die aktuelle Position des Traversierungsindex darstellt:
(1) Das aktuelle Element e = V wird direkt in das blaue Intervall eingeordnet, und i bewegt sich eine Position nach rechts.
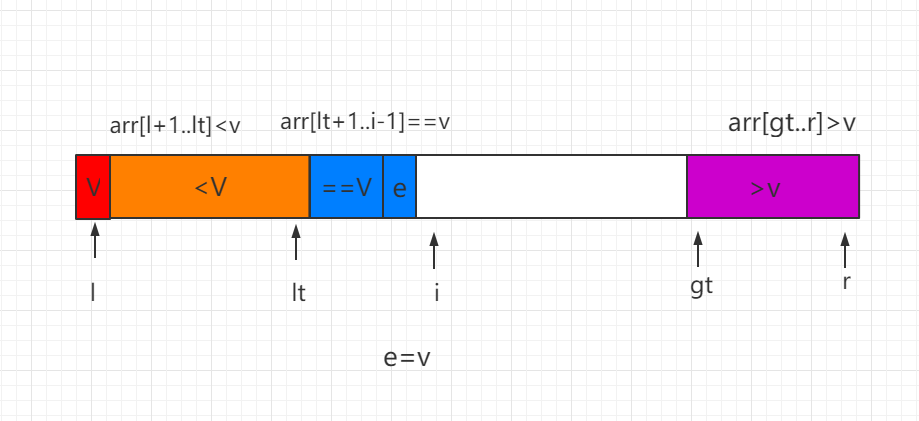
(2) Das aktuelle Element e < v: Vertausche e mit dem Wert an der ersten Position des Intervalls gleich V, und bewege sowohl lt als auch i um eine Position nach rechts.
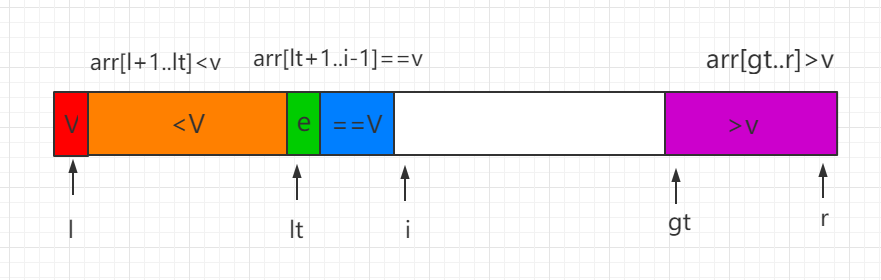
(3) Das aktuelle Element e > v: Vertausche e mit dem Wert am Index gt-1, und bewege den Index gt um eine Position nach links.
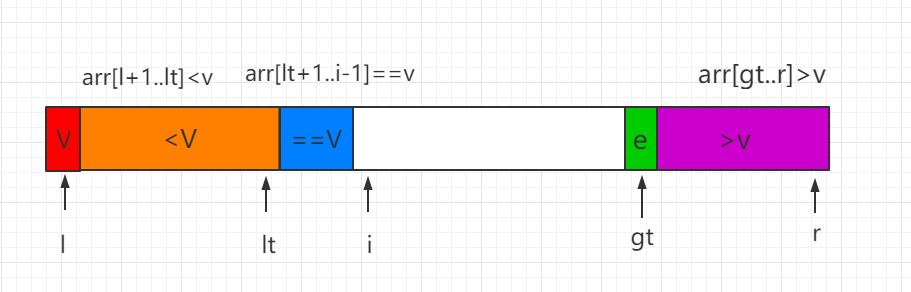
Schließlich, wenni=gtdie Traversierung endet, wird v mit dem Wert getauscht, auf den der Index lt zeigt, und damit ist der Partitionierungsprozess abgeschlossen. Dann werden mit derselben Methode rekursiv die Teile <V und >V sortiert.
Java-Beispielcode
Quellcode-Paket-Download:Herunterladen
Code der Datei QuickSort3Ways.java:
/**
* Drei-Wege-Quicksort
*/
public class QuickSort3Ways {
// Kerncode --- Start
// Quicksort rekursiv verwenden, um den Bereich arr[l...r] zu sortieren
private static void sort(Comparable[] arr, int l, int r){
if (l >= r) {
return;
}
// Zufällig einen Wert als Pivot im Bereich arr[l...r] auswählen
swap( arr, l, (int)(Math.random()*(r-l+1)) + l );
Comparable v = arr[l];
int lt = l; // arr[l+1...lt] < v
int gt = r + 1; // arr[gt...r] > v
int i = l+1; // arr[lt+1...i) == v
while( i < gt ){
if( arr[i].compareTo(v) < 0 ){
swap( arr, i, lt+1);
i ++;
lt ++;
}
else if( arr[i].compareTo(v) > 0 ){
swap( arr, i, gt-1);
gt --;
}
else{ // arr[i] == v
i ++;
}
}
swap( arr, l, lt );
sort(arr, l, lt-1);
sort(arr, gt, r);
}
// Kerncode --- Ende
public static void sort(Comparable[] arr){
int n = arr.length;
sort(arr, 0, n-1);
}
private static void swap(Object[] arr, int i, int j) {
Object t = arr[i];
arr[i] = arr[j];
arr[j] = t;
}
// Teste QuickSort3Ways
public static void main(String[] args) {
// Der Drei-Wege-Quicksort-Algorithmus ist ebenfalls ein Algorithmus mit O(nlogn)-Komplexität
// Kann Daten in der Größenordnung von 1 Million problemlos innerhalb von 1 Sekunde verarbeiten
int N = 1000000;
Integer[] arr = SortTestHelper.generateRandomArray(N, 0, 100000);
sort(arr);
SortTestHelper.printArray(arr);
}
}
Kernidee und Funktionsprinzip des Algorithmus
Die Feinheit des Drei-Wege-Partitionierungsalgorithmus besteht darin, dass er drei Zeiger verwendet, um verschiedene Bereiche des Arrays zu verfolgen, und die Drei-Wege-Klassifizierung in einem einzigen Durchlauf abschließt.
Partitionszustand des Algorithmus
Verstehen wir den Partitionierungsprozess des Algorithmus anhand eines Zustandsdiagramms:
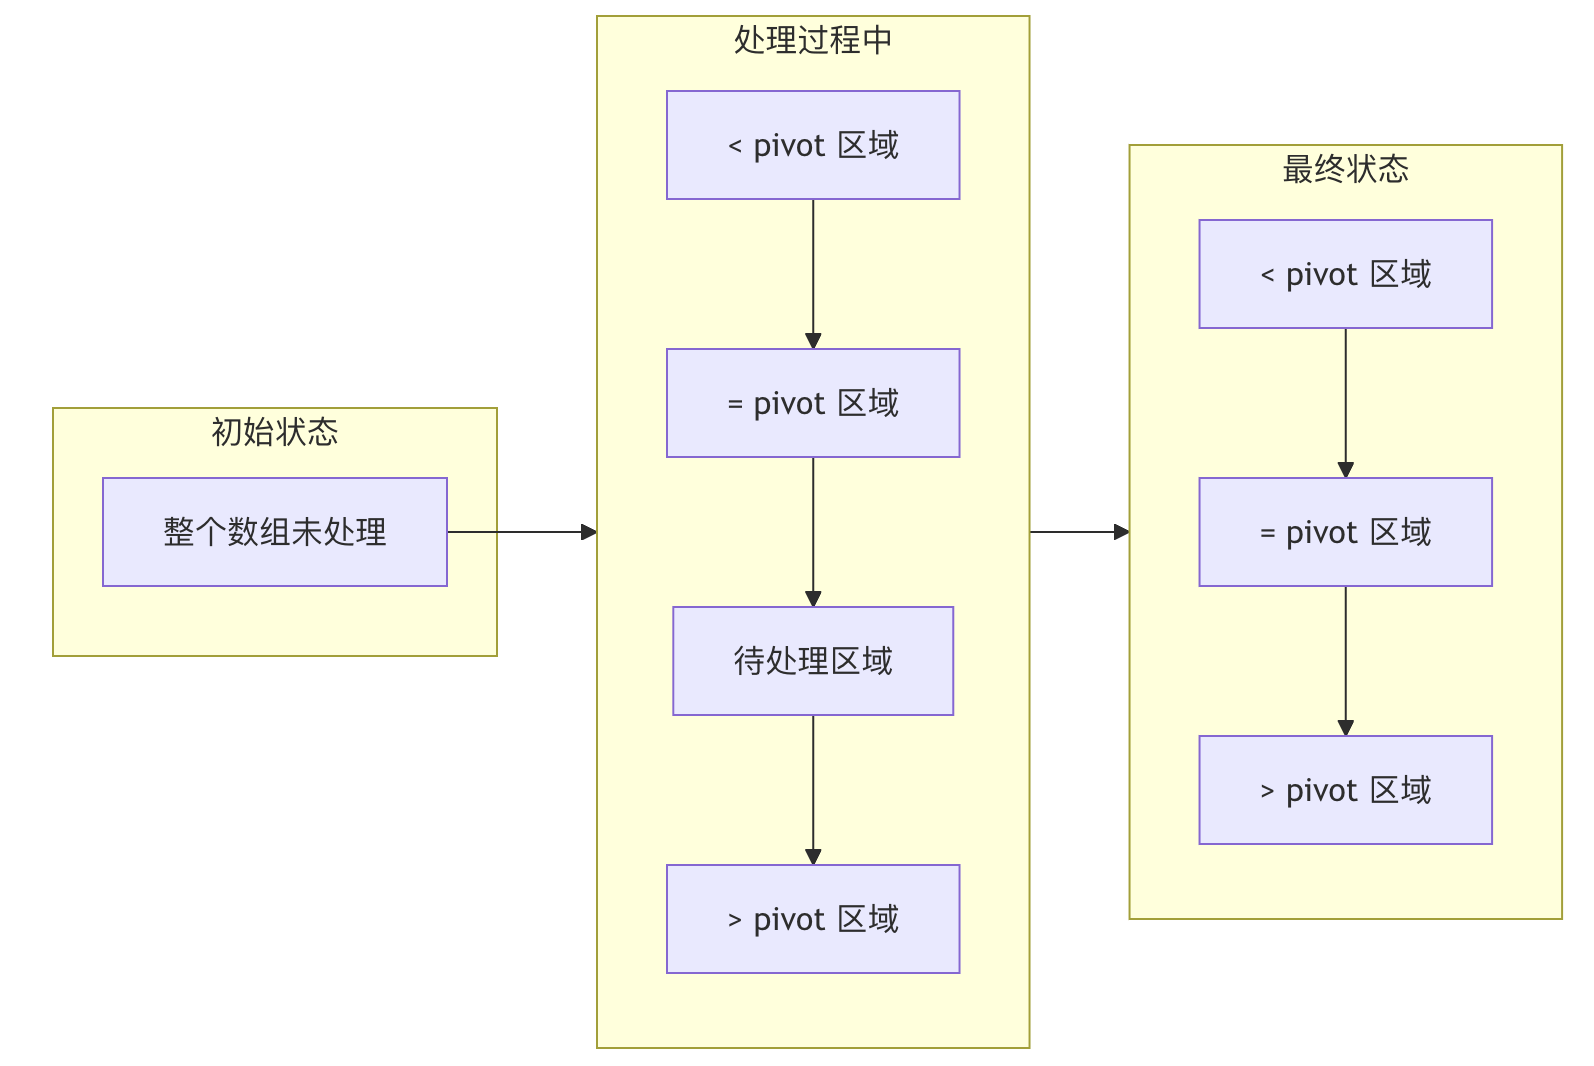
AbbildungsbeschreibungDer Algorithmus verwaltet drei Zeiger (lt, i, gtEs teilt das Array in vier Bereiche; im Verlauf der Verarbeitung schrumpft der unbearbeitete Bereich allmählich und bildet schließlich drei klare Partitionen.
Rollen der drei Schlüsselzeiger
lt(kleiner als)-ZeigerZeigt auf das Ende des Bereichs, der kleiner als das Pivot-Element isti(aktueller) ZeigerPosition des Elements, das gerade untersucht wirdgt(größer als)-ZeigerZeigt auf den Anfang des Bereichs, der größer als das Pivot-Element ist
Python-Implementierung
Grundlegende Drei-Wege-Partitionsfunktion
Nachfolgend finden Sie eine Standardimplementierung der Drei-Wege-Partitionsfunktion; wir werden sie Zeile für Zeile analysieren:
Beispiel
"""
Führe eine Drei-Wege-Partitionierung für das Array arr im Bereich von low bis high durch
Parameter:
arr: Das zu partitionierende Array
low: Der Startindex der Partition
high: Der Endindex der Partition
Rückgabe:
(lt, gt): Die linken und rechten Grenzen des Bereichs, der gleich dem Pivot-Wert ist
"""
# Wähle den Pivot (hier wird das erste Element gewählt)
pivot = arr[low]
# Initialisiere drei Zeiger
lt = low # Die rechte Grenze des Bereichs, der kleiner als der Pivot ist (initialisiert mit low)
i = low + 1 # Position des aktuellen Elements, das untersucht wird
gt = high # Die linke Grenze des Bereichs, der größer als der Pivot ist (mit high initialisiert)
# Hauptschleife: fortsetzen, solange noch unverarbeitete Elemente vorhanden sind
while i <= gt:
if arr[i] < pivot:
# Fall 1: Das aktuelle Element ist kleiner als der Pivot
# Tausche es mit dem nächsten Element des lt-Zeigers, um den Kleiner-als-Bereich zu erweitern
arr[lt], arr[i] = arr[i], arr[lt]
lt += 1
i += 1
elif arr[i] > pivot:
# Fall 2: Das aktuelle Element ist größer als der Pivot
# Tausche es mit dem Element am gt-Zeiger, um den Größer-als-Bereich zu erweitern
arr[i], arr[gt] = arr[gt], arr[i]
gt -= 1
# Hinweis: i wird hier nicht erhöht, weil das eingetauschte Element noch nicht geprüft wurde
else:
# Fall 3: Das aktuelle Element entspricht dem Pivot
# Direkt überspringen, den Gleichheitsbereich erweitern
i += 1
# Die Grenzen des Bereichs zurückgeben, der dem Pivot entspricht
return lt, gt
Vollständige Drei-Wege-Quicksort-Implementierung
Basierend auf der obigen Partitionsfunktion können wir den vollständigen Drei-Wege-Quicksort implementieren:
Beispiel
"""
Drei-Wege-Quicksort-Hauptfunktion
Parameter:
arr: Das zu sortierende Array
low: Der Startindex für die Sortierung (Standard ist 0)
high: Der Endindex für die Sortierung (Standard ist das Ende des Arrays)
"""
if high is None:
high = len(arr) - 1
# Abbruchbedingung der Rekursion: Die Länge des Teilarrays ist kleiner oder gleich 1
if low >= high:
return
# Drei-Wege-Partitionierung durchführen
lt, gt = three_way_partition(arr, low, high)
# Den Teil, der kleiner als das Pivot ist, rekursiv sortieren
three_way_quicksort(arr, low, lt - 1)
# Den Teil, der größer als das Pivot ist, rekursiv sortieren
three_way_quicksort(arr, gt + 1, high)
# Hinweis: Der Teil, der gleich dem Pivot ist, befindet sich bereits an der richtigen Position, es ist keine weitere Sortierung erforderlich
Praktische Anwendungsbeispiele
Beispiel 1: Problem der Farbsortierung
Dies ist ein klassisches Anwendungsszenario des Drei-Wege-Partitionierungsalgorithmus, auch bekannt als "Problem der niederländischen Flagge".
Beispiel
"""
Farbsortierung: Ordne ein Array, das nur 0 (rot), 1 (weiß), 2 (blau) enthält, in der richtigen Reihenfolge an
Parameter:
colors: Das Farb-Array, Elemente sind 0, 1, 2
Rückgabe:
Das sortierte Farb-Array
"""
# Initialisiere drei Zeiger
red_ptr = 0 # Das Ende des roten Bereichs
white_ptr = 0 # Die aktuell untersuchte Position (auch das Ende des weißen Bereichs)
blue_ptr = len(colors) - 1 # Der Anfang des blauen Bereichs
while white_ptr <= blue_ptr:
if colors[white_ptr] == 0:
# Rot: in den roten Bereich tauschen
colors[red_ptr], colors[white_ptr] = colors[white_ptr], colors[red_ptr]
red_ptr += 1
white_ptr += 1
elif colors[white_ptr] == 1:
# Weiß: bleibt im mittleren Bereich
white_ptr += 1
else:
# Blau: in den blauen Bereich tauschen
colors[white_ptr], colors[blue_ptr] = colors[blue_ptr], colors[white_ptr]
blue_ptr -= 1
# Hinweis: white_ptr wird hier nicht inkrementiert, weil das hineingetauschte Element noch nicht geprüft wurde
return colors
# Testdaten
test_colors = [2, 0, 2, 1, 1, 0, 1, 2, 0, 1, 0, 2]
print("Ursprüngliches Farbarray:", test_colors)
print("Sortiertes Farbarray:", sort_colors(test_colors.copy()))
TestdatenbeschreibungDas obige Array repräsentiert Farbcodes (0=rot, 1=weiß, 2=blau). Nach dem Sortieren sollten alle Nullen vorne stehen, Einsen in der Mitte und Zweien am Ende.
Beispiel 2: Gruppierung der Punktzahlen von Studenten
Angenommen, wir müssen Studenten nach Punktzahl segmentieren: unter 60 ist nicht bestanden, 60-80 ist gut und über 80 ist ausgezeichnet.
Beispiel
"""
Klassifiziere die Punktzahlen in drei Kategorien: Nicht bestanden (<60), Gut (60-80), Ausgezeichnet (>80)
Parameter:
scores: Array von Punktzahlen
Rückgabe:
Segmentiertes Punktzahlen-Array
"""
if not scores:
return scores
# Verwende die Drei-Wege-Partitionierungsidee mit 60 und 80 als Grenzen
# Erste Partitionierung nach 60: Nicht bestanden vs. bestanden oder darüber
low = 0
mid = 0
high = len(scores) - 1
# Erste Runde: nicht bestandene Ergebnisse (<60) trennen
while mid <= high:
if scores[mid] < 60:
scores[low], scores[mid] = scores[mid], scores[low]
low += 1
mid += 1
elif scores[mid] <= 80:
mid += 1
else:
scores[mid], scores[high] = scores[high], scores[mid]
high -= 1
# Zweite Runde: gute und ausgezeichnete Ergebnisse vom Teil ab der Bestehensgrenze trennen
# An dieser Stelle zeigt low auf die Position des ersten guten Ergebnisses
mid = low
high = len(scores) - 1
while mid <= high:
if scores[mid] <= 80:
mid += 1
else:
scores[mid], scores[high] = scores[high], scores[mid]
high -= 1
return scores
# Testdaten
test_scores = [45, 78, 92, 56, 85, 67, 72, 88, 59, 95, 61, 73]
print("Originalergebnisse:", test_scores)
print("Segmentierte Ergebnisse:", categorize_grades(test_scores.copy()))
print("Hinweis: erster Teil <60, mittlerer Teil 60-80, letzter Teil >80")
Analyse der Algorithmuskomplexität
Zeitkomplexität
Die Zeitkomplexitätsanalyse des Drei-Wege-Sortieralgorithmus kann mit der folgenden Formel ausgedrückt werden:
$$ T(n) = O(n) + T(k) + T(n - k - m) $$
Wobei:
- $n$ ist die Länge des Arrays
- $k$ ist die Anzahl der Elemente, die kleiner als der Pivot-Wert sind
- $m$ ist die Anzahl der Elemente, die gleich dem Pivot-Wert sind
- $n - k - m$ ist die Anzahl der Elemente, die größer als der Pivot-Wert sind
Bester FallBester Fall: Jede Partition kann das Array gleichmäßig in drei Teile aufteilen, mit der Zeitkomplexität $O(n \log_3 n)$, was tatsächlich immer noch $O(n \log n)$ ist.
Schlechtester FallSchlechtester Fall: Jede Partition ist extrem unausgewogen, mit der Zeitkomplexität $O(n^2)$.
Durchschnittlicher FallDurchschnittlicher Fall: Für zufällige Daten ist die durchschnittliche Zeitkomplexität $O(n \log n)$.
Speicherkomplexität
Der Algorithmus ist rekursiv implementiert, und die Rekursionstiefe hängt von der Partitionierungssituation ab:
- Bester Fall: $O(\log n)$
- Schlechtester Fall:$O(n)$
Der Speicherverbrauch kann durch Endrekursionsoptimierung oder durch die Verwendung eines iterativen Ansatzes reduziert werden.