Modèles séquence à séquence
Les modèles Sequence-to-Sequence (Seq2Seq) constituent une architecture importante en traitement du langage naturel (NLP), spécialement conçus pour les tâches qui convertissent une séquence en une autre séquence. L'idée centrale de ce modèle est d'accepter une séquence d'entrée de longueur variable et de générer une séquence de sortie de longueur variable.
Concepts de base
Les modèles Seq2Seq appartiennent à l'architectureEncodeur-Décodeur:
- Encodeur: encode la séquence d'entrée en un vecteur de contexte de longueur fixe
- Décodeur: génère la séquence de sortie étape par étape en se basant sur le vecteur de contexte
Caractéristiques typiques
- Les longueurs des séquences d'entrée et de sortie peuvent être différentes
- Adapté aux tâches de conversion entre plusieurs langues
- Capable de traiter des données de séquence de longueur variable
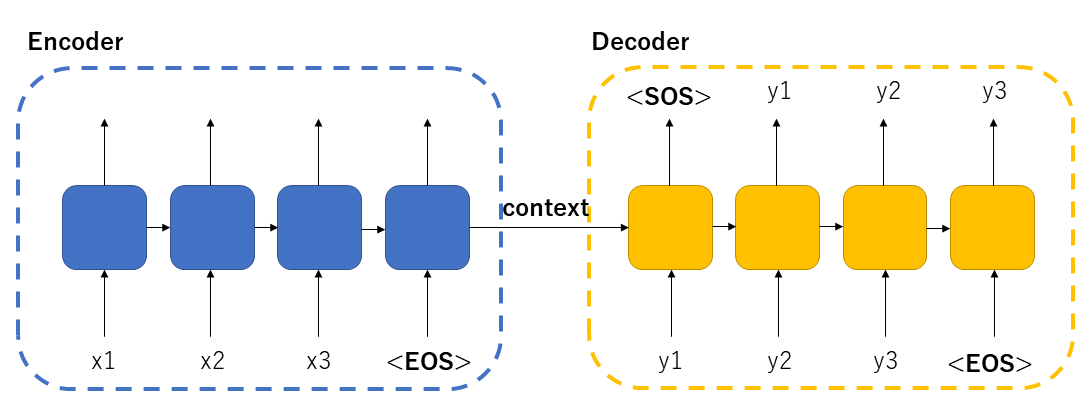
Principes fondamentaux des modèles Seq2Seq
Composants de base de l'architecture
Encodeur
L'encodeur utilise généralement des RNN (tels que LSTM ou GRU) pour traiter la séquence d'entrée, en compressant progressivement les informations de séquence dans des états cachés, et en générant finalement un vecteur de contexte qui représente l'ensemble de la séquence d'entrée.
Décodeur
Le décodeur part du vecteur de contexte et génère chaque élément de la séquence de sortie étape par étape jusqu'à produire le jeton de fin.
Workflow
- L'encodeur lit la séquence d'entrée et génère un vecteur de contexte
- Le décodeur initialise son état caché comme le vecteur de contexte
- Le décodeur génère les éléments de la séquence de sortie étape par étape
- S'arrête lorsque le jeton de fin est généré
Améliorations techniques clés
- Mécanisme d'attention: résout le problème de perte d'information dans les longues séquences
- Architecture Transformer: un modèle Seq2Seq entièrement basé sur des mécanismes d'auto-attention
- Recherche par faisceau: améliore les stratégies de décodage pour améliorer la qualité de génération
Exemples
class Seq2Seq(nn.Module):
def __init__(self):
self.encoder = RNN(input_size, hidden_size)
self.decoder = RNN(hidden_size, output_size)
def forward(self, input_seq):
# Phase d'encodage
hidden = self.encoder(input_seq)
# Phase de décodage
outputs = self.decoder(hidden)
return outputs
Application de Seq2Seq en traduction automatique
Caractéristiques des tâches de traduction automatique
- L'entrée et la sortie sont toutes deux des séquences de texte
- Les longueurs des séquences entre deux langues ne correspondent généralement pas
- Nécessite de comprendre la langue source et de générer la langue cible
Cas d'application typiques
- Système de traduction automatique neuronale de Google (GNMT)
- Système de traduction Fairseq de Facebook
- Outil open source OpenNMT
Points clés de l'implémentation
- Utiliser des encodeurs RNN bidirectionnels pour capturer les informations contextuelles
- Intégrer des mécanismes d'attention pour gérer les phrases longues
- Utiliser la tokenisation en sous-mots pour gérer les mots rares
Exemples
translation_model = Seq2Seq(
encoder=BiLSTM(vocab_size=src_vocab_size),
decoder=LSTM(vocab_size=tgt_vocab_size),
attention=DotProductAttention()
)
Application de Seq2Seq dans le résumé de texte
Classification des tâches de résumé de texte
| Type de résumé | Caractéristiques | Adéquation de Seq2Seq |
|---|---|---|
| Résumé extractif | Sélectionne les phrases importantes du texte original | Non adapté |
| Résumé abstractif | Génère un nouveau texte condensé | Très adapté |
Principaux défis techniques
- Gestion de la compression d'informations de documents longs
- Maintenir la cohérence et l'exactitude des résumés
- Éviter la génération répétée de contenu identique
Solutions
- Réseau pointeur-générateur: combine les méthodes extractives et génératives
- Mécanisme de couverture: suit le contenu généré pour éviter la répétition
- Apprentissage par renforcement: optimise les métriques de résumé telles que ROUGE
Exemples
summarizer = Seq2Seq(
encoder=TransformerEncoder(),
decoder=TransformerDecoder(),
pointer_network=True
)
Application de Seq2Seq dans la génération de dialogues
Comparaison des types de systèmes de dialogue
| Type | Caractéristiques | Adéquation de Seq2Seq |
|---|---|---|
| Dialogue orienté vers les tâches | Accomplit des tâches spécifiques | Adéquation limitée |
| Dialogue de bavardage | Communication en domaine ouvert | Très adapté |
Caractéristiques particulières de la génération de dialogue
- Nécessité de maintenir la cohérence du dialogue
- Les réponses doivent s'adapter au contexte du dialogue
- Éviter de générer des réponses génériques et dénuées de sens
Méthodes d'amélioration
- Plongement personnalisé: intègre les caractéristiques du locuteur
- Contrôle du sentiment: génère des réponses avec des tonalités émotionnelles spécifiques
- Entraînement adversarial: améliore le naturel des réponses
Exemples
chatbot = Seq2Seq(
encoder=GRU(hidden_size=512),
decoder=GRU(hidden_size=512),
personality_embedding=True
)
Entraînement et optimisation des modèles Seq2Seq
Processus d'entraînement
- Préparer des jeux de données de corpus parallèles
- Définir la fonction de perte (généralement l'entropie croisée)
- Entraîner avec Teacher Forcing
- Régler les hyperparamètres à l'aide de l'ensemble de validation
Problèmes courants et solutions
| Problème | Cause | Solution |
|---|---|---|
| Disparition du gradient | Dépendances de longues séquences | Utiliser LSTM/GRU, ou Transformer |
| Biais d'exposition | Inadéquation entre l'entraînement et le test | Échantillonnage planifié |
| Réponses génériques | Biais du maximum de vraisemblance | Entraînement adversarial ou apprentissage par renforcement |
Métriques d'évaluation
- BLEU: métriques couramment utilisées pour la traduction automatique
- ROUGE: métriques couramment utilisées pour le résumé de texte
- Évaluation humaine: un complément important pour les systèmes de dialogue
Résumé et perspectives
En tant que technologie centrale dans le domaine du traitement automatique du langage naturel, les modèles Seq2Seq ont évolué de l'architecture RNN simple initiale aux puissants modèles Transformer d'aujourd'hui. Ils ont démontré de fortes capacités dans des tâches telles que la traduction automatique, le résumé de texte et la génération de dialogues. Les orientations futures de développement incluent :
- Traitement plus efficace des longues séquences
- Capacités d'apprentissage few-shot/zero-shot
- Conversion de séquences multimodales
- Génération de contenu plus contrôlable
En comprenant les principes et les applications des modèles Seq2Seq, vous avez maîtrisé un outil puissant en NLP et pouvez commencer à créer vos propres applications de conversion de séquences !
Autres extensions