Architecture Transformer
L'architecture Transformer est un modèle d'apprentissage profond basé sur le mécanisme d'auto-attention, proposé par l'équipe Google dans un article de 2017《Attention Is All You Need》dans lequel il a été proposé pour la première fois.
Transformer a complètement transformé le domaine du traitement du langage naturel (NLP) et est devenu le fondement central des grands modèles de langage modernes (tels que GPT, BERT, etc.).
Semblable aux réseaux de neurones récurrents (RNNs), Transformer est conçu pour traiter des données d'entrée séquentielles telles que le langage naturel, et convient à des tâches comme la traduction automatique et le résumé de texte. Cependant, contrairement aux RNNs, Transformer n'a pas besoin de traiter les séquences étape par étape ; au lieu de cela, il peut traiter l'intégralité de l'entrée en parallèle en une seule fois.
Ce chapitre vous fera découvrir en profondeur les idées fondamentales, l'architecture et les principes de fonctionnement de Transformer, vous aidant à saisir les fondamentaux de cette technologie révolutionnaire.
Schéma de l'architecture Transformer
À gauche se trouve l'encodeur, et à droite le décodeur.
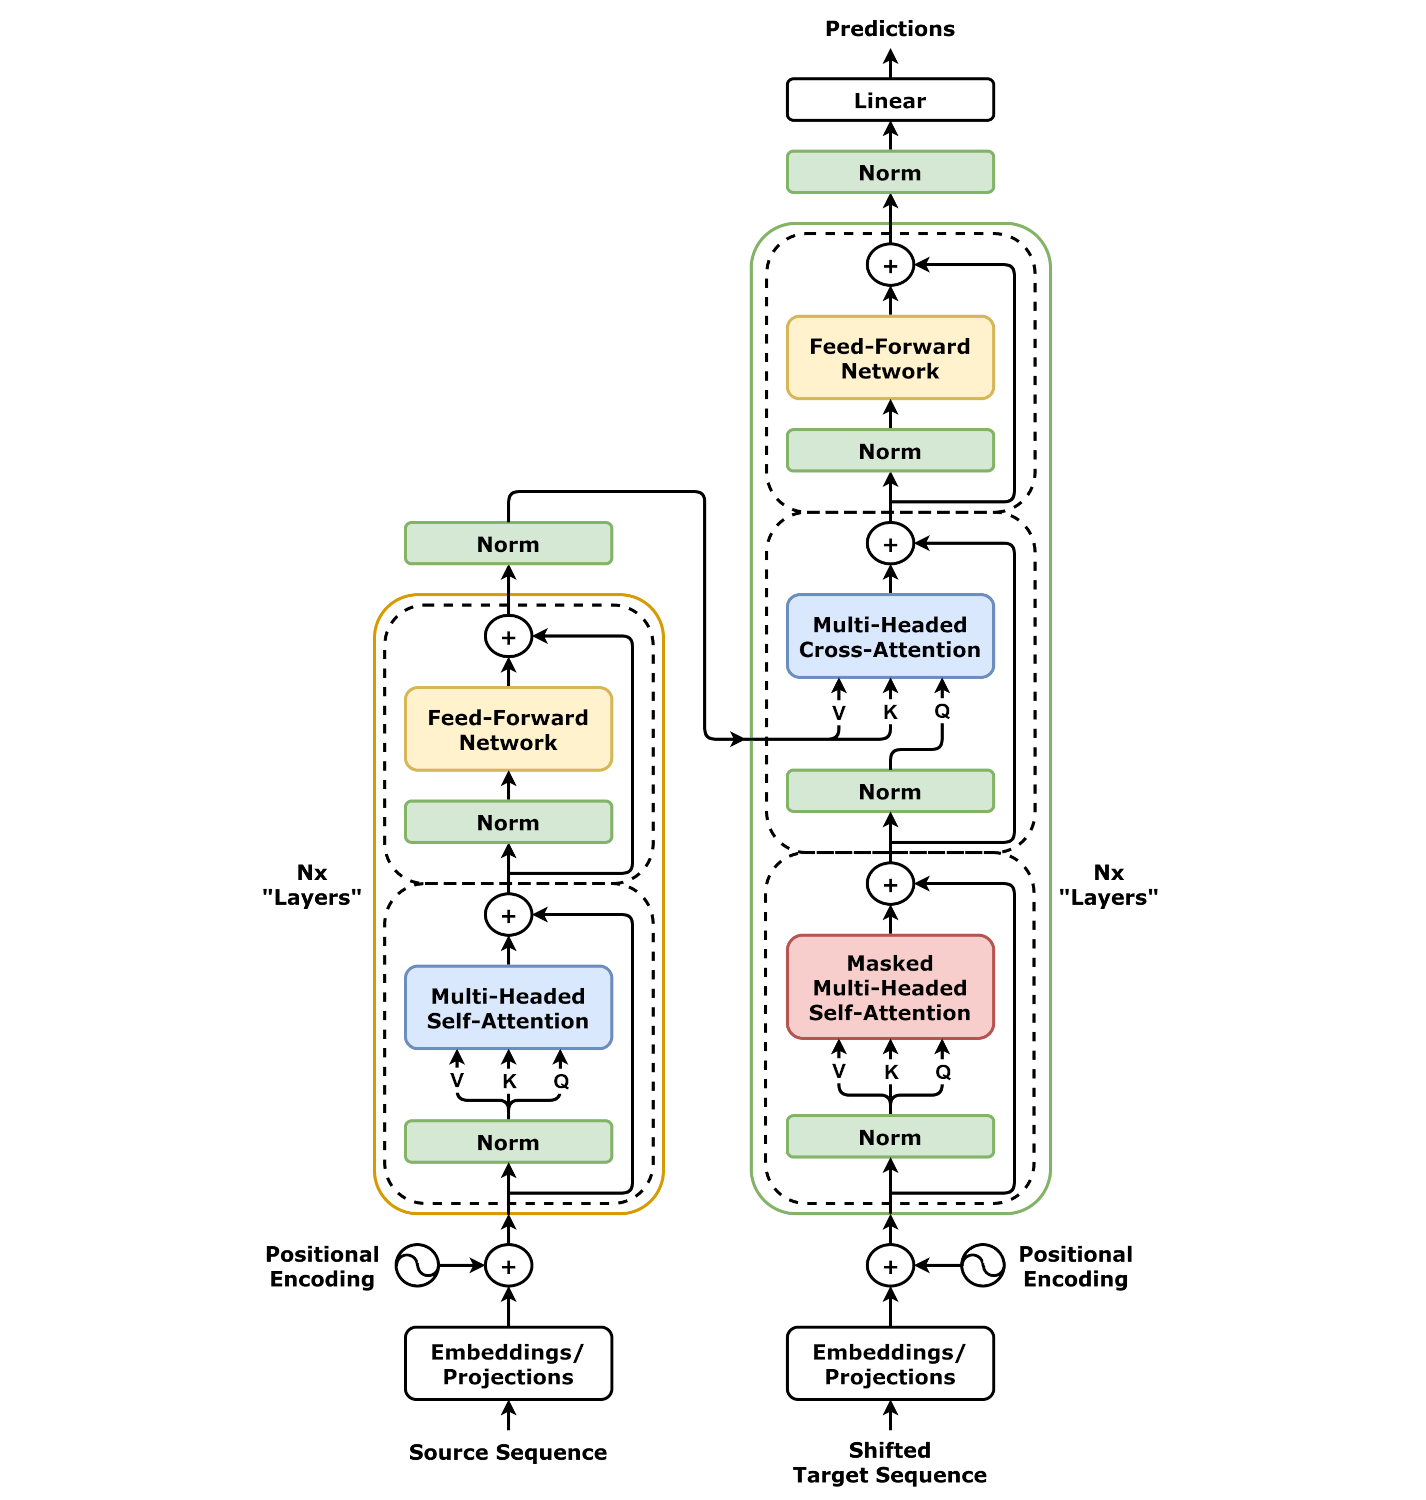
1. Traitement de l'entrée (Bas)
- Plongements/Projections (couche de plongement/projection)
- Fonction : Convertir les mots d'entrée (ou jetons) en vecteurs numériques (par ex., « chat » → [0.2, -0.5, 0.7…]).
- Analogie : C'est comme attribuer un « numéro d'identification » unique à chaque mot, mais en plus intelligent (il contient des informations sémantiques).
2. Encodeur (à gauche)
-
Auto-attention multi-têtes
- Fonction : Permet au modèle de prêter attention à tous les mots de l'entrée simultanément et de calculer leurs relations.
- Exemple : Dans la phrase « le chat poursuit la souris », le modèle apprend que « chat » et « souris » sont plus fortement associés que « chat » et « poursuit ».
- Point clé :Traiter tous les mots en parallèle, contrairement aux RNN, qui doivent calculer un par un.
-
Norm (normalisation de couche)
- Fonction : Stabilise le processus d'entraînement et empêche les valeurs de devenir trop grandes ou trop petites (comme régler le « volume » sur une plage appropriée).
-
Réseau feed-forward
- Fonction : Traite davantage la représentation de chaque mot (par ex., extraire des caractéristiques plus complexes).
- Analogie : comme effectuer une interprétation approfondie du vecteur pour « chat » et ajouter des détails (par ex., « un chat est un mammifère »).
3. Décodeur (droite)
-
Auto-attention multi-têtes masquée
- Fonction : empêche le modèle de « tricher » pendant l'entraînement (il ne peut voir que les mots actuels et précédents, pas les suivants).
- Exemple : lors de la génération de « I love __ », le modèle ne peut prédire le mot suivant qu'à partir de « I » et « love », et ne peut pas savoir à l'avance que la réponse est « you. »
-
Attention croisée multi-têtes
- Fonction : permet au décodeur de demander à l'encodeur : « Concernant l'entrée, sur quoi dois-je me concentrer ? »
- Scénario : dans les tâches de traduction, lorsque le décodeur génère de l'anglais, il se réfère à l'entrée en chinois traitée par l'encodeur.
-
Norm et réseau feed-forward
- Semblable à l'encodeur, il normalise et traite en profondeur les représentations du décodeur.
4. Sortie (en haut)
- Linéaire (couche linéaire)
- Fonction : Associe la sortie du décodeur au vocabulaire (par ex., prédire que le mot suivant est « you » avec la probabilité la plus élevée).
- Exemple : Avec l'entrée « I love, », le modèle peut produire une probabilité de 80% pour « you » et de 10% pour « eat »...
Idée centrale du Transformer
Mécanisme d'auto-attention
L'idée centrale du Transformer est de s'appuyer entièrement sur le mécanisme d'attention (sans structures récurrentes ni convolutionnelles) pour capturer les dépendances globales dans la séquence d'entrée, permettant ainsi un calcul parallèle efficace et une modélisation plus forte des dépendances à longue portée.
Exemple
def self_attention(query, key, value):
scores = torch.matmul(query, key.transpose(-2, -1)) # Calculer la similarité
weights = torch.softmax(scores, dim=-1) # Convertir en distribution de probabilité
output = torch.matmul(weights, value) # Somme pondérée
return output
Formule :
\[ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
- \(Q\) (requête), \(K\) (clé) et \(V\) (valeur) sont des matrices obtenues par des transformations linéaires de l'entrée.
- \(\sqrt{d_k}\) est un facteur d'échelle qui empêche le produit scalaire d'être trop grand, ce qui provoquerait la disparition du gradient.
Attention multi-têtes
- Exécute le mécanisme d'auto-attention plusieurs fois en parallèle (plusieurs « têtes »), chaque tête apprenant un motif d'attention différent, et concatène finalement les résultats.
- Avantage: Capture des informations contextuelles plus riches (telles que les dépendances locales/globales, les caractéristiques syntaxiques/sémantiques).
Encodage positionnel
- Le Transformer lui-même n'a aucune structure récurrente ou convolutive et ne peut pas percevoir directement l'ordre de la séquence, donc l'information positionnelle doit être injectée explicitement.
- Utiliser des fonctions sinusoïdales/cosinus ou un encodage positionnel apprenable :
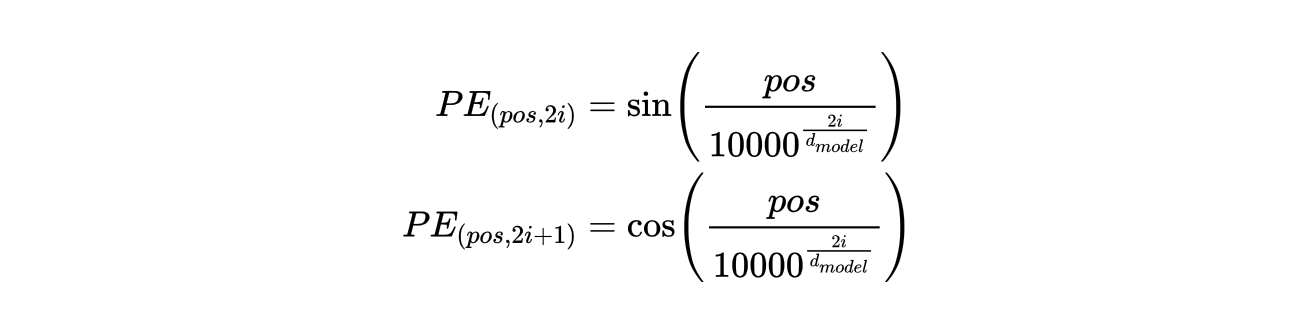
Réseau à propagation avant (FFN)
- La représentation à chaque position est ensuite transformée par un réseau entièrement connecté à deux couches (avec une activation non linéaire, telle que ReLU).
- Formule : \( \text{FFN}(x) = \max(0, xW_1 + b_1)W_2 + b_2 \).
Connexion résiduelle et normalisation de couche
- Connexion résiduelle: ajoute l'entrée directement à la sortie (par exemple, \( x + \text{Sublayer}(x) \)) pour atténuer la disparition du gradient.
- Normalisation de couche: normalise la sortie de chaque couche pour accélérer l'entraînement.
Capacité de traitement parallèle
Contrairement aux RNN/LSTM traditionnels, le Transformer peut traiter toute la séquence en parallèle, ce qui améliore considérablement l'efficacité de l'entraînement.
Modélisation des dépendances globales
Peu importe la distance entre les mots, le Transformer peut établir directement des dépendances entre eux, résolvant ainsi le problème des dépendances à longue portée.
Architecture encodeur-décodeur
Transformer adopte l'architecture classique encodeur-décodeur, mais chaque partie est composée de plusieurs modules identiques empilés.
Encodeur
| Composant | Description de la fonction | Importance |
|---|---|---|
| Attention multi-têtes | Capture des informations sémantiques issues de différents sous-espaces | ★★★★★ |
| Réseau feed-forward | Transformation non linéaire et extraction de caractéristiques | ★★★★ |
| Connexion résiduelle | Atténue le problème de disparition du gradient | ★★★★ |
| Normalisation par couche | Stabilise le processus d'entraînement | ★★★★ |

Décodeur
Le décodeur ajoute les éléments suivants par-dessus l'encodeur :
- Attention multi-têtes masquée : empêche la position actuelle de prêter attention aux informations futures
- Attention encodeur-décodeur : intègre les informations de la langue source
Encodage positionnel
Comme le Transformer n'a pas de structure récurrente, les informations positionnelles doivent être injectées explicitement.
Formule d'encodage positionnel sinusoïdal
La formule est divisée en deux parties, correspondant aux dimensions paires et impaires du vecteur d'encodage positionnel :Dimensions paires (2i),Dimensions impaires (2i+1)。
Description du paramètre :
pos: La position du mot dans la séquence (par exemple, le 1er mot, le 2e mot, etc.).i: L'indice de dimension du vecteur d'encodage positionnel (0 ≤ i < d_model/2)。d_model: La dimension de l'encodage positionnel (généralement identique à la dimension du vecteur de mot, comme 512, 768, etc.).
Caractéristiques de l'encodage positionnel
- Sensibilité à la position relative: Permet d'apprendre les relations positionnelles relatives
- Longueur extensible: Peut traiter des séquences plus longues que celles vues à l'entraînement
- Déterminisme: Aucun apprentissage requis, calculé directement
Exemple
class PositionalEncoding(nn.Module):
def __init__(self, d_model, max_len=5000):
super().__init__()
position = torch.arange(max_len).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model))
pe = torch.zeros(max_len, d_model)
pe[:, 0::2] = torch.sin(position * div_term)
pe[:, 1::2] = torch.cos(position * div_term)
self.register_buffer('pe', pe)
Avantages du Transformer
Comparaison avec les architectures traditionnelles
| Caractéristiques | Transformer | RNN/LSTM | CNN |
|---|---|---|---|
| Parallélisme | Entièrement parallèle | Traitement de séquence | Localement parallèle |
| Dépendances à longue portée | Modélisation directe | Transmission étape par étape | Champ réceptif limité |
| Vitesse d'entraînement | Rapide | Lent | Moyenne |
| Consommation de mémoire | Relativement élevée | Moyenne | Faible |
Avantages de l'application pratique
- Performance exceptionnelle: atteint l'état de l'art sur la plupart des tâches de NLP
- Scalabilité: l'échelle du modèle peut être facilement étendue (par ex. GPT-3)
- Adaptation multimodale: peut être appliquée à divers types de données tels que le texte, les images et la parole
- Compatible avec l'apprentissage par transfert: le paradigme de pré-entraînement + réglage fin est très efficace
Exercices pratiques
Exercice 1 : Implémenter l'auto-attention de base
Exemple
import torch.nn.functional as F
def scaled_dot_product_attention(Q, K, V, mask=None):
d_k = Q.size(-1)
scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(d_k)
if mask is not None:
scores = scores.masked_fill(mask == 0, -1e9)
weights = F.softmax(scores, dim=-1)
return torch.matmul(weights, V)
Exercice 2 : Comprendre l'encodage positionnel
- Visualisez les vecteurs d'encodage positionnel à différentes positions
- Calculez la similarité entre les encodages positionnels et observez les relations positionnelles
Questions fréquentes
Q : Pourquoi le Transformer est-il plus adapté au texte long que le RNN ?R : Un RNN doit transmettre les informations étape par étape, et les dépendances à longue portée sont facilement perdues ; le Transformer, en revanche, peut établir directement des relations entre deux mots quelconques.
Q : Pourquoi la fonction sinus est-elle choisie pour l'encodage positionnel ?R : La fonction sinus est périodique, peut représenter des relations positionnelles relatives et peut être étendue à des longueurs de séquence non vues pendant l'entraînement.
Q : Où se situe le principal goulot d'étranglement computationnel du Transformer ?R : La complexité spatiale du mécanisme d'auto-attention est O(n²), ce qui consomme une grande quantité de mémoire lors du traitement de longues séquences.
Résumé
L'architecture Transformer a fondamentalement transformé la modélisation de séquences grâce au mécanisme d'auto-attention. Ses principaux avantages sont :
- Puissante capacité de calcul parallèle
- Modélisation efficace des dépendances à long terme
- Évolutivité flexible
- Excellentes performances
Maîtriser les fondamentaux de Transformer est une base importante pour apprendre la technologie NLP moderne et est également la clé pour comprendre des modèles de pointe tels que BERT et GPT.
Autres extensions