Analyse de sentiments
L'analyse de sentiments est l'une des tâches les plus classiques et les plus largement appliquées dans le domaine du traitement du langage naturel (NLP). Elle utilise des techniques informatiques pour identifier, extraire et analyser automatiquement les informations subjectives dans un texte, en déterminant si l'attitude de l'auteur envers un sujet, un produit ou un service spécifique est positive, négative ou neutre.
Types de base de l'analyse de sentiment
Classification par granularité d'analyse
- Analyse de sentiment au niveau du document: Détermine la tendance sentimentale de l'ensemble du document
- Analyse de sentiment au niveau de la phrase: Analyse la polarité de sentiment d'une phrase unique
- Analyse de sentiment au niveau des aspects: Effectue des jugements de sentiment sur des aspects spécifiques mentionnés dans le texte
Classification par dimension de sentiment
- Classification binaire: Positif/Négatif
- Classification en trois classes: Positif/Neutre/Négatif
- Classification multiclasse: Classification de sentiment plus fine (comme la colère, la joie, la tristesse, etc.)
- Analyse de l'intensité du sentiment: Quantifie l'intensité du sentiment
Méthode d'analyse de sentiment basée sur un dictionnaire
La méthode basée sur un dictionnaire est la technique d'analyse de sentiment la plus traditionnelle, reposant principalement sur des dictionnaires de sentiment préconstruits.
Composants principaux
Dictionnaire de sentiments: une collection de mots avec polarité et intensité de sentiment
- Dictionnaires anglais courants : SentiWordNet, AFINN, VADER
- Dictionnaires chinois courants : dictionnaire de sentiments HowNet, base de données ontologique du vocabulaire de sentiments de l'Université de technologie de Dalian
Modificateur d'intensité: gère l'influence des adverbes de degré et des mots de négation
- Adverbes de degré : très (1.5), assez (1.3), un peu (0.8), etc.
- Mots de négation : ne pas, non, absolument pas, etc.
Flux de travail de base
Exemple
def lexicon_based_sentiment(text):
sentiment_score = 0
words = tokenize(text) # Segmentation des mots
for word in words:
if word in positive_lexicon:
sentiment_score += positive_lexicon[word]
elif word in negative_lexicon:
sentiment_score -= negative_lexicon[word]
# Gérer la négation et la modification de degré
sentiment_score = apply_negation(words, sentiment_score)
sentiment_score = apply_intensifier(words, sentiment_score)
return normalize(sentiment_score)
Analyse des avantages et des inconvénients
Avantages:
- Aucune donnée d'entraînement requise
- Efficacité computationnelle élevée
- Forte interprétabilité
Inconvénients:
- Difficile de gérer des phénomènes linguistiques complexes (tels que le sarcasme, l'ironie)
- Repose sur la couverture et la qualité du dictionnaire
- Impossible de capturer la sémantique contextuelle
Méthode d'analyse de sentiment basée sur l'apprentissage automatique
Les méthodes d'apprentissage automatique effectuent l'analyse de sentiment en apprenant des motifs à partir de données annotées.
Ingénierie des caractéristiques typique
- Modèle sac de mots (BOW): Représente le texte comme un vecteur de fréquences d'occurrence des mots
- TF-IDF: Considère l'importance des mots dans le document
- Caractéristiques n-grammes: Capture les motifs de séquence de mots locaux
- Caractéristiques de dictionnaire de sentiment: Combine les avantages des méthodes de dictionnaire
Algorithmes courants
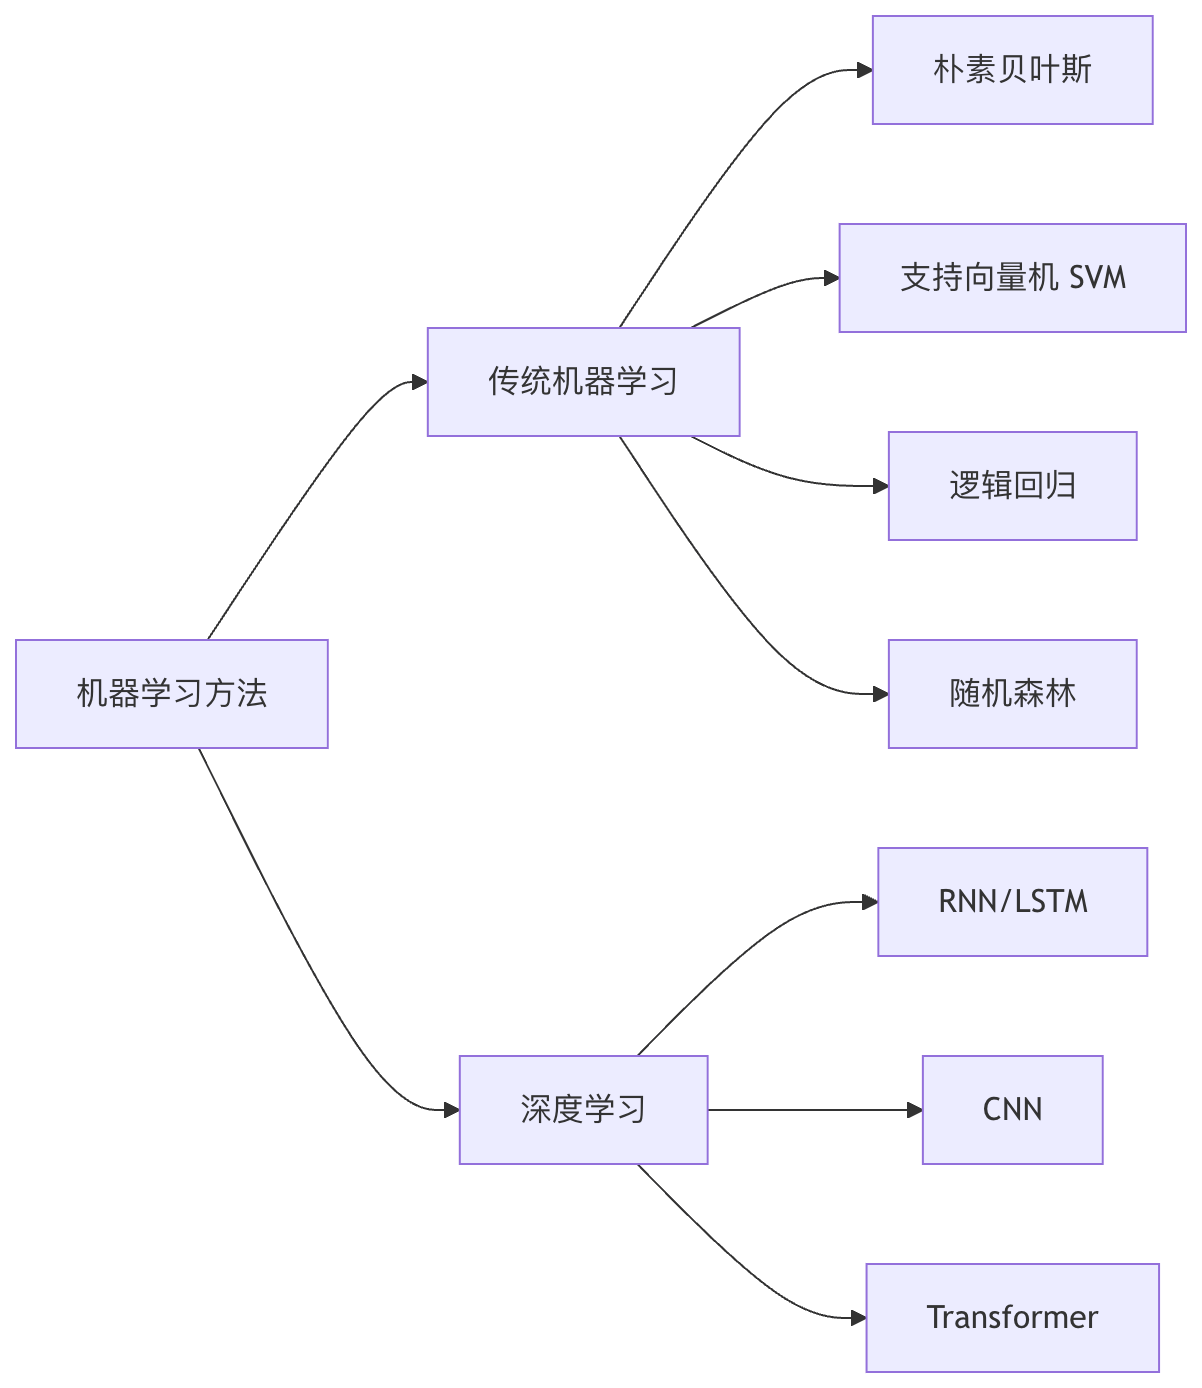
Exemple de code : Classification de sentiment avec Scikit-learn
Exemple
from sklearn.svm import LinearSVC
from sklearn.pipeline import Pipeline
# Construire un pipeline de classification
sentiment_clf = Pipeline([
('tfidf', TfidfVectorizer(ngram_range=(1, 2))),
('clf', LinearSVC())
])
# Entraîner le modèle
sentiment_clf.fit(train_texts, train_labels)
# Prédire un nouveau texte
prediction = sentiment_clf.predict(["Ce produit est extrêmement facile à utiliser, hautement recommandé !"])
print(prediction) # Sortie : 'positive'
Analyse fine des sentiments
L'analyse de sentiment basée sur les aspects (ABSA) est une tâche d'analyse de sentiment plus avancée qui vise à identifier des aspects spécifiques mentionnés dans le texte et leurs sentiments correspondants.
Sous-tâches essentielles de l'ABSA
Extraction d'aspects: identifie les entités ou attributs abordés dans le texte
- Aspect explicite : « L'autonomie de la batterie du téléphone est très bonne » → « batterie »
- Aspect implicite : « Les photos prises sont très claires » → « appareil photo »
Classification de sentiment: effectue des jugements de sentiment pour chaque aspect identifié
Comparaison des méthodes d'implémentation
| Type de méthode | Modèle représentatif | Scénario applicable | Avantages | Inconvénients |
|---|---|---|---|---|
| Méthode par pipeline | Utiliser d'abord CRF pour extraire les aspects, puis un classifieur pour déterminer le sentiment | Scénarios à ressources limitées | Modules clairs, faciles à déboguer | Propagation des erreurs |
| Méthode de bout en bout | BERT-ABSA、AOA-LSTM | Exigences de haute précision | Optimisation conjointe, meilleures performances | Nécessite plus de données |
| Apprentissage multi-tâches | MT-DNN, BERT multi-tâches | Assistance aux tâches connexes | Partage des connaissances | Difficulté d'équilibrage des tâches |
Exemple de code : analyse de sentiment au niveau des aspects basée sur BERT
Exemple
import torch
# Charger le modèle pré-entraîné
model = BertForSequenceClassification.from_pretrained('bert-base-uncased', num_labels=3)
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
# Préparer l'entrée
text = "L'environnement du restaurant est génial, mais le service est trop lent."
aspect = "service"
inputs = tokenizer(f"[CLS] {aspect} [SEP] {text} [SEP]", return_tensors="pt")
# Prédire le sentiment
outputs = model(**inputs)
predictions = torch.argmax(outputs.logits, dim=1)
print(predictions) # Sortie possible : 1 (négatif)
Défis et orientations de développement de l'analyse des sentiments
Principaux défis actuels
- Dépendance au contexte: Un même mot peut avoir des sentiments différents selon le contexte
- Adaptabilité au domaine: Les modèles entraînés dans un domaine sont moins performants dans d'autres domaines
- Traitement multilingue: L'expression des sentiments varie considérablement selon les langues
- Détection du sarcasme et de l'ironie: Cas où le texte littéral est opposé au sentiment réel
Orientations de développement à la pointe
- Analyse multimodale des sentiments: Combine plusieurs types d'informations tels que le texte, les images et la parole
- Analyse des sentiments interlingue: Tire parti des points communs entre les langues pour améliorer les performances sur les langues à faibles ressources
- Extraction des causes de sentiment: détermine non seulement le sentiment, mais analyse également les causes
- Analyse de sentiment personnalisée: prend en compte les caractéristiques personnelles et le comportement historique de l'utilisateur
Exercices pratiques
Exercice 1 : Construction d'un analyseur de sentiment de base
- Implémenter un analyseur de sentiment simple à l'aide du dictionnaire VADER de NLTK
- Tester sa précision sur un jeu de données d'avis de films
Exercice 2 : Comparaison de différentes méthodes d'apprentissage automatique
- Entraîner des classificateurs de sentiment en utilisant respectivement Naive Bayes, SVM et la régression logistique
- Utiliser la validation croisée pour comparer leurs différences de performance
Exercice 3 : Pratique de l'analyse de sentiment au niveau des aspects
- Affiner un modèle BERT pré-entraîné sur le jeu de données d'avis de restaurants SemEval 2014
- Implémenter un système de bout en bout capable d'extraire simultanément les aspects et de déterminer le sentiment
À travers cet article, vous devriez avoir maîtrisé les concepts de base, les principales méthodes et les techniques de mise en œuvre de l'analyse de sentiment. En tant que tâche fondamentale du NLP, la technologie d'analyse de sentiment ne cesse d'évoluer et possède une large valeur dans les applications pratiques, jouant un rôle important de l'analyse des avis produits à la surveillance des médias sociaux.
Autres extensions