Méthodes de représentation de texte
La représentation de texte est une tâche fondamentale du traitement du langage naturel (NLP), qui convertit des données textuelles non structurées en formes numériques que les ordinateurs peuvent traiter.
Cet article présente systématiquement les méthodes de représentation de texte couramment utilisées en NLP, des méthodes traditionnelles aux techniques modernes d'apprentissage profond, aidant les lecteurs à bien comprendre ce concept fondamental.
Représentation textuelle traditionnelle
Modèle de sac de mots
Le modèle de sac de mots est l'une des méthodes de représentation de texte les plus simples ; il traite le texte comme une collection non ordonnée de mots.
Concepts de base
- Ignore l'ordre des mots et la grammaire, se concentre uniquement sur la présence des mots
- Construire un vocabulaire et compter les occurrences de chaque mot dans le document
- La représentation finale est un vecteur creux de grande dimension
Exemple de code
Exemple
corpus = [
'Ceci est le premier document.',
'Ce document est le deuxième document.',
'Et ceci est le troisième.',
'Est-ce le premier document ?'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(vectorizer.get_feature_names_out())
print(X.toarray())
Analyse des avantages et des inconvénients
✅ Avantages :
- Implémentation simple, efficacité de calcul élevée
- Convient aux jeux de données de petite taille et aux tâches simples
❌ Inconvénients :
- Ignore l’ordre des mots et l’information sémantique
- Problème de sparsité en haute dimension
- Ne peut pas gérer les synonymes et les mots polysémiques
TF-IDF
TF-IDF (fréquence du terme - fréquence inverse du document) est une amélioration du modèle de sac de mots qui prend en compte l’importance des mots dans l’ensemble du corpus.
Formule de calcul
- TF (fréquence du terme) :
The number of times a word appears in a document / total number of words in the document - IDF (fréquence inverse du document) :
log(文档总数 / 包含该词的文档数) - TF-IDF = TF × IDF
Implémentation du code
Exemple
tfidf_vectorizer = TfidfVectorizer()
X_tfidf = tfidf_vectorizer.fit_transform(corpus)
print(tfidf_vectorizer.get_feature_names_out())
print(X_tfidf.toarray())
Avantages et inconvénients
✅ Avantages :
- Réduit l'impact des mots courants et met en évidence les mots importants
- Meilleures performances que le modèle simple de sac de mots
❌ Inconvénients :
- Ne peut toujours pas capturer les relations sémantiques
- Le problème de haute dimensionnalité existe toujours
Modèle N-gram
Le modèle N-gram tient compte de l'ordre des mots et représente le texte par des combinaisons de n mots consécutifs.
Types courants
- Unigramme (1-gram): un seul mot
- Bigramme (2-gram): combinaison de deux mots consécutifs
- Trigramme (3-gram): combinaison de trois mots consécutifs
Exemple de code
Exemple
X_bigram = bigram_vectorizer.fit_transform(corpus)
print(bigram_vectorizer.get_feature_names_out())
Avantages et inconvénients
✅ Avantages :
- Capture les informations sur l'ordre local des mots
- Peut représenter des phrases et des collocations figées
❌ Inconvénients :
- Le problème d'explosion de la dimensionnalité est plus grave
- Ne peut toujours pas gérer les dépendances à longue distance
Représentation vectorielle des mots
Principes et mise en œuvre de Word2Vec
Word2Vec est une méthode de représentation vectorielle de mots basée sur un réseau de neurones proposée par Google en 2013.
Deux architectures de modèles
- CBOW(Continuous Bag of Words): prédire le mot courant à partir du contexte
- Skip-gram: prédire le contexte à partir du mot courant
Implémentation du code
Exemple
sentences = [["cat", "say", "meow"], ["dog", "say", "woof"]]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)
# Obtenir les vecteurs de mots
vector = model.wv['cat']
# Trouver des mots similaires
similar_words = model.wv.most_similar('cat')
Fonctionnalités
- Vecteurs denses de faible dimension (généralement 50-300 dimensions)
- Peuvent capturer les relations sémantiques et syntaxiques entre les mots
- Prend en charge les opérations vectorielles (par exemple, roi - homme + femme ≈ reine)
Vecteurs de mots GloVe
GloVe (Global Vectors for Word Representation) combine les avantages des informations statistiques globales et des fenêtres de contexte locales.
Idée centrale
- Basé sur une matrice de co-occurrence de mots
- L’objectif d’optimisation est de rendre le produit scalaire de deux vecteurs de mots égal au logarithme de leur nombre de co-occurrences
Comparaison avec Word2Vec
| Fonctionnalité | Word2Vec | GloVe |
|---|---|---|
| Méthode d’entraînement | Fenêtre locale | Statistiques globales |
| Efficacité de calcul | Relativement élevée | Relativement faible |
| Performance sur les petits ensembles de données | Meilleur | Moyenne |
| Performance sur les grands ensembles de données | OK | Meilleur |
FastText
FastText est un modèle de vecteurs de mots développé par Facebook, caractérisé par la prise en compte d'informations sur les sous-mots.
Fonctionnalités principales
- Représente les mots comme un ensemble de n-grammes de caractères
- Peut gérer les mots hors vocabulaire (OOV)
- Particulièrement adapté aux langues à morphologie riche
Exemple de code
Exemple
model = FastText(sentences, vector_size=100, window=5, min_count=1, workers=4)
# Même les mots qui ne sont pas dans le dictionnaire peuvent obtenir des vecteurs
vector = model.wv['unseenword']
Représentations sensibles au contexte
Modèle ELMo
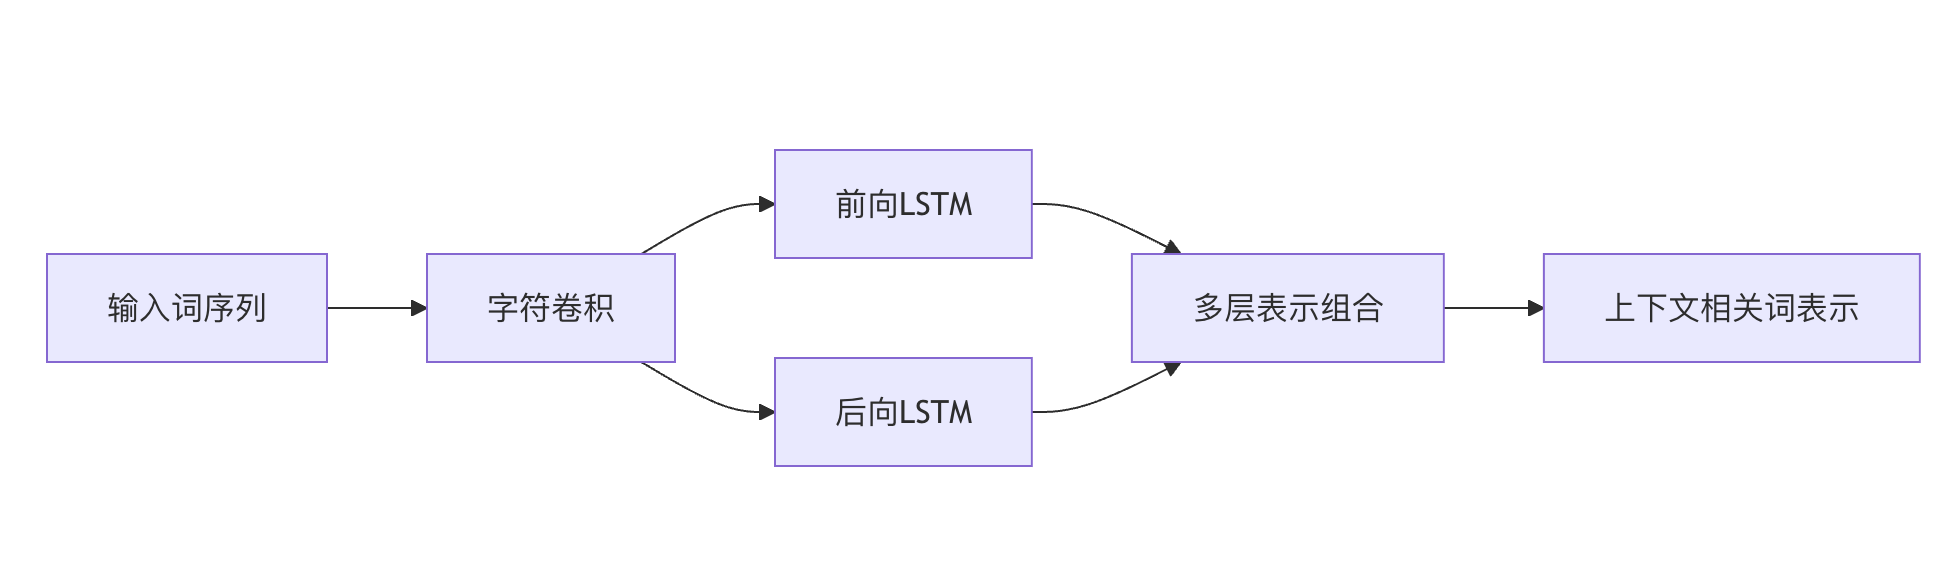
ELMo (Embeddings from Language Models) est l'une des premières méthodes de représentation de mots dépendantes du contexte.
Fonctionnalités principales
- Fondé sur des modèles de langue LSTM bidirectionnels
- La représentation d’un mot dépend de l’intégralité de la phrase d’entrée
- Génère des représentations multicouches (peut combiner la sémantique à différents niveaux)
Diagramme de l’architecture
BERT et ses variantes
BERT (Bidirectional Encoder Representations from Transformers) est un modèle de langue pré-entraîné proposé par Google.
Innovations clés
- Architecture Transformer
- Objectif d’entraînement du modèle de langue masqué (MLM)
- Tâche de prédiction de la phrase suivante (NSP)
Variantes courantes
- RoBERTa: stratégie d’entraînement optimisée
- DistilBERT: version allégée de BERT
- ALBERT: le partage de paramètres réduit la taille du modèle
Exemple de code
Exemple
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
model = BertModel.from_pretrained('bert-base-uncased')
inputs = tokenizer("Bonjour, mon chien est mignon", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
Aperçu des modèles de langage pré-entraînés
Le TAL moderne utilise principalement le paradigme pré-entraînement + fine-tuning :
- Étape de pré-entraînement: entraîner des représentations linguistiques générales sur des corpus à grande échelle
- Étape de fine-tuning: ajuster les paramètres du modèle sur des données spécifiques à la tâche
Comparaison des modèles
| Modèle | Date de sortie | Fonctionnalités principales |
|---|---|---|
| Word2Vec | 2013 | Vecteurs de mots statiques |
| GloVe | 2014 | Statistiques globales + fenêtre locale |
| ELMo | 2018 | LSTM bidirectionnel, dépendant du contexte |
| BERT | 2018 | Transformer, contexte bidirectionnel |
| GPT-3 | 2020 | Transformer unidirectionnel, forte capacité de génération |
Représentations au niveau du document
Doc2Vec
Doc2Vec est une extension de Word2Vec qui peut apprendre directement des représentations vectorielles de documents.
Deux modèles
- PV-DM(Distributed Memory): similaire à CBOW, ajoute l'ID du document
- PV-DBOW(Distributed Bag of Words): similaire à Skip-gram
Exemple de code
Exemple
from gensim.models.doc2vec import TaggedDocument
documents = [TaggedDocument(doc, [i]) for i, doc in enumerate(corpus)]
model = Doc2Vec(documents, vector_size=100, window=5, min_count=1, workers=4)
vector = model.infer_vector(["new", "document", "text"])
Vecteurs de phrases et vecteurs de documents
Méthodes courantes
- Moyenne: faire la moyenne des vecteurs de mots
- SIF: moyenne pondérée par fréquence inverse lissée
- Vecteurs de phrases BERT: utiliser le token [CLS] ou faire la moyenne de tous les vecteurs de mots
Exemple de code (avec Sentence-BERT)
Exemple
model = SentenceTransformer('all-MiniLM-L6-v2')
sentences = ["This is an example sentence", "Each sentence is converted"]
embeddings = model.encode(sentences)
Modèle de sujets (LDA)
L'allocation Dirichlet latente (LDA) est une méthode de modélisation de sujets non supervisée.
Principes de base
- Représente un document comme un mélange de plusieurs sujets
- Chaque thème est une distribution de probabilité sur les mots
- Appris par inférence variationnelle ou échantillonnage de Gibbs
Exemple de code
Exemple
from sklearn.feature_extraction.text import CountVectorizer
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
lda = LatentDirichletAllocation(n_components=2)
lda.fit(X)
Scénarios d'application
- Regroupement de documents
- Recommandation de contenu
- Résumé de texte
Résumé
Le développement des méthodes de représentation de texte est passé de simples statistiques à l'apprentissage profond :
- Méthodes traditionnelles: Simples et efficaces, adaptées aux données à petite échelle
- Vecteurs de mots: Capturent les relations sémantiques, faible dimensionnalité
- Modèles sensibles au contexte: Représentation dynamique, meilleures performances mais coût de calcul élevé
- Représentation de document: passe du niveau du mot au niveau du document
Lors du choix des méthodes de représentation de texte, tenez compte de :
- Exigences de la tâche (si une compréhension sémantique est nécessaire)
- Échelle des données
- Ressources de calcul
- Caractéristiques de la langue
Avec le développement des grands modèles de langage, les techniques de représentation de texte évoluent encore rapidement, mais comprendre ces méthodes fondamentales reste crucial pour maîtriser le NLP.
Autres extensions