Écosystème Python pour le NLP
Le traitement du langage naturel (NLP) est une branche importante de l'intelligence artificielle. Grâce à son riche écosystème de bibliothèques, Python est devenu le langage privilégié pour le développement en NLP.
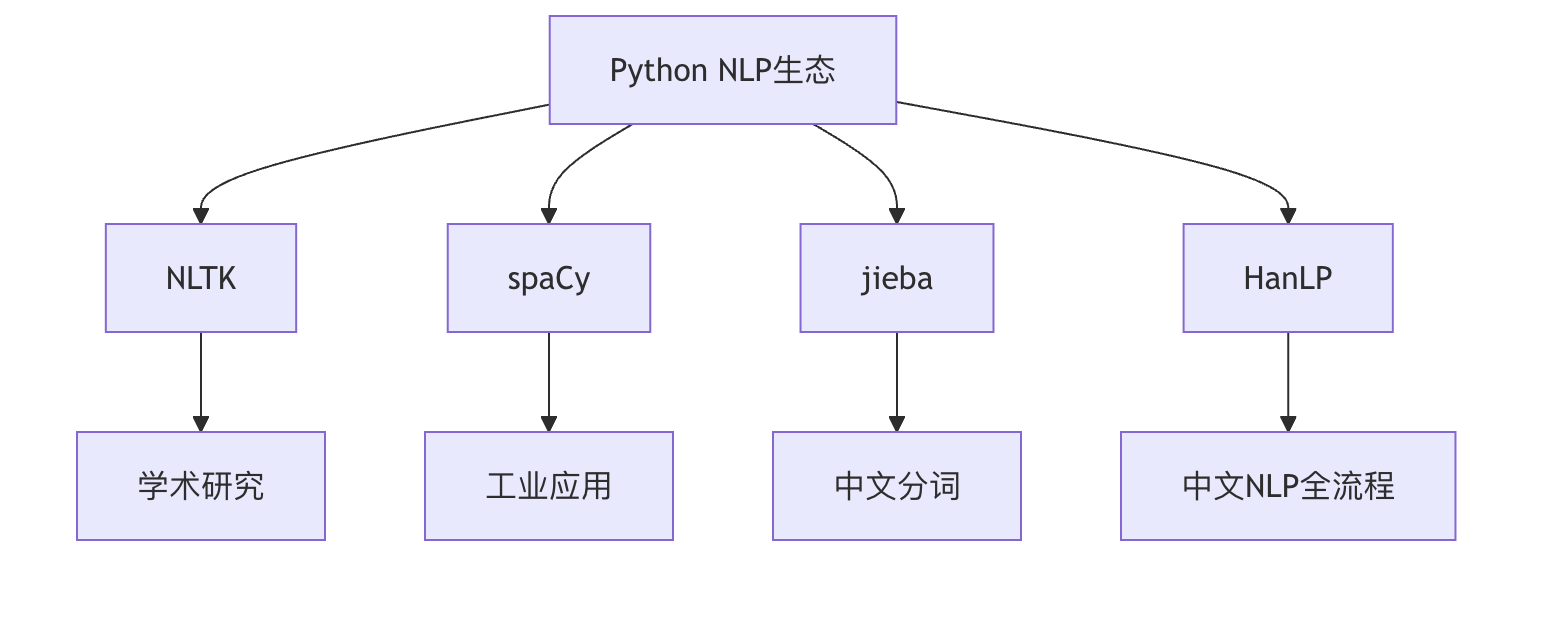
Cet article propose une introduction complète aux principales boîtes à outils de l'écosystème Python pour le NLP, notamment :
- NLTK- La boîte à outils de traitement du langage naturel privilégiée pour la recherche universitaire
- spaCy- Un framework NLP efficace de niveau industriel
- jieba- L'outil de segmentation de mots chinois le plus populaire
- HanLP- Une bibliothèque de traitement NLP chinois aux fonctionnalités complètes
NLTK : Le couteau suisse du traitement du langage naturel
Introduction de base
NLTK (Natural Language Toolkit) est l'une des bibliothèques Python de traitement du langage naturel les plus connues. Développé par l'Université de Pennsylvanie, il est particulièrement adapté à l'enseignement et à la recherche.
Fonctionnalités principales
- Tokenisation de texte
- Étiquetage morphosyntaxique (POS Tagging)
- Reconnaissance d'entités nommées (NER)
- Analyse de sentiments
- Racinisation et lemmatisation
Installation et utilisation de base
Exemple
nltk.download('punkt') # Télécharger les paquets de données nécessaires
# Exemple : Tokenisation de texte
from nltk.tokenize import word_tokenize
text = "Natural language processing is fascinating."
tokens = word_tokenize(text)
print(tokens) # Sortie : ['Natural', 'language', 'processing', 'is', 'fascinating', '.']
Analyse des avantages et des inconvénients
| Avantages | Inconvénients |
|---|---|
| Fonctionnalités complètes couvrant les principales tâches de TAL | Efficacité d'exécution plus faible |
| Bien documenté avec d'abondantes ressources d'apprentissage | Nécessite le téléchargement de paquets de données supplémentaires |
| Adapté à l'enseignement et à la recherche | Prise en charge limitée du chinois |
spaCy : framework TAL de qualité industrielle
Introduction de base
spaCy est une bibliothèque TAL moderne axée sur les applications industrielles, réputée pour son efficacité et sa facilité d'utilisation.
Fonctionnalités principales
- Prise en charge de modèles pré-entraînés
- Mécanisme de traitement basé sur un pipeline
- Implémentation de réseaux de neurones à haute performance
- Prise en charge multilingue (y compris le chinois)
Installation et utilisation de base
Exemple
# Installer le modèle chinois : python -m spacy download zh_core_web_sm
import spacy
# Charger le modèle anglais
nlp = spacy.load("en_core_web_sm")
doc = nlp("Apple is looking at buying U.K. startup for $1 billion")
# Extraire les entités nommées
for ent in doc.ents:
print(ent.text, ent.label_)
# Sortie : Apple ORG
# U.K. GPE
# $1 billion MONEY
Comparaison des performances
Exemple
title Comparaison de la vitesse de traitement des bibliothèques NLP (mots/seconde)
x-axis Bibliothèque
y-axis Vitesse
bar NLTK: 10,000
barre spaCy : 100,000
jieba : un outil puissant pour la segmentation des mots chinois
Introduction de base
jieba est un outil de segmentation de mots spécialement conçu pour le chinois, réputé pour sa facilité d'utilisation, son efficacité et sa précision.
Trois modes de segmentation de mots
- Mode précis: Le résultat de segmentation le plus précis
- Mode complet: Analyse toutes les formations de mots possibles
- Mode moteur de recherche: Segmente davantage les mots longs
Exemples d'utilisation de base
Exemple
# Tokenisation en mode précis
seg_list = jieba.cut("I love natural language processing", cut_all=False)
print("Mode précis : " + "/".join(seg_list))
# Sortie : Mode précis : I/love/natural language/processing
# Ajouter un dictionnaire personnalisé
jieba.load_userdict("userdict.txt") # Fichier de dictionnaire personnalisé
Fonctionnalités avancées
- Extraction de mots-clés
- Étiquetage morphosyntaxique
- Segmentation parallèle (améliore la vitesse de traitement pour les grands textes)
HanLP : Solution NLP chinoise tout-en-un
Introduction de base
HanLP est une boîte à outils NLP composée d'une série de modèles et d'algorithmes, dans le but de promouvoir l'application du traitement du langage naturel dans les environnements de production.
Fonctionnalités et caractéristiques
- Prend en charge plusieurs modes de segmentation
- Reconnaissance d'entités nommées
- Analyse de dépendances
- Classification de texte
- Analyse de sentiments
Exemples d'utilisation de base
Exemple
# Exemple de segmentation en mots
print(HanLP.segment('Bonjour, bienvenue sur HanLP !'))
# Sortie : [hello/vl, ,/w, welcome/v, use/v, HanLP/nx, !/w]
# Analyse syntaxique des dépendances
sentence = HanLP.parseDependency("J'aime le traitement du langage naturel")
print(sentence)
Prise en charge multilingue
HanLP prend en charge non seulement le chinois, mais aussi :
- Anglais
- Japonais
- Coréen
- et de nombreuses autres langues
Guide de sélection des outils
Comparaison des scénarios d'application
| Outil | Cas d'utilisation les plus adaptés | Prise en charge du chinois | Courbe d'apprentissage |
|---|---|---|---|
| NLTK | Recherche académique, enseignement | Limité | Modéré |
| spaCy | Applications industrielles, environnements de production | Bon | Gentle |
| jieba | Tâches de segmentation de mots chinois | Excellent | Simple |
| HanLP | Tâches complexes de NLP en chinois | Excellent | Plus abrupte |
Considérations de performance
- Vitesse de traitement:spaCy > jieba > HanLP > NLTK
- Utilisation de la mémoire:HanLP > spaCy > NLTK > jieba
- Précision(chinois): HanLP ≈ jieba > spaCy > NLTK
Cas pratique complet : pipeline d'analyse de texte chinois
Exemple
import jieba
from hanlp import HanLP
import spacy
text = "Le traitement du langage naturel est une branche importante de l'intelligence artificielle et s'est développé rapidement ces dernières années."
# 1. Utiliser jieba pour la segmentation des mots
words = list(jieba.cut(text))
print("résultat de la tokenisation :", words)
# 2. Utiliser HanLP pour l'étiquetage morphosyntaxique
print("\nÉtiquetage morphosyntaxique :")
print(HanLP.segment(text))
# 3. Utiliser le modèle anglais de spaCy pour traiter la partie anglaise
nlp = spacy.load("en_core_web_sm")
doc = nlp("Le traitement du langage naturel est incroyable.")
print("\nReconnaissance d'entités en anglais :")
for ent in doc.ents:
print(ent.text, ent.label_)
Ressources d'apprentissage recommandées
Documentation officielle
- NLTK: https://www.nltk.org/
- spaCy: https://spacy.io/
- jieba: https://github.com/fxsjy/jieba
- HanLP: https://hanlp.hankcs.com/
Résumé et perspectives
L'écosystème Python du TAL fournit une chaîne d'outils complète allant de la recherche académique aux applications industrielles. Pour le traitement de texte chinois, jieba et HanLP sont des outils indispensables, tandis que spaCy excelle dans la prise en charge multilingue et le déploiement industriel. Le développement futur du TAL mettra davantage l'accent sur :
- Application de modèles de langage pré-entraînés (tels que BERT, GPT)
- Capacités de traitement multimodal
- Prise en charge des langues peu dotées
- Interprétabilité et équité