Cálculo de similitud de texto en NLP
El cálculo de similitud de texto es una tarea fundamental en el Procesamiento del Lenguaje Natural (PLN/NLP), cuyo objetivo es cuantificar el grado de similitud entre dos fragmentos de texto. Esta tecnología tiene aplicaciones amplias en múltiples campos como la recuperación de información, los sistemas de preguntas y respuestas, la detección de plagio y los sistemas de recomendación.
Conceptos clave
- Similitud semántica: mide el grado de cercanía en el significado del texto
- Similitud literal: mide el grado de superposición en el vocabulario superficial del texto
- Modelo de espacio vectorial: representa el texto como vectores en un espacio de alta dimensión
- Medida de distancia: calcula la distancia o similitud entre vectores
Métodos comunes de cálculo de similitud de texto
1. Métodos basados en frecuencia de palabras
Modelo de bolsa de palabras (Bag of Words)
Ejemplo
from sklearn.feature_extraction.text import CountVectorizer
corpus = [
'Me gusta el procesamiento del lenguaje natural',
'Me encanta aprender tecnología NLP',
'El cálculo de similitud de texto es muy interesante'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
corpus = [
'Me gusta el procesamiento del lenguaje natural',
'Me encanta aprender tecnología NLP',
'El cálculo de similitud de texto es muy interesante'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
Método TF-IDF
Ejemplo
from sklearn.feature_extraction.text import TfidfVectorizer
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
2. Métodos basados en vectores de palabras
Similitud con Word2Vec
Ejemplo
from gensim.models import Word2Vec
sentences = [
['yo','gusta','procesamiento del lenguaje natural'],
['yo','encanta','aprender','NLP','tecnología'],
['texto','similitud','cálculo','muy','interesante']
]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)
vector = model.wv['procesamiento del lenguaje natural'] # Obtener vectores de palabras
Cálculo de vectores de oraciones
Ejemplo
import numpy as np
def sentence_vector(sentence, model):
vectors = [model.wv[word] for word in sentence if word in model.wv]
return np.mean(vectors, axis=0) if vectors else np.zeros(model.vector_size)
sentence_vec1 = sentence_vector(['yo','gusta','procesamiento del lenguaje natural'], model)
sentence_vec2 = sentence_vector(['yo','encanta','NLP'], model)
3. Métodos basados en modelos preentrenados
Cálculo de similitud con BERT
Ejemplo
from transformers import BertTokenizer, BertModel
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("Esta es una oración de ejemplo", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("Esta es una oración de ejemplo", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
Métricas de similitud
Métodos comunes de medición de distancia
| Nombre del método | Fórmula | Características |
|---|---|---|
| Similitud coseno | cos(θ) = (A·B)/(|A||B|) | Ignora la magnitud del vector, se centra en la dirección |
| Distancia euclidiana | √Σ(Ai-Bi)² | Considera la posición absoluta de los vectores |
| Distancia de Manhattan | Σ|Ai-Bi| | Insensible a valores atípicos |
| Similitud de Jaccard | |A∩B|/|A∪B| | Adecuada para similitud de conjuntos |
Ejemplo de implementación de código
Ejemplo
from sklearn.metrics.pairwise import cosine_similarity
# Calcular la similitud coseno
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"Similitud de texto: {similarity)
# Calcular la similitud coseno
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"Similitud de texto: {similarity)
Ejemplo de aplicación práctica
Detección de similitud en titulares de noticias
Ejemplo
import pandas as pd
from sklearn.metrics.pairwise import cosine_similarity
# Datos de ejemplo
titles = [
"Apple lanza el nuevo iPhone",
"Apple presenta el teléfono inteligente más reciente",
"Microsoft publica resultados trimestrales",
"Google anuncia un nuevo plan de inteligencia artificial"
]
# Calcular la matriz de similitud
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(titles)
similarities = cosine_similarity(tfidf_matrix)
# Mostrar resultados
df = pd.DataFrame(similarities, columns=titles, index=titles)
print(df)
Análisis de resultados
                         苹果发布新款iPhone手机  苹果公司推出最新智能手机  微软公布季度财报  谷歌宣布新的人工智能计划
苹果发布新款iPhone手机           1.000000         0.723417     0.000000         0.000000
苹果公司推出最新智能手机         0.723417         1.000000     0.000000         0.000000
微软公布季度财报               0.000000         0.000000     1.000000         0.204598
谷歌宣布新的人工智能计划         0.000000         0.000000     0.204598         1.000000
Técnicas avanzadas y desafíos
1. Manejo de textos semánticamente similares pero con vocabulario diferente
Ejemplo
text1 = "Me gustan los gatos"
text2 = "Odio a los perros"
# La similitud superficial es baja, pero semánticamente ambas expresan una actitud hacia los animales
text2 = "Odio a los perros"
# La similitud superficial es baja, pero semánticamente ambas expresan una actitud hacia los animales
2. Resolución del problema de la polisemia
Ejemplo
# 'Manzana' puede referirse a la fruta o a la empresa
text1 = "La manzana es muy dulce"
text2 = "La capitalización de mercado de Apple alcanza un nuevo máximo"
text1 = "La manzana es muy dulce"
text2 = "La capitalización de mercado de Apple alcanza un nuevo máximo"
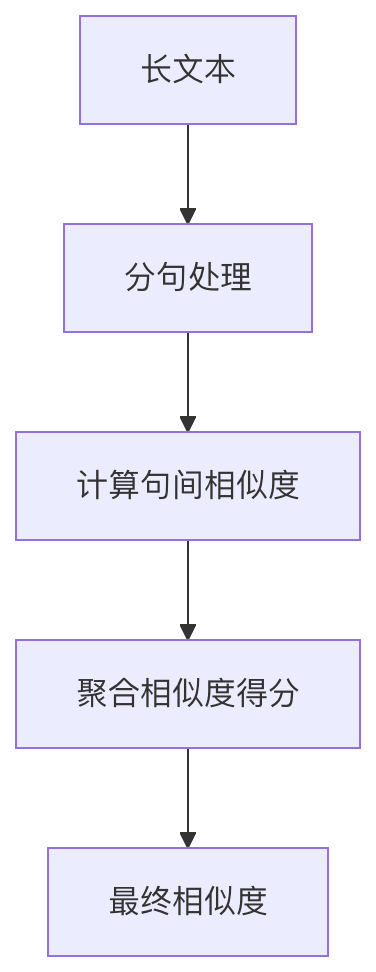
3. Cálculo de similitud en textos largos
Recomendaciones de mejores prácticas
El preprocesamiento de datos es muy importante
- Unificar mayúsculas y minúsculas
- Eliminar palabras vacías (stopwords)
- Derivación (stemming) / Lematización
Elegir el método según el escenario
- Textos cortos: modelos preentrenados como BERT
- Documentos largos: TF-IDF + similitud coseno
- Sistemas en tiempo real: modelos ligeros como Word2Vec
Considerar la eficiencia computacional
- Para datos a gran escala, usar algoritmos de vecinos más cercanos aproximados (ANN)
- Considerar el uso de bibliotecas eficientes de búsqueda de similitud como Faiss
Evaluación y optimización continuas
- Crear un conjunto de evaluación manual
- Monitorear el rendimiento en producción
- Actualizar los modelos periódicamente