Modelos preentrenados multimodales
Los modelos preentrenados multimodales (Multimodal Pre-trained Models) se refieren a modelos de aprendizaje profundo capaces de procesar y comprender simultáneamentemúltiples modalidades de datos(como texto, imagen, audio, etc.). A diferencia de los modelos unimodales tradicionales, estos modelos aprenden las relaciones y correspondencias entre diferentes modalidades mediante el preentrenamiento a gran escala.
Ventajas principales del aprendizaje multimodal
- Información complementaria: diferentes modalidades pueden proporcionar información complementaria (por ejemplo, la imagen proporciona información visual, el texto proporciona información semántica)
- Robustez mejorada: cuando una modalidad de datos falta o es de mala calidad, otras modalidades pueden brindar soporte
- Ampliación de escenarios de aplicación: admite tareas multimodales más ricas (como recuperación de imagen-texto, generación de descripciones de imágenes, etc.)
CLIP: un hito en el aprendizaje contrastivo de imagen-texto
Conceptos básicos
CLIP (Contrastive Language-Image Pre-training) es un modelo multimodal propuesto por OpenAI en 2021 que establece la asociación entre imágenes y texto mediante el aprendizaje contrastivo.
CLIP consta de dos componentes principales:
- Codificador de imágenes (Image Encoder): convierte las imágenes en vectores de características (por ejemplo, usando Vision Transformer o ResNet).
- Codificador de texto (Text Encoder): convierte las descripciones de texto en vectores de características (por ejemplo, usando Transformer).
Flujo de trabajo:
- Entrada:
- Pares de imagen y texto (por ejemplo, la foto de un perro + la descripción "a photo of a dog").
- Codificación:
- El codificador de imágenes extrae las características de la imagen, y el codificador de texto extrae las características del texto.
- Aprendizaje contrastivo:
- Se calcula la matriz de similitud de todos los pares imagen-texto, y se optimiza el modelo mediante una función de pérdida (como InfoNCE) para que las características de los pares coincidentes se acerquen y las de los pares no coincidentes se alejen.
Los vectores de características de salida de ambos se mapean al mismo espacio semántico, alineando las representaciones de imagen y texto mediante el aprendizaje contrastivo.
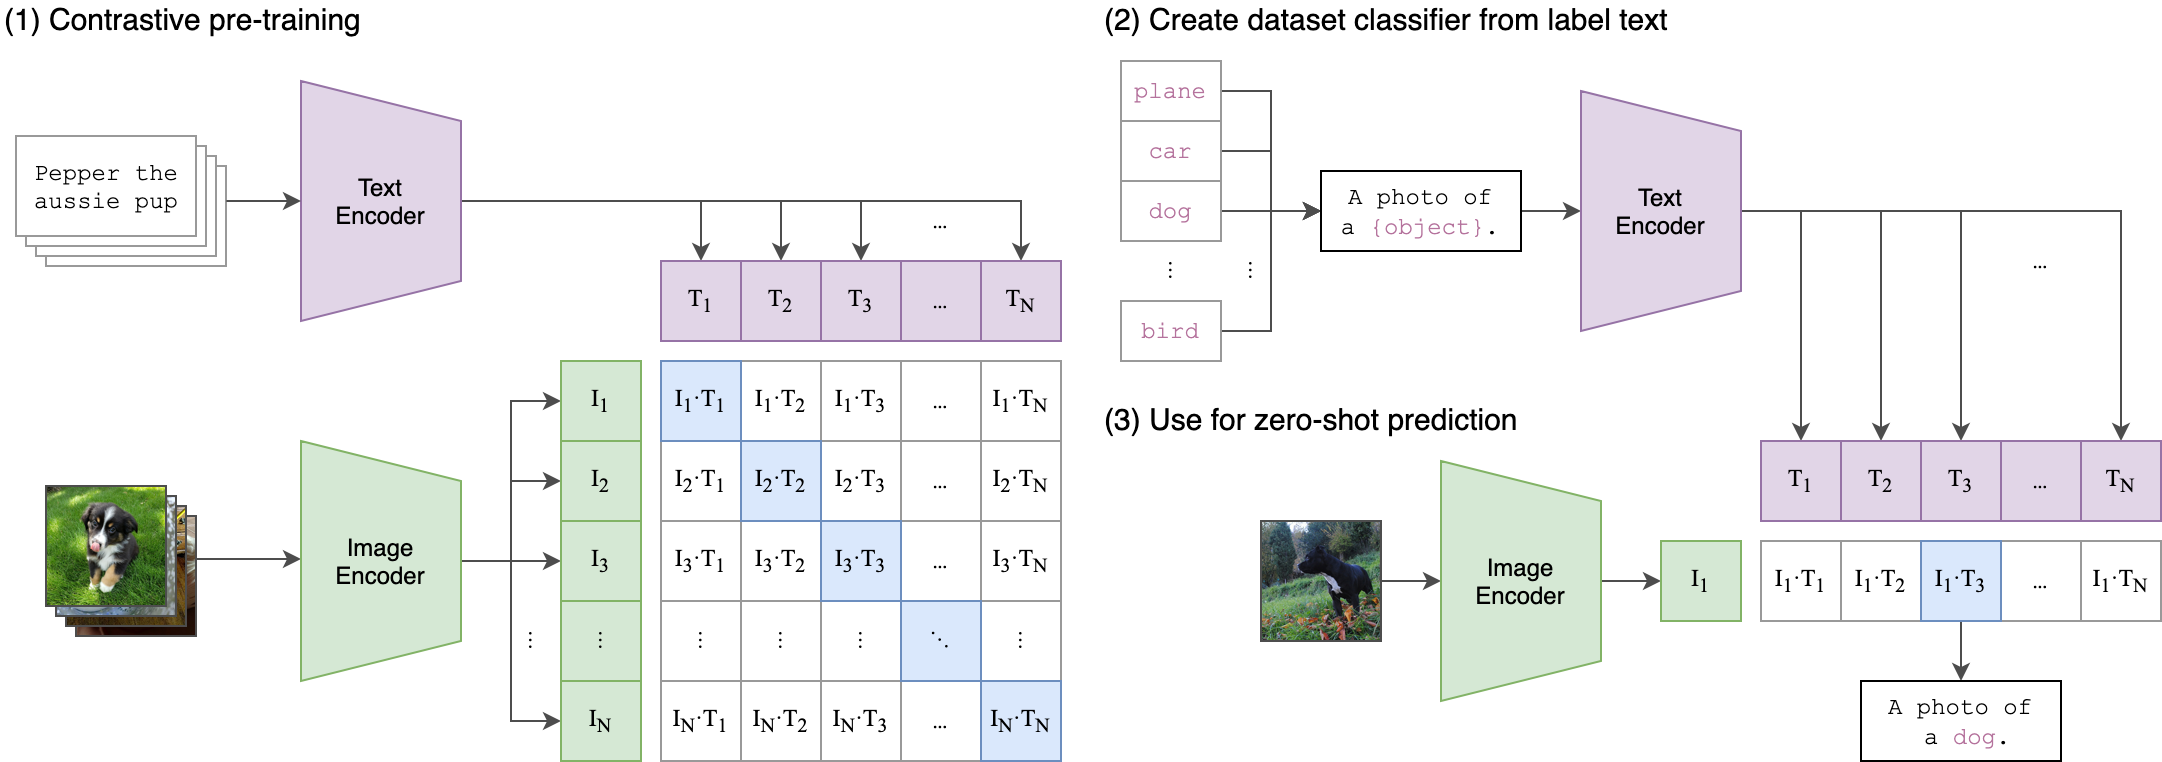
Explicación de las partes clave de la figura
Parte de la tabla: matriz de aprendizaje contrastivo
La tabla muestra el cálculo de similitud de los pares imagen-texto (suponiendo que hayNtextos y4imágenes):
- Filas (imágenes):
I1, I2, I3, I4Representan las características de diferentes imágenes. - Columnas (texto):
T1, T2, ..., TNRepresentan las características de diferentes textos. - Valores de las celdas(por ejemplo,
I1-T1): la imagenI1y el textoT1tienen una similitud de coseno entre sus vectores de características.
Objetivo:
Maximizar la similitud en la diagonal (pares correctos, comoI1-T1), y minimizar la similitud fuera de la diagonal (pares incorrectos, comoI1-T2). Esta es la idea central del aprendizaje contrastivo.
Parte de ejemplo
- Ejemplos de imagen:
- "Pepper the aussie pup" (foto de un perro pastor australiano).
- "Planer car dog" (posiblemente ruido o etiquetado incorrecto; en realidad debería ser el texto de plantilla "A photo of a (object)").
- Plantilla de texto:
- "A photo of a (object)" es una plantilla de aviso de texto comúnmente utilizada en el preentrenamiento de CLIP para generalizar diferentes categorías (por ejemplo, "a photo of a dog").
Arquitectura del modelo
- Estructura de doble codificador:
- Codificador de imágenes: comúnmente se usa Vision Transformer (ViT) o ResNet
- Codificador de texto: basado en la arquitectura Transformer
- Objetivo del aprendizaje contrastivo:
- Los pares de muestras positivas (pares imagen-texto coincidentes) se acercan en el espacio de características
- Los pares de muestras negativas (pares imagen-texto no coincidentes) se alejan en el espacio de características
Proceso de entrenamiento
Ejemplo
image_features = image_encoder(image_batch) # Extracción de características de la imagen
text_features = text_encoder(text_batch) # Extracción de características del texto
# Cálculo de la matriz de similitud
logits = torch.matmul(image_features, text_features.T) * temperature
labels = torch.arange(batch_size) # La diagonal son las muestras positivas
# Pérdida contrastiva simétrica
loss_img = cross_entropy(logits, labels)
loss_txt = cross_entropy(logits.T, labels)
total_loss = (loss_img + loss_txt)/2
Escenarios de aplicación
- Clasificación de imágenes zero-shot: permite clasificar nuevas categorías sin ajuste fino (fine-tuning)
- Recuperación de imagen-texto: permite una búsqueda eficiente de texto a imagen o de imagen a texto
- Moderación de contenido: identifica contenido de imagen que no coincide con la descripción textual
DALL-E: la magia de la generación de texto a imagen
Conceptos básicos
DALL-E es un modelo de generación de texto a imagen desarrollado por OpenAI, capaz de generar imágenes de alta calidad a partir de descripciones en lenguaje natural.
Características técnicas
Entrenamiento en dos etapas:
- Primera etapa: el autoencoder variacional discreto (dVAE) comprime la imagen en tokens visuales.
- Segunda etapa: un Transformer autorregresivo aprende el mapeo de texto a tokens visuales.
Innovaciones clave:
- Considera la generación de imágenes como un problema de predicción de secuencias.
- Utiliza un modelo Transformer con 12 mil millones de parámetros.
Ejemplo del proceso de generación
Ejemplo
text = "Un shiba inu con traje espacial jugando un videojuego en una estación espacial"
text_tokens = tokenizer(text) # Codificación del texto
image_tokens = transformer.generate(text_tokens) # Generación de tokens visuales
image = dvae.decode(image_tokens) # Decodificación en imagen
Evolución del modelo
| Versión | Principales mejoras | Capacidad de generación |
|---|---|---|
| DALL-E 1 | Arquitectura base | Resolución 256x256 |
| DALL-E 2 | Modelo de difusión | Resolución 1024x1024, más preciso |
| DALL-E 3 | Integración con ChatGPT | Comprensión de avisos más compleja |
Otros modelos multimodales importantes
ALIGN(Google)
- Entrenados con datos de red con alto nivel de ruido
- Demostró la efectividad de los datos débilmente supervisados a gran escala
Flamingo(DeepMind)
- Procesa secuencias multimodales intercaladas (como alternancia de imagen y texto)
- Admite aprendizaje con pocas muestras (few-shot learning)
BEiT-3(Microsoft)
- Marco unificado de preentrenamiento multimodal
- Rendimiento sobresaliente en tareas de imagen, texto y lenguaje visual
Desafíos de aplicación de los modelos multimodales
- Requisitos de datos: se necesitan enormes cantidades de datos multimodales alineados de alta calidad
- Costo computacional: entrenar estos modelos requiere enormes recursos computacionales
- Dificultad de evaluación: falta un estándar unificado de evaluación para tareas multimodales
- Problema de sesgo: puede amplificar los sesgos sociales presentes en los datos de entrenamiento
Ejercicio práctico: clasificación zero-shot con CLIP
Ejemplo
import torch
from PIL import Image
# Cargar el modelo y el preprocesamiento
device = "cuda" if torch.cuda.is_available() else "cpu"
model, preprocess = clip.load("ViT-B/32", device=device)
# Preparar la entrada
image = preprocess(Image.open("dog.jpg")).unsqueeze(0).to(device)
text_inputs = clip.tokenize(["a dog", "a cat", "a bird"]).to(device)
# Calcular las características
with torch.no_grad():
image_features = model.encode_image(image)
text_features = model.encode_text(text_inputs)
# Calcular la similitud
logits = (image_features @ text_features.T).softmax(dim=-1)
print("Probabilidad de predicción:", logits.cpu().numpy())
Direcciones de desarrollo futuro
- Arquitecturas más eficientes: reducir el costo computacional y aumentar la velocidad de inferencia
- Fusión de más modalidades: incorporar más modalidades como audio, video, etc.
- Capacidad de comprensión causal: mejorar la comprensión profunda del contenido multimodal por parte del modelo
- Generación controlable: mejorar el control preciso y la editabilidad del contenido generado
Los modelos preentrenados multimodales están remodelando la interacción humano-computadora. Desde la comprensión multimodal de CLIP hasta la generación creativa de DALL-E, estas tecnologías abren posibilidades completamente nuevas para las aplicaciones de IA.
Otras extensiones