Red neuronal recurrente (RNN)
Una red neuronal recurrente (Recurrent Neural Network, RNN) es un tipo de red neuronal diseñada específicamente para procesar datos secuenciales (como texto, voz y series temporales).
A diferencia de las redes neuronales feedforward tradicionales, la RNN tiene capacidad de "memoria" y puede conservar información de pasos anteriores.
La red neuronal recurrente utiliza el estado oculto (Hidden State) del paso anterior para influir en la salida del paso actual, capturando así las dependencias temporales de la secuencia.
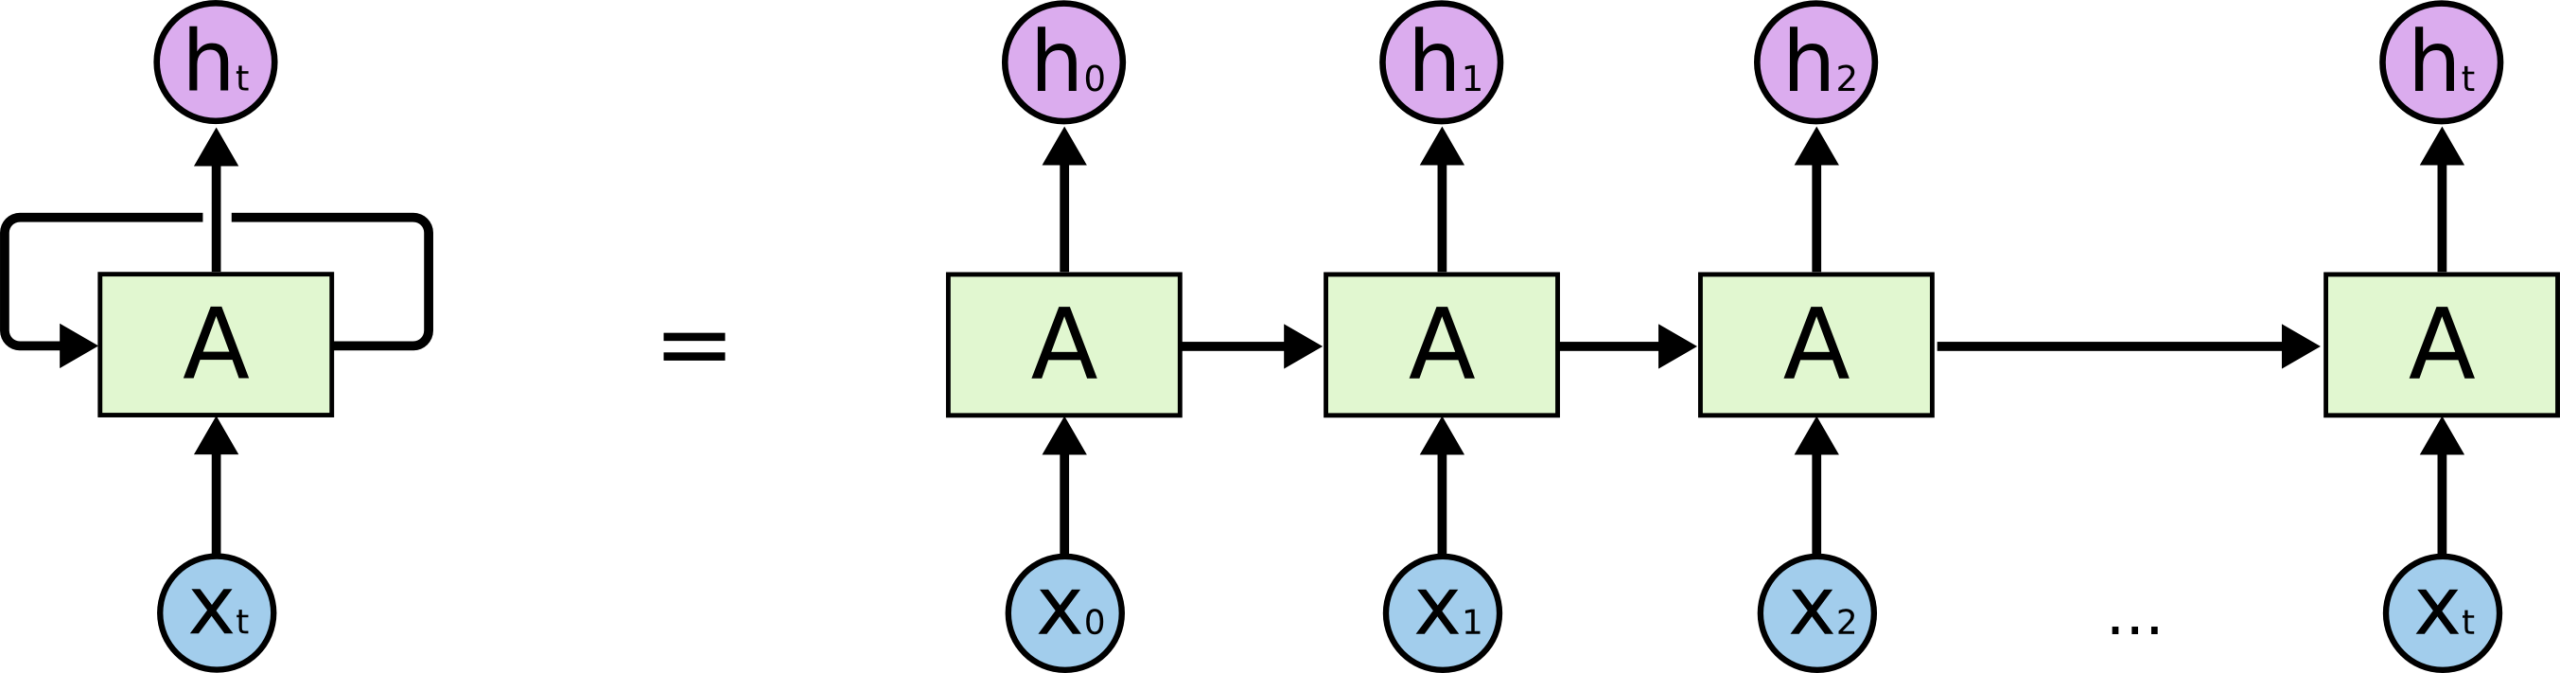
Idea central de RNN
Conexión recurrente(Recurrent Connection), es decir, la salida de la red no solo depende de la entrada actual, sino también de las entradas de todos los pasos de tiempo anteriores. Esta estructura permite a RNN procesar datos de secuencias de cualquier longitud.Red neuronal tradicional
: la entrada y la salida son independientes (por ejemplo, en la clasificación de imágenes, las imágenes individuales no están relacionadas).: mediante
RNNConexión recurrente(Recurrent Connection), el estado oculto del paso anterior se transfiere al siguiente paso, formando una "memoria".Entrada de cada paso = datos actuales + estado oculto del paso anterior.
La salida no solo depende de la entrada actual, sino también del contexto de todos los pasos anteriores.
Es como cuando una persona lee una oración: entender la palabra actual depende del contenido leído antes (por ejemplo, «él abrió __», predecirás «la puerta» o «el libro»).
Ejemplo
Ejemplo
import numpy as np
class SimpleRNN:
def __init__(self, input_size, hidden_size):
self.Wx = np.random.randn(hidden_size, input_size) # Peso del estado oculto
self.Wh = np.random.randn(hidden_size, hidden_size) # Sesgo
self.b = np.zeros((hidden_size, 1)) Mecanismo de funcionamiento de RNN
def forward(self, x, h_prev):
h_next = np.tanh(np.dot(self.Wx, x) + np.dot(self.Wh, h_prev) + self.b)
return h_next
Mecanismo de funcionamiento de RNN
Recibe la entrada actual xₜ y el estado oculto anterior hₜ₋₁
- Calcula el nuevo estado oculto hₜ = f(Wₕₕ·hₜ₋₁ + Wₓₕ·xₜ + b)
- Produce la salida yₜ = g(Wₕᵧ·hₜ + c)
- donde f y g suelen ser funciones de activación (como tanh o softmax).
Ventajas y desventajas de RNN
Ventajas y desventajas de RNN
Puede procesar secuencias de longitud variable:
- En teoría puede recordar información histórica de cualquier longitud
- Parámetros compartidos (el mismo conjunto de pesos se usa en todos los pasos de tiempo)
- Desventajas
Problema de desvanecimiento/explosión del gradiente (dificultad para aprender dependencias a largo plazo):
- Baja eficiencia computacional (no se pueden procesar los pasos de tiempo en paralelo)
- Red de memoria a largo y corto plazo (LSTM)
Red de memoria a largo y corto plazo (LSTM)
2.1 Estructura central de LSTM
2.1 Estructura central de LSTM
Componente
| Función | Compuerta de entrada |
|---|---|
| Controla la entrada de información nueva | Compuerta de olvido |
| Decide qué información antigua descartar | Compuerta de salida |
| Controla la cantidad de información de salida | Celda de memoria |
| Almacena el estado a largo plazo | Ejemplo |
Ejemplo
class LSTMCell:
def __init__(self, input_size, hidden_size):
# Dividir para obtener cada compuerta
self.W = np.random.randn(4*hidden_size, input_size+hidden_size)
self.b = np.random.randn(4*hidden_size, 1)
def forward(self, x, h_prev, c_prev):
combined = np.vstack((h_prev, x))
gates = np.dot(self.W, combined) + self.b
# Compuerta de olvido
f_gate = sigmoid(gates[:hidden_size]) # Compuerta de entrada
i_gate = sigmoid(gates[hidden_size:2*hidden_size]) # Compuerta de salida
o_gate = sigmoid(gates[2*hidden_size:3*hidden_size]) # Memoria candidata
c_candidate = np.tanh(gates[3*hidden_size:]) # Actualizar memoria y estado oculto
Cómo resuelve LSTM el problema de las dependencias a largo plazo
c_next = f_gate * c_prev + i_gate * c_candidate
h_next = o_gate * np.tanh(c_next)
return h_next, c_next
Cómo resuelve LSTM el problema de las dependencias a largo plazo
- : la compuerta de olvido puede decidir conservar o descartar información específicaRuta de gradiente
- : la celda de memoria proporciona una ruta de propagación de gradiente relativamente directaProtección de la información
- : el contenido de la memoria no se modifica directamente por las operaciones de cada paso de tiempoUnidad recurrente con compuertas (GRU)
Unidad recurrente con compuertas (GRU)
Estructura central de GRU
Estructura central de GRU
Componente
| Función | Compuerta de actualización |
|---|---|
| Decide cuánta información antigua conservar | Compuerta de reinicio |
| Decide cómo combinar información nueva y antigua | Activación candidata |
| Nuevo estado calculado a partir de la compuerta de reinicio | Ejemplo |
Ejemplo
class GRUCell:
def __init__(self, input_size, hidden_size):
self.W = np.random.randn(3*hidden_size, input_size+hidden_size)
self.b = np.random.randn(3*hidden_size, 1)
def forward(self, x, h_prev):
combined = np.vstack((h_prev, x))
gates = np.dot(self.W, combined) + self.b
# Compuerta de actualización
z = sigmoid(gates[:hidden_size]) # Compuerta de reinicio
r = sigmoid(gates[hidden_size:2*hidden_size]) # Actualizar el estado oculto
h_candidate = np.tanh(np.dot(self.W[2*hidden_size:],
np.vstack((r*h_prev, x))) + self.b[2*hidden_size:]
Característica
h_next = (1-z)*h_prev + z*h_candidate
return h_next
GRU vs LSTM
| Cantidad de parámetros | GRU | LSTM |
|---|---|---|
| Menos | Más | Velocidad de entrenamiento |
| Más rápida | Más lenta | Celda de memoria |
| Número de compuertas | Ninguno | tener |
| 2 | 3 | Rendimiento |
| Mejor en conjuntos de datos pequeños | Posiblemente mejor en conjuntos de datos grandes | RNN bidireccional (Bi-RNN) |
RNN bidireccional (Bi-RNN)
Arquitectura del RNN bidireccional
Arquitectura del RNN bidireccional
Capa hacia adelante: procesa la secuencia en orden temporal
- Capa hacia atrás: procesa la secuencia en orden temporal inverso
- La salida final es una combinación de las salidas de ambas direcciones (normalmente concatenación o suma).
Casos de uso del RNN bidireccional

Casos de uso del RNN bidireccional
- : etiquetado de partes del discurso, reconocimiento de entidades nombradasReconocimiento de voz
- : utiliza el contexto anterior y posterior para mejorar la precisiónBioinformática
- : predicción de la estructura de proteínasPredicción de series temporales
- : considera tendencias históricas y futurasLSTM/GRU bidireccionales
LSTM/GRU bidireccionales
# Crear una capa LSTM bidireccional
Ejemplo
model.add(Bidirectional(LSTM(64))) Ejercicio 1: Implementar un RNN simple
Ejercicios prácticos
Ejercicio 1: Implementar un RNN simple
Construye un clasificador de sentimiento de reseñas de películas basado en LSTM usando Keras.
Ejercicio 2: Análisis de sentimiento con LSTM
Implementa un modelo GRU bidireccional para reconocer entidades como nombres de personas y lugares en un texto.
Ejercicio 3: Reconocimiento de entidades nombradas con GRU bidireccional
Compara las diferencias de rendimiento entre Vanilla RNN, LSTM y GRU en el mismo conjunto de datos.
Ejercicio 4: Experimentos comparativos
RNN y sus variantes son herramientas potentes para procesar datos secuenciales. Para dominarlo a fondo:
Resumen y aprendizaje avanzado
Aprender cómo el mecanismo de atención mejora RNN
- Explorar la relación entre la arquitectura Transformer y RNN
- Practicar diversas tareas de modelado de secuencias (traducción automática, síntesis de voz, etc.)
- Otras extensiones
- IA pensando...