Mecanismo de atención
El mecanismo de atención (Attention Mechanism) es una técnica importante en el aprendizaje profundo que imita la forma en que los humanos asignan atención en los procesos visuales y cognitivos. Así como al leer prestas atención inconscientemente a las palabras clave, el mecanismo de atención permite que la red neuronal se enfoque dinámicamente en las partes más relevantes de los datos de entrada.
Conceptos básicos
La idea central del mecanismo de atención es:Asignar dinámicamente diferentes pesos según la importancia de las diferentes partes de la entrada para la tarea actualEsta asignación de pesos no es fija, sino que se calcula dinámicamente según el contexto.
Expresión matemática
El mecanismo de atención generalmente se puede expresar como:
Attention(Q, K, V) = softmax(QK^T/√d_k)V
donde:
- Q (Query): el elemento de consulta actual para calcular la salida
- K (Key): la clave utilizada para coincidir con el elemento de consulta
- V (Value): el valor real correspondiente a la clave
- d_k: la dimensión de la clave, utilizada para escalar el resultado del producto punto
¿Por qué se necesita el mecanismo de atención?
- Resolver el problema de dependencias de larga distancia: las RNN tradicionales tienen dificultades para capturar relaciones entre palabras distantes
- Capacidad de cómputo paralelo: en comparación con el procesamiento secuencial de las RNN, la atención se puede calcular en paralelo
- Interpretabilidad: los pesos de atención pueden mostrar intuitivamente el enfoque del modelo
Mecanismo de autoatención (Self-Attention)
La autoatención es una forma especial del mecanismo de atención que permite que cada elemento de la secuencia de entrada se relacione con todos los demás elementos de la secuencia.
Principio de funcionamiento
- Para cada elemento de la secuencia de entrada, calcular su puntuación de similitud con todos los elementos
- Usar la función softmax para convertir estas puntuaciones en pesos (entre 0 y 1)
- Usar estos pesos para realizar una suma ponderada de los valores correspondientes y obtener la salida
Ejemplo
import torch
import torch.nn.functional as F
def self_attention(query, key, value):
scores = torch.matmul(query, key.transpose(-2, -1)) / (query.size(-1) ** 0.5)
weights = F.softmax(scores, dim=-1)
return torch.matmul(weights, value)
Ventajas de la autoatención
- Percepción del contexto global: cada posición puede acceder directamente a la información de todas las posiciones de la secuencia
- Independencia de posición: no depende del orden de la secuencia, adecuada para procesar diversos tipos de datos estructurados
- Cálculo eficiente: en comparación con la complejidad O(n) de las RNN, la autoatención se puede calcular en paralelo
Atención multi-cabeza (Multi-Head Attention)
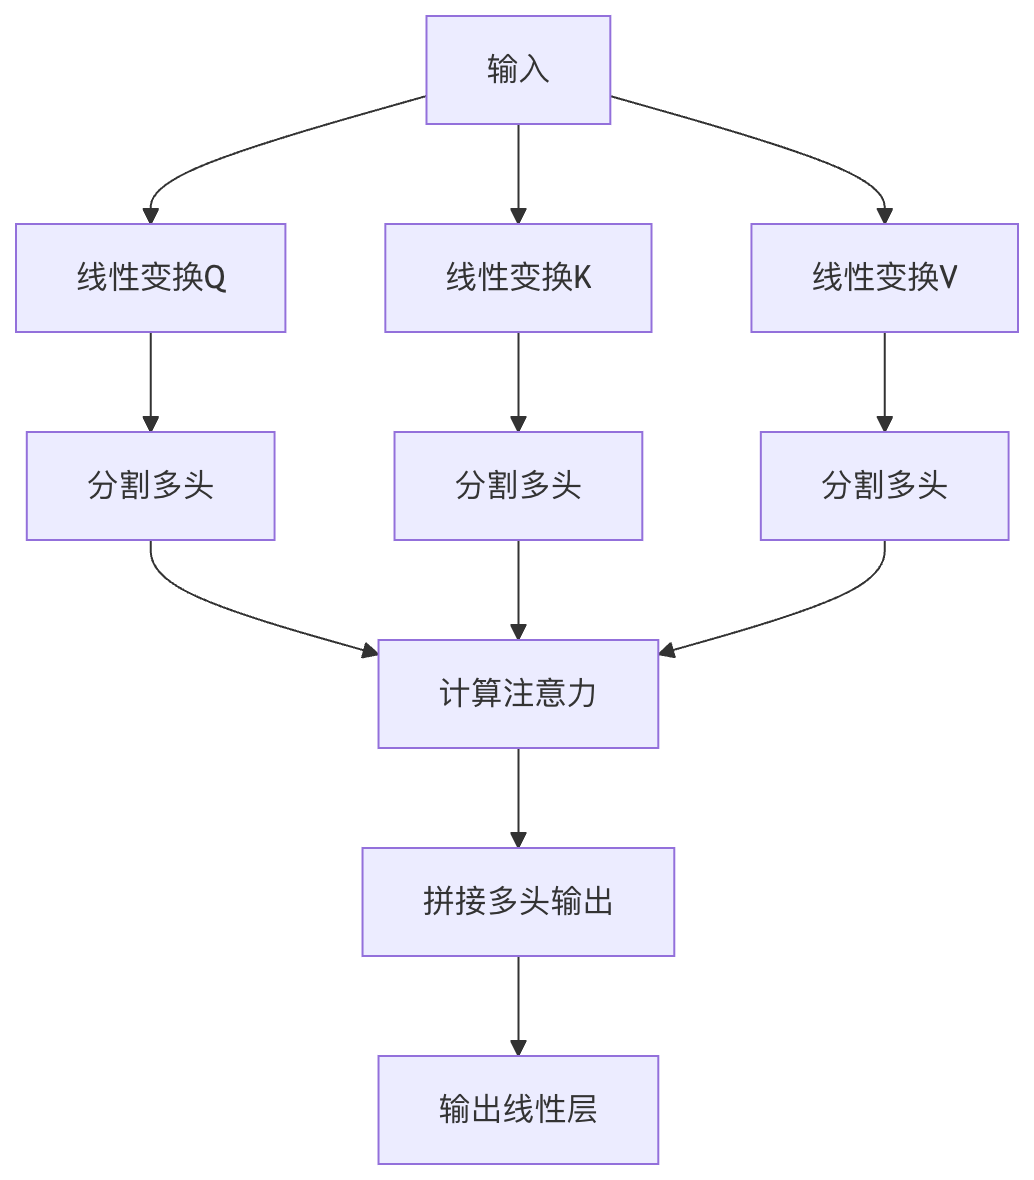
La atención multi-cabeza es una extensión de la autoatención; ejecuta el mecanismo de atención varias veces en paralelo y luego concatena los resultados.
Composición estructural
- Múltiples cabezas de atención: normalmente se utilizan 8 o más cabezas de atención en paralelo
- Capa de transformación lineal: cada cabeza tiene sus propias matrices de transformación Q, K, V
- Concatenación y salida: concatenar las salidas de cada cabeza y pasarlas por una capa lineal
Ventajas de la atención multi-cabeza
- Capturar diferentes relaciones: cada cabeza puede aprender a prestar atención a diferentes aspectos de las relaciones
- Mejorar la capacidad de representación: tiene una mayor capacidad de extracción de características que la atención de una sola cabeza
- Entrenamiento estable: la combinación de múltiples cabezas reduce la dependencia del modelo de patrones específicos
Ejemplo
class MultiHeadAttention(nn.Module):
def __init__(self, d_model, num_heads):
super().__init__()
self.d_model = d_model
self.num_heads = num_heads
self.d_k = d_model // num_heads
self.W_q = nn.Linear(d_model, d_model)
self.W_k = nn.Linear(d_model, d_model)
self.W_v = nn.Linear(d_model, d_model)
self.W_o = nn.Linear(d_model, d_model)
def forward(self, query, key, value):
batch_size = query.size(0)
# Transformación lineal y división en múltiples cabezas
Q = self.W_q(query).view(batch_size, -1, self.num_heads, self.d_k)
K = self.W_k(key).view(batch_size, -1, self.num_heads, self.d_k)
V = self.W_v(value).view(batch_size, -1, self.num_heads, self.d_k)
# Calcular la atención
scores = torch.matmul(Q, K.transpose(-2, -1)) / (self.d_k ** 0.5)
weights = F.softmax(scores, dim=-1)
output = torch.matmul(weights, V)
# Concatenar las cabezas y generar la salida
output = output.transpose(1, 2).contiguous().view(batch_size, -1, self.d_model)
return self.W_o(output)
Aplicaciones del mecanismo de atención en NLP
El mecanismo de atención se ha convertido en un componente central de los sistemas modernos de NLP, especialmente en la arquitectura Transformer.
Principales escenarios de aplicación
Traducción automática:
- Modelo clásico Seq2Seq con atención
- Permite al modelo prestar atención a las partes más relevantes de la oración fuente al generar cada palabra objetivo
Resumen de texto:
- Identificar información clave en el texto original mediante pesos de atención
- Los modelos de resumen generativo utilizan autoatención para capturar relaciones globales en documentos largos
Sistemas de preguntas y respuestas:
- Atención cruzada entre la pregunta y el documento
- Ayuda al modelo a localizar los fragmentos de texto relevantes a la pregunta
Modelos de lenguaje:
- Los modelos de la serie GPT utilizan autoatención enmascarada
- Permite que cada palabra preste atención a todas las palabras anteriores
Caso práctico: atención en BERT
BERT (Bidirectional Encoder Representations from Transformers) es un representante típico del uso del mecanismo de atención:
- Autoatención bidireccional: considera simultáneamente el contexto izquierdo y derecho
- 12/24 capas de Transformer: apila capas de atención multi-cabeza
- Tareas de preentrenamiento: aprende representaciones generales mediante el modelo de lenguaje enmascarado y la predicción de la siguiente oración
Ejemplo
from transformers import BertModel, BertTokenizer
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
model = BertModel.from_pretrained('bert-base-uncased')
inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
outputs = model(**inputs)
# Obtener los pesos de atención
attention = outputs.attentions # Incluye los pesos de atención de cada capa
Variantes y extensiones del mecanismo de atención
1. Atención de producto punto escalado (Scaled Dot-Product Attention)
- Introduce un factor de escala (√d_k) para evitar la saturación de softmax
- Alta eficiencia computacional, adecuada para aplicaciones a gran escala
2. Atención aditiva (Additive Attention)
- Utiliza una red feedforward de una sola capa para calcular la función de compatibilidad
- Adecuada para casos donde las dimensiones de consulta y clave son diferentes
3. Atención local (Local Attention)
- Solo presta atención a un subconjunto de la entrada, reduciendo la complejidad computacional
- Equilibra la atención global y la eficiencia computacional
4. Atención dispersa (Sparse Attention)
- Solo calcula los pesos de atención en algunas posiciones
- Por ejemplo, la atención de ventana deslizante utilizada por Longformer
Práctica y ejercicios
Ejercicio 1: Implementar un mecanismo de atención básico
Ejemplo
import torch.nn as nn
import torch.nn.functional as F
class SimpleAttention(nn.Module):
def __init__(self, hidden_size):
super(SimpleAttention, self).__init__()
self.attention = nn.Linear(hidden_size, 1)
def forward(self, encoder_outputs):
# encoder_outputs: [batch_size, seq_len, hidden_size]
attention_scores = self.attention(encoder_outputs).squeeze(2) # [batch_size, seq_len]
attention_weights = F.softmax(attention_scores, dim=1)
context_vector = torch.bmm(attention_weights.unsqueeze(1), encoder_outputs) # [batch_size, 1, hidden_size]
return context_vector.squeeze(1), attention_weights
Ejercicio 2: Visualizar los pesos de atención
Ejemplo
import seaborn as sns
def plot_attention(attention_weights, source_tokens, target_tokens):
plt.figure(figsize=(10, 8))
sns.heatmap(attention_weights,
xticklabels=source_tokens,
yticklabels=target_tokens,
cmap="YlGnBu")
plt.xlabel("Source Tokens")
plt.ylabel("Target Tokens")
plt.title("Attention Weights Visualization")
plt.show()
# Ejemplo de uso
source = ["The", "cat", "sat", "on", "the", "mat"]
target = ["Le", "chat", "s'est", "assis", "sur", "le", "tapis"]
attention = torch.rand(7, 6) # Pesos de atención simulados
plot_attention(attention, source, target)
Resumen y aprendizaje avanzado
El mecanismo de atención se ha convertido en una tecnología fundamental del aprendizaje profundo moderno, especialmente en el campo del NLP. Para aprender en profundidad:
Leer el artículo original:
- "Attention Is All You Need" (Vaswani et al., 2017)
- "Neural Machine Translation by Jointly Learning to Align and Translate" (Bahdanau et al., 2015)
Sugerencias para proyectos prácticos:
- Implementar un modelo Transformer completo
- Usar el mecanismo de atención para mejorar modelos existentes
- Analizar el impacto de diferentes variantes de atención en el rendimiento
Ampliar áreas de aplicación:
- Atención visual en visión por computadora
- Atención intermodal en aprendizaje multimodal
- Mecanismo de atención en grafos en redes neuronales de grafos
El desarrollo del mecanismo de atención continúa; comprender sus principios centrales te ayudará a dominar mejor las técnicas modernas de aprendizaje profundo.
Otras extensiones