Fundamentos de los Grandes Modelos de Lenguaje (LLM)
El Gran Modelo de Lenguaje (Large Language Model, abreviado LLM) es el cerebro de los agentes de IA; comprenderlo es la base para construir agentes inteligentes.
La razón por la que un Gran Modelo de Lenguaje puede conversar contigo, escribir artículos y programar es, en esencia, que, basándose en el texto (prompt) que le proporcionas, palabra por palabraadivinargenera la continuación más razonable.
En términos simples, un Gran Modelo de Lenguaje es un modelo de aprendizaje profundo entrenado con enormes volúmenes de datos de texto, capaz de comprender y generar lenguaje humano. Al analizar grandes cantidades de texto en Internet, aprende las reglas estadísticas del lenguaje y, cuando recibe una entrada, genera la continuación más razonable según las reglas aprendidas.

Podemos imaginar un Gran Modelo de Lenguaje como unestudiante extremadamente aplicado y con una memoria excepcional:
Fase de aprendizaje (entrenamiento): ha leído casi todos los textos públicos de Internet (libros, artículos, páginas web, código, etc.), con un volumen de datos que puede alcanzar billones de palabras. En este proceso, no memoriza, sino que aprende un conjunto de reglas lingüísticas extremadamente complejas.
Fase de aplicación (inferencia): cuando le haces una pregunta o le das una instrucción, aplica las reglas aprendidas y genera, palabra por palabra, la respuesta más lógica y contextualmente adecuada.
Su carácter "grande" se refleja principalmente en dos aspectos:
- Gran escala de parámetros: el modelo contiene decenas de miles de millones o incluso billones de parámetros ajustables, que almacenan el conocimiento lingüístico aprendido.
- Grandes volúmenes de datos de entrenamiento: la cantidad de datos de texto utilizados para el entrenamiento es enorme e incluye lo mejor de la información pública de Internet.
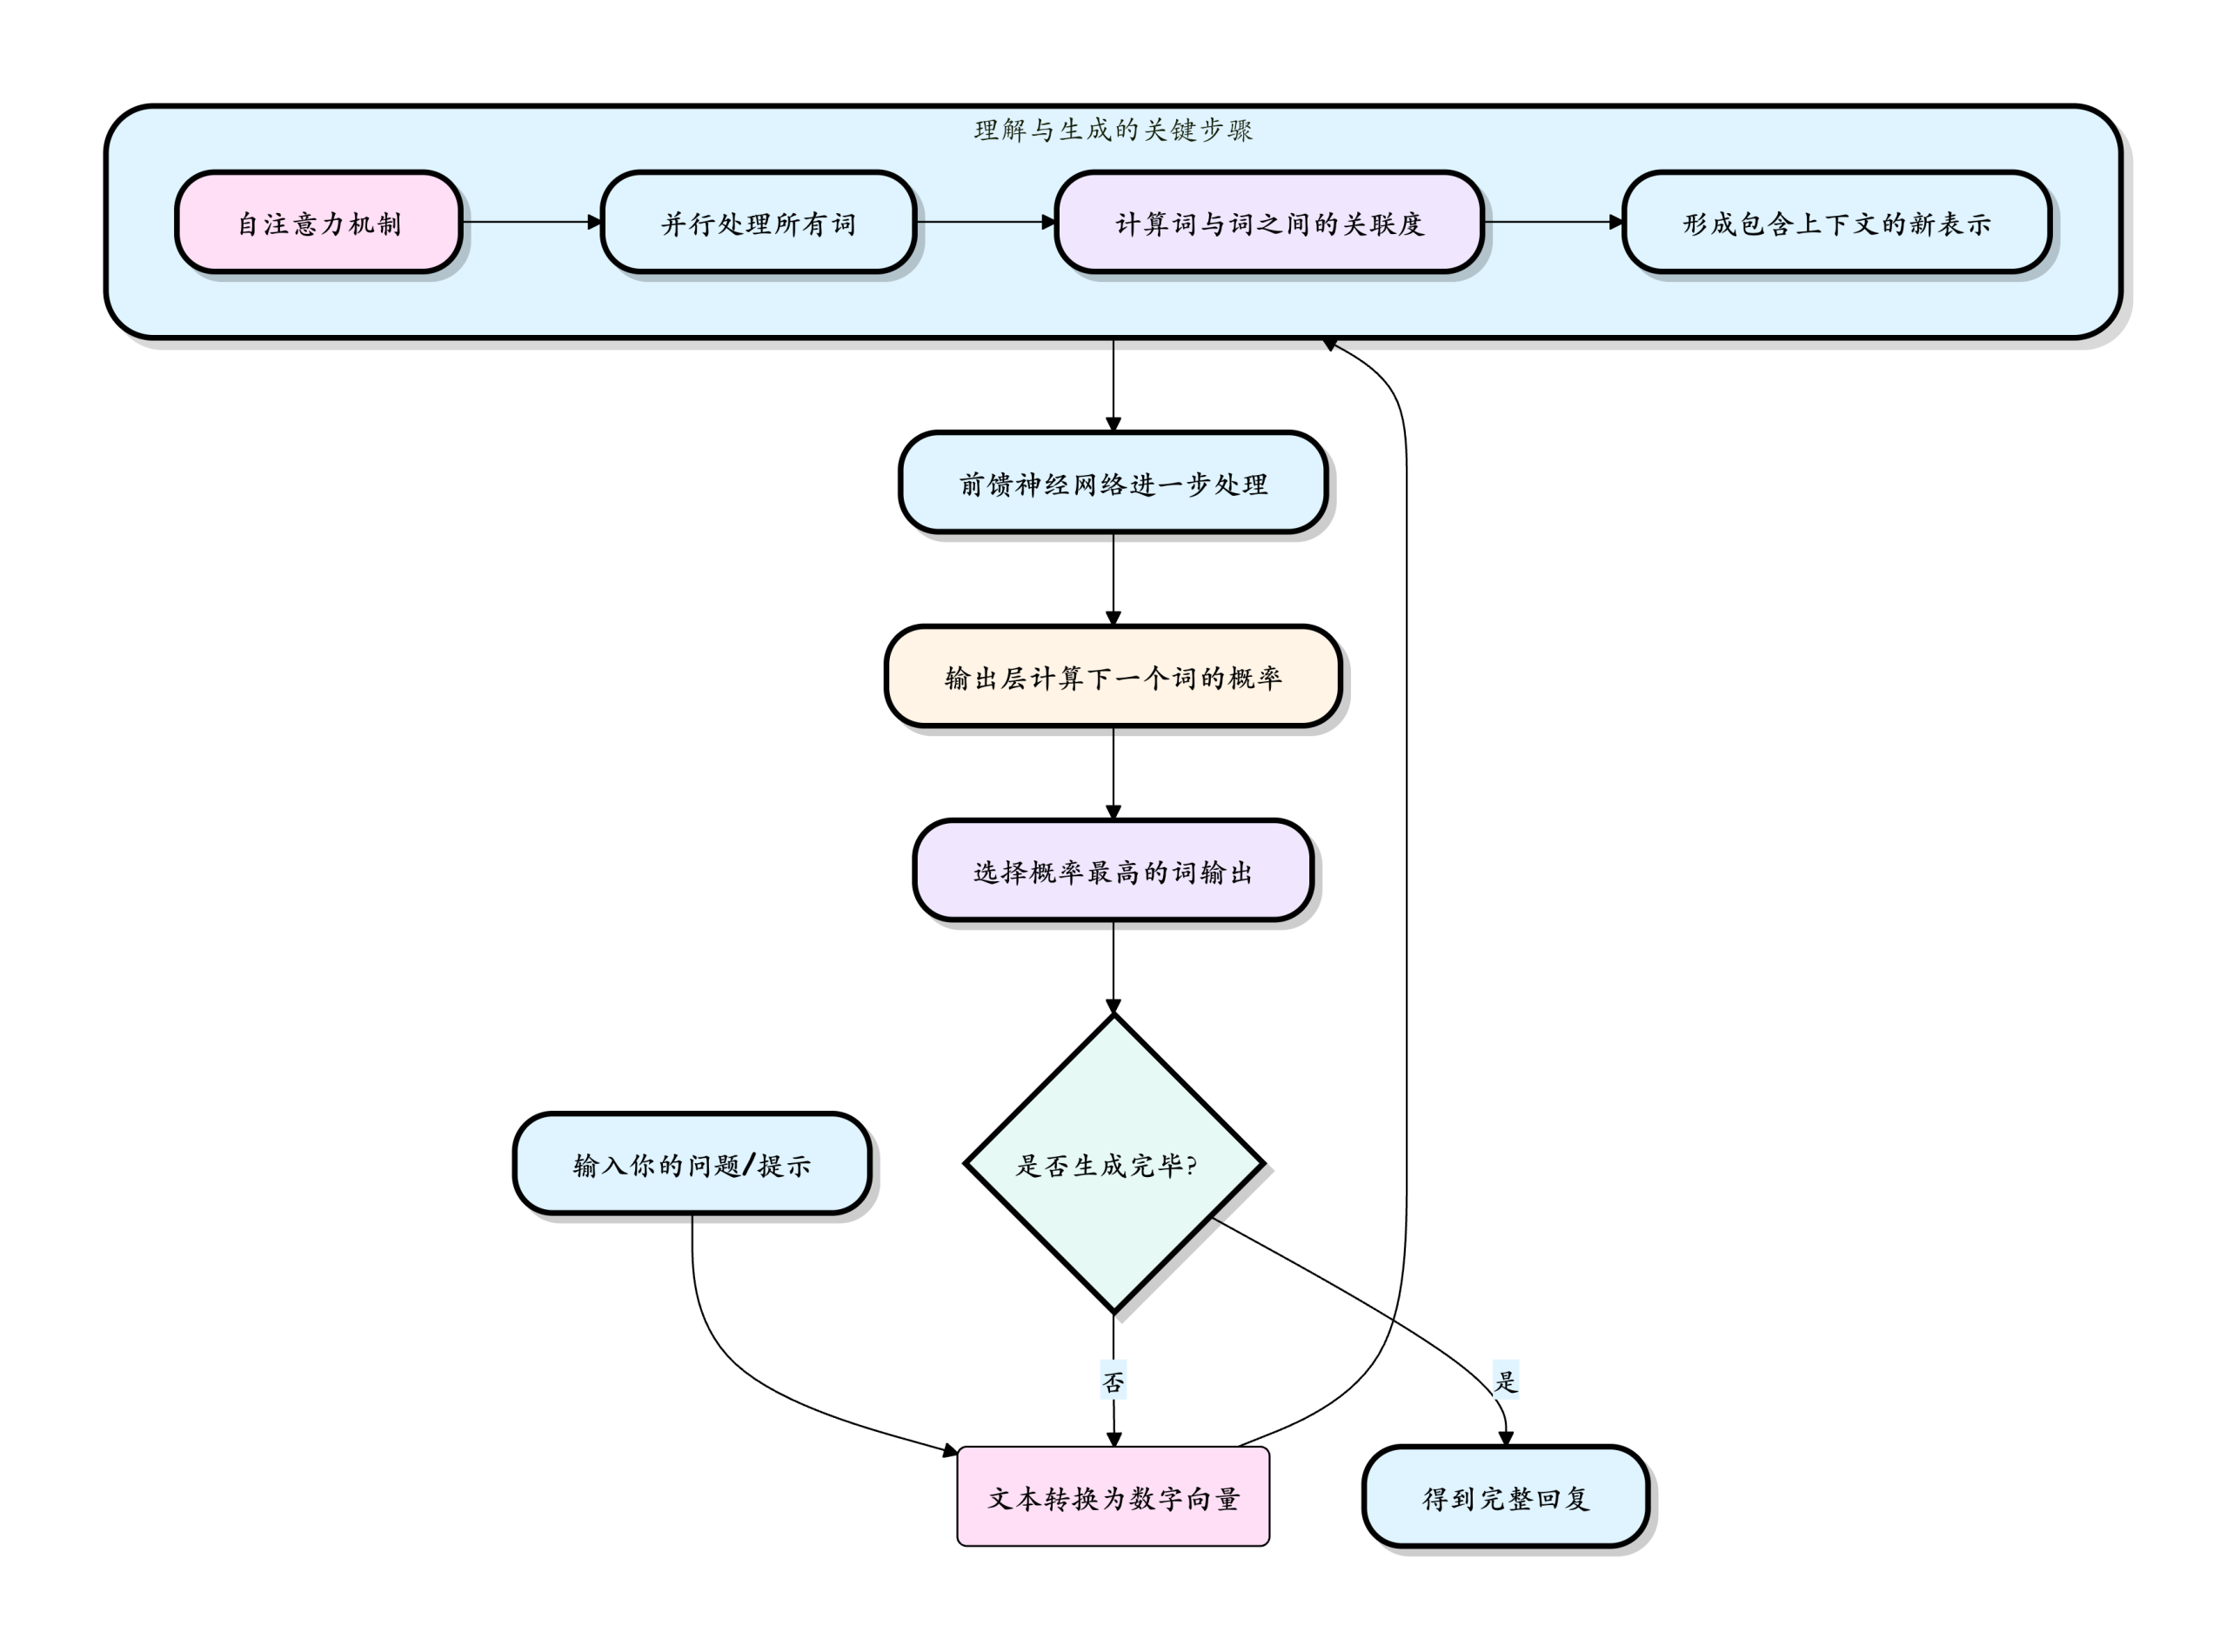
La siguiente figura muestra el proceso de generación de texto palabra por palabra en un LLM: solo predice una palabra a la vez, luego incorpora esa nueva palabra a la entrada y continúa prediciendo la siguiente, repitiendo el ciclo hasta generar una respuesta completa:

Demostración animada:
Cada paso hace una sola cosa: según el contexto previo, adivinar la siguiente palabra
Aunque los LLM son muy potentes, también tienen limitaciones claras:
| Capacidad | Descripción | Limitación |
|---|---|---|
| Corte de conocimiento | Los datos de entrenamiento tienen una fecha de corte | No puede conocer información posterior al entrenamiento |
| Cálculo matemático | Puede hacer cálculos simples | Los cálculos complejos son propensos a errores |
| Información en tiempo real | Requiere la asistencia de herramientas externas | Por sí mismo no puede obtener datos en tiempo real |
| Precisión factual | Puede generar información incorrecta | Requiere verificación de hechos |
| Procesamiento de textos largos | La longitud del contexto es limitada | Los textos extremadamente largos pierden información |
| Consistencia lógica | Puede ser contradictorio | Requiere diseño y verificación cuidadosos |
Aviso importante:Los LLM no son omniscientes ni omnipotentes; son esencialmente sistemas de coincidencia de patrones basados en estadísticas. Comprender sus limitaciones permite aprovechar mejor sus capacidades.
Principio de funcionamiento central: breve análisis de la arquitectura Transformer
La asombrosa capacidad de los LLM depende de su tecnología central subyacente:la arquitectura TransformerNo es necesario profundizar en los complejos principios matemáticos, pero se puede entender su idea central.
Imagina que quieres escribir un artículo sobre el sistema solar:
- Leer todos los materiales: primero consultarías muchos libros y páginas web relacionados.
- Captar lo esencial: notarías que palabras como sol, planetas, órbita y gravedad aparecen con frecuencia y están interrelacionadas.
- Organizar el lenguaje: según el punto que quieras transmitir (por ejemplo, presentar Marte), utilizarías selectivamente la información vista antes sobre el tamaño, el color y la posición de Marte, y la organizarías en oraciones fluidas.
El funcionamiento de Transformer es similar a esto; su proceso central se divide en tres etapas:
- Procesamiento de entrada: tus palabras se dividen en tokens (palabras o caracteres) y se convierten en números (vectores) que la computadora puede entender.
- Comprensión del contexto (núcleo):El mecanismo de autoatención (Self-Attention)comienza a trabajar. Permite que el modelo, al procesar cada palabra, pondere la importancia detodas las demás palabrasen la oración. Este proceso esparaleloy extremadamente rápido.
- Generación y repetición: basándose en la comprensión de todas las palabras, el modelo calcula una distribución de probabilidad y predice la siguiente palabra más probable. Tras seleccionar y generar esa palabra, la toma como nueva entrada y repite todo el proceso hasta generar una respuesta completa.
El mecanismo de autoatención es la innovación más clave de Transformer. Tomando como ejemplo la frase «El teléfono de Apple, la batería de él es muy grande», cuando el modelo procesaelloesta palabra, el mecanismo de autoatención ayuda al modelo a determinar queelloy«Apple»yy «teléfono»son altamente relevantes. La siguiente figura muestra la distribución de los pesos de atención en este proceso:
Es precisamente esta capacidad deprocesamiento paralelounióny comprensión profunda del contexto globalla que hace que los LLM basados en Transformer superen con creces a tecnologías anteriores (como RNN) en tareas de lenguaje.
Cómo interactuar con LLM: Introducción a la ingeniería de prompts
Prompt (instrucción)Es la entrada que le das al LLM; le indica al modelo lo que quieres, como dar instrucciones a un asistente: cuanto más claras sean las instrucciones, mejores serán los resultados. La calidad del prompt determina directamente la calidad de la respuesta.
Un buen prompt generalmente consta de las siguientes cuatro partes:
Principios básicos
Ser claro y específico: evita las expresiones vagas. No digas«escribe algo sobre perros», sino que deberías decir«escribe, con un lenguaje vivo y animado, una breve introducción de unas 100 palabras sobre las características de personalidad del golden retriever, dirigida a niños de 6 a 8 años»。
Proporcionar contexto: indícale al modelo tu identidad, antecedentes y objetivo. Por ejemplo:«Eres un tutor experimentado de programación en Python. Explica a un principiante que acaba de terminar la sintaxis básica qué es la comprensión de listas y proporciona un ejemplo sencillo.»
Especificar el formato: si necesitas una salida con un formato específico, indícalo con claridad, por ejemplo:«resume los siguientes puntos en tres viñetas»o«genera la salida en formato JSON»。
Pensamiento paso a paso (Chain-of-Thought): para problemas complejos, puedes guiar al modelo a razonar paso a paso en el prompt, por ejemplo:«analiza este problema paso a paso: primero enumera las condiciones conocidas, luego deriva los pasos intermedios y finalmente da una conclusión.»Este método puede mejorar significativamente la precisión en tareas de razonamiento complejo.
Casos de uso comunes de los LLM
| Categoría de escenario | Ejemplo concreto | Descripción |
|---|---|---|
| Creación y edición de contenido | Redactar correos electrónicos, informes y blogs; continuar historias; pulir textos; traducir textos de diferentes estilos | Generar borradores rápidamente, proporcionar inspiración y múltiples formas de expresión |
| Búsqueda y resumen de información | Leer rápidamente documentos largos y extraer las ideas clave; preguntas y respuestas basadas en bases de conocimiento | "Comprende" las preguntas mejor que la búsqueda tradicional, y puede resumir e integrar |
| Asistencia de programación | Explicar código, generar fragmentos de código, depurar errores, refactorizar código y escribir casos de prueba | Actúa como un compañero de programación 24/7, mejorando enormemente la eficiencia del desarrollo |
| Conversación y atención al cliente | Chatbots inteligentes, tutores personalizados, juegos de rol | Proporciona una experiencia de interacción antropomórfica y contextualmente coherente |
| Razonamiento lógico y análisis | Resolver problemas matemáticos, realizar razonamiento lógico básico, analizar tendencias de datos y hacer planes | Muestra una sorprendente capacidad de razonamiento dentro de dominios limitados |
Llamadas a la API y configuración de parámetros
Para construir un Agente de IA, necesitas aprender a invocar el LLM a través de la API.
En esta sección, tomamos la API de OpenAI como ejemplo para presentar los métodos básicos de llamada.
openai es una potente biblioteca de Python para interactuar con los modelos y servicios de OpenAI. Para más detalles, consulta:Python OpenAI。
Dirección de código abierto:https://github.com/openai/openai-python
Llamadas básicas a la API
1. Instalar las bibliotecas necesarias
pip install openai
Luego, debes registrarte en el sitio web oficial de OpenAI y generar una API Key en la página de claves API.
Ejemplo
from openai import OpenAI
client = OpenAI(
# This is the default and can be omitted
api_key="Tu API key solicitada",
)
response = client.responses.create(
model="gpt-4o",
instructions="You are a coding assistant that talks like a pirate.",
input="How do I check if a Python object is an instance of a class?",
)
print(response.output_text)
Actualmente, en nuestro país, acceder a OpenAI sigue siendo un poco complicado; muchos proveedores nacionales también admiten OpenAI, como DeepSeek y Qwen de Alibaba.
DeepSeek
La API de DeepSeek es totalmente compatible con el formato de API de OpenAI. Solo necesitas modificar una pequeña configuración para usar directamente el SDK de OpenAI o herramientas compatibles para acceder a la API de DeepSeek.
Parámetros de configuración principales:
| Parámetro | Valor/Descripción |
|---|---|
| base_url | Obligatorio, valor fijo:https://api.deepseek.com(También se puede completarhttps://api.deepseek.com/v1, solo por compatibilidad con OpenAI; v1 no está relacionado con la versión del modelo) |
| api_key | Obligatorio; primero debes solicitar una API Key exclusiva en el sitio web oficial de DeepSeek (dirección de solicitud:https://platform.deepseek.com/) |
| model | Obligatorio,
|
Ejemplo
from openai import OpenAI
# Inicializar el cliente (configuración principal: reemplaza con tu API Key)
client = OpenAI(
api_key=os.environ.get('DEEPSEEK_API_KEY'), # Se recomienda configurar mediante variables de entorno; también se puede escribir directamente (no recomendado)
base_url="https://api.deepseek.com" # Dominio fijo de DeepSeek
)
# Llamar a la API de conversación
try:
response = client.chat.completions.create(
model="deepseek-v4-flash", # Especificar el modelo; opciones: deepseek-v4-flash / deepseek-v4-pro
messages=[
{"role": "system", "content": "You are a helpful assistant"}, # Definición del rol del sistema
{"role": "user", "content": "Hello"}, # Pregunta del usuario
],
stream=False # Salida no transmitida (devuelve el resultado completo de una sola vez)
)
# Imprimir el contenido de la respuesta
print("Resultado de la respuesta:", response.choices[0].message.content)
except Exception as e:
print("Error en la llamada:", str(e))
Alibaba Bailian
El modelo Tongyi Qianwen de Alibaba Cloud Bailian admite interfaces compatibles con OpenAI. Solo necesita ajustar la API Key, BASE_URL y el nombre del modelo para migrar el código OpenAI existente al servicio Alibaba Cloud Bailian.
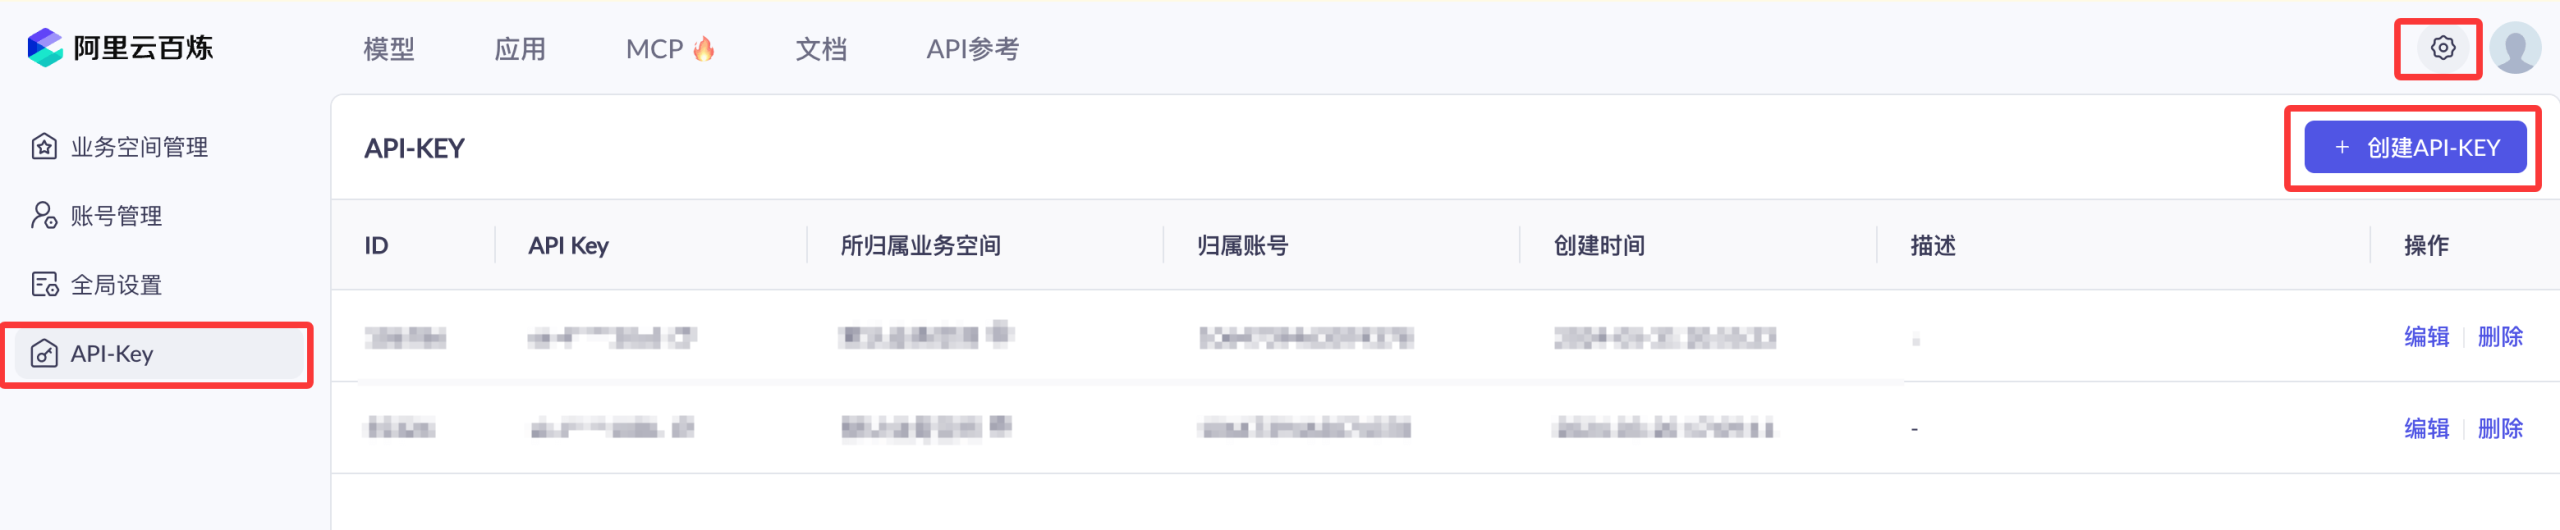
Necesitamos activar el servicio de modelos Alibaba Cloud Bailian y obtener una API-KEY.
Primero podemos usar la cuenta principal de Alibaba Cloud para acceder a la plataforma de servicios de modelos Bailian:https://bailian.console.aliyun.com/, luego haga clic en "Iniciar sesión" en la esquina superior derecha. Después de iniciar sesión, haga clic en el icono de engranaje ⚙️ en la esquina superior derecha, seleccione API key, copie la API key; si no tiene una, también puede crear una API key:
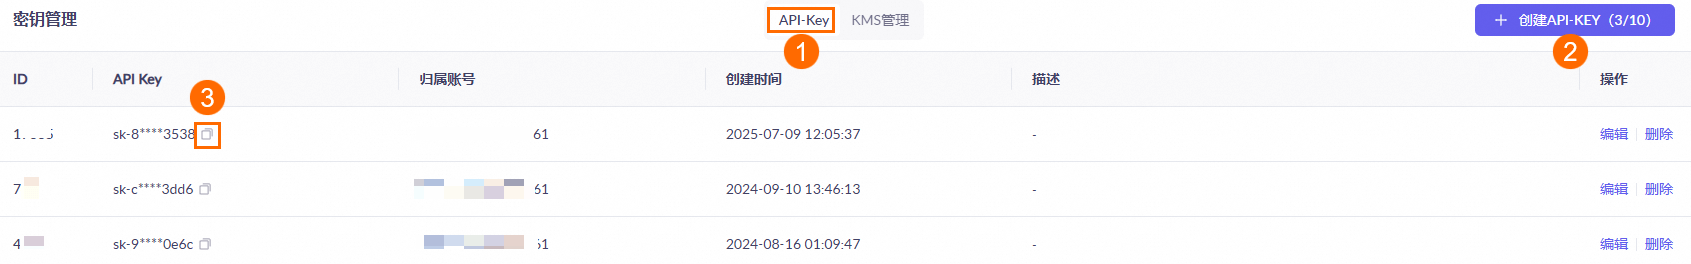
Activar Alibaba Cloud Bailian no genera costos; solo la llamada a modelos (después de superar la cuota gratuita), el despliegue de modelos y el ajuste de modelos generarán los cargos correspondientes.
Ahora, para usar la API, todo se factura por tokens. Afortunadamente, no es caro; podemos comprar primero el paquete más barato:Plataforma de servicios de modelos grandes de Alibaba Cloud Bailian。
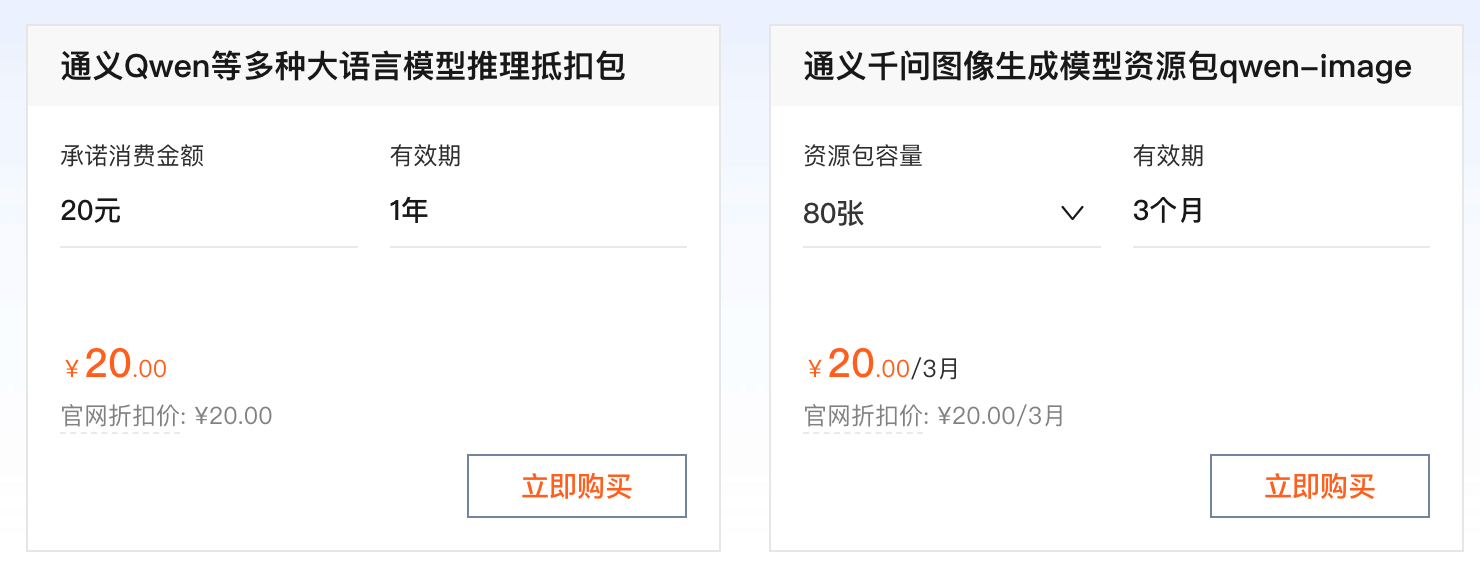
También se puede usar directamente el plan Coding Plan de Bailian y Ark:https://www.example.com/claude-code/coding-plan.html。
Método de uso
A continuación, usamos el SDK de OpenAI para acceder al modelo Tongyi Qianwen en el servicio Bailian.
Ejemplo de llamada no streaming
Ejemplo
import os
def get_response():
client = OpenAI(
api_key="sk-xxx", # Utiliza la API Key de Alibaba Cloud Bailian
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1", # Completa el base_url del SDK de DashScope
)
completion = client.chat.completions.create(
model="qwen-plus", # Aquí se usa qwen-plus como ejemplo; puedes cambiar el nombre del modelo según sea necesario. Lista de modelos: https://help.aliyun.com/zh/model-studio/getting-started/models
messages=[{'role': 'system', 'content': 'You are a helpful assistant.'},
{'role': 'user', 'content': '¿Quién eres?'}]
)
# datos json
#print(completion.model_dump_json())
print(completion.choices[0].message.content)
if __name__ == '__main__':
get_response()
Al ejecutar el código se pueden obtener los siguientes resultados:
Soy Tongyi Qianwen, un modelo de lenguaje a ultra gran escala desarrollado de forma independiente por el laboratorio Tongyi, perteneciente al Grupo Alibaba. Puedo ayudarte a responder preguntas y crear textos, por ejemplo, escribir historias, redactar documentos oficiales, correos, guiones, razonamiento lógico, programación, entre otras cosas; también puedo expresar opiniones y jugar juegos. Si tienes alguna pregunta o necesitas ayuda, ¡no dudes en decírmelo en cualquier momento!
Ejemplo de llamada streaming
Ejemplo
def get_response():
client = OpenAI(
api_key="sk-xxx",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
model="qwen-plus",
messages=[
{'role': 'system', 'content': 'You are a helpful assistant.'},
{'role': 'user', 'content': '¿Quién eres?'}
],
stream=True,
stream_options={"include_usage": True}
)
for chunk in completion:
# el chunk puede no tener choices o delta
if hasattr(chunk, "choices") and len(chunk.choices) > 0:
choice = chunk.choices[0]
if hasattr(choice, "delta") and hasattr(choice.delta, "content"):
print(choice.delta.content, end='', flush=True)
if __name__ == '__main__':
get_response()
Al ejecutar el código se pueden obtener los siguientes resultados:
Soy Tongyi Qianwen, un modelo de lenguaje a ultra gran escala desarrollado de forma independiente por el laboratorio Tongyi, perteneciente al Grupo Alibaba. Puedo ayudarte a responder preguntas y crear textos, por ejemplo, escribir historias, redactar documentos oficiales, correos, guiones, razonamiento lógico, programación, entre otras cosas; también puedo expresar opiniones y jugar juegos. Si tienes alguna pregunta o necesitas ayuda, ¡no dudes en decírmelo en cualquier momento!
Principales Grandes Modelos de Lenguaje
A continuación se presenta una recopilación de los sitios web oficiales y las direcciones de documentación de API de los principales modelos de lenguaje grandes: