Évaluation et surveillance des modèles TensorFlow
1. Concepts de base de l'évaluation des modèles
Dans les projets d'apprentissage automatique, l'évaluation des modèles est une étape essentielle pour valider les performances du modèle. Elle nous aide à comprendre comment le modèle se comporte dans des scénarios réels et nous guide dans l'optimisation du modèle.
1.1 Pourquoi avons-nous besoin de l'évaluation des modèles
- Vérification des performances: Confirmer si le modèle atteint les résultats attendus
- Sélection de modèle: Comparer les forces et les faiblesses de différents modèles
- Réglage des paramètres: Guider la direction de l'ajustement des hyperparamètres
- Éviter le surapprentissage: Détecter si le modèle est en surapprentissage sur les données d'entraînement
1.2 Types de métriques d'évaluation
| Type de métrique | Scénario applicable | Métriques courantes |
|---|---|---|
| Métriques de classification | Problèmes de classification | Exactitude, précision, rappel, score F1 |
| Métriques de régression | Problèmes de régression | MSE、MAE、R² |
| Métriques de clustering | Apprentissage non supervisé | Coefficient de silhouette, indice de Davies-Bouldin |
2. Outils d’évaluation TensorFlow
TensorFlow fournit une variété d’outils et de méthodes pour évaluer les performances d’un modèle.
2.1 Métriques d’évaluation intégrées
Exemple
import tensorflow as tf
# Métriques de classification couramment utilisées
metrics = [
tf.keras.metrics.BinaryAccuracy(),
tf.keras.metrics.Precision(),
tf.keras.metrics.Recall(),
tf.keras.metrics.AUC()
]
# Métriques de régression couramment utilisées
metrics = [
tf.keras.metrics.MeanSquaredError(),
tf.keras.metrics.MeanAbsoluteError(),
tf.keras.metrics.RootMeanSquaredError()
]
2.2 Processus d'évaluation
1. Spécifier les métriques lors de la compilation du modèle
Exemple
model.compile(
optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy', tf.keras.metrics.AUC()]
)
optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy', tf.keras.metrics.AUC()]
)
2. Utiliser la méthode evaluate pour l'évaluation
Exemple
test_loss, test_acc, test_auc = model.evaluate(
test_images, test_labels, verbose=2
)
test_images, test_labels, verbose=2
)
3. Fonctions d'évaluation personnalisées
Exemple
import tensorflow as tf
@tf.function
def custom_metric(y_true, y_pred):
threshold = 0.5
y_pred = tf.cast(y_pred > threshold, tf.float32)
# Calculer la précision, pas seulement la proportion d'exemples positifs
correct_predictions = tf.cast(tf.equal(y_true, y_pred), tf.float32)
return tf.reduce_mean(correct_predictions)
model.compile(
optimizer='adam',
loss='binary_crossentropy',
metrics=[custom_metric, 'accuracy'] # Vous pouvez également conserver la métrique d'exactitude standard comme référence
)
3. Surveillance et visualisation du modèle
1. Intégration de TensorBoard
TensorBoard est l'outil de visualisation de TensorFlow qui permet une surveillance en temps réel du processus d'entraînement.
Exemple
# Configurer la fonction de rappel
tensorboard_callback = tf.keras.callbacks.TensorBoard(
log_dir='./logs',
histogram_freq=1,
write_graph=True,
write_images=True
)
# Ajouter la fonction de rappel lors de l'entraînement du modèle
model.fit(
train_data,
époques=10,
validation_data=val_data,
callbacks=[tensorboard_callback]
)
tensorboard_callback = tf.keras.callbacks.TensorBoard(
log_dir='./logs',
histogram_freq=1,
write_graph=True,
write_images=True
)
# Ajouter la fonction de rappel lors de l'entraînement du modèle
model.fit(
train_data,
époques=10,
validation_data=val_data,
callbacks=[tensorboard_callback]
)
Lancer TensorBoard :
tensorboard --logdir=./logs
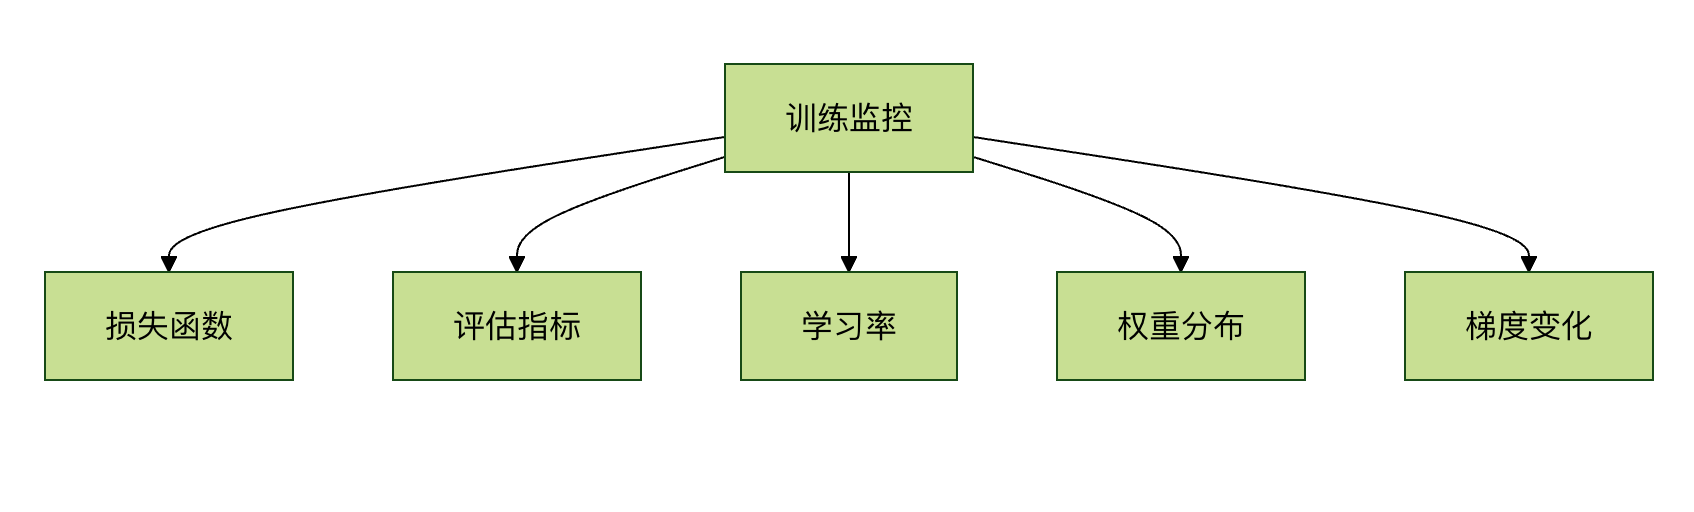
2. Indicateurs clés pour la surveillance
4. Techniques avancées d'évaluation
4.1 Validation croisée
Exemple
from sklearn.model_selection import KFold
import numpy as np
# Préparer les données
X = np.array(...)
y = np.array(...)
# Validation croisée en 5 plis
kfold = KFold(n_splits=5, shuffle=True)
fold_no = 1
for train, test in kfold.split(X, y):
# Créer le modèle
model = create_model()
# Entraîner le modèle
model.fit(X[train], y[train], epochs=10)
# Évaluer le modèle
scores = model.evaluate(X[test], y[test])
print(f'Fold {fold_no} - {model.metrics_names[0]}: {scores[0]}')
fold_no += 1
4.2 Analyse de la matrice de confusion
Exemple
from sklearn.metrics import confusion_matrix
import seaborn as sns
import matplotlib.pyplot as plt
# Obtenir les résultats de prédiction
y_pred = model.predict(test_images)
y_pred_classes = np.argmax(y_pred, axis=1)
# Générer la matrice de confusion
conf_mat = confusion_matrix(test_labels, y_pred_classes)
# Visualisation
plt.figure(figsize=(10, 8))
sns.heatmap(conf_mat, annot=True, fmt='d')
plt.xlabel('Prédit')
plt.ylabel('Réel')
plt.show()
5. Surveillance du modèle après déploiement
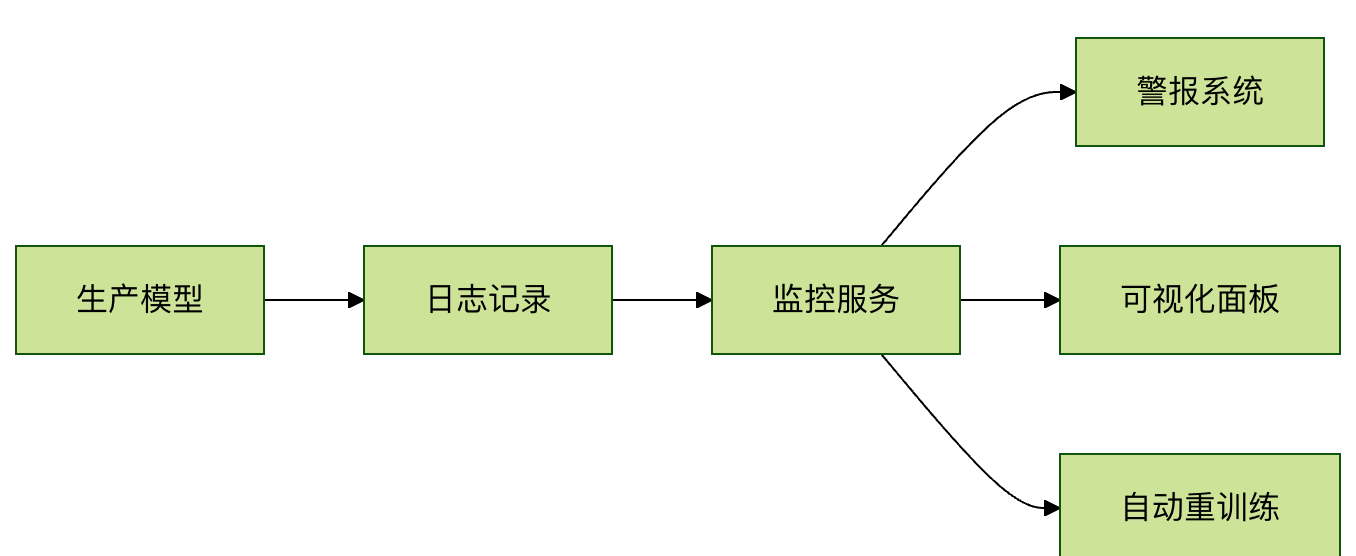
5.1 Points clés pour la surveillance de l'environnement de production
- Détection de dérive des données: Surveiller les changements dans la distribution des données d'entrée
- Détection de dérive conceptuelle: Surveiller les changements dans la relation entre les caractéristiques et les cibles
- Détection de dégradation des performances: Évaluer périodiquement les performances du modèle
- Détection d'entrées anormales: Identifier des échantillons d'entrée anormaux
5.2 Architecture du système de surveillance
6. Travaux pratiques
6.1 Tâches pratiques
- Entraîner un modèle CNN simple sur le jeu de données MNIST
- Implémenter les fonctionnalités d'évaluation suivantes :
- Suivi de la précision et de la perte pendant le processus d'entraînement
- Analyse de la matrice de confusion sur l'ensemble de test
- Utiliser TensorBoard pour visualiser le processus d'entraînement
- Essayez d'implémenter des métriques d'évaluation personnalisées
6.2 Cadre du code de référence
Exemple
import tensorflow as tf
from tensorflow.keras import layers
# 1. Préparation des données
(train_images, train_labels), (test_images, test_labels) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape((60000, 28, 28, 1)).astype('float32') / 255
test_images = test_images.reshape((10000, 28, 28, 1)).astype('float32') / 255
# 2. Construction du modèle
model = tf.keras.Sequential([
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
layers.Flatten(),
layers.Dense(10, activation='softmax')
])
# 3. Compiler le modèle (ajoutez les métriques de votre choix)
model.compile(...)
# 4. Entraîner le modèle (ajoutez le callback TensorBoard)
history = model.fit(...)
# 5. Évaluer le modèle
test_loss, test_acc = model.evaluate(...)
# 6. Analyse de la matrice de confusion
# Votre code...