Caso de aplicación de Sklearn
El conjunto de datos de iris (Iris Dataset) es uno de los conjuntos de datos introductorios más clásicos en el aprendizaje automático.
El conjunto de datos de iris contiene tres especies de iris (Setosa, Versicolor, Virginica), cada una con 4 características: longitud del sépalo, ancho del sépalo, longitud del pétalo y ancho del pétalo.
A continuación, nuestra tarea es predecir la especie de iris basándonos en estas características.
El caso de este capítulo cubrirá pasos como carga de datos, visualización, selección de características, preprocesamiento de datos, construcción de un modelo de clasificación, evaluación y optimización del modelo.
1. Carga y visualización de datos
Carga de datos
Primero, cargamos el conjunto de datos de iris. scikit-learn proporciona una interfaz para cargar directamente el conjunto de datos de iris.
Ejemplo
import pandas as pd
# Cargar el conjunto de datos de iris
data = load_iris()
# Convertir a DataFrame para visualizarlo fácilmente
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Ver las primeras filas de datos
print(df.head())
Resultado de salida:
   sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)  target species
0                 5.1               3.5                1.4               0.2       0   setosa
1                 4.9               3.0                1.4               0.2       0   setosa
2                 4.7               3.2                1.3               0.2       0   setosa
3                 4.6               3.1                1.5               0.2       0   setosa
4                 5.0               3.6                1.4               0.2       0   setosa
En este punto, los datos se han cargado correctamente y podemos ver las características de cada dato y el tipo de flor correspondiente.
Visualización de datos
Para comprender mejor los datos, podemos ver la relación entre diferentes características mediante visualización. Podemos usar las bibliotecas matplotlib y seaborn para visualizar.
Ejemplo
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
# Cargar el conjunto de datos de iris
data = load_iris()
# Convertir a DataFrame para visualizarlo fácilmente
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Dibujar la relación entre características
sns.pairplot(df, hue="species")
plt.show()
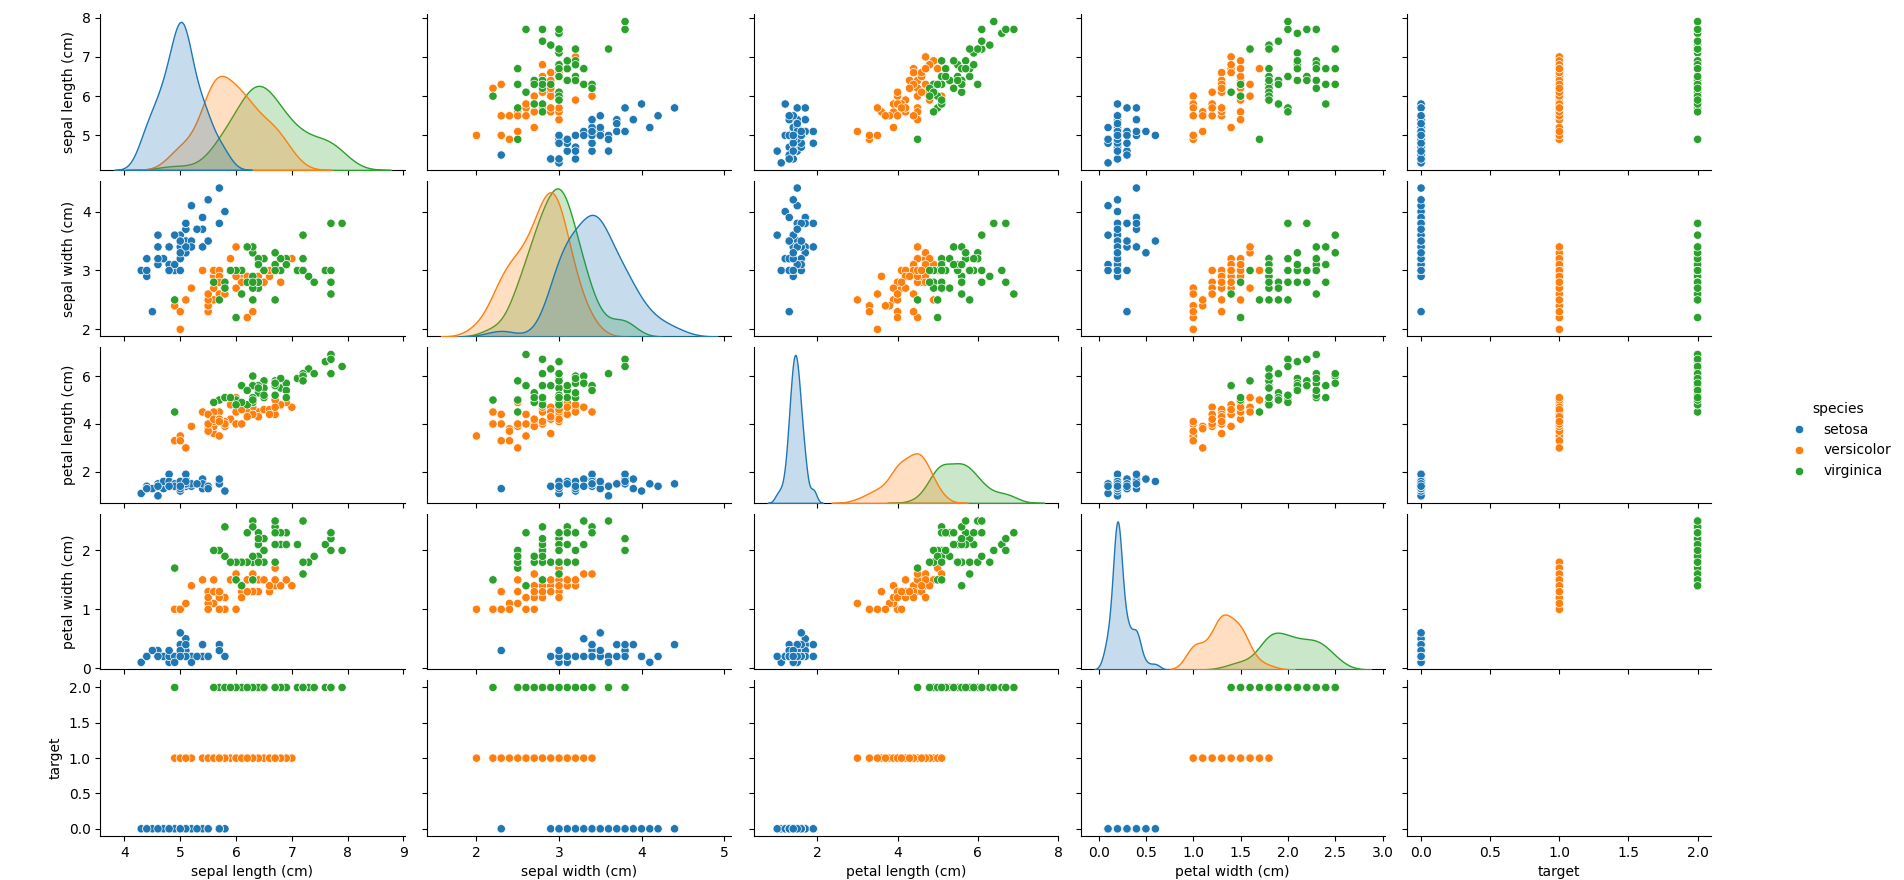
pairplot dibuja una matriz de diagramas de dispersión entre características, usando diferentes colores para identificar las distintas especies de iris. Esto nos ayuda a comprender la distribución de cada característica y la relación entre ellas.
La gráfica se muestra a continuación:
Mapa de calor para visualizar la correlación entre características
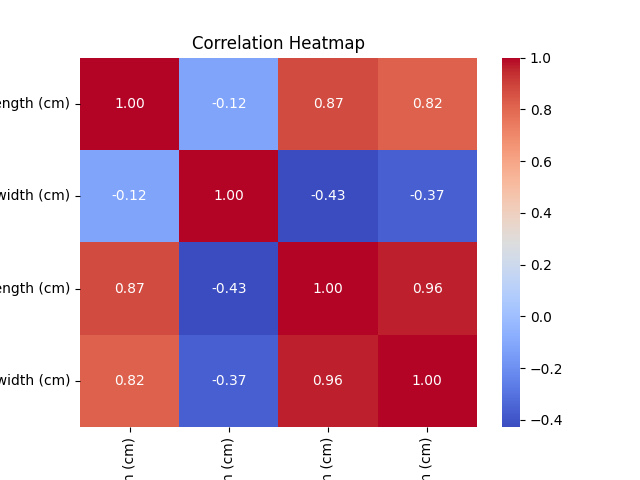
Mediante el mapa de calor podemos ver la correlación entre características; una correlación más fuerte puede ayudarnos a tomar mejores decisiones al modelar.
Ejemplo
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
# Cargar el conjunto de datos de iris
data = load_iris()
# Convertir a DataFrame para visualizarlo fácilmente
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Dibujar la relación entre características
correlation_matrix = df.drop(columns=['target', 'species']).corr()
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f")
plt.title("Correlation Heatmap")
plt.show()
La gráfica se muestra a continuación:
2. Selección de características y preprocesamiento de datos
Preprocesamiento de datos
En el aprendizaje automático, el preprocesamiento de datos es un paso muy importante.
Para el conjunto de datos de iris, los valores de las características ya son datos numéricos y no se necesita demasiado preprocesamiento. Sin embargo, podemos estandarizar los datos para mejorar el efecto de entrenamiento del modelo.
Ejemplo
# Extraer características y etiquetas
X = df.drop(columns=['target', 'species'])
y = df['target']
# Estandarizar características
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
El propósito de la estandarización es hacer que cada característica tenga media 0 y varianza 1. Esto es muy importante para algunos modelos basados en distancia (como KNN, SVM).
Selección de características
Aunque las características del conjunto de datos de iris son relativamente simples, en problemas reales a veces necesitamos reducir la dimensionalidad de las características mediante la selección de características para mejorar el rendimiento del modelo.
Podemos usar métodos como SelectKBest o Recursive Feature Elimination (RFE).
Por ejemplo, use SelectKBest para seleccionar las 2 características más relevantes con la etiqueta:
Ejemplo
# Usar la prueba de chi-cuadrado para seleccionar las 2 características más relevantes
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X_scaled, y)
# Imprimir las características seleccionadas
selected_features = selector.get_support(indices=True)
print("Selected features:", X.columns[selected_features])
Esto seleccionará las 2 características con mayor correlación con la etiqueta objetivo.
3. Construir un modelo de clasificación: usar árbol de decisión o SVM para clasificar
Usar clasificador de árbol de decisión
Primero intentaremos clasificar usando un modelo de árbol de decisión (Decision Tree).
Ejemplo
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
# Dividir el conjunto de datos
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2, random_state=42)
# Inicializar el clasificador de árbol de decisión
model_dt = DecisionTreeClassifier(random_state=42)
# Entrenar el modelo
model_dt.fit(X_train, y_train)
# Predecir
y_pred_dt = model_dt.predict(X_test)
# Evaluar el modelo
accuracy_dt = accuracy_score(y_test, y_pred_dt)
print(f"Decision Tree Accuracy: {accuracy_dt:.4f}")
Usar máquina de vectores de soporte (SVM) para clasificar
A continuación, podemos intentar clasificar usando máquina de vectores de soporte (SVM).
Ejemplo
# Inicializar el clasificador SVM
model_svm = SVC(kernel='linear', random_state=42)
# Entrenar el modelo
model_svm.fit(X_train, y_train)
# Predecir
y_pred_svm = model_svm.predict(X_test)
# Evaluar el modelo
accuracy_svm = accuracy_score(y_test, y_pred_svm)
print(f"SVM Accuracy: {accuracy_svm:.4f}")
4. Evaluar el modelo y optimizarlo
Evaluación del modelo
Además de la exactitud, también podemos usar otras métricas de evaluación, como la matriz de confusión, la precisión, la exhaustividad (recall) y la puntuación F1.
Ejemplo
# Matriz de confusión
cm = confusion_matrix(y_test, y_pred_dt)
print("Confusion Matrix (Decision Tree):")
print(cm)
# Precisión, exhaustividad, puntuación F1
report = classification_report(y_test, y_pred_dt)
print("Classification Report (Decision Tree):")
print(report)
Ajuste mediante búsqueda en cuadrícula
Para optimizar el modelo, podemos usar la búsqueda en cuadrícula (GridSearchCV) para ajustar los hiperparámetros del modelo y encontrar la mejor combinación de parámetros.
Ejemplo
# Definir la cuadrícula de parámetros del árbol de decisión
param_grid = {
'max_depth': [3, 5, 10, None],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4]
}
# Inicializar GridSearchCV
grid_search = GridSearchCV(estimator=DecisionTreeClassifier(random_state=42), param_grid=param_grid, cv=5)
# Entrenar la búsqueda en cuadrícula
grid_search.fit(X_train, y_train)
# Obtener los mejores parámetros y el mejor modelo
print("Best Parameters:", grid_search.best_params_)
best_model = grid_search.best_estimator_
# Predecir y evaluar
y_pred_optimized = best_model.predict(X_test)
accuracy_optimized = accuracy_score(y_test, y_pred_optimized)
print(f"Optimized Decision Tree Accuracy: {accuracy_optimized:.4f}")
Mediante la búsqueda en cuadrícula, podemos encontrar los parámetros del árbol de decisión más adecuados para los datos actuales y mejorar la exactitud de predicción del modelo.
Validación cruzada
Para evaluar aún más la estabilidad del modelo, podemos usar la validación cruzada para evaluar el rendimiento del modelo.
Ejemplo
# Realizar validación cruzada de 5 pliegues
cross_val_scores = cross_val_score(best_model, X_scaled, y, cv=5)
print(f"Cross-validation Scores: {cross_val_scores}")
print(f"Mean CV Accuracy: {cross_val_scores.mean():.4f}")
La validación cruzada nos ayuda a evaluar el rendimiento del modelo en diferentes subconjuntos de datos, evitando el sobreajuste del modelo.
5. Código completo
A continuación se muestra un caso de código completo que cubre los pasos de carga del conjunto de datos de iris, preprocesamiento de datos, selección de características, construcción de un modelo de clasificación, evaluación y optimización del modelo. Usaremos los clasificadores de árbol de decisión y SVM, y optimizaremos los hiperparámetros del modelo mediante búsqueda en cuadrícula.Ejemplo
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split, GridSearchCV, cross_val_score
from sklearn.preprocessing import StandardScaler
from sklearn.tree import DecisionTreeClassifier
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
# 1. Carga de datos
# Cargar el conjunto de datos de iris
data = load_iris()
# Convertir a DataFrame para visualizarlo fácilmente
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Ver las primeras filas de datos
print("Vista previa de los datos:")
print(df.head())
# 2. Visualización de datos
# Dibujar la relación entre características
sns.pairplot(df, hue="species")
plt.show()
# Dibujar el mapa de calor para ver la correlación entre características
correlation_matrix = df.drop(columns=['target', 'species']).corr()
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f")
plt.title("Correlation Heatmap")
plt.show()
# 3. Selección de características y preprocesamiento de datos
# Extraer características y etiquetas
X = df.drop(columns=['target', 'species'])
y = df['target']
# Estandarización de datos
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
# 4. Construir modelo de clasificación
# Dividir el conjunto de datos
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2, random_state=42)
# Usar clasificador de árbol de decisión
model_dt = DecisionTreeClassifier(random_state=42)
model_dt.fit(X_train, y_train)
# Predecir
y_pred_dt = model_dt.predict(X_test)
# Mostrar la exactitud del árbol de decisión
accuracy_dt = accuracy_score(y_test, y_pred_dt)
print(f"Decision Tree Accuracy: {accuracy_dt:.4f}")
# Usar clasificador de máquina de vectores de soporte (SVM)
model_svm = SVC(kernel='linear', random_state=42)
model_svm.fit(X_train, y_train)
# Predecir
y_pred_svm = model_svm.predict(X_test)
# Mostrar la exactitud de SVM
accuracy_svm = accuracy_score(y_test, y_pred_svm)
print(f"SVM Accuracy: {accuracy_svm:.4f}")
# 5. Evaluación del modelo
# Evaluación del modelo de árbol de decisión
print("\nDecision Tree Classification Report:")
print(classification_report(y_test, y_pred_dt))
print("\nDecision Tree Confusion Matrix:")
print(confusion_matrix(y_test, y_pred_dt))
# Evaluación del modelo SVM
print("\nSVM Classification Report:")
print(classification_report(y_test, y_pred_svm))
print("\nSVM Confusion Matrix:")
print(confusion_matrix(y_test, y_pred_svm))
# 6. Ajuste mediante búsqueda en cuadrícula
# Definir la cuadrícula de parámetros del árbol de decisión
param_grid = {
'max_depth': [3, 5, 10, None],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4]
}
# Inicializar GridSearchCV
grid_search = GridSearchCV(estimator=DecisionTreeClassifier(random_state=42), param_grid=param_grid, cv=5)
grid_search.fit(X_train, y_train)
# Obtener los mejores parámetros y el mejor modelo
print("\nBest Parameters from GridSearchCV (Decision Tree):")
print(grid_search.best_params_)
# Usar el mejor modelo para predecir
best_model = grid_search.best_estimator_
y_pred_optimized = best_model.predict(X_test)
# Mostrar la exactitud del árbol de decisión optimizado
accuracy_optimized = accuracy_score(y_test, y_pred_optimized)
print(f"Optimized Decision Tree Accuracy: {accuracy_optimized:.4f}")
# 7. Validación cruzada
# Realizar validación cruzada de 5 pliegues
cross_val_scores = cross_val_score(best_model, X_scaled, y, cv=5)
print("\nCross-validation Scores (Optimized Decision Tree):")
print(cross_val_scores)
print(f"Mean CV Accuracy: {cross_val_scores.mean():.4f}")
Análisis del código:
Carga de datos:
- Usar
load_iris()cargar el conjunto de datos de iris y convertir los datos aDataFrameformato, para poder visualizarlo y analizarlo.
- Usar
Visualización de datos:
- Usar
seaborndepairplotdibujar la matriz de diagramas de dispersión entre las características y, medianteheatmapdibujar el mapa de calor de correlación entre características.
- Usar
Selección de características y preprocesamiento de datos:
- Extraer características (
X) y etiquetas (y), y estandarizar los datos de las características para que cada característica tenga media 0 y varianza 1.
- Extraer características (
Construir el modelo de clasificación:
- Usar
DecisionTreeClassifierySVCEntrenar el clasificador de árbol de decisión y el clasificador de máquina de vectores de soporte por separado, y evaluar su precisión en el conjunto de prueba.
- Usar
Evaluación del modelo:
- Usar
classification_reportyconfusion_matrixGenerar métricas de evaluación detalladas del modelo, incluyendo precisión, recall, puntuación F1 y matriz de confusión.
- Usar
Ajuste mediante búsqueda en cuadrícula:
- Usar
GridSearchCVAjustar los hiperparámetros del modelo de árbol de decisión, encontrar la mejor combinación de hiperparámetros y mostrar la precisión del modelo optimizado.
- Usar
Validación cruzada:
- Usar
cross_val_scoreRealizar una validación cruzada de 5 pliegues para evaluar la estabilidad y el rendimiento del modelo de árbol de decisión optimizado.
- Usar
La salida es la siguiente:
数据预览:
   sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)  target species
0                 5.1               3.5                1.4               0.2       0   setosa
1                 4.9               3.0                1.4               0.2       0   setosa
2                 4.7               3.2                1.3               0.2       0   setosa
3                 4.6               3.1                1.5               0.2       0   setosa
4                 5.0               3.6                1.4               0.2       0   setosa

Decision Tree Accuracy: 1.0000
SVM Accuracy: 1.0000

Decision Tree Classification Report:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00         9
           1       1.00      1.00      1.00         8
           2       1.00      1.00      1.00         8

    accuracy                           1.00        25
   macro avg       1.00      1.00      1.00        25
weighted avg       1.00      1.00      1.00        25

Decision Tree Confusion Matrix:
[[9 0 0]
 [0 8 0]
 [0 0 8]]

SVM Classification Report:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00         9
           1       1.00      1.00      1.00         8
           2       1.00      1.00      1.00         8

    accuracy                           1.00        25
   macro avg       1.00      1.00      1.00        25
weighted avg       1.00      1.00      1.00        25

SVM Confusion Matrix:
[[9 0 0]
 [0 8 0]
 [0 0 8]]

Best Parameters from GridSearchCV (Decision Tree):
{'max_depth': 5, 'min_samples_leaf': 1, 'min_samples_split': 2}

Optimized Decision Tree Accuracy: 1.0000

Cross-validation Scores (Optimized Decision Tree):
[1.         1.         1.         1.         1.        ]
Mean CV Accuracy: 1.0000
Otras extensiones