Ollama-Einführung
Ollama ist eine Open-Source-Plattform für große Sprachmodelle (LLM), mit der Nutzer große Sprachmodelle lokal einfach ausführen, verwalten und mit ihnen interagieren können.
Ollama bietet eine einfache Möglichkeit, verschiedene vortrainierte Sprachmodelle zu laden und zu verwenden, und unterstützt mehrere Aufgaben der natürlichen Sprachverarbeitung wie Textgenerierung, Übersetzung, Codeerstellung und Fragebeantwortung.
Ein Merkmal von Ollama ist, dass es nicht nur fertige Modelle und Toolsets bereitstellt, sondern auch praktische Schnittstellen und APIs bietet, sodass Aufgaben von Textgenerierung und Dialogsystemen bis hin zur semantischen Analyse schnell umgesetzt werden können.
Im Gegensatz zu anderen NLP-Frameworks zielt Ollama darauf ab, Benutzer-Workflows zu vereinfachen, sodass maschinelles Lernen kein Bereich mehr ist, der nur Entwicklern mit tiefgehendem technischen Hintergrund zugänglich ist.
Ollama unterstützt mehrere Hardwarebeschleunigungsoptionen, einschließlich reiner CPU-Inferenz und verschiedener zugrunde liegender Rechenarchitekturen (wie Apple Silicon), was eine bessere Nutzung unterschiedlicher Hardwareressourcen ermöglicht.

Ollama ist eine lokale Modell-Laufzeitumgebung, die aus vier Teilen besteht.
| Komponente | Beschreibung | Wobei |
|---|---|---|
| Kommandozeilen-Tool | Einstiegspunkt für alle täglichen Vorgänge wie run, pull, list | Der Befehl ollama im System-PATH |
| Hintergrunddienst | Läuft dauerhaft, ist für das Laden von Modellen und die Inferenz verantwortlich und stellt nach außen eine REST-API bereit | Lokaler Port 11434 |
| Modellbibliothek | Offizielle Distributionskanäle für verschiedene Open-Source-Modelle, klassifiziert nach Fähigkeits-Tags | ollama.com/library |
| Lokaler Speicher | Heruntergeladene Modellgewichte und Konfigurationen | Der Ordner .ollama im Benutzerverzeichnis |
Die neue Version bietet außerdem zwei weitere benutzerfreundliche Einstiegspunkte: Die direkte Eingabe von ollama öffnet ein interaktives Menü, und die Verwendung von ollama launch verbindet lokale Modelle mit nur einem Klick mit Tools wie Claude Code und VS Code.
Kernfunktionen und Merkmale
-
Unterstützung für mehrere vortrainierte Sprachmodelle
Ollama bietet eine Vielzahl sofort einsatzbereiter vortrainierter Modelle, darunter gängige große Sprachmodelle wie GPT und BERT. Benutzer können diese Modelle einfach laden und für Aufgaben wie Textgenerierung, Sentimentanalyse und Fragebeantwortung verwenden. -
Einfache Integration und Nutzung
Ollama bietet ein Kommandozeilenwerkzeug (CLI) und ein Python SDK, was die Integration in andere Projekte und Dienste vereinfacht. Entwickler müssen sich nicht um komplexe Abhängigkeiten oder Konfigurationen kümmern und können Ollama schnell in bestehende Anwendungen integrieren. -
Lokale Bereitstellung und Offline-Nutzung
Anders als einige cloudbasierte NLP-Dienste ermöglicht Ollama Entwicklern, Modelle in lokalen Rechenumgebungen auszuführen. Das bedeutet, dass es die Abhängigkeit von externen Servern beseitigen und die Datenprivatsphäre gewährleisten kann, und bei Anfragen mit hoher Parallelität kann die Offline-Bereitstellung eine geringere Latenz und größere Steuerbarkeit bieten. -
Unterstützung für Modell-Feinabstimmung und Anpassung
Benutzer können nicht nur die von Ollama bereitgestellten vortrainierten Modelle verwenden, sondern Modelle auf dieser Grundlage auch feinabstimmen. Entsprechend ihren spezifischen Anforderungen können Entwickler Modelle mit ihren eigenen gesammelten Daten neu trainieren, um die Leistung und Genauigkeit des Modells zu optimieren. -
Leistungsoptimierung
Ollama konzentriert sich auf Leistung, bietet einen effizienten Inferenzmechanismus, unterstützt Stapelverarbeitung und verwaltet Speicher- und Rechenressourcen effektiv. Dadurch bleibt es bei der Verarbeitung großer Datenmengen effizient. -
Plattformübergreifende Unterstützung
Ollama unterstützt die Ausführung auf mehreren Betriebssystemen, darunter Windows, macOS und Linux. Dies gewährleistet eine konsistente Erfahrung, egal ob Entwickler in einer lokalen Umgebung debuggen oder Unternehmen in der Produktion bereitstellen. -
Open-Source- und Community-Unterstützung
Ollama ist ein Open-Source-Projekt, was bedeutet, dass Entwickler den Quellcode einsehen, ihn ändern und optimieren sowie zum Projekt beitragen können. Darüber hinaus hat Ollama eine aktive Community, in der Entwickler Hilfe erhalten und Erfahrungen mit anderen austauschen können.
Anwendungsszenarien
-
Content-Erstellung:
Hilft Autoren, Journalisten und Marketern, schnell hochwertige Inhalte zu erstellen, wie Blogbeiträge, Werbetexte und mehr. -
Programmierhilfe::
Hilft Entwicklern, Code zu generieren, Programme zu debuggen oder Codestrukturen zu optimieren. -
Bildung und Forschung:
Unterstützt Studierende und Forschende beim Lernen, Schreiben und Forschen, z. B. beim Generieren von Abstracts für wissenschaftliche Arbeiten oder beim Beantworten von Fragen. -
Sprachübergreifende Kommunikation:
Bietet hochwertige Übersetzungsfunktionen, damit Nutzer Sprachbarrieren überwinden können. -
Persönlicher Assistent:
Dient als intelligenter Assistent, der Nutzern hilft, tägliche Aufgaben zu erledigen, z. B. E-Mails schreiben, To-do-Listen erstellen und mehr.
Warum große Modelle lokal ausführen
Lokaler Betrieb ist keine Nostalgie; er beruht auf vier triftigen Gründen.
Datenschutz: Daten verlassen niemals das Gerät. Bei Inhalten, die den lokalen Rechner nicht verlassen dürfen, wie Vertragsentwürfe, Krankenakten und privater Code, muss man vor der Nutzung von Cloud-APIs immer Risiken abwägen, während lokale Inferenz dieses Problem von Natur aus vermeidet.
Kosten: Keine Abrechnung pro Token. Das Herunterladen eines Modells kostet nur einmal Speicherplatz und Strom, und die Grenzkosten nähern sich bei starker Nutzung null, was besonders vorteilhaft für Szenarien ist, die Batch-Textverarbeitung erfordern.
Offline: Keine Abhängigkeit vom Netzwerk. In Intranet-Umgebungen, Serverräumen oder im Flugzeug gilt: Solange das Gerät da ist, ist das Modell da; dies ist eine harte Anforderung für den Vor-Ort-Einsatz und Gebiete mit schlechter Konnektivität.
Kontrollierbarkeit: Versionen und Verhalten sind vorhersehbar. Lokale Modelle führen nicht stillschweigend Upgrades durch und ändern ihr Verhalten; die heute verifizierten Ausgabeformate ändern sich morgen nicht. Für Produktionssysteme ist das wichtiger als "leistungsfähiger" zu sein.
Natürlich, um ehrlich zu sein: Die Fähigkeitsobergrenze lokaler Open-Source-Modelle ist derzeit noch niedriger als die von Cloud-Flaggschiffmodellen. Bei der Wahl einer lokalen Lösung geht es darum, "gut genug, kontrollierbar und günstig" zu sein, nicht "alleskönnend".
Unterschiede zu Cloud-APIs und anwendbare Szenarien
Stellt man die beiden Ansätze nebeneinander, werden die Auswahlkriterien klar.
| Dimension | Ollama lokal | Cloud-API (OpenAI, Claude usw.) |
|---|---|---|
| Datenstandort | Verlässt niemals den lokalen Rechner | Wird auf die Server des Anbieters hochgeladen |
| Compute-Quelle | Eigene CPU / GPU | Rechenzentrum des Anbieters |
| Kostenmodell | Einmaliger Download, kostenlos nutzbar | Kontinuierliche Abrechnung pro Token |
| Modellstärke | Durch lokale Hardware eingeschränkt | Beste verfügbare Flaggschiff-Modelle |
| Offline-Verfügbarkeit | Vollständig verfügbar | Nicht verfügbar |
| Einstiegskosten | Software einmal installieren, Hardware einmal konfigurieren | Nach der Registrierung sofort einsatzbereit, aber Schlüssel und Abrechnungen müssen verwaltet werden |
Die passenden Einsatzszenarien werden ebenfalls deutlich: Wählen Sie lokal für datenschutzsensible, hochfrequente Aufrufe, Offline-Umgebungen sowie Lernen und Entwicklungsvalidierung; wählen Sie Cloud-APIs, wenn Sie erstklassige Modellfähigkeiten, stoßartig elastischen Datenverkehr benötigen oder keine eigene GPU besitzen.
Die beiden sind keine Gegner; ausgereifte Produkte verwenden oft eine Hybridarchitektur: Alltägliche Anfragen laufen lokal, und einige schwierige Aufgaben werden an die Cloud weitergeleitet.
Vergleich mit anderen lokalen Lösungen
Das lokale Ausführen großer Modelle ist nicht auf Ollama beschränkt; jede gängige Lösung hat ihre eigene Zielgruppe.
| Lösung | Positionierung | Einfachheit des Einstiegs | Zielgruppe |
|---|---|---|---|
| Ollama | Eine Laufzeitumgebung, die Modelle mit einem einzigen Befehl ausführt + lokaler API-Dienst | Niedrig | Die meisten Entwickler, Teams, die eine schnelle Integration wünschen |
| llama.cpp | Die Hochleistungs-Inferenz-Engine selbst, mit vielen Parametern und feingranularer Steuerung | Hoch | Nutzer, die sich eingehend mit Inferenzdetails befassen und das Deployment anpassen möchten |
| LM Studio | Eine Desktop-Anwendung mit grafischer Oberfläche, mit integriertem Durchsuchen und Herunterladen von Modellen | Niedrig | Nutzer, die eine grafische Oberfläche bevorzugen und die Kommandozeile nicht verwenden möchten |
| vLLM | Ein hochdurchsatzfähiger Inferenzdienst in Produktionsqualität für GPU-Server | Hoch | Teams mit hochgradig nebenläufigen Online-Diensten und reichlich Rechenressourcen |
| GPT4All | Eine leichtgewichtige Desktop-Anwendung mit Fokus auf lokale Dokumentenkonversation | Niedrig | Normale Nutzer ohne technischen Hintergrund |
Ihre Beziehung ist erwähnenswert: Ollamas zugrunde liegende Inferenzfähigkeit stammt von llama.cpp, was man als ein auf llama.cpp aufbauendes "benutzerfreundliches Wrapper- + serviceorientiertes + Modellbibliotheks-Ökosystem" verstehen kann.
Dieses Tutorial wählt Ollama als roten Faden, wegen seiner Ausgewogenheit: minimale Befehle, vollständige Abdeckung von drei Plattformen und das vollständigste API- und Tool-Ökosystem. Der Vergleich basiert auf öffentlichen Informationen und dem Projektstand von August 2026; alle Lösungen entwickeln sich rasant weiter.
Lokale Modelle vs. Ollama Cloud
Bei den bisherigen Vergleichen ging es ausschließlich um die "Clouds anderer Anbieter". Ollama selbst bietet ebenfalls eine Cloud-Lösung, die die drei Nutzungsarten großer Modelle vervollständigt.

Die Nutzung von Ollama Cloud ist fast identisch mit der lokalen: Hängen Sie das Suffix `:cloud` an den Modellnamen an, melden Sie sich bei Ihrem Konto an und führen Sie es direkt aus. Lokale Befehle, APIs und Tool-Integrationen funktionieren unverändert, außer dass die Inferenz transparent an die Server von Ollama weitergeleitet wird.
Beispiele
ollama signin
# Cloud-Modelle wie lokale Modelle ausführen, ohne Gewichte herunterladen zu müssen
ollama run qwen3.5:cloud
Der Nutzen liegt in zwei Szenarien: ultragroße Modelle, die Ihre lokale Rechenleistung nicht bewältigen kann, und das "Testen, ob ein größeres Modell sich lohnt", bevor Sie einen neuen Computer kaufen.
Cloud-Modelle haben einen Ausmusterungsmechanismus: Das offizielle Team nimmt regelmäßig alte Cloud-Modelle außer Betrieb und kündigt Ersatz an. Automatisierungsworkflows, die von ihnen abhängen, müssen auf Ankündigungen achten; lokale Modelle bleiben für immer auf Ihrer Festplatte, unberührt. Dieses Thema wird im Kapitel „Cloud Hybrid Deployment“ vollständig behandelt.
Hardware-Anforderungen und Erwartungen
Ein letzter Punkt: Schätzen Sie Ihre eigene Maschine ein. Ollama ist überraschend genügsam bei den Hardware-Anforderungen – es kann allein mit reiner CPU laufen, allerdings mit einem Geschwindigkeitsunterschied von einer Größenordnung.
Mit einer dedizierten GPU (NVIDIA, AMD) oder einem Apple-Silicon-Chip wird die Inferenz per GPU beschleunigt, und die Generierungsgeschwindigkeit ist normalerweise mehrere bis dutzende Male schneller als bei reiner CPU.
Die Standardgröße des Kontextfensters wird von Ollama automatisch je nach VRAM gestaffelt:
| VRAM-Größe | Standard-Kontextlänge |
|---|---|
| Weniger als 24GiB | 4K |
| 24 ~ 48GiB | 32K |
| 48GiB und höher | 256K |
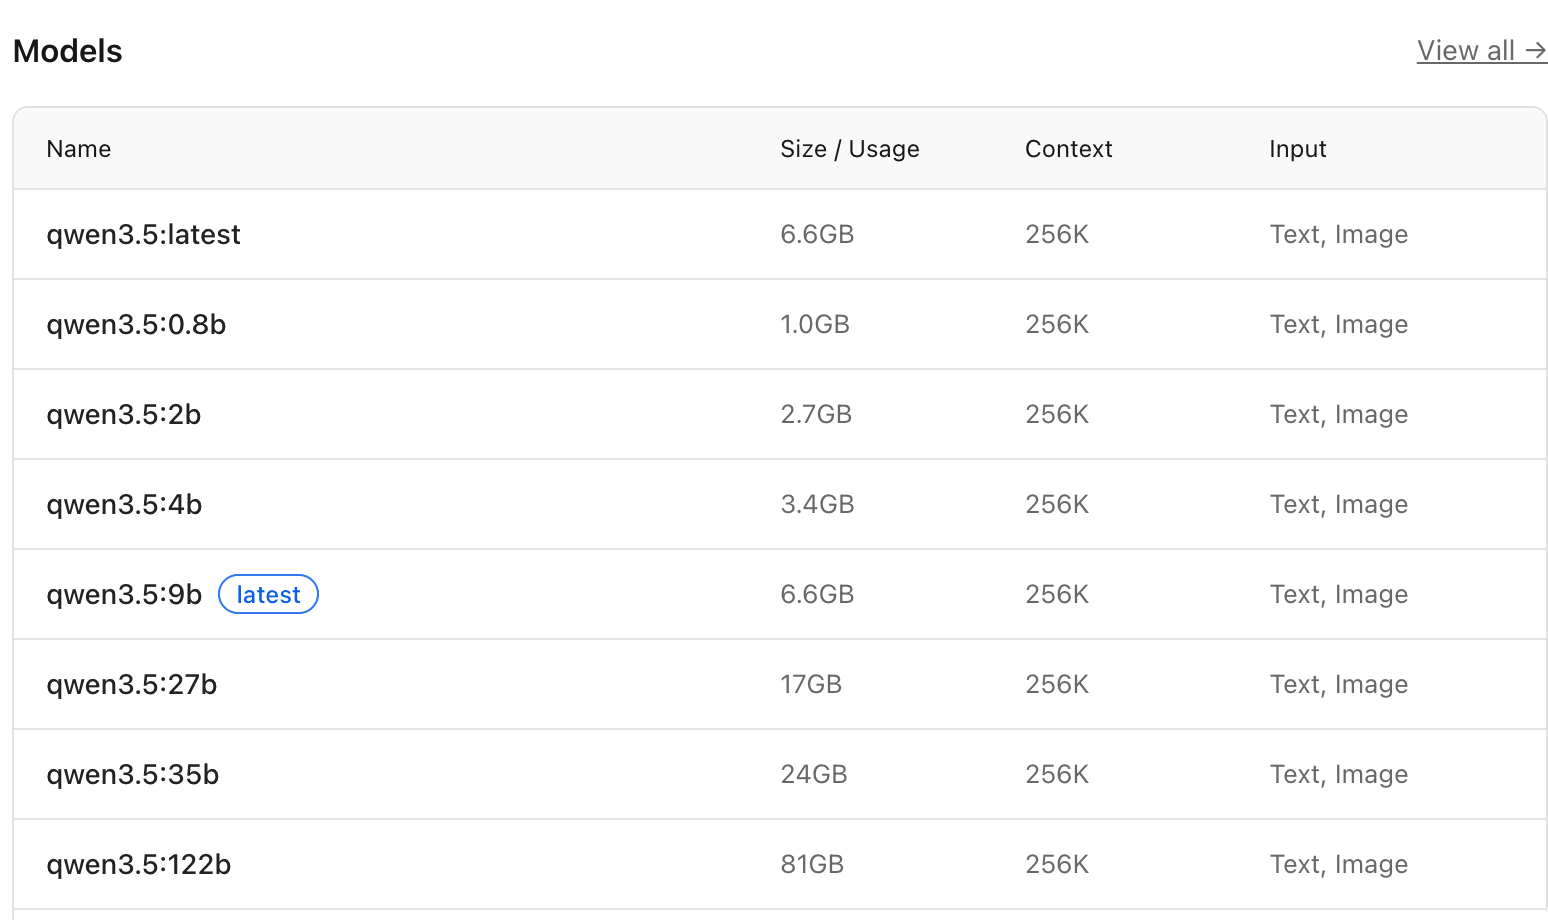
Betrachten Sie nun die erwartete Zuordnung zwischen Parameterumfang und Gerät (am Beispiel der qwen3.5-Familie):https://ollama.com/library/qwen3.5):
| Modellspezifikation | Downloadgröße | Empfohlene Konfiguration | Erfahrungserwartung |
|---|---|---|---|
| qwen3.5:latest | Etwa 6.6GB | 16GB RAM oder 8GB VRAM | Standard-Spezifikation, ausgewogene Qualität und Geschwindigkeit |
| qwen3.5:0.8b | Etwa 1.0GB | 8GB RAM reichen aus | Verifikationsumgebungen, leichte Konversationen |
| qwen3.5:4b | Etwa 3.4GB | 16GB RAM | Der Sweet Spot für die tägliche Nutzung |
| qwen3.5:9b entspricht qwen3.5:latest | Etwa 6.6GB | 16GB RAM oder 8GB VRAM | Standard-Spezifikation, ausgewogene Qualität und Geschwindigkeit |
| qwen3.5:27b | Etwa 17GB | 24GB VRAM | Anspruchsvolle Aufgaben wie lange Dokumente und Code |
Nachdem das Modell läuft, verwenden Sie denollama psBefehl, um die Spalte PROCESSOR zu prüfen und zu bestätigen, ob das Modell wirklich vollständig auf der GPU läuft. Dieser Verifizierungsschritt wird im Kapitel Modellverwaltung wiederholt verwendet.
Weitere ErweiterungenLassen Sie sich nicht entmutigen, wenn Ihre Konfiguration wirklich begrenzt ist: Die 0.8b-Spezifikation reicht aus, um die überwiegende Mehrheit der Befehlsdemos in diesem Tutorial durchzugehen; und wenn Sie wirklich ein größeres Modell benötigen, gibt es den `:cloud`-Weg, der keine Hardware erfordert.